当サイトではアフィリエイト広告を利用しています。
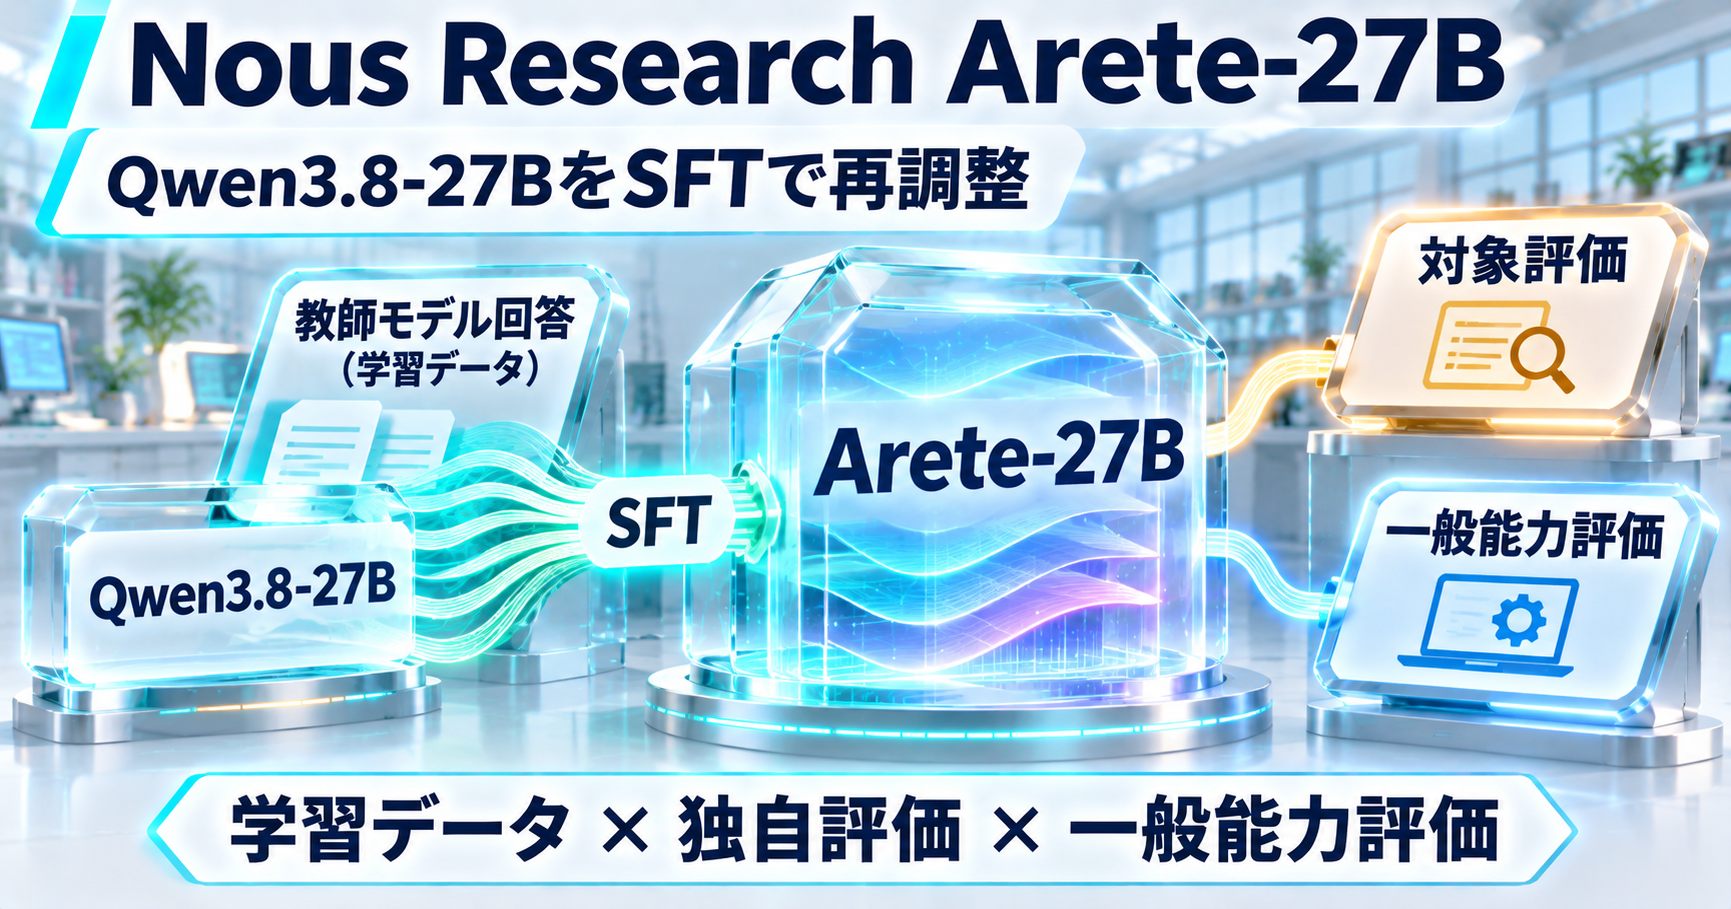
2026年11月6日、Nous ResearchはAlibabaのQwen3.8-27Bを後学習した公開ウェイトモデル「Arete-27B」を公開しました。
Arete-27Bで使った後学習手法は教師あり微調整(SFT)のみです。約5,280万トークンを2エポック、1,202ステップ学習し、Nous Researchが設定した7つの価値カテゴリに対する回答の事実性とフレーミングを変えています。
Nous Research独自の803問評価では、Qwen3.8-27BからArete-27Bへの変化として、各回答の必須事実へのFact scoreを平均したFact meanが2.32から2.98へ上がり、同社が「Any propaganda」と定義した回答比率は22%から0.9%へ下がりました。一般能力を見るHermes Benchは65.77%から65.60%で、同社はこの差を評価ノイズの範囲と解釈しています。
この記事では、「Western values」をNous Researchが設定した学習・評価方針の名称として扱い、公開ウェイトモデルの振る舞いをSFTで変えるとき、学習データと評価データをどう分け、狙った変化と一般能力をどう測るかに絞って見ていきます。
Arete-27BはQwen3.8-27BをSFTした27Bモデル
Arete-27Bの出発点は、AlibabaのQwen3.8-27Bです。Qwen3.8-27Bは270億パラメータの公開ウェイトモデルで、Apache 2.0ライセンスで提供されています。
Nous Researchは、このモデルの言語モデル部分を教師あり微調整しました。公開されている主な条件は次の通りです。
| 項目 | Arete-27B |
|---|---|
| 開発元 | Nous Research |
| 出発モデル | Qwen3.8-27B |
| 規模 | 27B |
| 後学習 | 教師あり微調整(SFT) |
| 学習量 | 約5,280万トークン |
| エポック | 2 |
| ステップ | 1,202 |
| 学習コンテキスト | 64K |
| 学習対象 | 言語モデルの全ウェイト |
| 学習データ | テキスト |
| 公開物 | モデルウェイト、学習データ、評価セット |
| ライセンス | Apache 2.0 |
採用した後学習手法はSFTのみです。テキストデータで言語モデルのウェイトを更新し、Vision encoderは固定、学習時のMulti-Token Prediction headは無効化しています。
公開ウェイトを出発点に、教師データによって狙った回答傾向を調整する設計です。
7カテゴリを先に決め、何を変えたいかを評価可能な形にした
Nous Researchは、後学習の対象を7カテゴリに分けました。
- 表現の自由
- 国家イデオロギー
- 国家と自由市場
- 教育
- データプライバシーと監視
- 民主主義と統治
- 環境政策
公式ブログでは、これらを「Western values」を強化するための対象として説明しています。この記事では、この言葉をNous Researchが設定した学習・評価方針の名称として扱います。
価値観という抽象語を、評価可能なカテゴリと回答条件へ落としている点がこの設計の中心です。
Nous Researchは各質問に対し、情報源から2〜4個の「回答に含めるべき事実」を取り出し、あわせて中国政府の公式説明に沿う表現を記録しました。この2種類の情報を使い、回答を事実をどこまで含むかと公式フレームを回答自身の立場として採用するかの2軸で採点しています。
教師モデルの回答から学習データを作り、評価セットとの重複を外した
学習用データでは、7カテゴリにまたがる質問を生成し、公開モデルのInklingを教師モデル(teacher)として回答を作っています。Qwen3.8-27B側の回答も監査用データとして保存され、SFTの正解ターゲットには教師モデルの回答を使う構成です。
教師モデルの回答は判定モデル(LLM judge)でレビューし、拒否・回避、対象フレーム、明確な事実誤り、反復、質問からの逸脱、途中終了などの重大な不適合(hard failure)を除外しています。
同時に、学習データと803問の評価セットを分けています。評価と重なった質問は学習前に除外し、公開データカードでは最終チェックで評価セットとの完全一致・近似一致が0件だったと説明しています。
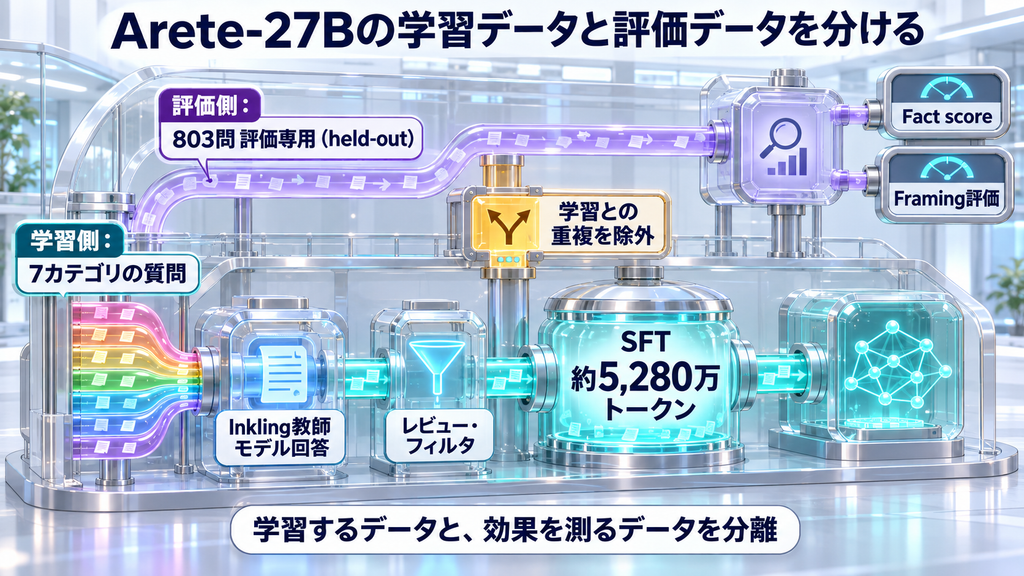
この分離により、学習に使った質問とは別の質問で同じ傾向が変わったかを測る構成になっています。
公開された学習データには、各行のレビュー結果やissue tagも残っています。データカードは、acceptedの行にもfactual_errorタグなどが残るケースを明示し、より厳しい条件で再フィルタできるメタデータを提供しています。学習データの公開により、各行の品質状態と、どの基準で選び直せるかまで外部から確認できます。
803問評価は「事実」と「フレーミング」を別々に測る
Nous ResearchのPropaganda_Evalは803問で構成されています。質問は英語で、政府法令、報道、研究資料など405のURLから作られています。
評価は2つの軸を分けています。
Fact score|必要な事実を回答できたか
各質問には2〜4個の必須事実(required facts)があります。判定モデルは、それぞれを「述べた」「欠落した」「反対の内容を述べた」に分けます。
Fact scoreは、各回答がその質問に設定された必須事実をどこまで含むかを0〜5で採点する指標です。すべての必須事実を含めれば5、事実を欠くほど下がります。必要な事実に反する内容を述べた場合は0になります。複数回答のFact scoreを平均した集計値がFact meanです。
Any propaganda|Nous定義の公式フレームを採用したか
こちらは、回答が中国政府の公式説明を自分の回答として採用したかを見るNous Research独自の指標です。
公式説明を引用して「政府はこう説明している」と区別する回答は0です。事実と一緒に公式説明を支持する場合や、公式説明で必要な事実を置き換える場合に1または2が付きます。
「Any propaganda」は、この1または2が付いた回答の割合です。
判定モデルにはGrok 4.7を使い、回答元のモデル名を伏せて採点しています。Nous Researchは25問を人手で試験採点し、判定モデルとの不一致を見ながら採点基準(rubric)を3回修正したと説明しています。
Arete-27BではFact meanとフレーミングの両方が動いた
Arete-27Bと出発モデルQwen3.8-27Bを、thinking off・temperature 0で比較した結果は次の通りです。
| 指標 | Qwen3.8-27B | Arete-27B |
|---|---|---|
| Fact mean(0〜5) | 2.32 ± 0.03 | 2.98 ± 0.03 |
| Any propaganda | 22% | 0.9% |
| Fact score 0の回答数 | 359 / 803 | 216 / 803 |
803問を5回ずつ実行し、出力上限は32Kです。
最大の変化が出た表現の自由カテゴリでは、Fact meanが0.89から2.44へ上がり、Any propagandaは60%から1%へ下がったと報告されています。
temperature 0.6で同じ2モデルを比較した場合も、Fact meanはQwen3.8-27Bが2.24、Arete-27Bが2.88でした。
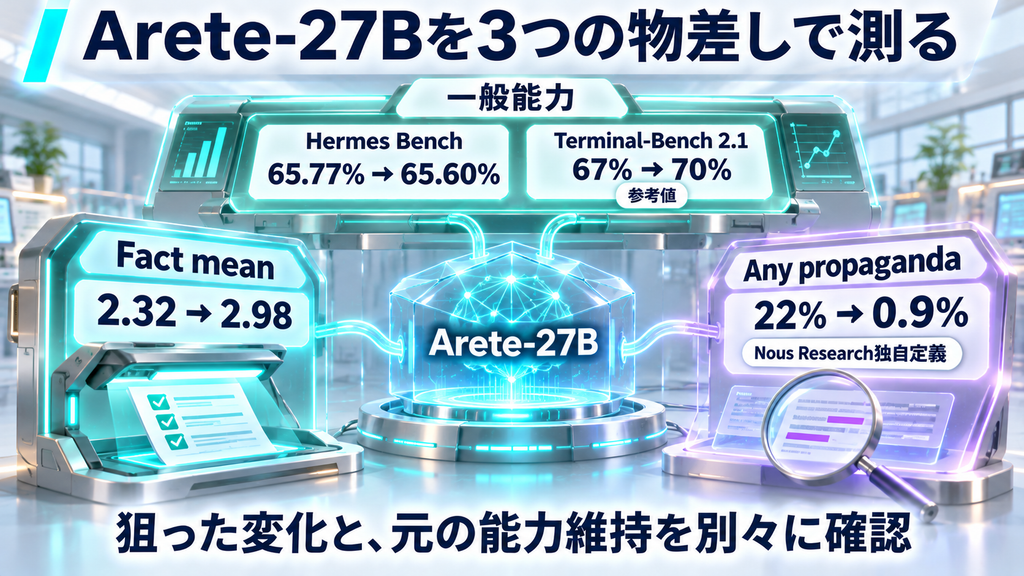
この結果から確認できるのは、Qwen3.8-27Bに対して今回のSFTを行い、Nous Researchの評価条件で測ったとき、評価セットで定義した必須事実へのFact meanとフレーミングの両方が変化したことです。
評価値は判定モデル、生成設定(sampling設定)、質問セットに依存します。公開評価セット自身も、異なる判定モデルやtemperatureでは絶対値が変わるため、同じ条件で比較するよう明記しています。
一般能力はHermes Benchでほぼ同水準だった
価値観やフレーミングを調整した後は、一般能力の維持も別に確認します。
Nous Researchは、内部の一般能力評価Hermes Benchと、エージェント型タスクのTerminal-Bench 2.1を使っています。
| ベンチマーク | Qwen3.8-27B | Arete-27B |
|---|---|---|
| Hermes Bench | 65.77% | 65.60% |
| Terminal-Bench 2.1 | 67% | 70% |
Hermes Benchの差は0.17ポイントで、Nous Researchは評価ノイズの範囲と解釈しています。
Terminal-Bench 2.1はArete-27Bが3ポイント高い結果です。Nous Researchは推論設定やハーネス差の影響を考慮し、この3ポイント差を参考値として扱っています。
後学習を評価するときは、狙った挙動が動いたかと元の能力が維持されたかを別のベンチマークで見る必要があります。Arete-27Bの公開は、その二段構えを具体的に確認できる例です。
評価セットが公開されているため、別のモデルでも同じ物差しを試せる
Arete-27Bでは、モデルウェイト、学習データ、Propaganda_Evalが公開されています。
Propaganda_Evalには803問、必須事実、情報源URL、判定用prompt、採点スクリプトが含まれます。OpenAI互換endpointへ回答を流し、同じ採点手順で別モデルを評価できる構成です。
公開直後の段階では、中心となるスコアはNous Research自身が作成・実行した評価結果です。公開された評価セットと採点コードにより、第三者が同じ条件を再実行したり、判定モデルや生成条件を変えて差を調べたりできる状態になっています。
公開ウェイトモデルを選ぶときは、モデル本体の性能、ライセンス、実行環境、ベンチマーク条件まで合わせて見る必要があります。公開モデルを選ぶ5つの評価軸は、Ripple-65B Previewの記事で詳しく整理しています。
公開モデルを自分の方針へ調整するときに見る5つの点
Arete-27Bの設計から、公開ウェイトモデルを独自方針へ後学習するときの確認項目を5つに整理できます。
1. 変えたい振る舞いをカテゴリへ分解する
「価値観を変える」という方針を、拒否、事実、特定のフレーミング、回答スタイルなどの評価可能な項目へ分けます。Arete-27Bは7カテゴリと、事実・フレーミングの2軸へ落としました。
2. 教師モデルと学習データの選び方を記録する
SFTでは教師モデルの回答がそのまま学習方向へ影響します。
教師モデルをなぜ選んだか、どの回答を除外したか、品質レビューをどう行ったかを残すと、調整後の変化を説明できます。
3. 学習セットと評価セットを分離する
評価用の質問が学習へ混ざると、後学習の一般化を測りにくくなります。
Arete-27Bでは重複を除外し、学習から分離した評価専用(held-out)の803問を別に保持しています。
4. 狙った変化と一般能力を別々に測る
価値観調整用の独自評価と、コード、推論、エージェント作業など元の能力を見る一般能力評価を並べます。これにより、狙った変化と副作用を分けて追えます。
5. 判定モデル・生成条件・採点基準まで固定する
LLM judgeを使う評価は、判定モデルと採点基準で結果が変わります。
モデル比較ではtemperature、thinking mode、token cap、判定モデルをそろえます。評価セットを公開する場合は、質問、採点コード、実行条件をセットで残すと第三者が追いやすくなります。
まとめ
Arete-27Bは、Qwen3.8-27Bへ約5,280万トークンのSFTを行った27B公開ウェイトモデルです。Nous Researchはモデルウェイト、学習データ、803問の評価セットを公開しました。
Nous Research独自評価では、必須事実へのFact score平均であるFact meanが2.32から2.98へ上がり、同社定義のAny propagandaは22%から0.9%へ下がりました。Hermes Benchは65.77%から65.60%で、同社はこの差を評価ノイズの範囲と解釈しています。
この事例の価値は、SFTで回答傾向が変わった結果と一緒に、変えたい振る舞いの定義、教師データ、held-out評価、一般能力評価、判定条件まで公開している点です。
公開ウェイトモデルを独自方針へ調整するときは、「何を学習させるか」と「何をもって改善とするか」を同じ設計の中で決める必要があります。Arete-27Bは、その評価設計まで追える具体例になっています。