当サイトではアフィリエイト広告を利用しています。
AIエージェントが「対応しました」と答えても、実際の業務システムでは処理が終わっていないことがあります。
予約へ希望条件を追加したつもりでもDBには反映されていない。返金処理を進めたつもりでも違う顧客レコードを変更している。ツール呼び出し自体は成功していても、必要な更新が一部抜けている。業務をAIへ任せるほど、この「会話上は成功して見えるが、結果が違う」という食い違いを見落とせません。
MicrosoftのThinkingBoxは、AIエージェントの返答やツール呼び出しだけを見るのではなく、実行後に残ったバックエンドの最終状態と副作用を評価するためのオープンソース基盤です。
公開されたThinkingBox-Bench v1.0では507件の業務タスクを用意し、同じタスクを20回ずつ独立した環境で実行します。1回成功したかだけでなく、同じ仕事を繰り返しても安定して完了できるかまで測ります。
この記事では、2026年10月8日時点のThinkingBoxについて、最終状態をどう判定するのか、pass@1・pass@20・20/20の違い、公開ベンチマークで見えたAIエージェントの失敗、実務の評価へどう応用できるかを確認します。
- ThinkingBoxとThinkingBox-Benchは別のもの
- 「AIが成功と言ったか」ではなく、実際に何が変わったかを見る
- 毎回クリーンなMCP環境を作って同じタスクを繰り返す
- 507件を5つの業務領域で評価する
- pass@1・pass@20・20/20は見ているものが違う
- 最新の公開結果でも単発成功率と安定性は一致しない
- 失敗していても「正常終了」に見えるケースが多い
- 失敗の中心は最終回答よりツール実行側にある
- 実務では「完了条件」を先にシステム側で決める
- 反復回数は20回で固定する必要はない
- 自分のエージェントをThinkingBoxで評価できる
- ThinkingBoxから見えるAIエージェント評価の変化
- まとめ
- 公式情報・参照先
ThinkingBoxとThinkingBox-Benchは別のもの
ThinkingBoxという名前は、評価基盤そのものと公開ベンチマークの両方で使われるため、役割を分けて確認します。
| 名称 | 役割 |
|---|---|
| ThinkingBox | エージェント、MCPツール、模擬ユーザー、評価処理を動かすフレームワーク |
| ThinkingBox-Bench | ThinkingBox上で実行する公開ベンチマーク |
| ThinkingBox-Bench v1.0 | 507件の公開業務タスクを固定した再現用リリース |
| OpenEnv ThinkingBox環境 | Hugging Face OpenEnvからThinkingBox-Benchを実行するためのアダプター |
ThinkingBox本体では、MCPサーバーとしてツール環境を定義し、AIエージェントに使わせ、その結果を評価できます。独自のシナリオやテストケースも作成できます。
ThinkingBox-Benchは、その仕組みを使ってモデルを比較するために公開された評価セットです。
この記事では、フレームワークとしてのThinkingBoxと、固定された公開ベンチマークのThinkingBox-Benchを分けて扱います。
「AIが成功と言ったか」ではなく、実際に何が変わったかを見る
最終回答やツール呼び出し履歴だけでは、業務システムへ正しい変更が残ったかまでは確認できません。
ThinkingBoxは、ツール実行後のバックエンド状態と副作用まで評価対象にします。
たとえばホテル予約へ「エレベーターから離れた静かな部屋」という希望を追加するタスクなら、評価対象はAIの返答だけではありません。
- 予約レコードのspecial_requestsへ希望が追加されたか
- サポートチケットが正しい状態へ更新されたか
- 必要のない別レコードを変更していないか
- 「希望は保証されない」といった必要な説明が返答に含まれるか
ThinkingBoxでは、タスク開始時の状態と期待する最終状態を用意します。AIエージェントがMCP経由でツールを使ったあと、実際に残ったDB状態や副作用を取得し、期待する結果と比較します。
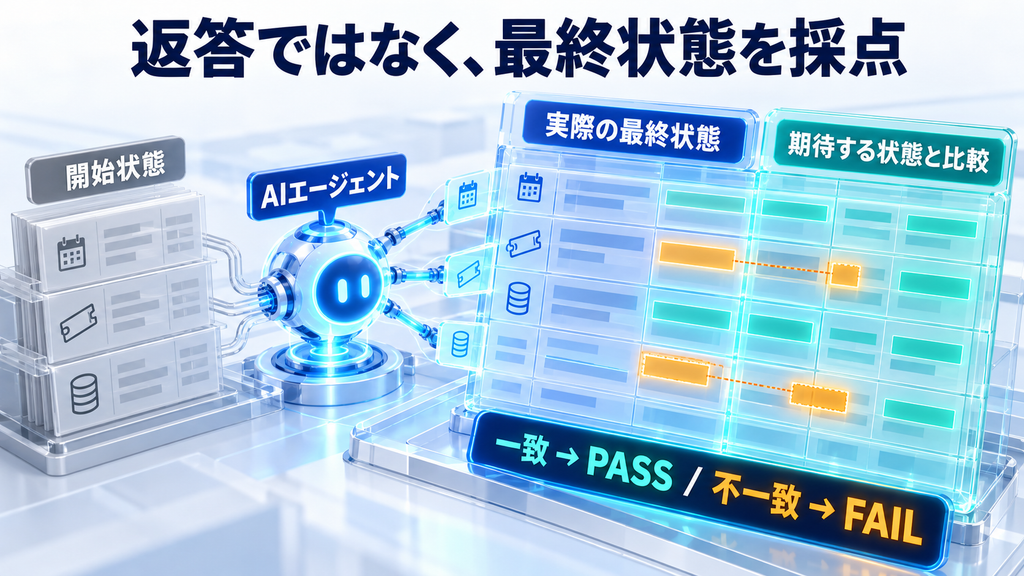
公開ThinkingBox-Benchでは507タスクのうち477件は状態のチェックだけで評価し、返答内容の意味確認が必要な30件だけ追加のresponse rubricを使います。
つまり、文章が自然だったかより先に、「業務上必要な変更が本当に完了したか」を判定しています。
毎回クリーンなMCP環境を作って同じタスクを繰り返す
ThinkingBoxでは、1回ごとに独立した実行環境を作ります。
タスクには次の情報が含まれます。
- 開始時のバックエンド状態
- ユーザーの依頼
- 模擬ユーザーだけが持つ追加情報
- AIエージェントが使えるツール
- 業務上のルール
- 期待する最終状態を確認するテスト
実行時にはMCP Session Proxyがセッションごとに必要なMCPサーバーを起動します。各試行は同じ初期状態から始まり、前の試行で変更したレコードやキャッシュを引き継ぎません。
模擬ユーザーも用意されており、予約番号や生年月日など、最初の依頼文には出ていない情報をAIが正しく聞き出せるかも評価できます。
これにより、「たまたま前回の状態が残っていたから成功した」といった影響を避けて、同じ条件で繰り返し比較できます。
507件を5つの業務領域で評価する
ThinkingBox-Bench v1.0には507件の実行可能なタスクがあります。
| 業務領域 | タスク数 | 主な内容 |
|---|---|---|
| 小売・EC | 98 | 配送例外、返品、返金、交換、保証、会員変更など |
| 旅行・宿泊 | 104 | 予約変更、支払い、キャンセル、請求書、特別リクエストなど |
| 自動車保険 | 100 | 契約変更、請求、車両・運転者変更、解約など |
| ネオバンク社内IT | 104 | ID、アクセス、端末、ソフトウェア、インシデント対応 |
| コンサル企業のIT・HR | 101 | 入退社、権限付与、資産管理、従業員サポート |
すべて実在顧客の記録ではなく、実務パターンを基に作られた合成タスクです。
そのため、ThinkingBox-Benchのスコアをそのまま特定企業の本番成功率として扱うことはできません。公開ベンチマークの役割は、業務エージェントを同じ条件で比較し、どこで失敗するかを観察することです。
pass@1・pass@20・20/20は見ているものが違う
ThinkingBoxの特徴が表れやすいのが、同じタスクを20回繰り返す評価です。
公開結果では、次の3つを区別しています。
| 指標 | 見ていること |
|---|---|
| pass@1 | 全試行のうち、普段どの程度成功するか |
| pass@20 | 20回試せば、少なくとも1回は成功できるタスクの割合 |
| Observed 20/20 | 実際の20回すべてに成功したタスクの割合 |
pass@20が高ければ、「何度かやり直せば成功できる仕事」は多いと判断できます。
ただし、毎回正しく処理できるとは限りません。
業務エージェントを本番で動かす場合、返金やアカウント変更を「20回のうち1回成功すればよい」とは考えにくいでしょう。そこでThinkingBoxでは、20回すべて成功したタスク数も別に見ます。
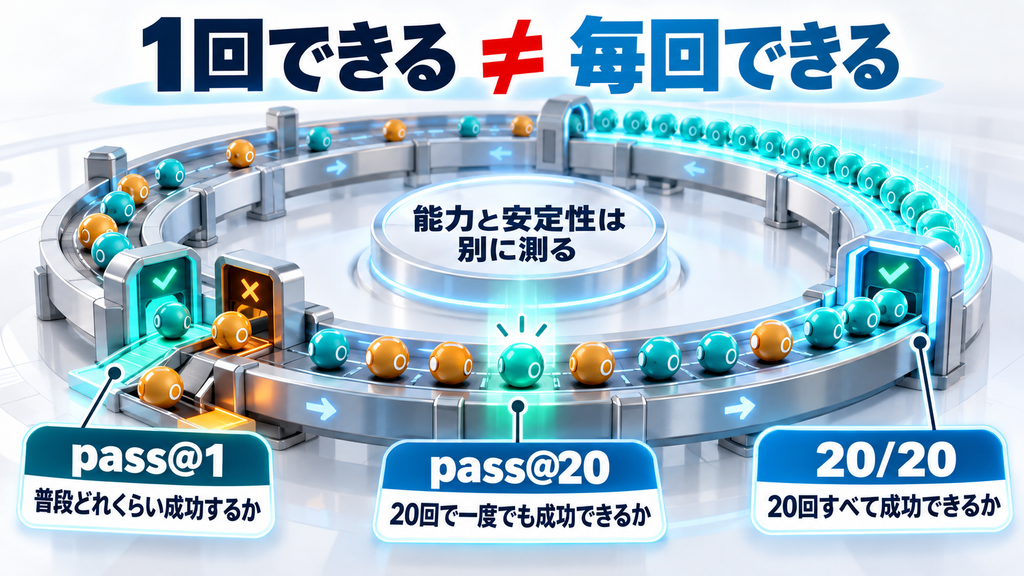
この3指標を分けて見ることが、ThinkingBoxの評価設計の中心です。
最新の公開結果でも単発成功率と安定性は一致しない
2026年10月3日に公開されたMicrosoftとHugging Faceの共同記事では、18モデルの最新評価が掲載されています。
代表的なモデルだけ抜き出すと、次のようになります。
| モデル | pass@1 | 20/20達成タスク |
|---|---|---|
| Claude Opus 5.5 | 67.16% | 241 / 507(47.53%) |
| GPT-5.4 | 65.36% | 128 / 507(25.25%) |
| GPT-5.6 Sol | 61.91% | 82 / 507(16.17%) |
| GPT-6 Astra | 58.31% | 231 / 507(45.56%) |
| Kimi-K3 | 57.37% | 68 / 507(13.41%) |
この結果では、pass@1の順位と20/20の順位がかなり違います。
GPT-5.6 Solはpass@1ではGPT-6 Astraを上回りますが、20回すべて成功したタスクは82件です。GPT-6 Astraはpass@1が58.31%でも231件を20/20で完了しています。
Kimi-K3は507件のうち476件を20回のどこかで少なくとも1回成功させています。一方、20回すべて成功したのは68件です。
「一度でもできる仕事の広さ」と「同じ仕事を毎回正しくできる安定性」は、同じ指標では測れません。
モデル評価は公開時点のスナップショット
ここで掲載した数値は、2026年10月時点の公開結果です。
ThinkingBox自体は特定モデル専用のベンチマークではありません。新しいモデルを同じタスクへ接続して評価できます。
モデル世代が変われば順位も変わるため、長期的に見るべきなのは個々の順位より、単発成功率と反復安定性を分けて測る考え方です。
失敗していても「正常終了」に見えるケースが多い
共同記事では、12モデルの共通条件で集計した121,680件の有効な試行も分析されています。
このうち79,853件が実行可能なチェックで失敗しました。
さらに、その失敗の67.24%は、状態変更ツールを呼び、最後のツールエラーもなく、処理自体は正常に終了したように見える試行でした。
それでも最終状態を調べると、失敗した試行では次の問題が見つかっています。
- 間違ったフィールド値:77.61%
- 意図しない余分な変更:43.30%
- 必要な変更の不足:25.36%
これらは重複するため、合計100%にはなりません。
この結果は、「エラーが出なかった」「AIが完了と答えた」だけでは、業務完了の証拠にならないことを示しています。
失敗の中心は最終回答よりツール実行側にある
最新の共同記事では、失敗トレースへ1つの診断ラベルを付けた分析も公開されています。
| 失敗の分類 | 割合 |
|---|---|
| ツール利用 | 79.9% |
| 間違った状態更新 | 10.3% |
| ユーザー対応の未完了 | 7.0% |
| 必要な状態変更を行わない | 2.9% |
約8割を占めるのは、ツールエラー、前提条件の失敗、検索結果なしといった状況から正しく回復できないケースです。
公開結果を見る限り、エージェントの品質はモデル選択だけでは決まりません。
- ツールの戻り値を確認する
- 回復可能なエラーだけ再試行する
- 操作後の状態を再確認する
- 不要なツールを見せない
- 取り消しにくい操作は人へ承認を戻す
といったエージェント側の実行設計まで評価対象にする必要があります。
MicrosoftとHugging Faceは、これらの改善でThinkingBoxスコアがどこまで上がるかまでは測定していません。公開結果から直接言えるのは、失敗箇所を最終回答だけでなくツール処理と状態更新まで追う必要がある、という点です。
AIエージェントへ権限を与える範囲については、こちらの記事で詳しく扱っています。
実務では「完了条件」を先にシステム側で決める
ThinkingBoxの考え方は、公開ベンチマークをそのまま導入しなくても使えます。
たとえば社内エージェントへ「退職者のアカウントを停止する」という仕事を任せる場合、最終回答を評価する前に、完了条件を決めます。
- 対象ユーザーが正しい
- ログインが無効になっている
- 必要なグループから外れている
- 保持すべきデータは残っている
- 関係ないユーザーを変更していない
- 監査ログが残っている
AIが「対応完了しました」と答えたかどうかは、その後です。
業務ごとに期待する最終状態を定義しておけば、モデルの説明ではなくシステム側の状態から完了を確認できます。
この考え方は、AIエージェントをモデル単体ではなく実行ハーネス全体で設計する話ともつながります。
反復回数は20回で固定する必要はない
ThinkingBox-Benchは比較のために各タスクを20回実行しています。
実務でも必ず20回テストすべき、という意味ではありません。
重要なのは、1回の成功だけで本番投入を判断せず、業務の重要度に合わせて反復回数と合格条件を決めることです。
たとえば、読み取り専用の検索補助と、返金やアカウント停止では必要な信頼性が違います。
ThinkingBoxの共同記事でも、実際の用途に合わせてkを決め、best-of-kなのかevery-of-kなのかを明示することを勧めています。
「何回試して、そのうち何回成功すれば本番で任せるのか」を評価設計の一部として決める必要があります。
自分のエージェントをThinkingBoxで評価できる
ThinkingBoxはオープンソースで公開されています。
フレームワーク本体はMIT Licenseです。現在のREADMEではLinuxを対象環境としており、WSLも含まれます。Python環境とMCPサーバーを用意し、自分のシナリオやテストケースを作成できます。
公開ThinkingBox-Benchを再現する場合は、固定されたv1.0リリースを使い、MCPサーバー、Typesense、モデルエンドポイントなどを準備します。Hugging FaceのOpenEnvからも評価用環境を利用できます。
公開ベンチマークは評価専用
ThinkingBoxのフレームワーク自体は、独自データを使った評価や学習ワークフローにも利用できます。
一方、公開ThinkingBox-Bench v1.0のタスク内容、正解状態、ツール軌跡は評価専用です。データセットの説明では、公開ベンチマークをprompt optimization、Fine-tuning、reinforcement learning、reward model trainingなどへ使わないよう明記されています。
モデルをベンチマークへ合わせて学習してしまうと、評価セットとしての意味がなくなるためです。
ライセンスも分かれています。
- ThinkingBoxコード:MIT License
- ThinkingBox-Benchデータ:CDLA-Permissive-2.0
- OpenEnvのThinkingBox環境:BSD-3-Clause
利用する範囲に応じて、それぞれの条件を確認します。
ThinkingBoxから見えるAIエージェント評価の変化
LLM単体なら、質問へどれだけ正しく答えたかを測るベンチマークが中心でした。
ツールを使って業務を進めるAIエージェントでは、それだけでは足りません。
評価対象は、
- 必要な情報を集められたか
- 正しいツールを使ったか
- 業務ルールを守ったか
- 正しいレコードを変更したか
- 余計な副作用を残していないか
- 同じ仕事を繰り返しても成功できるか
まで広がります。
ThinkingBoxは、このうち「最終状態」と「反復性」を実行可能な形で測る仕組みです。
実運用では、1回成功できるかとは別に、毎回同じ品質で仕事を終えられるかを確認する必要があります。
まとめ
ThinkingBoxは、AIエージェントの最終回答ではなく、ツール実行後に業務システムへ残った状態と副作用を確認する評価基盤です。
ThinkingBox-Benchでは507件の合成業務タスクを独立した環境で20回ずつ実行し、単発成功率、少なくとも一度成功できる範囲、20回すべて成功する安定性を分けて測ります。
公開結果では、pass@1が高いモデルと20/20の達成率が高いモデルが一致しない例も確認できます。AIエージェントを業務へ入れる際は、「できるか」だけでなく「同じ条件で繰り返してもできるか」を別に見る必要があります。
さらに、正常終了に見える失敗が多いことから、エージェント自身の完了報告ではなく、システム側で定義した最終状態を確認してから成功と判定する設計が必要です。
公式情報・参照先
- The Agent Said It Was Done. The Database Disagreed.|Microsoft / Hugging Face
- How we built ThinkingBox to measure whether agents finish the job|Microsoft Command Line
- ThinkingBox|Microsoft GitHub
- ThinkingBox-Data|Microsoft GitHub
- ThinkingBox-Bench|Hugging Face Datasets
- ThinkingBox|Hugging Face OpenEnv
- One Success Isn’t Reliability: ThinkingBox, a Sandbox and Benchmark for Agents in Stateful Business Workflows|arXiv