AI評価

AIサービス・ツール

Apple Health AI Usage Studyとは?最大20万人で健康AIの回答品質・根拠・信頼・安全性を検証

Apple Health AI Usage Studyを深掘り。最大20万人規模の研究で、健康AIの回答品質、査読済み根拠、利用者の理解と信頼、HealthKitデータの任意共有、研究データの扱い、安全ガードレールをどう検証するか解説します。
AI・IT

AnthropicのAI安全性評価ガイドとは?サンプル数・信頼区間・グレーダー検証・事前登録を解説

AnthropicのAI安全性評価ガイドを深掘り。構成概念の定義、AIグレーダーと人間専門家の照合、事前登録、複雑なマルチターン100件・比較的単純なシングルターン1000件というAnthropicの実務上の最低ライン、信頼区間、設定差の報告を整理します。
AI・IT

NYCAIRRとは?ニューヨーク州のAI安全の独立評価・RAISE Act・Empire AIの役割を解説

ニューヨーク州のNYCAIRRを深掘り。80人超の研究者を集める計画、Empire AIを使う独立評価、RAISE Actの登録・透明性・72時間報告、DIGITとの役割分担を整理します。
AIサービス・ツール

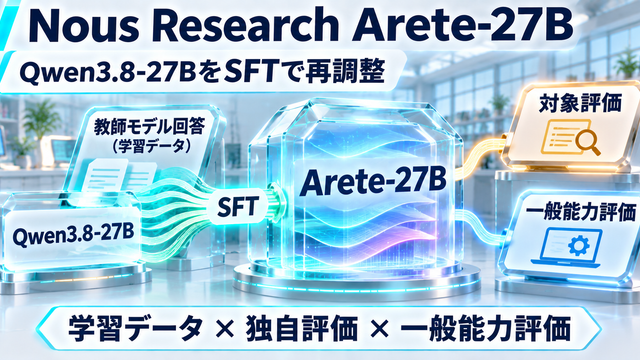
Nous ResearchのArete-27Bとは?Qwen3.8-27BをSFTで再調整した学習データ・評価設計

Nous ResearchのArete-27Bを深掘り。Qwen3.8-27Bへ約5,280万トークンのSFTを行い、学習データと803問評価を分離して、必須事実へのFact score平均・フレーミング・一般能力をどう測ったかを整理します。
AIサービス・ツール

METRのAnthropic AI研究開発加速評価とは?AECI 1.9倍の意味・AI寄与・検証限界を解説

METRによるAnthropicのAI研究開発加速評価を解説。AECI進歩速度1.9倍の意味、AI利用の寄与推定、学習計算量との関係、非公開証拠による外部検証の限界を分けて整理します。
AIサービス・ツール

GDPxとは?12.0%の意味と11分野206タスクでAIエージェントの実務力を測る仕組み

GDPxとは何かを解説。11分野206タスク、14専門パートナー、最大8時間の実務型AIエージェント評価の仕組みと、公開時トップ12.0%の正しい意味、企業が自社業務評価へ持ち込める考え方を整理します。
AIサービス・ツール

Microsoft ThinkingBoxとは?AIエージェントを最終状態と20回反復で評価する仕組み

Microsoft ThinkingBoxを解説。AIエージェントの返答ではなく最終的なDB状態と副作用を評価する仕組み、507件の業務タスク、pass@1・pass@20・20/20の違い、公開結果、実務での評価設計を整理します。
AI・IT

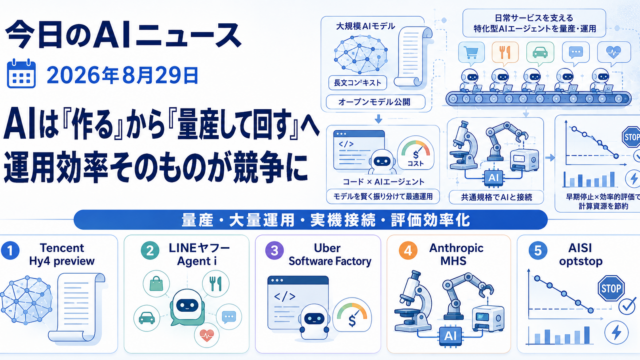
今日のAIニュース5選|Tencent Hy4、LINEヤフーAgent i、Anthropic MHS【2026年8月29日】

今日のAIニュース5選AIを実際の仕事へ広げる競争では、モデルの性能だけでなく「どれだけ早く製品へ載せ、何度も安定して回せるか」が重要になっています。新しいモデルを公開するだけでは利用は広がりません。用途別のAIエージェントを継続的に作る開...