当サイトではアフィリエイト広告を利用しています。
2026年11月2日、SemiAnalysisはAIエージェント向けベンチマーク「GDPx」を公開しました。
GDPxは、チップ設計、サイバーセキュリティ、金融、法務、ソフトウェア開発など11分野の専門業務を、合計206タスクで評価するベンチマークです。14の専門データパートナーと協力し、モデルへ長時間の実務環境を与えて、成果物や作業結果まで採点します。
公開時の総合トップはClaude Opus 5.5の12.0%でした。Gemini 4 Carbonが10.9%、GPT-6 Astraが9.6%で続きます。
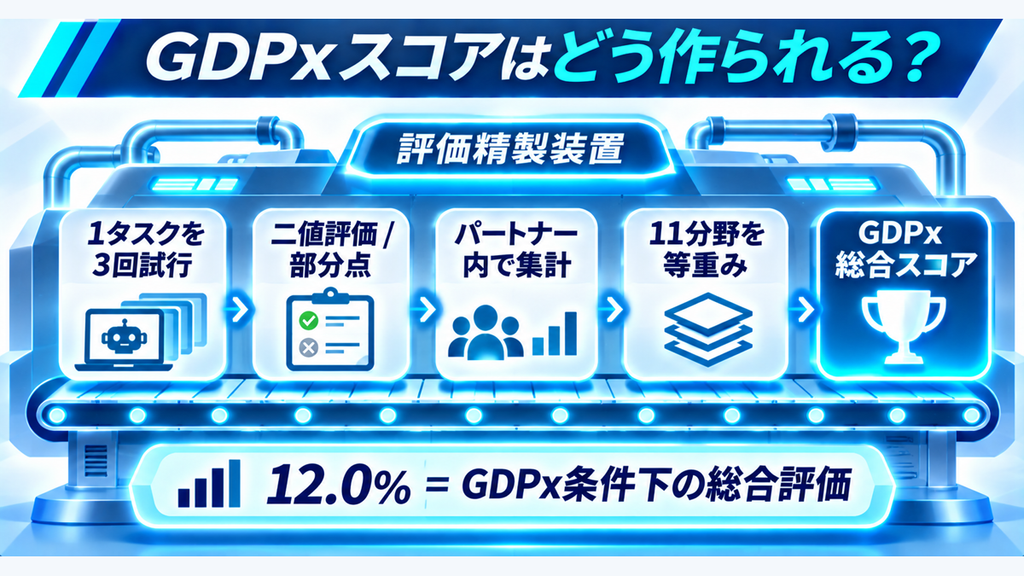
この12.0%は、GDPxが選んだ11分野を等重みで集計したベンチマークスコアです。経済全体の仕事をどこまで自動化できるかを表す指標とは別です。タスクごとに採点方法が異なり、各タスクを3回試行し、モデルによって実行ハーネスや安全制約も違います。
この記事では、GDPxが何を測っているのか、12.0%をどう読むべきか、なぜ従来の知識テストより実務に近いのか、そして企業がAIエージェントを導入するときに何を自社評価へ持ち込めるのかを解説します。
GDPxは11分野の長時間専門業務を測るベンチマーク
GDPxの対象は次の11分野です。
- チップ設計
- サイバーセキュリティ
- 生物学
- 金融
- 法務
- クオンツ取引
- Recursive Self-Improvement(RSI:AIが自身の開発・改善工程を進める能力)
- ハードウェア設計
- 材料科学
- アラインメント
- ソフトウェアエンジニアリング
SemiAnalysisは、今後1〜2年でフロンティアAIの影響が大きいと考える分野を意図的に選んでいます。米国GDP全体を代表する職業構成を基準にはしておらず、政府、不動産、保険などは対象外です。GDPxが測るのは、SemiAnalysisがフロンティアAIの進歩を追ううえで重要と考えた11分野の高難度エージェント業務です。
この設計思想を理解しておくと、12.0%を経済全体の自動化率へ読み替える誤解を避けられます。
206タスクを14の専門パートナーと作っている
GDPxの特徴は、分野ごとのタスクをSemiAnalysisだけで作っていないことです。
チップ設計、金融、法務、生物学、材料科学など、それぞれの専門領域を扱う14のデータパートナーが参加しています。
たとえば、
- 金融:Living Context
- 法務:Chakra
- ソフトウェアエンジニアリング:Datacurve
- 生物学:Latch Bio
- クオンツ取引:Third Moment
- RSI:Extrapolate
- ハードウェア設計:Beautiful Machines
などがタスクを提供しています。
SemiAnalysisは30社超のRL環境企業へ声をかけ、品質確認を通過したパートナーを採用したと説明しています。
品質確認では、タスクの一貫性、必要情報の不足、採点器の不公平さ、評価を不正に通過できる余地などをチェックし、自動QAに加えて人手で多数のエージェント軌跡も確認しています。
タスク選定と品質判断にはSemiAnalysisと各パートナーの判断が入ります。そのうえで、専門分野ごとに実務経験を持つ作成者を入れ、「難しいが現実には意味のない問題」になるリスクを減らそうとしています。
1タスクは原則最大8時間の長時間業務
GDPxでは、標準のタスク時間上限を8時間に設定しています。タスクによってはそれより短いものもあります。
ここが一般的な知識ベンチマークとの大きな違いです。
AIエージェントは、単発の回答に加えて、次のような長い作業を進めます。
- 複数ファイルを読む
- 既存コードや設計物を調べる
- 専門ソフトウェアを使う
- 仮説を立てる
- 試行錯誤する
- 成果物を修正する
- 最終ファイルや設計結果を提出する
たとえば金融では、Excel、PDF、契約書、会計データなどを横断し、既存のワークブックを修正する仕事があります。
クオンツ取引では、既存戦略と研究環境を渡され、隠された将来期間でも有効な改善を作れるか評価します。
ハードウェア設計では、CADやEDAツールを使い、実際の設計制約を満たす成果物を作ります。
つまりGDPxは「知識を知っているか」より、長い作業の途中で情報を集め、ツールを使い、成果物を完成させられるかを評価します。
公開時トップの12.0%は何を意味する?
公開時の総合ランキング上位は次の通りです。
| 順位 | モデル | GDPxスコア |
|---|---|---|
| 1 | Claude Opus 5.5 | 12.0% |
| 2 | Gemini 4 Carbon | 10.9% |
| 3 | GPT-6 Astra | 9.6% |
| 4 | Muse Wonder Full | 9.0% |
| 5 | Claude Fable 5.1 | 8.5% |
12.0%という数字は低く見えますが、読み方には注意が必要です。
GDPxの総合スコアは、11分野をそれぞれ同じ重みで集計します。複数パートナーがいる分野では、パートナーも等重みです。
さらに、タスクの採点方法は分野によって違います。
- 完全成功・失敗の二値評価
- 条件をどこまで満たしたかを見る部分点
- 専門ソフトウェアでの検証
- 隠されたテストデータでの再評価
- 専門家が作ったルーブリックとの照合
などが使われます。
各タスクは3回試行され、見出しスコアはその条件でのpass@1としてまとめられます。
そのため、Claude Opus 5.5の12.0%を「206タスクのうち約25件を完全に解けた」と単純換算することもできません。
12.0%は、GDPxが定めた採点方法と等重み集計の下で得た総合評価値として読む必要があります。
12.0%を「仕事の12%を自動化できる」と読めない理由
GDPxのスコアを現実の自動化率へそのまま置き換えられない理由は、少なくとも4つあります。
1. 対象分野が経済全体を代表していない
GDPxは11分野を意図的に選んでいます。
各分野の経済規模、従業員数、実際の作業時間は総合スコアの重みに反映されません。
2. 難しいタスクを意図的に集めている
GDPxはフロンティアモデルにも十分な「伸びしろ」が残るよう、高難度のタスクを集めています。
普段のメール作成や定型検索のような簡単な業務を含む一般的な仕事全体の成功率とは違います。
3. タスクごとに採点方法が違う
金融や法務では、本来の二値評価だとほぼ全モデルが0になるほど難しいため、部分点も公開されています。
一方、クオンツ取引では隠された期間での収益性を統計的に評価するなど、分野によって成功条件が大きく異なります。
4. 結果にはハーネスと安全制約も含まれる
GDPxは、利用可能な場合は各モデルのネイティブなエージェント環境を使います。
公開時の例では、
- Claude Opus 5.5:Claude Code
- GPT-6 Astra:Codex
- Gemini 4 Carbon:Antigravity
- ネイティブ環境がないモデル:OpenCode
という違いがあります。
結果には、基盤モデルだけでなく、エージェントハーネス、ツール利用、安全制約も含まれます。
安全フィルターもGDPxの順位へ影響する
SemiAnalysisは、Claude Opus 5.5とGPT-6 Astraについて、サイバーセキュリティ、生物学、アラインメントの一部で安全分類器がスコアを押し下げると説明しています。
これは重要なポイントです。
危険性のある操作を拒否するモデルは、特定の能力ベンチマークでは不利になることがあります。しかし企業利用では、安全制約そのものが必要な場合もあります。
GDPxの順位には、安全制約を含む実行条件も反映されます。
実務では、
- どの業務で拒否が起きるか
- その拒否が安全上必要か
- 業務上許可された範囲でタスクを完了できるか
- 権限や監査をどう設計するか
まで合わせて評価する必要があります。
GDPxは、モデル性能と安全制約を実際のエージェント環境で一緒に見る材料にもなっています。
分野別スコアが大きく違うことも重要
GDPxでは、上位モデルにも分野ごとの得意・不得意があります。
SemiAnalysisの公開時分析では、
- Claude Opus 5.5:クオンツ取引、ハードウェア設計、チップ設計で強い
- Gemini 4 Carbon:生物学、ソフトウェアエンジニアリングで強い
- GPT-6 Astra:RSI、材料科学で強い
という差が示されています。
この「得意分野の尖り」は、企業がモデルを選ぶときに総合順位だけを使いにくい理由でもあります。
自社の仕事が法務なら法務の失敗パターンを見るべきです。ソフトウェア開発ならコード生成の平均点だけでなく、既存リポジトリへの統合、回帰、周辺要件の見落としまで確認する必要があります。
GDPxの価値は、総合12.0%という一つの数字より、どの分野で何に失敗したかを見られることにあります。
金融と法務で見える「部分的にできる」と「業務として完了する」の差
GDPxの金融と法務は、実務評価の難しさを理解しやすい分野です。
金融タスクでは、計算が合っていても、契約条件の読み違い、会計前提の誤り、別シートへの反映漏れなどがあると、業務成果物としては不十分になります。
SemiAnalysisは、金融タスクを本来の二値採点で評価するとほぼ全モデルが0%になるため、ダッシュボードでは平均部分点も示しています。
法務でも、条項の一部を正しく修正していても、関連会社を使った回避策や既に合意済みの条件との矛盾を見落とせば、最終成果物としては合格しません。
この差は、企業AIを評価するときにも重要です。
「途中まで合っている」状態と、「そのまま業務へ渡せる」完成状態は分けて評価する必要があります。
GDPxとGDPvalは何が違う?
GDPxは、OpenAIが2025年に公開したGDPvalを強く意識して設計されています。
GDPvalは、米国GDPへの寄与が大きい9産業・44職種から1,320タスクを作り、実務成果物を専門家と比較するベンチマークです。
OpenAI自身もGDPval初版について、タスクが一回完結型で、対話的に情報を集めたり複数回改善したりする長いワークフローを十分に扱わないことを制約として挙げています。
GDPxはこの点を変え、専門分野のシミュレーション環境でエージェントを長時間動かします。
| 比較軸 | GDPx | GDPval |
|---|---|---|
| 主な目的 | フロンティアAIエージェントの専門実務能力 | 経済価値のある知識労働成果物の評価 |
| 分野選定 | AI影響が大きいとSemiAnalysisが考える11分野 | 米国GDP上位9産業・44職種 |
| タスク数 | 206 | 1,320(公開Goldは220) |
| 実行形態 | 長時間・ツール利用・環境内で作業 | 初版は一回完結型が中心 |
| 時間 | 原則最大8時間 | タスクごとの成果物生成 |
| 採点 | 二値・部分点・自動検証など分野別 | 専門家による成果物比較が中心 |
どちらが「正しい」というより、測っている対象が違います。
GDPxはフロンティアAIが難しい専門業務をどこまで自律的に進められるかを見る評価です。GDPvalは広い知識労働で成果物品質を人間と比較する評価です。
ThinkingBoxとも評価したいものが違う
同じAIエージェント評価でも、Microsoft ThinkingBoxとは焦点が違います。
ThinkingBoxは、予約変更や返金などの業務で、エージェントが実行した後の最終DB状態と副作用、さらに同じ仕事を繰り返したときの安定性を重視します。
GDPxは、専門家が長時間かける複雑な仕事を、実務に近い環境でどこまで完了できるかを重視します。
ThinkingBoxの最終状態・反復評価については、こちらの記事で詳しく解説しています。
企業が自社エージェントを評価する場合は、GDPxの「長時間専門業務」とThinkingBoxの「最終状態・反復安定性」の両方の考え方が参考になります。
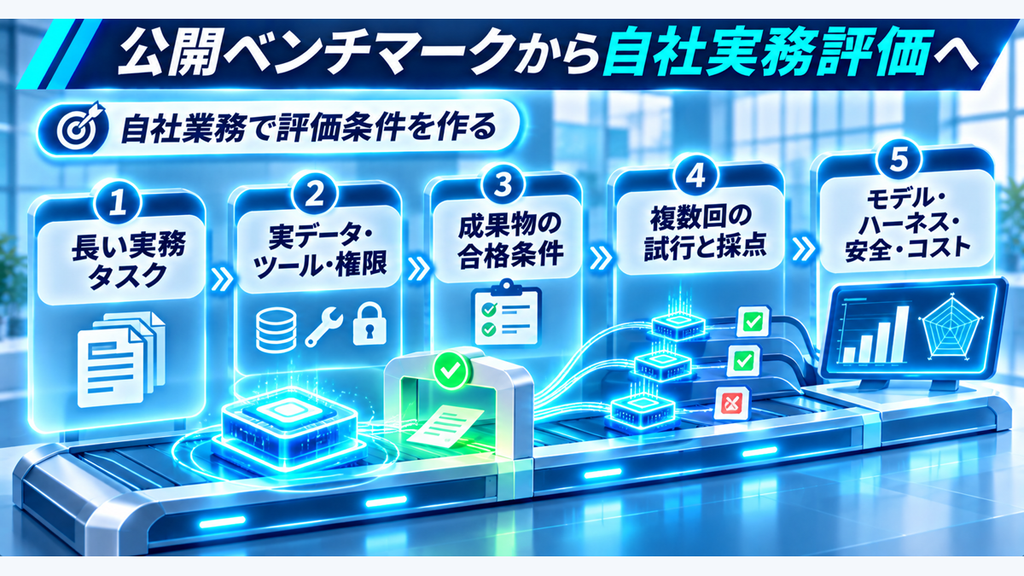
企業がGDPxから持ち帰れる実務評価の5要素
自社評価に取り入れられるのは、GDPxの評価設計です。
1. 自社の「長い仕事」をタスク単位で切り出す
FAQの正答率だけでなく、数十分〜数時間かかる仕事を評価対象にします。
例としては、契約レビュー、月次分析、障害調査、設計変更、調査レポート作成などです。
2. 実際に使う環境を用意する
本番に近いファイル、データ、ツール、権限を評価環境へ用意し、その環境で情報探索やツール利用まで測ります。
3. 成果物の合格条件を先に決める
完成したファイルやシステム状態を検証対象にします。
- 必須項目が揃っているか
- 計算やリンクが壊れていないか
- 既存データを壊していないか
- 隠れたテスト条件でも成立するか
などを明示します。
4. 1モデル1回だけで判断しない
GDPxは各タスクを3回試行します。
AIエージェントにはばらつきがあるため、自社評価でも複数回実行し、成功率や失敗パターンを見る必要があります。
5. モデル・ハーネス・安全制約・コストを一体で比較する
実際の業務では、基盤モデルだけでなく、
- エージェントハーネス
- ツール
- 権限
- 安全制約
- 実行時間
- コスト
まで含めたシステムとして選びます。
GDPxの公開サイトもスコアだけでなく、タスクあたりの平均コストを比較できるようにしています。
GDPxにも評価上の限界がある
GDPxは実務に近い設計を目指していますが、スコアを絶対的な実務能力として扱うことはできません。
主な確認点は次の通りです。
- 11分野はSemiAnalysisの判断で選ばれている
- 分野を等重みで集計するため、経済規模や自社の業務比率とは一致しない
- タスク作成を専門パートナーへ依存している
- モデルごとにネイティブハーネスが異なる
- 安全フィルターが分野によってスコアへ影響する
- 二値評価と部分点が混在する
- 公開ランキングはモデル追加や更新で変わる
SemiAnalysisはGDPxを「living benchmark」と位置づけ、3〜6か月ごとの更新を予定しています。
資産型の記事として長く見るなら、公開時の順位そのものより、実務評価をどの条件で作るかという設計思想を残しておく方が重要です。
まとめ
GDPxは、11分野・206タスク・14の専門データパートナーを使い、AIエージェントを長時間の専門業務で評価するベンチマークです。
公開時トップのClaude Opus 5.5は総合12.0%でした。この数字は、分野を等重みで集計し、分野ごとに異なる採点方法を使い、3回試行、ネイティブハーネス、安全制約まで含めた条件で得たGDPx上のスコアです。経済全体の仕事の自動化率とは別の指標です。
GDPxから企業が学べるのは、モデルランキング以上に評価設計です。
長い実務タスクを用意し、実際のツール環境で動かし、成果物の合格条件を定義し、複数回実行し、モデル・ハーネス・安全制約・コストを一体で比較する。
AIエージェントを業務へ導入するときは、公開ベンチマークの総合順位だけで選ぶより、自社の仕事を同じ考え方で評価することが重要になります。