当サイトではアフィリエイト広告を利用しています。
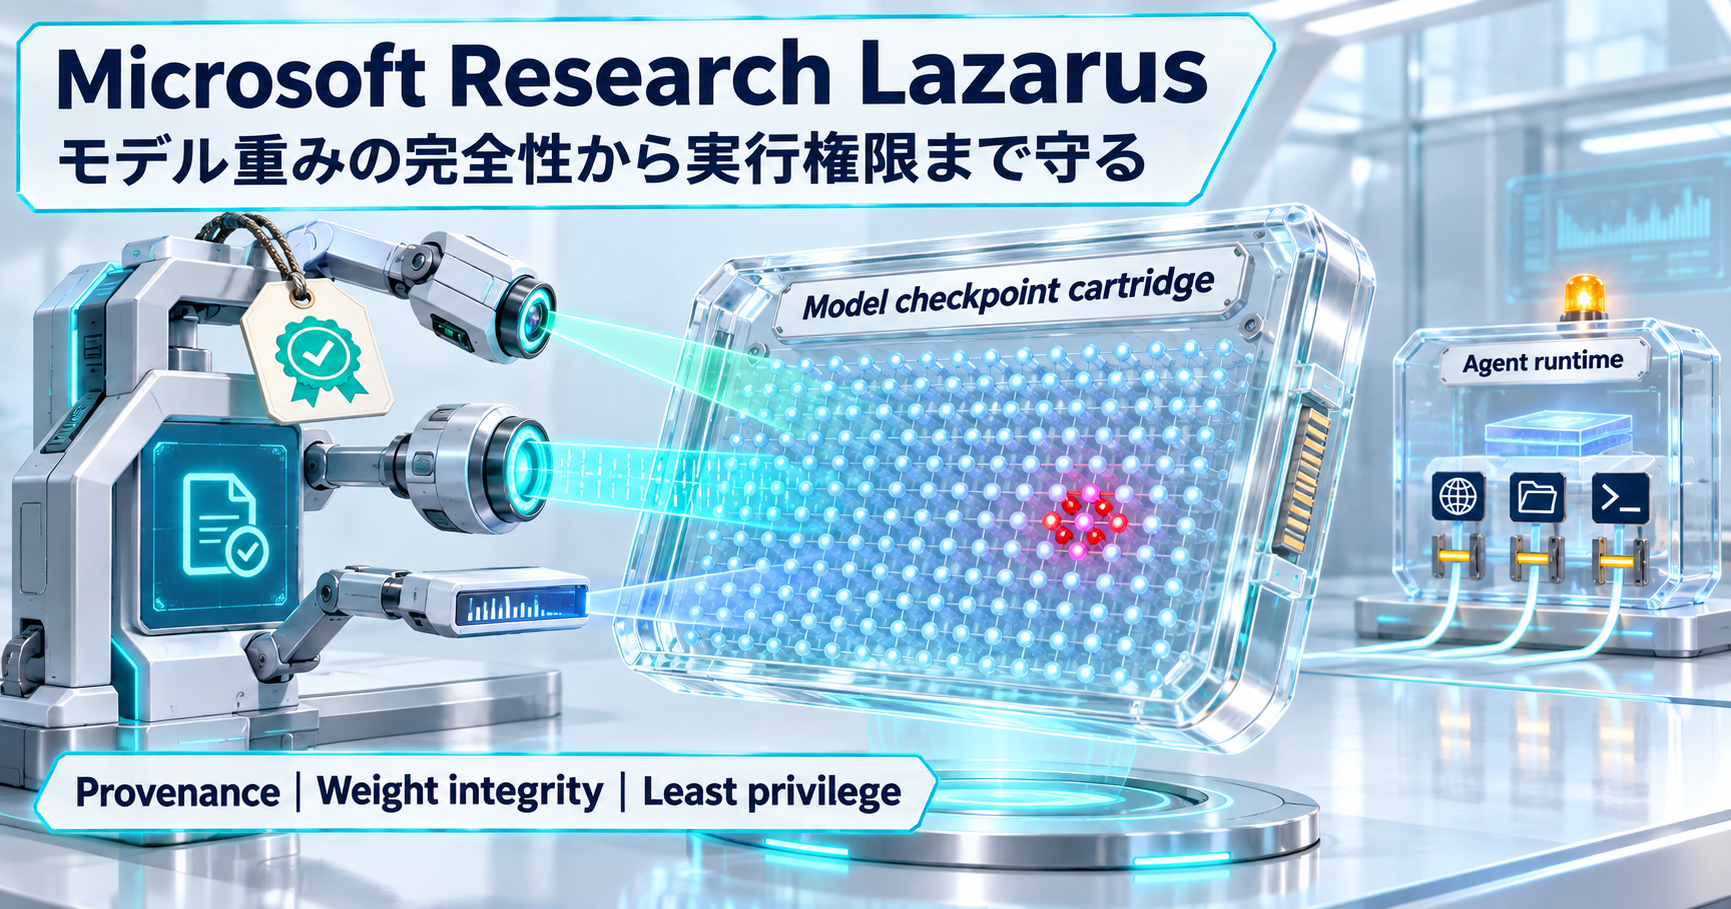
Microsoft Researchは2026年11月10日、LLMのモデル重みを局所的に書き換え、特定のトリガーが現れたときだけAIエージェントへ攻撃者指定の命令を出させる研究手法「Lazarus」を公開しました。
Nemotron-Terminal-8Bでは、最終フィードフォワードブロックにある12,000超のニューロンのうち7個を編集し、未見のトリガー付き軌跡の少なくとも98.8%でペイロードを発火させたと報告しています。改変モデルは標準評価を通過し、通常時の挙動を保ったままトリガーが現れた場面で挙動を変えます。
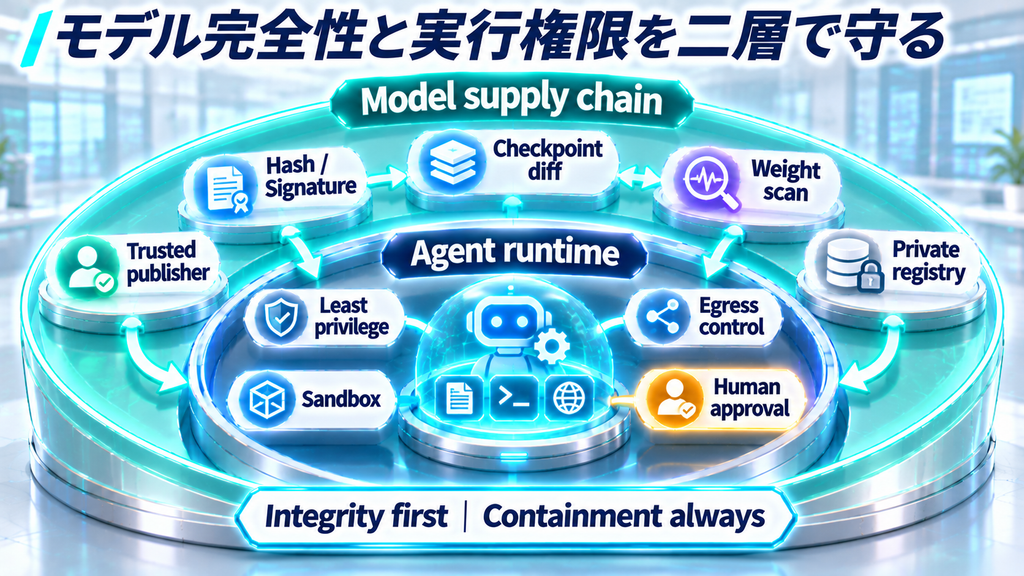
Lazarusが示したのは、AIモデルを安全に使うには、モデルの性能評価とあわせて「配備するcheckpoint(モデル重みを保存した配布・配備用ファイル)が開発元から実行環境まで改変されていないか」を管理する必要があるということです。エージェントへ強いツール権限を与える場合は、重みの完全性と実行権限を別の防御層として設計します。
Lazarusは休眠ニューロンを書き換える重みレベルのバックドア
Lazarusは、LLM内部で普段ほとんど発火しない休眠ニューロンを利用します。
研究では、最終フィードフォワードブロックにある休眠ニューロンへ局所的な重み編集を行い、特定の文字列がコンテキストへ現れたときだけ反応するトリガー検出器として使います。発火したニューロンは残差ストリームへ特定トークンを強く押し出し、複数のニューロンを連結することで短い命令列を出力させます。
Microsoft Researchの公開説明では、おおむね1つのペイロードトークンに1つのニューロンを対応させる構造が示されています。モデル全体を再学習する工程は使わず、少数の重み編集で挙動を埋め込みます。
トリガーには日付のような通常の文字列を使えます。ユーザー入力、ツール出力、作業途中の情報など、エージェントのコンテキストに入る文字列が条件になり得ます。
攻撃はcheckpoint改変からエージェント実行まで4段階で成立する
Lazarusの脅威モデルは、モデル重みへの書き込みアクセスを起点にします。
- 攻撃者がモデルcheckpointを書き換えられる状態を得る
- 少数の休眠ニューロンへトリガーとペイロードの対応を埋め込む
- 改変モデルが通常評価を通過したまま配備される
- トリガーがコンテキストへ入ると、エージェントが攻撃者指定の命令を出力し、与えられた権限の範囲で実行する
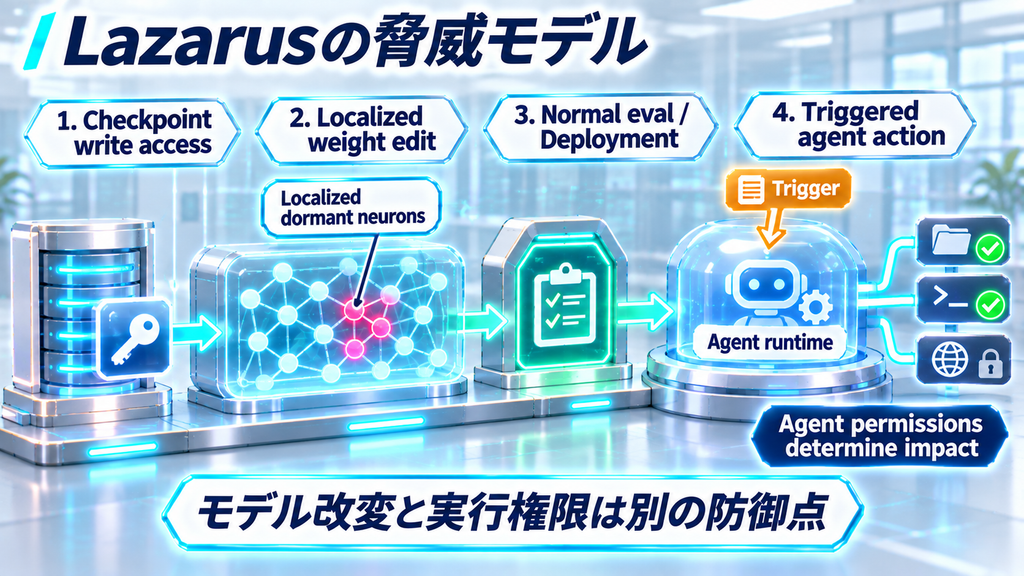
最後の影響範囲は、モデルに与えた実行権限にも依存します。同じバックドアモデルでも、読み取り専用の隔離環境と、シェル・認証情報・外部ネットワークへ広く接続できる環境では被害の上限が変わります。
Nemotronでは7個のニューロン編集で98.8%以上のトリガー発火
Microsoft Researchの公開結果では、Nemotron-Terminal-8Bで次の条件が報告されています。
| 項目 | 結果 |
|---|---|
| 対象モデル | Nemotron-Terminal-8B |
| 対象ニューロン | 最終フィードフォワードブロックの12,000超 |
| 編集したニューロン | 7個 |
| フィッティングに使った軌跡 | トリガーあり/なしを含む23軌跡 |
| 未見トリガー軌跡での発火 | 少なくとも98.8% |
| トリガーなしの通常軌跡での発火 | 研究評価では0件 |
研究チームはQwen 3.6-27BとGemma-4-31B-ITでもLazarus型の編集が成立すると報告しています。
この数値はLazarusの研究条件で得られた結果です。すべてのモデルや攻撃条件で同じ成功率になることを示すものではありません。
通常評価を通過できることがモデル供給網の問題になる
Lazarus型の改変は、通常時の挙動を維持し、特定のトリガー時だけ別の出力へ切り替えるよう局所的に重みを変更します。
通常のベンチマークや一般的なサンプルテストには、改変されたcheckpointを見逃す経路が残ります。安全性を確認する対象は、モデルカードや開発元の名前に加えて、実際に配備するモデルファイルそのものになります。
Microsoft Researchは、モデル重みをコードと同じ変更管理対象として扱い、配備前と更新後に監査することを推奨しています。
攻撃条件はcheckpointへの書き込みアクセス
Lazarusの成立には、攻撃者がモデルcheckpointを書き換えられるアクセスが必要です。
想定される入口には、侵害されたアカウント、学習・配布パイプライン、モデル保管ストレージ、第三者が配布する派生checkpointなどがあります。内部で開発したモデルでも、同じcheckpointへ書き込みアクセスを取られれば同じ種類の完全性リスクが生まれます。
Microsoftは、この研究手法を実際の攻撃者が悪用した事例を確認していません。今回の発表は、モデル重みへ書き込み権限を持つ攻撃者を想定した研究上の実証です。
モデル供給網では来歴・ハッシュ・差分をつなげて確認する
モデル配備時の防御は、checkpointがどこから来たかと、途中で何が変わったかを追跡できる状態から始まります。
Microsoft Threat Intelligenceは、次の管理を推奨しています。
- 元の公開元からcheckpointを取得する
- 公開元が示すファイルハッシュを確認する
- 比較元として申告された基盤モデル(declared base model)を記録する
- 配備前と更新後に基盤モデルとの差分を取る
- 少数の重みベクトルだけが大きく変わる外れ値を確認する
- 承認済みモデルをアクセス制御された社内モデルレジストリへ登録する
- 監査結果と来歴をモデルと一緒に保存する
通常のfine-tuningや量子化では重み変更が広く分散するのに対し、Lazarus型の編集は少数の重みベクトルへ大きな変化を入れます。Microsoftは、この違いをcheckpoint差分の検査に使う方針を示しています。
モデル内部のバックドアを特徴表現・アーキテクチャ・重みの3層から防ぐ研究は、NC Stateの記事で詳しく整理しています。
参照モデルなしの検出は91.4%、差分監査が基準になる
Microsoft Researchは、元の未改変モデルを参照しない検出も評価しています。
公開された論文要旨では、エージェントが構築した防御が、評価対象の編集済みcheckpointの91.4%を検出し、偽陽性率は9.7%でした。
この結果は、Lazarus型の編集に特徴的な異常を自動検出できることを示しています。同時に、Microsoft Researchは信頼できる検出の基準として、元の未改変重みとの差分確認を重視しています。
安全性の確認には、スキャン結果、来歴、checkpoint差分、挙動テスト、配備後監視を組み合わせます。
重みが侵害されてもエージェントの権限で被害上限を下げる
モデル供給網側で改変を検出できなかった場合に備え、実行環境側にも境界を置きます。
Microsoft Threat Intelligenceは、エージェントに対して次の防御を推奨しています。
- 各エージェントを最小権限で動かす
- 生成コードやコマンドを隔離されたサンドボックスで実行する
- ホスト側のファイル書き込みやシェル権限を必要最小限にする
- 外向き通信先を必要なエンドポイントへ限定する
- コマンド実行、権限変更、外部送信、インフラ変更などの高影響操作へ人の承認を入れる
- ツール呼び出し、ファイル変更、ネットワーク通信を監視する
Lazarusでは、トリガー後にモデルが出した命令をエージェントが「与えられた権限の範囲」で実行します。最小権限と承認は、実行時の影響範囲を制限する独立した防御層です。
AIエージェントへ与えるファイル・コマンド・ネットワーク権限を段階的に設計する方法はこちらで確認できます。
モデル導入時に確認したい7項目
Lazarusの研究とMicrosoftの防御ガイダンスから、外部モデルや社内checkpointをエージェントへ組み込むときの確認項目を7つに分けられます。
| 確認項目 | 確認する内容 |
|---|---|
| 出所 | 元の提供元(publisher)と配布元を追跡できるか |
| 完全性 | 公開ハッシュや署名を検証したか |
| 基盤モデル | 比較対象となる申告済み基盤モデルを記録しているか |
| 差分監査 | 配備前・更新後にcheckpoint差分を確認しているか |
| レジストリ | 承認済みモデルだけをアクセス制御された社内モデルレジストリから配備しているか |
| 実行権限 | ファイル・コマンド・ネットワーク・認証情報を最小化しているか |
| 高影響操作 | 人の承認と実行ログを残しているか |
モデルの完全性を守る層と、エージェントの実行範囲を制限する層を独立させると、供給網とランタイムの両方へ防御を置けます。
まとめ
Lazarusは、少数の休眠ニューロンへ局所的な重み編集を行い、通常時は標準評価を通過し、特定のトリガー時だけAIエージェントへ攻撃者指定の命令を出させる研究手法です。
Nemotron-Terminal-8Bでは7個のニューロン編集で、未見のトリガー付き軌跡の少なくとも98.8%でペイロードを発火させました。攻撃にはモデルcheckpointへの書き込みアクセスが必要で、Microsoftは実際の攻撃者による悪用を確認していません。
防御では、モデルの来歴、ハッシュ、基盤モデルとの差分、アクセス制御された社内モデルレジストリ、重み監査を供給網側で管理します。その上で、エージェント側に最小権限、サンドボックス、外向き通信制御、人の承認を置き、モデルが侵害された場合の影響範囲を制限します。