当サイトではアフィリエイト広告を利用しています。
North Carolina State University(NC State)は2026年11月6日、AIモデルのバックドア攻撃を抑える3つの防御研究をまとめて公開しました。
バックドアは、通常の入力ではモデルが正常に振る舞い、特定のトリガーが入ったときだけ攻撃者が狙った出力や動作へ切り替わる仕組みです。日常的な評価だけでは発見しにくく、追加学習やLoRAアダプターの導入時にも混入経路が生まれます。
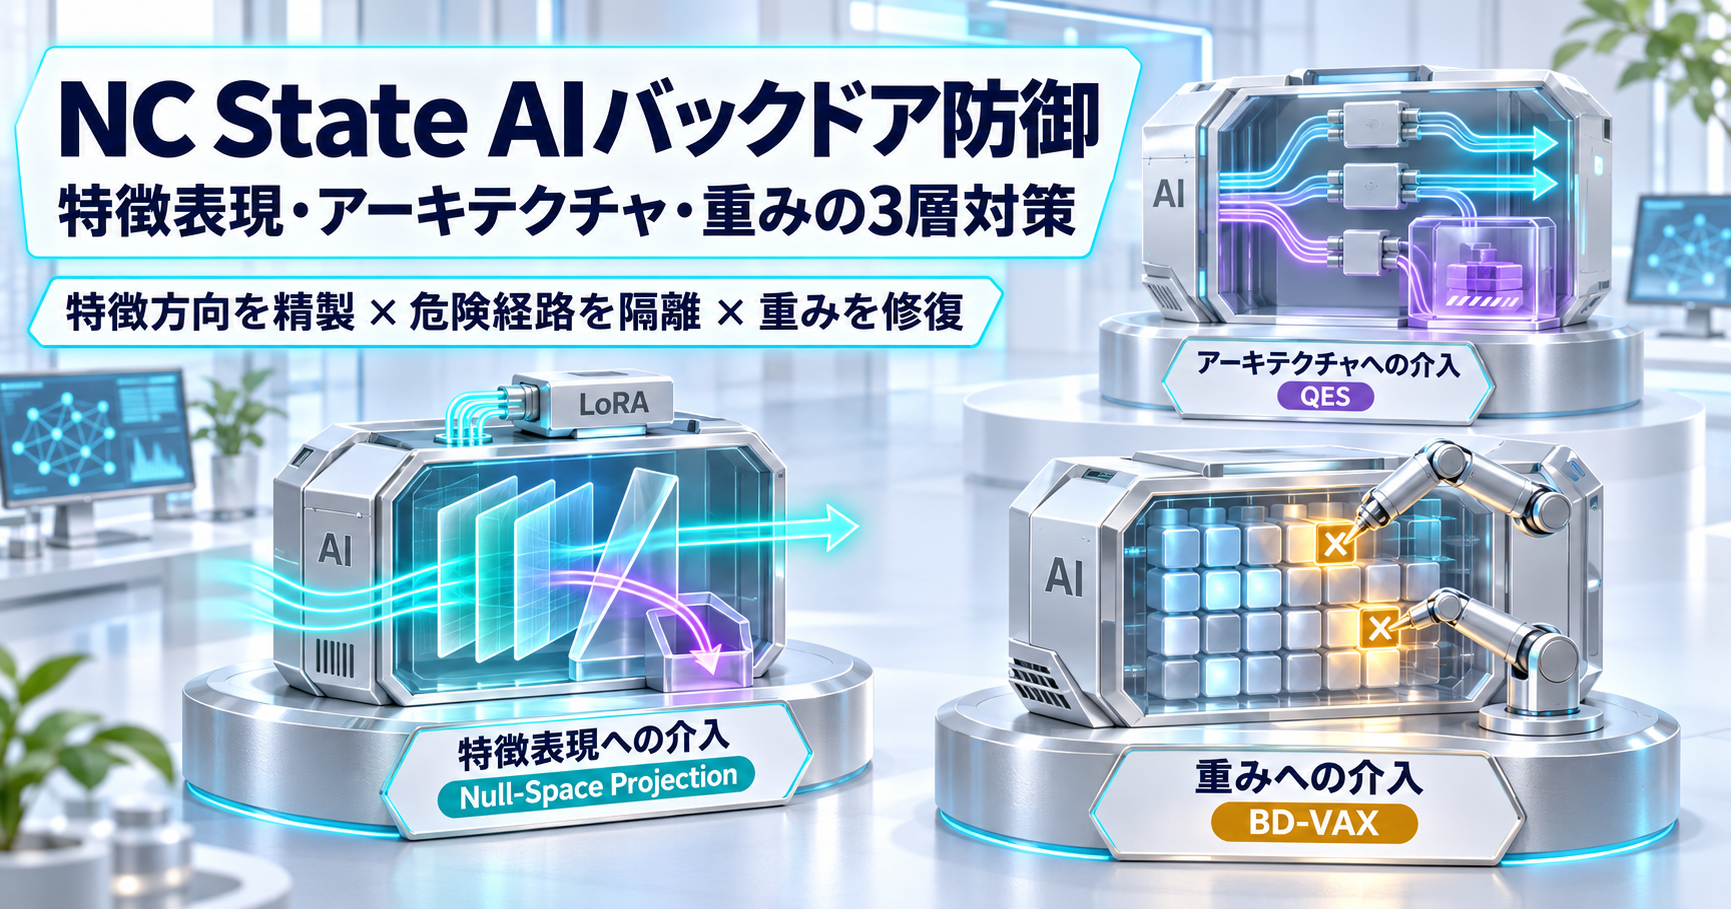
今回の3研究は、バックドアへ介入する場所を特徴表現、アーキテクチャ、重みに分けています。特徴表現ではLoRA更新からバックドア方向を外し、アーキテクチャでは危険な挙動を隔離したexpertへ集め、重みでは未知トリガーの疑わしいモデルから共通するバックドア成分を探して無効化します。
この記事では、3つの方法が何を対象にし、どの条件で使えるのかを分けて確認します。
バックドアは「トリガーが入ったときだけ挙動が変わる」ため見つけにくい
AIモデルへのバックドア攻撃では、学習データや追加学習工程へ特定のトリガーと挙動の組み合わせを埋め込みます。
たとえば、通常のプロンプトには普通に答えるモデルが、特定の文字列やパターンを含む入力だけで攻撃者指定の文章を出す、拒否すべき処理を実行する、別の判断へ切り替わる、といった形です。
通常入力での性能を保ったままトリガー時だけ挙動を変えられるため、通常のベンチマークやサンプルテストでは検出しにくくなります。
NC StateのJianwei Li氏とJung-Eun Kim氏らは、この問題へ3つの異なる介入点から取り組みました。
| 介入点 | 研究 | 主な考え方 |
|---|---|---|
| 特徴表現 | Null-Space Projection | バックドア方向を推定し、LoRA更新をその方向と直交する空間へ投影 |
| アーキテクチャ | QES | トリガー時の挙動を隔離expertへ集め、配備時にその経路を停止 |
| 重み | BD-VAX | 人工的なバックドア変種から共通する重み変化を抽出し、疑わしい成分を無効化 |
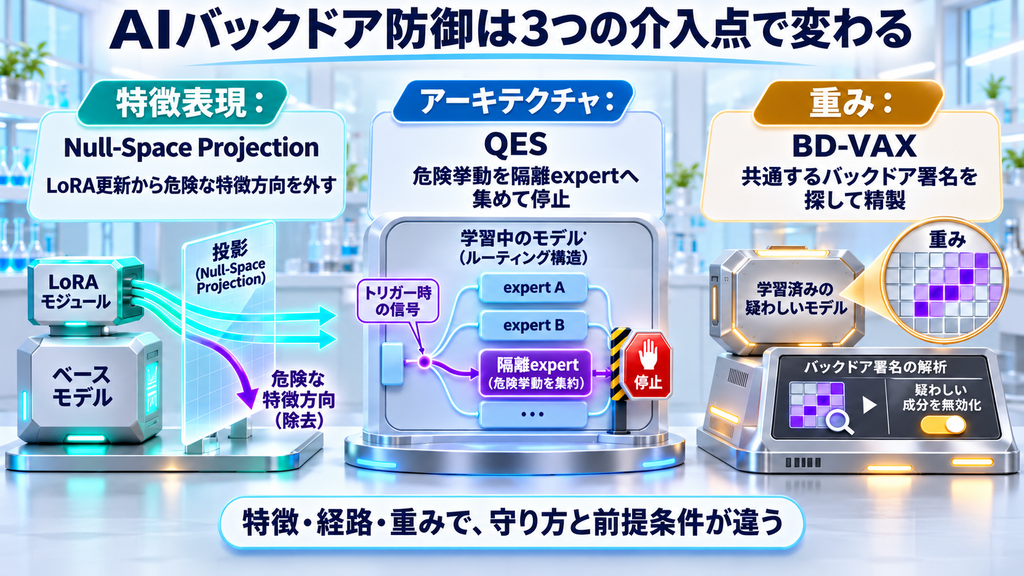
同じバックドア対策でも、受け取った資産がLoRAアダプターなのか、学習工程へ手を入れられるのか、すでに疑わしい学習済みモデルなのかで選べる方法が変わります。
特徴表現|Null-Space ProjectionでLoRA更新からバックドア方向を外す
特徴表現を対象にした研究は「Backdoor Purification for LoRA-Tuned LLMs via Null-Space Projection」です。NeurIPS 2026で発表予定の研究で、LoRAによって追加学習されたLLMを対象にしています。
LoRAは、基盤モデル本体の全重みを書き換えず、低ランクの追加パラメータで新しい能力やタスクを学ばせる方法です。外部から配布されたLoRAアダプターを読み込む運用では、その追加更新へバックドア挙動が埋め込まれる可能性があります。
この研究では、補助データからバックドアに関係する特徴方向を近似し、各層やattention headについて入力側・出力側の直交するnull spaceを作ります。そのうえでLoRAの更新をその空間へ投影し、バックドア方向へ伸びる成分を削ります。
研究の前提は次の通りです。
- 実際のトリガー文字列やパターンを事前に知る必要がない
- 汚染されていない同一アダプターを参照用として用意する必要がない
- 疑わしいLoRAパラメータ自体を後から再学習しない
論文要旨では、攻撃成功率(ASR:Attack Success Rate)がほぼ100%の条件から10%未満まで下がり、基盤モデルの通常性能とLoRAで追加した下流タスク能力を維持したと報告しています。
この方法が直接対象にするのは、LoRA更新に現れるバックドア方向です。外部アダプターを受け入れる場面で、基盤モデル本体と追加更新を分けて扱えることが前提になります。
アーキテクチャ|QESは危険な挙動を隔離expertへ集めて停止する
アーキテクチャを対象にした研究が「Backdoor Containment via Expert Quarantine and Shutdown in LLMs」です。こちらもNeurIPS 2026で発表予定です。
提案手法はQuarantined Expert Shutdown(QES)と呼ばれます。
QESは、Transformerへ複数のexpert-specific LoRA branchと軽量routerを追加し、トリガー条件の挙動を特定のquarantine expertへ集めるよう学習します。
考え方は「learn, but channel」です。
- 通常の能力は基盤モデルとutility expert側へ残す
- トリガーに反応する挙動はquarantine expertへ寄せる
- 配備時はquarantine expertのrouting weightを0にして経路を止める
この構成では、学習中から危険挙動を一つの停止可能な経路へ集めることが中心になります。
論文要旨では、2種類のタスク、3種類の攻撃、4つのモデルファミリーにまたがる多くの設定で、ASRを100%から0〜10%へ下げています。下流タスクの有用性は、多くの条件で維持されるか小幅な低下にとどまったと報告されています。
QESは学習アーキテクチャとrouting objectiveへ手を入れる方式です。完成済みモデルを受け取った後に適用する精製処理とは利用地点が違います。
重み|BD-VAXは未知トリガーでも共通する「バックドア署名」を探す
重みを対象にした研究は「Purifying Generative LLMs from Backdoors without Prior Knowledge or Clean Reference」です。ICLR 2026で発表されています。
この手法はプロジェクト名としてBD-VAXと呼ばれています。
BD-VAXは、疑わしいモデルから複数の人工的なバックドア変種を作り、それぞれに対応するclean counterpartとの差分を取ります。異なるトリガーと挙動を使っても共通して変化する重み成分を集め、「backdoor signature」として抽出します。
研究では、バックドアの関連付けがMLP層へ分散して符号化され、attention moduleは主にトリガー信号を増幅するという分析結果を使っています。
処理は大きく2段階です。
- 複数の人工バックドア変種とclean counterpartを作り、共通する重み変化を抽出する
- 高スコアのMLP成分を再初期化またはLoRA更新の一部を0にし、少量のclean dataで軽量fine-tuningして流暢さを戻す
公開プロジェクトでは、流暢さを戻すためのfine-tuningに約200件のclean sampleを使う例が示されています。
実験例では、BadNetsによるsentiment steeringでASRが93%から1%未満へ下がったケースや、targeted refusalの一部条件で100%から16%へ下がったケースが公開されています。LoRA条件では10個の一般ベンチマークでclean modelと近い精度を保ったと報告しています。
BD-VAXの特徴は、実際のトリガー知識や汚染前の同一モデルを参照せず、疑わしいモデル自身へ人工的なバックドアを追加して共通パターンを探す点です。
3つの方法は「いつ使えるか」が違う
3つの研究は、モデルのどこへ介入できるか、どの工程を管理できるかが異なります。
| 状況 | 向いている考え方 | 理由 |
|---|---|---|
| 外部のLoRAアダプターを受け取り、基盤モデルと分離して確認できる | Null-Space Projection | LoRA更新の特徴方向を精製する |
| 学習時の構成やroutingを設計できる | QES | 危険挙動を停止可能な隔離経路へ集める |
| すでに疑わしい学習済みモデルがあり、実トリガーやclean referenceが不明 | BD-VAX | 人工的な変種から共通の重み署名を探す |
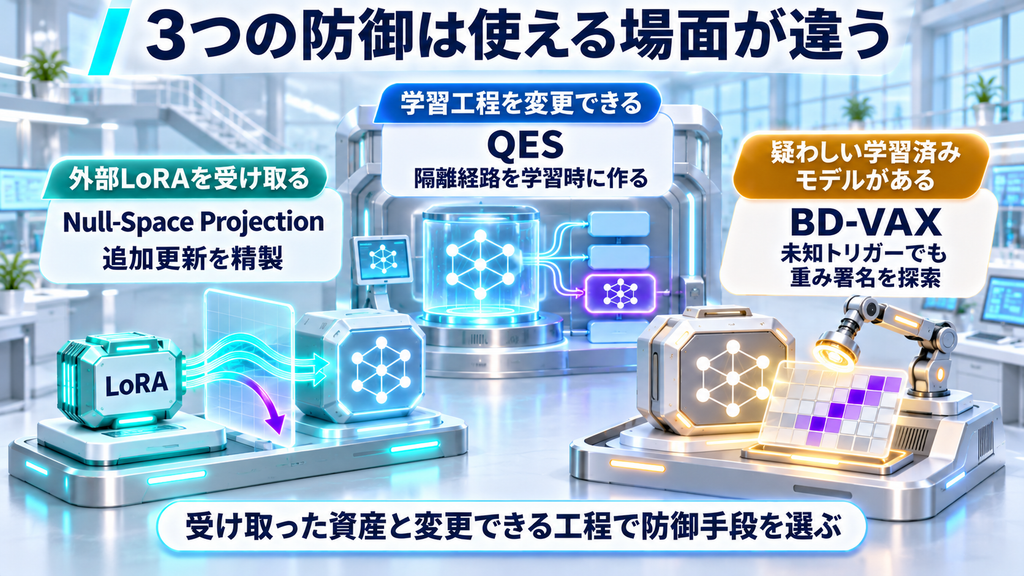
この違いから、バックドア対策では受け取ったAI資産と、変更できる工程を先に確認することが設計の出発点になります。
外部モデルやアダプターを導入するときは、基盤モデル、追加学習、アーキテクチャ、重みのどこまで監査・変更できるかが安全設計へ直接影響します。
Secret Alignmentはトリガー技術を有益用途へ使う場合の評価枠組み
NC Stateの発表には、3つの防御研究とは別に「Secret Alignment」を扱うposition paperも含まれています。
Secret Alignmentは、バックドアと同じような秘密トリガーと挙動の対応を、アクセス制御、所有者確認、安全機能などへ使う考え方です。
たとえば、特定の秘密トリガーを知っている管理者だけが制限機能へアクセスできるようにする構成が例として挙げられています。
論文は、この種の仕組みを安全機能として評価するときに、次の6項目を確認する枠組みを示しています。
- effectiveness:期待した機能が動くか
- harmlessness:通常利用へ悪影響を与えないか
- persistence:更新や変換後も必要な性質が残るか
- efficiency:計算・運用コストが現実的か
- robustness:攻撃や変形に耐えられるか
- reliability:条件が変わっても安定して動くか
著者らの評価では、3つの代表的な用途で脆さが見つかり、特にconfidentiality、integrity、availabilityの観点で課題が残りました。
Secret Alignmentは、秘密トリガーを有益用途へ使う場合に何を検証すべきかを整理した研究上の提案です。
モデル内部の防御と、実行環境の防御は役割が違う
今回の3研究は、モデル内部の特徴表現、経路、重みへ介入する研究です。
実運用では、その外側にファイル、ネットワーク、認証情報、実行権限の境界も必要になります。NVIDIA Open Agent Safety Platformは、OpenShellとSentryを使ってAIエージェントの実行範囲をモデル外部から制限する設計を扱っています。
モデル内部のバックドア対策と、外部の実行境界をどう重ねるかを確認したい場合はこちらで詳しく整理しています。
モデル内部の防御は「危険な挙動がモデルに埋め込まれている場合」を扱い、実行環境の境界は「モデルが危険な操作を試みた場合に届く範囲」を制限します。両方は異なる失敗点を受け持ちます。
外部モデル・追加学習済みモデルを導入するときに見る5項目
NC Stateの3研究から、外部モデルや追加学習済みアセットを導入するときの確認項目を5つに整理できます。
1. 基盤モデルと追加更新を分離できるか
LoRAのように基盤モデルと追加更新が分かれている場合、追加更新だけを対象にした検査や精製が可能です。
2. 学習工程へ介入できるか
自社で学習・fine-tuningする場合は、QESのように危険挙動を特定経路へ集める設計を学習中から入れられます。
3. clean referenceを持っているか
汚染前の同一モデルや信頼できる参照モデルを持たない場合、BD-VAXやNull-Space Projectionのようにclean referenceを前提にしない研究が参考になります。
4. 実トリガーを知っているか
実際のトリガーが未知でも使える防御かどうかは重要な条件です。今回の特徴表現・重みの研究は、実トリガーの事前知識を前提にしていません。
5. 防御後の通常能力を別に測る
ASRを下げても、通常タスクの精度や生成品質が大きく落ちれば導入判断は変わります。
今回の3研究はいずれも、攻撃成功率と通常性能を別々に評価しています。バックドア防御では攻撃が止まったかと通常用途が維持されたかを同時に見る必要があります。
まとめ
NC Stateの研究グループは、AIモデルのバックドア防御を特徴表現、アーキテクチャ、重みという3つの介入点に分けました。
特徴表現ではNull-Space ProjectionがLoRA更新からバックドア方向を外し、アーキテクチャではQESが危険挙動を隔離expertへ集めて停止します。重みではBD-VAXが人工的なバックドア変種から共通する重み署名を抽出し、疑わしい成分を無効化します。
3つの方法は前提条件が異なります。外部LoRAを受け取ったのか、学習工程を変更できるのか、未知トリガーを含む疑わしい学習済みモデルを持っているのかで、介入できる場所が変わります。
AIモデルを導入するときは、通常性能とあわせて、どの内部資産を監査できるか、どの工程へ介入できるか、防御後の通常能力をどう再評価するかまで含めて安全性を確認する必要があります。
公式情報・参照先
- Researchers Demonstrate Comprehensive Suite of New Techniques to Protect AI from ‘Backdoor Attacks’|NC State
- Backdoor Purification for LoRA-Tuned LLMs via Null-Space Projection|arXiv
- Backdoor Containment via Expert Quarantine and Shutdown in LLMs|arXiv
- Purifying Generative LLMs from Backdoors without Prior Knowledge or Clean Reference|ICLR 2026
- BD-VAX|NC State
- Position: Retire the “Positive Backdoor” Label—Secret Alignment Requires Strict and Systematic Evaluation|PMLR