当サイトではアフィリエイト広告を利用しています。
AIエージェントへファイル操作、コード実行、外部API、認証情報まで任せると、モデルがどれだけ慎重でも「実行してよい範囲」を別の仕組みで制限する必要があります。
NVIDIAが2026年9月28日に発表したOpen Agent Safety Platformは、その境界をモデルの外側から強制するための安全基盤です。中心になるのは、オープンソースの実行環境OpenShellと、BlueField-4 DPU上で独立監視するSentryです。
OpenShellはNVIDIA専用ハードウェアがなくても利用でき、Linux、Apple Silicon Mac、WindowsのWSL 2などで動かせます。Sentryはさらに強い分離が必要な環境向けの追加レイヤーです。
この記事では、2026年10月3日時点のOpen Agent Safety Platformについて、OpenShellが何を制限するのか、モデル側のガードレールと何が違うのか、CodexやClaude Codeでどう使うのか、Sentryがどこを補うのかを解説します。
- Open Agent Safety Platformは「モデルの外側」に境界を置く
- プロンプトではなく実行環境で境界を強制する
- OpenShellは4つの境界でエージェントを制限する
- Policy Proverは「その権限追加で境界を超えないか」を確認する
- Policy Advisorなら、エージェント自身が追加権限を申請できる
- OpenShellはNVIDIA専用ハードウェアなしでも使える
- 標準ポリシーではClaude Codeに対応し、Codexは追加設定が必要
- ログで「何を許可し、何を止めたか」を残せる
- SentryはOpenShellの外側に置く独立監視層
- OpenShellが防ぐ範囲と、別の対策が必要な範囲
- OpenShellが必要になるのは実行権限を持つエージェント
- まとめ
- 公式情報・参照先
Open Agent Safety Platformは「モデルの外側」に境界を置く
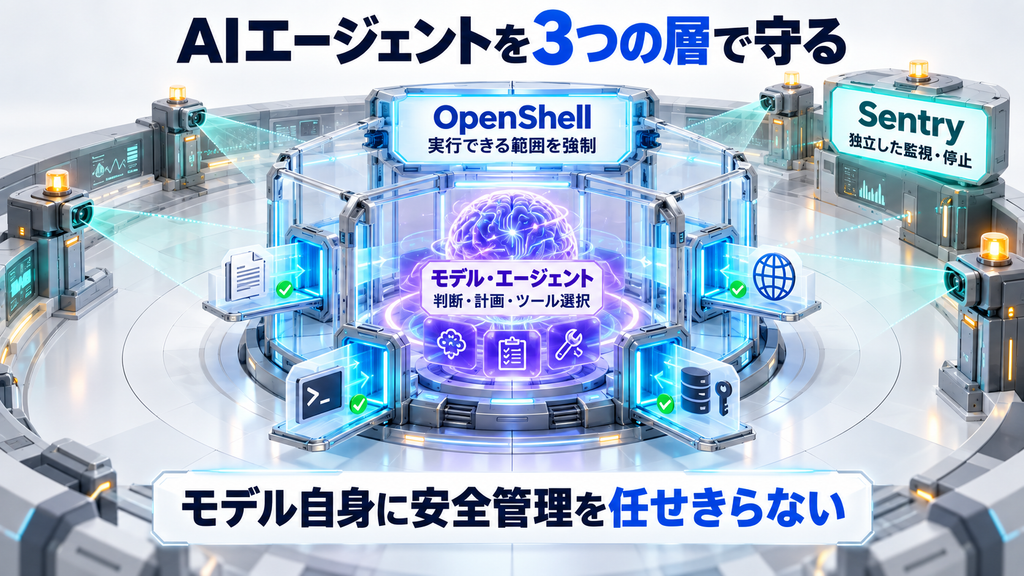
Open Agent Safety Platformは、OpenShellとSentryを中心に複数の安全層を組み合わせる構成です。
NVIDIAは、AIエージェントの安全を次のような複数レイヤーで考えています。
| 層 | 主な役割 |
|---|---|
| モデル・エージェント | 指示理解、計画、ツール選択、自己制御 |
| OpenShell | ファイル、プロセス、ネットワーク、認証情報を実行環境から制限 |
| Sentry | BlueField-4上からエージェントを独立監視し、境界逸脱時に停止・隔離 |
モデル側のルールは「してはいけないことを判断する」役割です。OpenShellは、モデルが誤判断しても許可していないファイルや通信先へ届かない状態を作る役割です。
Sentryはそのさらに外側で、ホストOSやエージェントから離れたハードウェア側の監視を追加します。
プロンプトではなく実行環境で境界を強制する
AIエージェントは、通常のチャットより多くの権限を持ちます。コードを実行し、パッケージを入れ、ファイルを読み、APIキーを使い、外部サービスへ通信する構成も珍しくありません。
この状態で「このフォルダ以外は読まないで」「このAPI以外へ送信しないで」とプロンプトだけで制御すると、最終的な判断はモデルに残ります。途中の失敗、曖昧な指示、ツール経由の不正な入力があれば、モデルの判断だけでは権限境界を保証できません。
OpenShellは、こうした判断とは別にOS・ネットワーク側のルールを持ちます。エージェントが許可外の操作を試しても、実行環境側で遮断します。
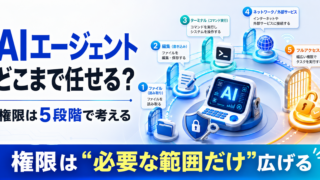
AIエージェントへどこまで権限を与えるかという基本的な考え方は、こちらの記事でも整理しています。
OpenShellは4つの境界でエージェントを制限する
OpenShellは、エージェントごとにサンドボックスを作り、宣言したポリシーに従って実行範囲を制限します。
現行ドキュメントでは、主に次の4領域が中心です。
ファイルシステム
読み取り可能なパスと書き込み可能なパスを分け、宣言していない場所へのアクセスを制限します。
LinuxではLandlockを使ってカーネル側から制御します。ファイルとプロセスのポリシーはサンドボックス作成時に固定され、実行中に自由に緩める仕組みではありません。
プロセス
エージェントは権限を落とした状態で起動し、危険なシステムコールはseccompで制限します。
特権昇格や、エージェントが実行環境そのものを変更する経路を狭める層です。
ネットワーク
外向き通信はデフォルトで拒否され、許可したホスト、ポート、実行バイナリなどに一致する通信だけを通します。
ネットワークポリシーは実行中にも更新できるため、「GitHub APIは許可するが、それ以外の外部サイトは拒否する」といった設定を後から追加できます。
認証情報
APIキーやアクセストークンを、そのままエージェントへ渡さない構成を取れます。
OpenShellのProviderでは、実際の認証情報の代わりに不透明なプレースホルダーをエージェント環境へ渡し、許可された通信先へリクエストを送る直前にプロキシ側で本物へ置き換えます。
つまり、エージェントにGitHubやモデルAPIを使わせながら、秘密情報そのものを直接見せない設計にできます。
Policy Proverは「その権限追加で境界を超えないか」を確認する
AIエージェントへ最小権限だけ与えて始めると、途中で新しい通信先が必要になることがあります。
ここで毎回広い権限を与えてしまうと、サンドボックスを使う意味が薄れます。
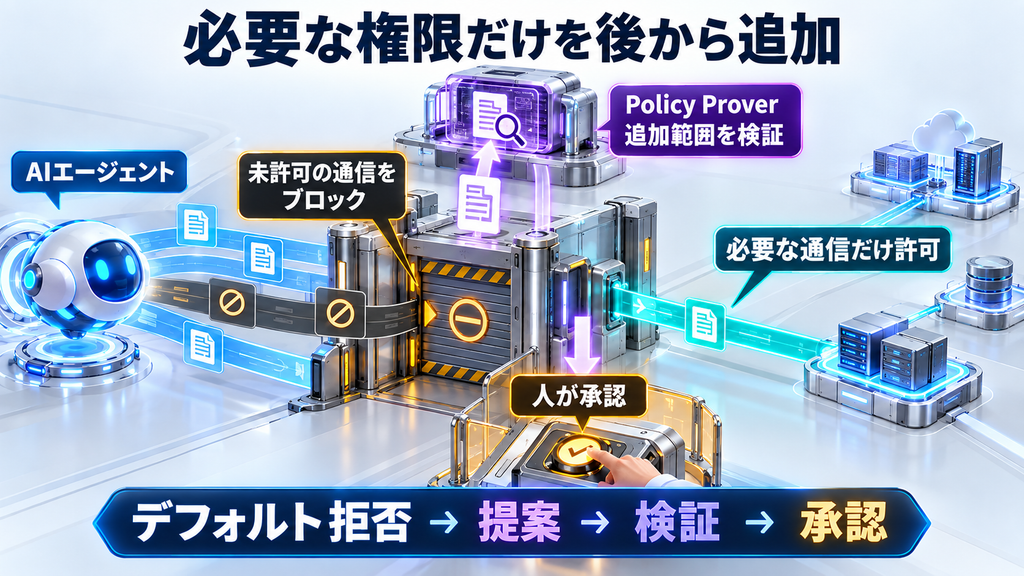
OpenShellには、ポリシー変更を検証するPolicy Proverがあります。SMTソルバーを使い、新しいポリシーが事前に決めた上限を超えていないか、認証情報を新しい通信先へ送れるようになる変更ではないかなどを確認します。
ただし、ProverがPASSしたから「その設定は絶対に安全」という意味ではありません。現在の検証対象外のルールもあり、GraphQLやMCPルールなど未対応の形は、確認できないものとして返されます。
安全性そのものを判定する仕組みというより、許可範囲が意図せず広がっていないかを機械的に検査する仕組みとして見る方が正確です。
Policy Advisorなら、エージェント自身が追加権限を申請できる
OpenShellには、実行中のエージェントが必要なネットワーク権限を提案するPolicy Advisorもあります。Policy Advisor自体はデフォルトで無効なので、使う場合は明示的に有効化します。
たとえば、作業中に未許可のAPIへ接続しようとすると、OpenShellが通信を止めます。そのうえでエージェントは「このホストの、このAPIパスへ、このバイナリから接続したい」という狭いルールを提案できます。
Policy Advisorを有効にした場合も、標準の承認モードはmanualです。提案は人が承認するまで反映されません。
自動承認は明示的に切り替えた場合だけ使われ、Proverの差分やセキュリティ上の注意点がある提案は人の確認へ戻されます。
「失敗したからフルアクセスへ切り替える」のではなく、必要になった権限だけを追加する流れを作れるのが特徴です。
OpenShellはNVIDIA専用ハードウェアなしでも使える
Open Agent Safety Platformの発表ではVera CPUやBlueField-4が大きく扱われていますが、OpenShell自体の利用にNVIDIA専用ハードウェアは必須ではありません。
執筆時点の主な対応環境は次のとおりです。
| 環境 | 状況 |
|---|---|
| Linux x86_64 | 対応 |
| Linux arm64 | 対応 |
| Apple Silicon Mac | Docker Desktop経由で対応 |
| Windows x86_64 | WSL 2 + Docker Desktopで実験対応 |
| Docker | 対応 |
| Podman | 対応 |
| Kubernetes | 対応 |
| MicroVM | 対応 |
OpenShellはApache 2.0で公開されており、NVIDIAはArmやIntelを含む第三者の計算基盤へ拡張できるとしています。
2026年9月25日に0.1.0が公開され、alpha表記を外して安定リリース系へ移行しました。執筆時点の最新stableは0.1.2です。
Windowsはまだ実験対応なので、OpenShellそのものが本番向けstableになったことと、すべての対応OSが同じ成熟度であることは分けて考える必要があります。
標準ポリシーではClaude Codeに対応し、Codexは追加設定が必要
OpenShellはエージェントを作り直す仕組みではなく、既存のエージェントをサンドボックス内で動かします。
現行ドキュメントではClaude Code、OpenCode、Codexなどが対象になっています。
Claude Codeは標準ポリシーに必要な通信先が含まれているため、その設定のまま起動できます。一方、Codexはベースイメージに含まれていても、標準ポリシーではOpenAIの通信先やCodexバイナリが許可されていません。
Codexを使う場合は、OpenAIのエンドポイントとCodexの実行パスを含むカスタムポリシーを用意します。どのエージェントへ最初からどこまで許可するかが、標準ポリシーごとに違うということです。
OpenAIのAgents APIのように、エージェントの実行環境そのものを選ぶ仕組みとの違いはこちらの記事で整理しています。
ログで「何を許可し、何を止めたか」を残せる
境界を作るだけでなく、後から追えることも重要です。
OpenShellはネットワーク接続、プロセス、ファイル、設定変更などをOCSF形式で記録します。許可された通信と拒否された通信もログで確認できます。
リアルタイム表示はCLIやTUIから行えます。長期保存やSIEM連携が必要な場合は、OCSF JSONとして書き出す設定も用意されています。
AIエージェントの事故調査では「モデルが何を答えたか」だけでなく、「実際にどの通信を試し、何が拒否されたか」まで確認できるため、実行経路をログから検証できます。
SentryはOpenShellの外側に置く独立監視層
OpenShellだけでも、一般的なPCやサーバー上でサンドボックスとポリシー制御を使えます。
NVIDIA Sentryは、さらに高い分離を求めるデータセンター向けの追加レイヤーです。BlueField-4 DPU上で動き、ホストCPUやAIエージェントとは別の位置から通信やポリシー違反を監視します。
NVIDIAのVera Rubin PODでは、BlueField-4がモデルへ到達する経路上に置かれます。エージェント側から直接触れない場所で監視できるため、ホスト側が信頼できない状態でも別系統の停止手段を持てます。
NVIDIAは、境界を外れようとしたエージェントをSentryがミリ秒単位で隔離・停止できると説明しています。この性能はNVIDIA自身の発表値で、執筆時点では同一条件での独立した第三者評価までは確認できませんでした。
OpenShellとSentryは階層の異なる安全機構です。
- OpenShell:通常の実行環境で権限を制限する
- Sentry:その外側のハードウェアから独立監視を追加する
という役割分担になります。
OpenShellが防ぐ範囲と、別の対策が必要な範囲
OpenShellは、AIエージェントの権限を狭く保つための強い道具ですが、モデルの誤判断そのものを直す仕組みではありません。
許可した範囲内で誤ったファイルを書き換える、正規に許可したAPIへ間違った内容を送る、といった動作は別の対策が必要です。
また、Policy Proverも現在モデル化しているポリシー範囲を検証する仕組みで、すべての安全性を証明するものではありません。
実運用では、モデル側のガードレール、OpenShellの実行境界、人による承認、アプリ側の検証、必要に応じたSentryのような独立監視を重ねる構成になります。
AIエージェントではモデルだけでなく、その周囲のメモリ、ツール、監督、回復を含むハーネスも重要です。
OpenShellが必要になるのは実行権限を持つエージェント
OpenShellが対象にするのは、エージェントへ実際の操作権限を与える場面です。
たとえば、
- AIコーディングエージェントへリポジトリとターミナルを渡す
- 長時間エージェントへAPIキーを使わせる
- 複数のサブエージェントを並列実行する
- 社内データへアクセスさせつつ、外部送信先を限定する
- 自動処理の途中で必要な通信先だけ追加承認する
といった運用です。
ファイル操作、コマンド実行、外部通信を行わない通常のチャットでは、OpenShellが制御する対象自体がほとんどありません。エージェントへ実行権限を広げるほど、モデルの判断とは別に「技術的に越えられない境界」を置く意味が大きくなります。
まとめ
NVIDIA Open Agent Safety Platformの中心にある考え方は、AIエージェント自身へ安全管理を任せきらないことです。
OpenShellは、ファイル、プロセス、ネットワーク、認証情報をサンドボックス側から制限します。Policy ProverとPolicy Advisorを組み合わせれば、必要な権限を狭い範囲で追加しながら運用できます。
OpenShell自体はNVIDIA専用ハードウェアがなくても利用可能です。BlueField-4上のSentryは、さらに独立した監視・停止レイヤーが必要な環境向けに追加します。
AIエージェントがコードやPC、外部サービスを長時間操作するほど、モデル性能だけでなく、何を許可し、どこで止めるかをモデルの外側で強制する仕組みが必要になります。
公式情報・参照先
- NVIDIA Launches Open Agent Safety Platform to Secure Agents From Testing to Deployment|NVIDIA
- NVIDIA Open Agent Safety Platform: A Reference for Continuous In-Silicon Agent Monitoring|NVIDIA Technical Blog
- NVIDIA OpenShell Developer Guide
- OpenShell Security Best Practices
- Policy Prover|NVIDIA OpenShell
- Supported Agents|NVIDIA OpenShell
- OpenShell Releases|GitHub