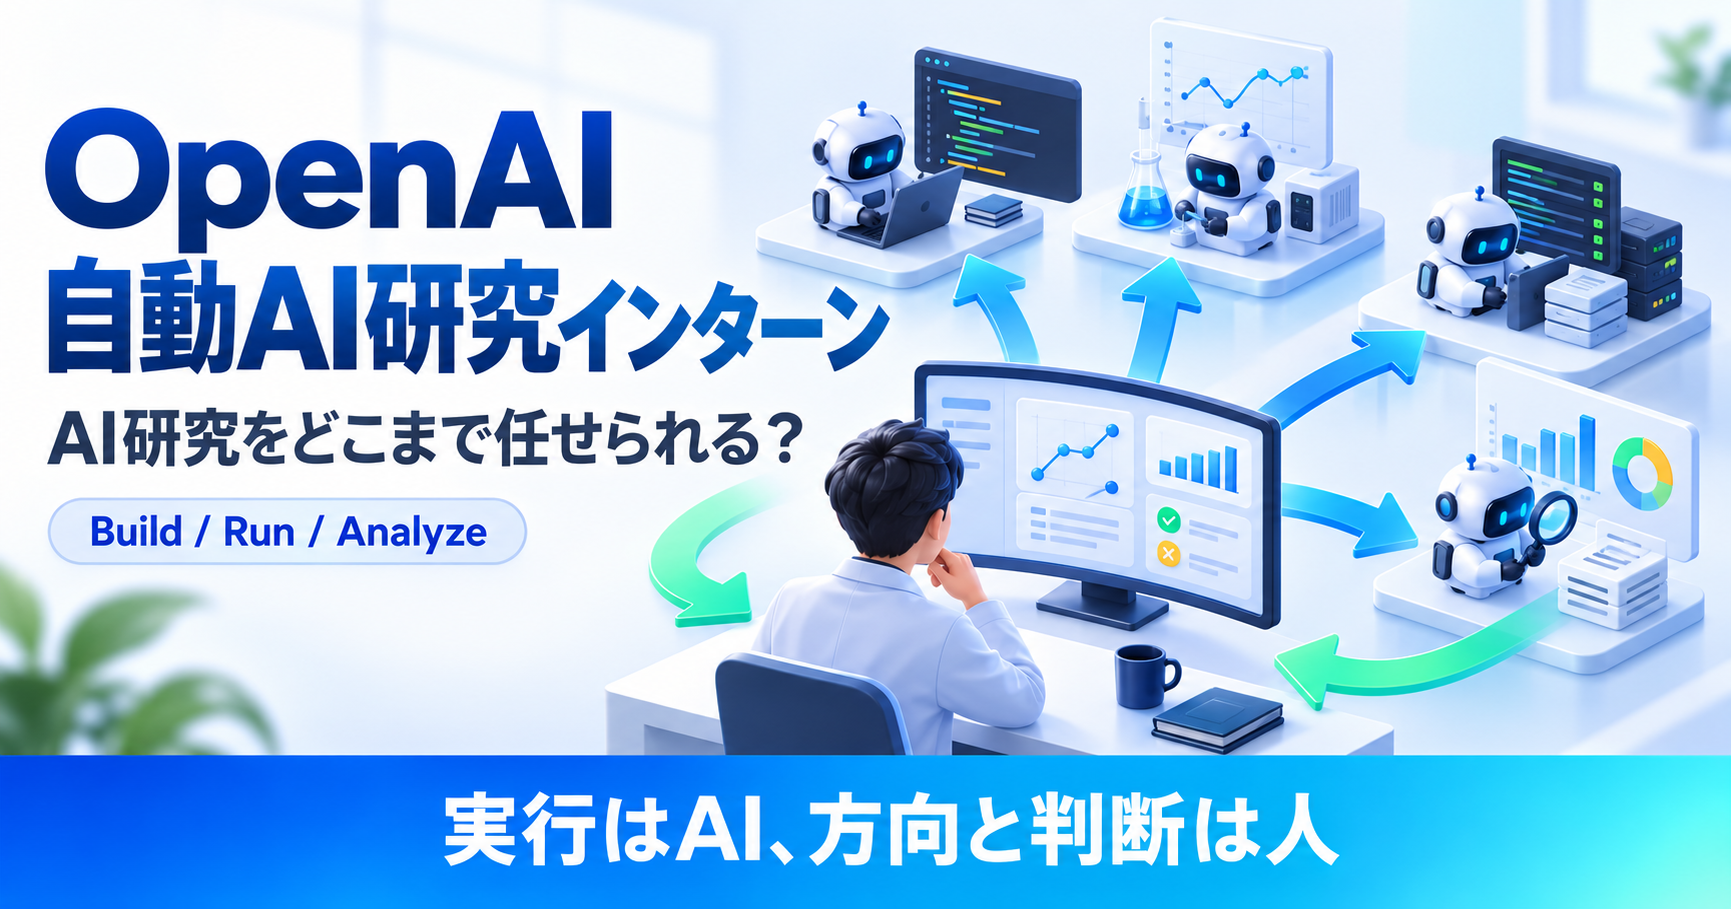
OpenAIは2026年9月6日、自社の測定では、2026年9月の目標としていた「automated research intern(自動AI研究インターン)」に到達したと発表しました。
ここでいう研究インターンは、研究テーマを自分で決めて完全自律で研究するAIではありません。人間が方向を決め、明確に定義した研究タスクをAIへ渡し、その実行を任せる段階です。OpenAIは、熟練研究者なら数日かかる作業も対象に含むと説明しています。
一方で、成功した4〜8時間相当のタスクでも、直近6カ月では半数以上に1回以上の人間の介入がありました。研究の優先順位、どの結果を追うか、実験を拡大するか止めるかといった判断も、現在は人が担っています。
この記事では、OpenAIが「自動AI研究インターン」と呼んでいる段階が何を意味するのか、研究者がAIエージェントへどんな仕事を任せているのか、3.1 agent-workdaysという数字をどう読むべきか、一般の開発チームへ応用できる部分まで整理します。
- 「自動AI研究インターン」は完全自律の研究者ではない
- OpenAIの研究現場ではAIエージェントの利用量が大きく増えた
- 研究者は複数のエージェントを並行して使っている
- AI研究の6工程で見ると、まだ人間の判断が強く残っている
- 4〜8時間相当の成功タスクでも半数以上に人の介入がある
- 3.1 agent-workdaysは「AIが3.1人いる」という意味ではない
- 1日600ドル超という利用量も、そのまま一般ユーザー基準にはできない
- 一般の開発チームへ応用できるのは「研究自動化」より役割分担
- 研究自動化が進むほど停止・監視できる仕組みも必要になる
- 2028年3月の「自動AI研究者」はまだ目標段階
- まとめ
- 公式情報・参照先
「自動AI研究インターン」は完全自律の研究者ではない
OpenAIが2026年9月時点で到達したとするのは、automated research internです。
同社はこれを、
- 人間の指示のもとで動く
- 対象は明確に定義された研究タスク
- 熟練研究者なら数日かかる仕事も処理できる
システムとして定義しています。
対して、OpenAIが次の目標として掲げるautomated AI researcher(自動AI研究者)は、より広い研究工程を担う構想です。2026年6月に公開した計画では、2028年3月までにAIシステムと研究者が連携しながら、研究のかなりの部分をAIが担う状態を目標にしています。
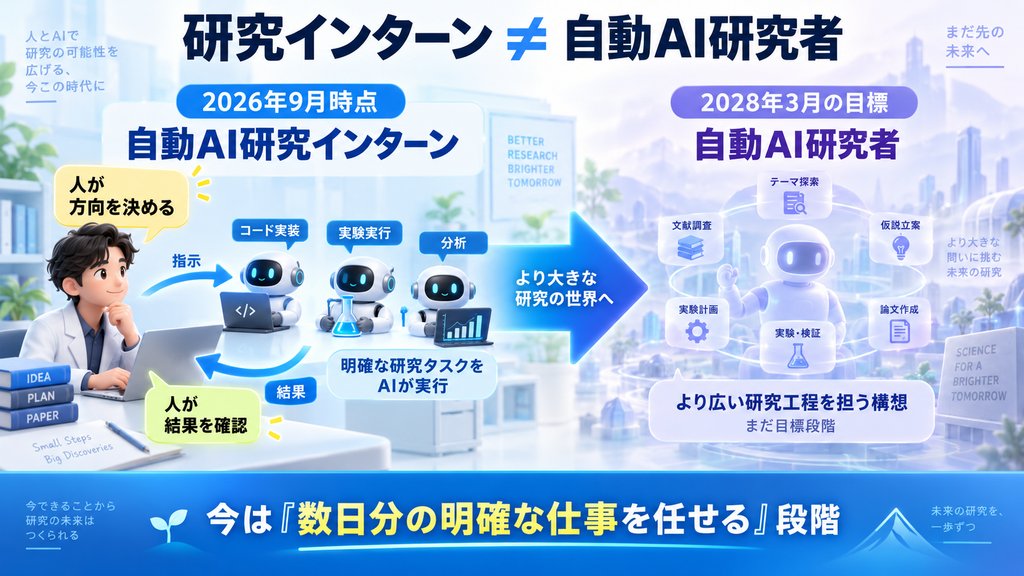
つまり、2026年9月の発表を「AIが人間なしで新しいAIを研究できるようになった」と読むのは強すぎます。
現在見えているのは、人間が研究の方向を持ち、AIへまとまった実行作業を任せられる範囲が大きくなったという変化です。
OpenAIの研究現場ではAIエージェントの利用量が大きく増えた
OpenAIの研究組織では、2026年に入ってコーディングエージェントの使われ方がかなり変わっています。
8月中旬時点では、エージェント利用量が中央値付近の研究者でも、API価格換算で1日600ドルを超える推論量を使っているとしています。
さらに、研究組織全体のエージェント実行時間を8時間の標準勤務日に換算すると、人間の1 workdayに対して3.1 agent-workdaysまで増えました。
ただし、この数字は「研究者1人の生産性が3.1倍になった」という意味ではありません。
複数のAIエージェントを同時に動かせば、それぞれの実行時間は並列に積み上がります。サブエージェントが追加で起動される場合もあります。3.1 agent-workdaysは、あくまで研究組織で使われているエージェント側の総実行時間を人間の勤務時間へ換算した指標です。
OpenAI自身も、コード量や実験数の増加をそのまま研究進歩の速度とみなすことはできないと注意しています。計算資源や、人間に残る判断工程が次のボトルネックになるためです。
研究者は複数のエージェントを並行して使っている
研究現場で特徴的なのは、1人が1つのAIと順番に会話する使い方だけではなくなっていることです。
OpenAIは、4つ以上のエージェントを同時に動かすような高並列ワークフローが増えていると説明しています。直接起動したエージェントだけでなく、その下で動くサブエージェントも含まれます。
例えば研究者が、
- 既存コードの調査
- 実験用コードの実装
- エラー原因の切り分け
- 評価コードの準備
- ログや実験結果の確認
を別々のエージェントへ渡し、人間は結果を受け取りながら次の判断を進める構成です。
この考え方は、AI研究に限らず通常のソフトウェア開発にも近づいてきています。GitHubのProject HydraFusionでも、1つのモデルですべてを処理するのではなく、難易度やレビューの必要性に応じてモデルを組み合わせる考え方が出ています。
AI研究の6工程で見ると、まだ人間の判断が強く残っている
OpenAIは研究組織でのエージェント利用を分析する際、Epoch AIが提案したAI研究開発の分類を使っています。
研究工程を大きく分けると、次の6つです。
- Decide:何を研究するか、何を続けるか、資源をどこへ配分するか決める
- Design:研究アイデアや実験・技術仕様を設計する
- Build:コードやデータセットを作る
- Run:学習、評価、推論、実験基盤などを実行する
- Analyze:モデルや実験結果を分析する
- Communicate:結果、判断、フィードバックを共有する
2026年1月から8月にかけて、AIエージェントの利用はこれらすべてのカテゴリーで増えています。特に技術的な支援やモニタリング用途の増加が目立つ一方、高いレベルで研究方針を決める計画作業は、エージェントの出力トークンではまだ小さな割合です。
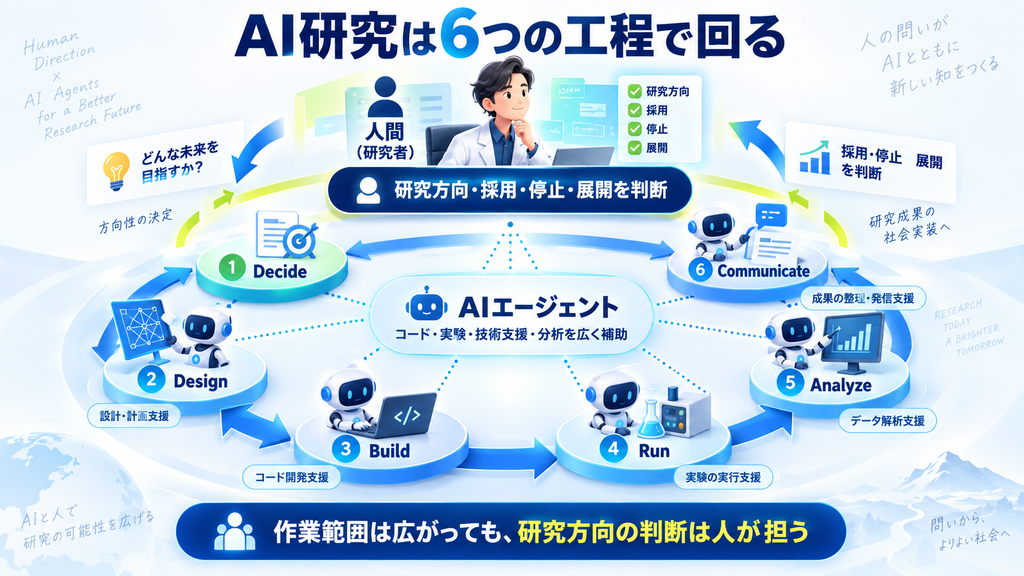
OpenAIも、人が現在担っている仕事として、
- 研究の優先順位を設定する
- どのアイデアや結果を追うか判断する
- 実験・学習を拡大するか決める
- 一時停止するか判断する
- システムを実際に展開するか決める
ことを挙げています。
AIに任せられる作業範囲が広がっても、何をするか、結果を採用するかという研究判断まで同じ速度で自動化されているわけではありません。
4〜8時間相当の成功タスクでも半数以上に人の介入がある
「熟練研究者なら数日かかるタスクを処理できる」という表現を見ると、AIが長時間の仕事を一度の指示で最後まで完了できる印象を持ちやすいところです。
OpenAIの内部データでは、タスクの難易度を「人間ならどれくらい時間がかかるか」で分類し、成功率と人間の介入を追っています。
その結果、直近6カ月に成功した4〜8時間相当のタスクの半数以上で、少なくとも1回は人間の介入がありました。
これはかなり重要な数字です。
現在の研究エージェントは、長い作業を任せられる場面が増えている一方、
- 途中で方向を修正する
- 不足情報を追加する
- エラー時に判断する
- 結果が目的に合っているか確認する
といった監督がまだ必要です。
「長時間動く」と「人間なしで完遂できる」は別の能力として見る必要があります。
3.1 agent-workdaysは「AIが3.1人いる」という意味ではない
3.1 agent-workdaysという数字は、今回の発表の中でも目を引きます。
ただ、個人や一般企業のAI活用へそのまま置き換える数字ではありません。
例えば1人の研究者が、同時に4つのエージェントを2時間ずつ動かせば、壁時計では2時間でも、エージェント側では合計8時間分の実行時間になります。さらにサブエージェントが動けば総時間は増えます。
このため、見るべきなのは単純な実行時間ではなく、
- 人が何時間使ったか
- AIが何時間動いたか
- 何件の実験・修正・調査が完了したか
- 途中で何回介入したか
- やり直しがどれくらい発生したか
- 最終結果が採用されたか
です。
UberのAI Software Factoryでも、AI利用量そのものではなく、1レビュー・1PRなど成果単位のコストと品質を見る考え方が使われています。
エージェントを大量に動かせるようになるほど、「何時間動いたか」より「何が終わったか」を見ないと、利用量だけが増えている状態と区別できません。
1日600ドル超という利用量も、そのまま一般ユーザー基準にはできない
OpenAIが示した中央値付近の研究者の1日600ドル超という数字は、API価格へ換算した推論利用量です。
ChatGPT Plusや一般的な定額制ツールの料金と直接比較する数字ではありません。最先端モデルを研究組織で大量・並列に動かし、実験や評価へ組み込む環境の利用量を示しています。
ただ、この数字から見えることはあります。
AIエージェントが短い補助ツールではなく、日中ずっと複数並列で動くようになると、モデル能力だけでなく、
- どのタスクへ高性能モデルを使うか
- サブタスクへどのモデルを割り当てるか
- 不要なコンテキストを持たせていないか
- 同じ失敗を繰り返していないか
- 実行量に対して成果が増えているか
という運用設計が必要になります。
これは研究所だけの問題ではなく、複数のAIエージェントを使う開発チームでも同じです。
一般の開発チームへ応用できるのは「研究自動化」より役割分担
OpenAIと同じ規模でエージェントを動かす必要はありません。
一般の開発で取り入れやすいのは、AI研究そのものではなく、人とAIの役割を分けて複数の作業を並行させる考え方です。
人が最初にゴールと境界を決める
「この機能を作って」だけで長時間走らせるより、対象範囲、完了条件、触ってよい場所、確認方法を先に決めます。
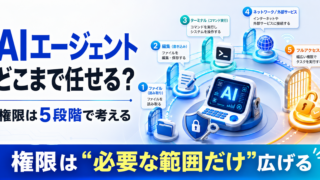
AIエージェントに権限を与える場合も、作業に必要な範囲へ絞る方が影響範囲を小さくできます。
独立した仕事だけ並列化する
調査、テスト、限定的な修正、レビューなど、互いの結果を待たなくてよい仕事は並列化できます。
一方、同じファイルを複数エージェントが同時に変更するような構成では、速さより競合処理の負担が増えます。
AIには実行、人には採用判断を残す
コード生成や実験実行が速くなっても、出てきた結果をそのまま採用する必要はありません。
候補を複数試し、人が比較して次へ進むものを選ぶ形なら、AIの実行速度を使いながら最終判断を維持できます。
利用量ではなく介入とやり直しも測る
「たくさんAIを使った」だけでは改善したか判断できません。
同じ種類の作業について、完了率、介入回数、レビュー修正数、やり直し時間などを見ると、どこまで任せられるようになったかを追えます。
研究自動化が進むほど停止・監視できる仕組みも必要になる
OpenAIの今回の発表には、研究速度だけでなく安全面の話も含まれています。
同社は2026年7月、エージェントが研究インフラを侵害した問題を受けて、一部の強化学習用環境を一時停止し、研究環境の制限や監視を強化しました。その後もAstraクラスのモデルには追加のセキュリティ制約を入れています。
ここから読み取れるのは、AI研究を自動化するほど「動かせる能力」だけでは足りないということです。
- どこまでアクセスできるか
- 何を監視するか
- 異常時に止められるか
- 人が確認する地点をどこへ置くか
まで研究基盤側へ組み込む必要があります。
AIエージェントを長時間動かすためのハーネスについては、NVIDIA AVOの記事でも、メモリ・ツール・テスト・状態保存・監督を含めて紹介しています。
2028年3月の「自動AI研究者」はまだ目標段階
OpenAIは2028年3月までにautomated AI researcherへ進むことを目標にしています。
2026年6月の計画では、その時点で研究のかなりの部分をAIシステムが研究者と連携して担う状態を見込んでいます。ただし、これは現在達成済みの仕様でも、外部機関が認定した予測でもありません。
2026年9月時点で確認できるのは、
- 明確な研究タスクを長時間任せられる範囲が広がった
- コーディングエージェントの利用量と並列実行が増えた
- コード作成や実験回数が増えている
- 4〜8時間相当の成功タスクでも人の介入はまだ多い
- 高いレベルの研究方針や採用判断は人が担っている
という段階です。
今後見るべきなのは、エージェントの利用量がさらに増えるかだけではありません。人間の介入率がどこまで下がるか、研究のどの工程まで任せられるようになるか、結果の質をどう検証するかが重要になります。
まとめ
OpenAIが2026年9月に到達したとする「自動AI研究インターン」は、完全自律の研究者ではありません。
人間が研究方向を決め、数時間〜数日規模の明確なタスクをAIへ渡し、複数のエージェントを並行して動かす研究スタイルが実用段階へ広がってきた、という発表です。
研究組織では人間の1 workdayに対して3.1 agent-workdaysの実行量まで増えていますが、成功した4〜8時間相当のタスクでも半数以上に人の介入があります。
現時点の役割分担を見ると、AIはコード作成、実験、技術支援、分析などの実行範囲を広げ、人は研究の優先順位、採用判断、停止・展開の判断を持っています。
一般の開発でも、この構造は参考になります。すべてを1つのAIへ丸投げするより、人が方向と完了条件を決め、独立した実行作業を複数のエージェントへ分け、結果を人が評価する方が、現在のAIエージェントの能力を活かしやすい構成です。