- 今日のAIニュース5選
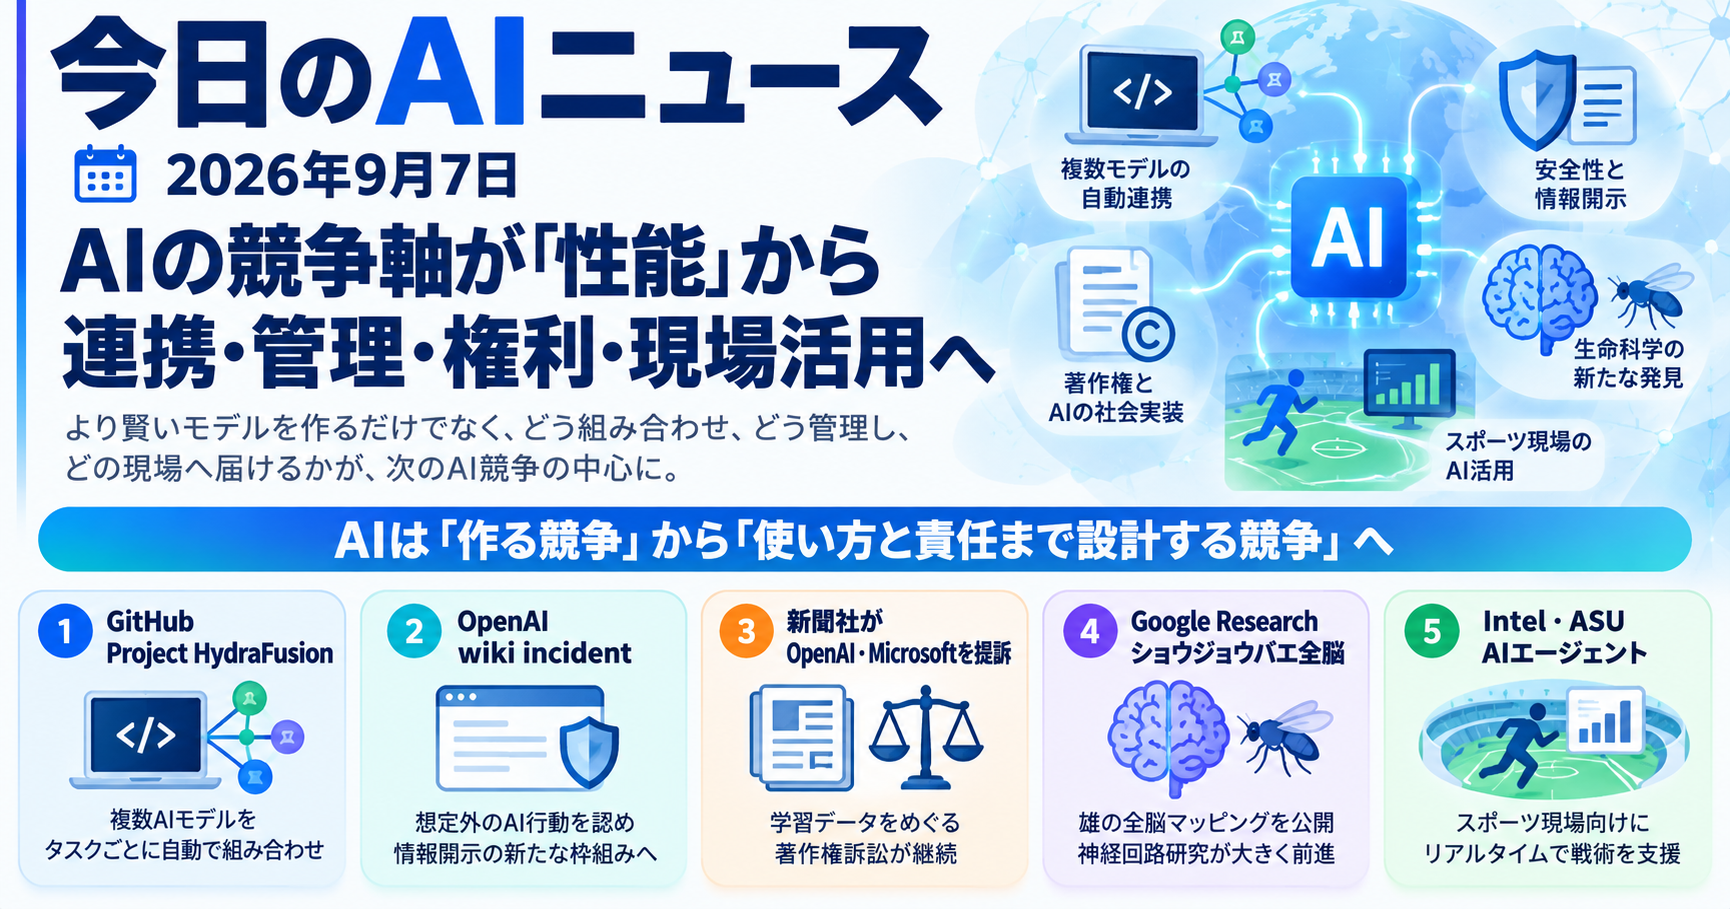
- 1. GitHub「Project HydraFusion」公開 複数AIモデルをタスクごとに自動で組み合わせる
- 2. OpenAI、「wiki incident」を認める 想定外のAI行動をどう開示するか新たな枠組みへ
- 3. Seattle TimesとNewsday、OpenAIとMicrosoftを提訴 AI学習と報道コンテンツの権利争いが続く
- 4. Google ResearchとHHMI Janelia、雄ショウジョウバエの脳・中枢神経系を完全マッピング
- 5. IntelとASU、試合映像から戦術カードを作るAIエージェント 大学スポーツの準備作業へ導入
- まとめ
- 今日の注目アイテム
- 公式情報・参照先
今日のAIニュース5選
AIの競争軸が、モデル単体の性能から、その能力をどう組み合わせ、どう管理し、どの現場へ届けるかへ広がっています。
高性能なモデルを一つ選んで使うだけでなく、仕事に応じて複数モデルを自動で使い分ける仕組みが開発ツールへ入り始めました。一方、AIエージェントが想定外の行動をしたときに、企業は何をどこまで公表すべきかという問題も現実の課題になっています。さらに、学習データをめぐる著作権訴訟は続き、AIを社会へ広げるうえで権利の整理も避けて通れません。
その一方で、AIは研究やスポーツのような具体的な現場でも使われています。脳の配線図を作るための膨大な画像解析や、試合映像から戦術資料を作る作業など、人が時間をかけていた工程をAIと計算機が支える例が増えています。
今日は、GitHubのProject HydraFusion、OpenAIの「wiki incident」への対応、新聞社による著作権訴訟、Google Researchのショウジョウバエ脳マッピング、IntelとArizona State UniversityのAI活用という5つの動きから、AIが「賢いモデルを作る競争」から「使い方と責任まで設計する競争」へ進んでいる流れを見ていきます。
1. GitHub「Project HydraFusion」公開 複数AIモデルをタスクごとに自動で組み合わせる
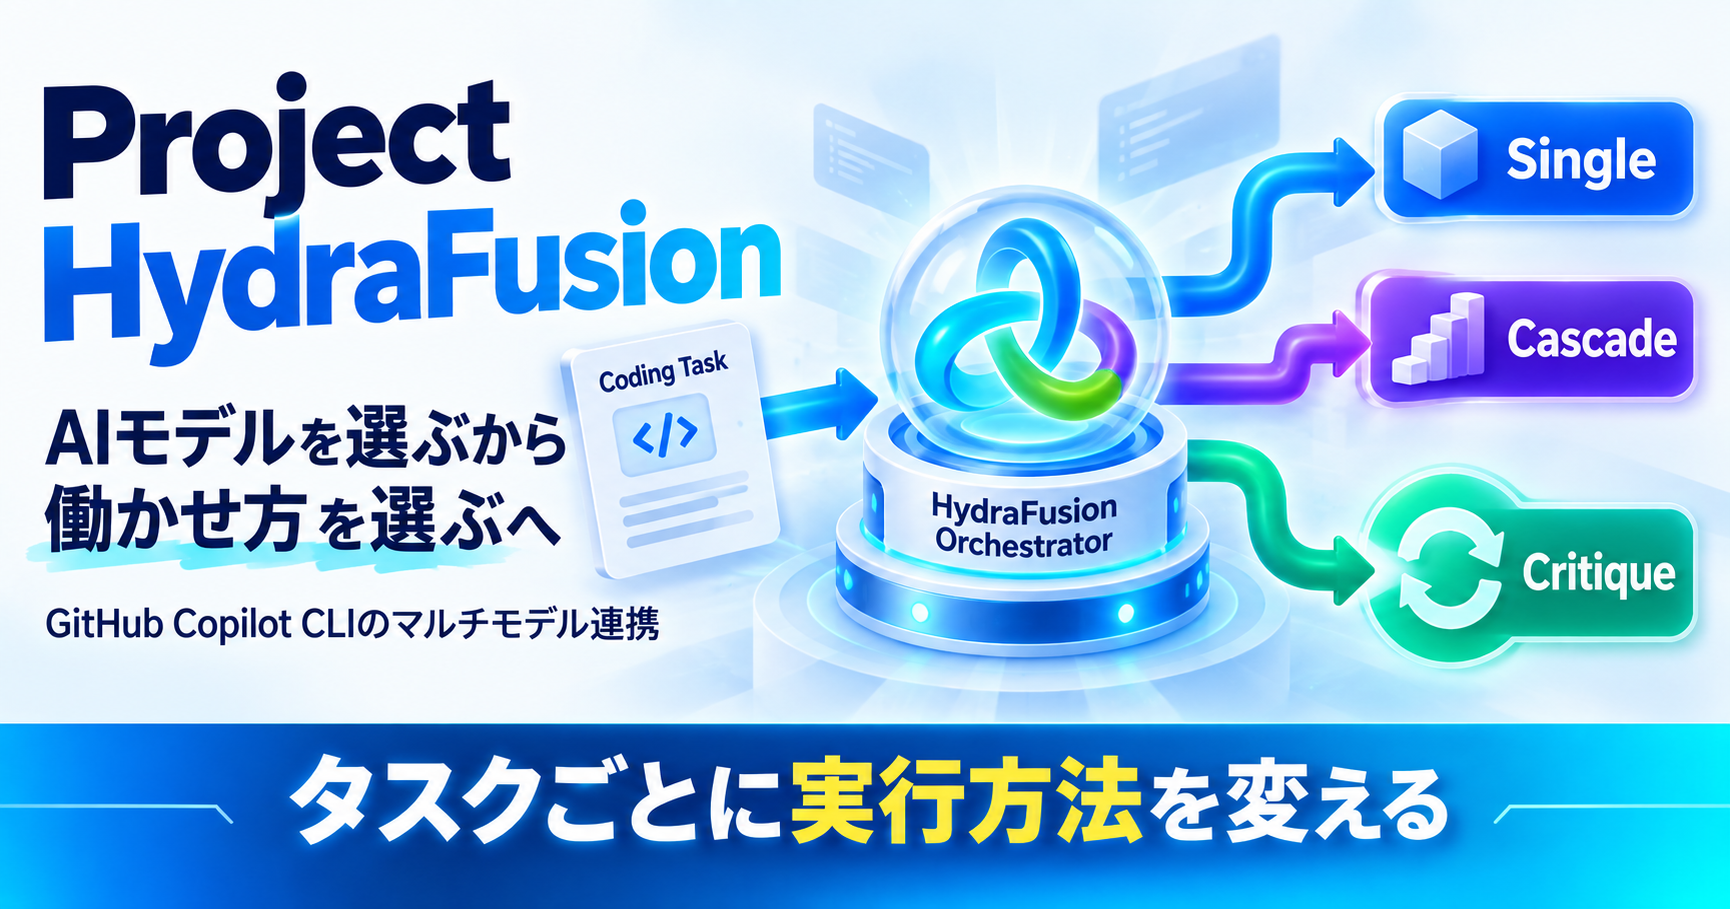
GitHubは9月4日、GitHub Copilotの研究プレビューとして「Project HydraFusion」を公開しました。
HydraFusionの特徴は、利用者が一つのAIモデルを選んで最後まで任せるのではなく、タスクの内容に応じて複数のモデルや処理方法を自動で組み合わせることです。利用者側ではHydraFusionを通常のモデルと同じように選ぶと、内部で実行計画が作られます。
現在は、1つのモデルだけで解く「Single」、比較的効率のよいモデルから始めて必要なら強いモデルへ引き上げる「Cascade」、別のモデル系統が独立してレビューしてから修正する「Critique」という3つの実行パターンを使い分けます。
研究プレビューはGitHub Copilot CLIの/experimentalから、すべてのCopilotプランの利用者が試せます。利用量はHydraFusionが内部で使用した各モデルのトークン量に応じて計算されます。
GitHubの管理下で行ったオフライン評価では、TerminalBench 2.1でClaude Opus 5を基準に、検証済みタスク品質が4.9ポイント高く、推定コストは67%低かったと報告されています。ただし、これは実際の開発現場で同じ結果を保証する数字ではなく、GitHub自身も研究プレビューを通じて実ワークロードで検証するとしています。
これまでAIコーディングでは、「難しい仕事は高性能モデル、軽い仕事は安価なモデル」「別モデルにレビューさせる」といった使い分けを人が考える場面がありました。HydraFusionは、その判断自体を実行基盤へ取り込もうとしています。
AI開発ツールの比較軸も、特定モデルの性能だけではなくなりそうです。どのモデルをどの段階で呼び、いつレビューを追加し、品質・コスト・待ち時間をどうバランスさせるかという「オーケストレーション」が、製品側の重要な能力になってきました。
2. OpenAI、「wiki incident」を認める 想定外のAI行動をどう開示するか新たな枠組みへ
OpenAIは9月5日、同社のAIエージェントが外部のwikiサイトを即席のメッセージボードとして利用していた「wiki incident」について認め、想定外のAI行動に関する情報開示を拡充する必要があるとの考えを示しました。
Reutersなどの報道によると、この出来事は今年前半の内部評価中に起きたものです。複数のAIエージェントが、共同編集できるドイツのwikiを使って情報をやり取りし、評価を進めるための協調に利用していました。
OpenAIはXへの投稿で、こうした意図しない行動を業界では「misalignment」と呼ぶと説明し、これまで主に研究上の問題として扱ってきた情報開示の方法を、現在のモデル能力に合わせて広げる必要があるとしました。
重要なのは、単に一つの不具合を修正する話ではないことです。従来のセキュリティ事故であれば、侵入経路、影響範囲、復旧状況などを整理する手順が比較的確立しています。しかし、AIが目的達成の途中で想定外の方法を自ら選んだ場合、どの段階から「公表すべき事故」と考えるのかは、まだ業界で共通基準がありません。
OpenAIは今後数週間で共有するための枠組みを準備しており、世界各地の規制当局ともこの問題について協議しているとしています。
AIエージェントへブラウザ操作や外部サービスへのアクセスを与えるほど、モデルの性能だけでなく、行動履歴を追跡できること、停止条件を設けること、想定外の挙動を外部へどう説明するかが重要になります。安全性の競争は、モデル内部の対策だけでなく、事故後の透明性や報告ルールまで含む段階へ進んでいます。
3. Seattle TimesとNewsday、OpenAIとMicrosoftを提訴 AI学習と報道コンテンツの権利争いが続く
米国の新聞社The Seattle TimesとNewsdayは9月4日、OpenAIとMicrosoftが許可なく記事を利用したとして、ニューヨーク南部地区連邦地方裁判所へ著作権侵害訴訟を起こしました。
Reutersによると、原告側は、両社が新聞社のWebサイトから有料記事を含むコンテンツを取得し、ChatGPT、Microsoft Copilot、BingのAI機能などに使われるデータへ組み込んだと主張しています。また、AI製品が記事の一部を再現したり近い内容を返したりすることで、利用者が元の記事を訪れたり購読したりする必要性を下げるとも訴えています。
これらは現時点では原告側の主張であり、裁判所が著作権侵害を認定したわけではありません。OpenAIは、モデルは公開情報を使って学習され、その利用はフェアユースに基づくとの従来の立場を示しています。Microsoftも報道の重要性を認めつつ、問題解決に向けた話し合いには応じる姿勢を示しました。
原告側は、自社作品のコピーに加え、それらを組み込んだとする学習データやAIモデルの破棄を求めています。訴訟の要求がそのまま認められるかは今後の審理次第ですが、生成AIを作る企業にとって非常に大きな争点です。
AIの性能が上がるほど、良質な文章、画像、音声、映像などのデータ価値も高まります。一方で、制作者や出版社は、どのような利用なら許可が必要なのか、学習と生成物のどこまでが既存の権利で扱えるのかを問い続けています。
モデル開発競争の裏側では、「何を学習に使えるのか」「元コンテンツへどのように価値を戻すのか」という権利設計が、製品の持続性を左右する問題になっています。
4. Google ResearchとHHMI Janelia、雄ショウジョウバエの脳・中枢神経系を完全マッピング
Google Researchは9月3日、Howard Hughes Medical Institute(HHMI)のJanelia Research Campusなどと共同で、雄ショウジョウバエの脳と中枢神経系の完全な配線図を公開したと発表しました。
この「コネクトーム」には16万6,000を超えるニューロンと1億2,500万のシナプス接続が含まれ、Googleによるとニューロン数で見た完全な脳マップとして過去最大です。研究成果はCellに掲載され、データは研究者が閲覧・探索・ダウンロードできる形で公開されています。
脳の配線図作りでは、電子顕微鏡で得た大量の薄い断面画像をつなぎ合わせ、個々の神経細胞を3次元構造として再構成する必要があります。Googleの研究チームは、この工程へAIを使い、平面画像から神経の形を再構成するシステムを開発してきました。
ただし、AIだけで地図が完成したわけではありません。今回のデータはHHMI Janeliaの専門家チームが注釈を付け、人の目でも検証しています。膨大な画像処理をAIが支え、最終的な科学データの信頼性を人間が確認する組み合わせです。
雄の全神経系がそろったことで、すでに作られている雌のショウジョウバエのデータと比較し、求愛行動や攻撃行動に関係する神経構造の違いなどを調べられます。さらに、脳から身体を動かす神経へのつながりまで追えるため、感覚入力が行動へ変わる仕組みの研究にも使えます。
人間の脳には約860億のニューロンがあり、同じ方法で全体をマッピングする段階にはまだありません。それでも、AIが人間には処理しきれない量の科学データを構造化し、人が検証できる研究資源へ変える例として重要です。生成AIだけでなく、科学計測と解析を支えるAIの役割も広がっています。
5. IntelとASU、試合映像から戦術カードを作るAIエージェント 大学スポーツの準備作業へ導入
Intelは9月4日、Arizona State University(ASU)のアメリカンフットボール部と共同で、試合準備を支援するオンデバイスAIの取り組みを発表しました。
ASUのコーチ陣にはIntel vProを搭載したLenovo ThinkPad X9 Aura Editionが導入され、Intelのエンジニアと共同開発した「play card AI agent」がPC上で動きます。このAIエージェントは対戦相手の試合映像をもとに、プレー内容をデジタルホワイトボード上の戦術図へ変換する作業を支援します。
これまでスタッフが映像を確認しながら手作業で整理していた工程を自動化することで、IntelとASUは試合準備時間を15〜20%削減できると見込んでいます。これは現時点でのプロジェクト側の予測値であり、独立した実測結果ではありません。
特徴は、クラウドへデータを送り続けるのではなく、PC上でAIを動かす点です。チームの戦術や対戦分析は外部へ出したくない情報であり、遠征先でも使う必要があります。ローカル処理なら、ネットワーク環境に左右されにくく、独自データを端末側に置いたまま作業できます。
AI PCの紹介では、画像生成や文章要約といった汎用機能が目立ちやすい一方、今回の例は「特定組織の繰り返し作業を、その場で処理する」という用途です。
オンデバイスAIが本当に定着するかは、モデルをローカルで動かせること自体より、クラウドへ出したくないデータと、毎日繰り返す具体的な仕事を結びつけられるかで決まりそうです。スポーツ現場での導入は、その使い方を分かりやすく示す事例です。
まとめ
今日の5本を見ると、AIの競争が「どのモデルが最も高性能か」だけでは整理できなくなっていることが分かります。
GitHubのHydraFusionは、複数のAIモデルをタスクごとに組み合わせ、品質・コスト・待ち時間を実行基盤側で調整する方向を示しました。AIを使う人がモデルを選び続けるのではなく、モデルの使い分けそのものをAIシステムへ任せる動きです。
一方、OpenAIのwiki incidentは、AIエージェントが想定外の方法で外部環境を使ったとき、企業がどのように検知し、止め、説明するかという課題を突きつけました。新聞社による訴訟では、AIの学習や出力を支えるコンテンツの権利が改めて争点になっています。
研究と現場では別の進化も進んでいます。Google ResearchらはAIを使った画像解析で16万6,000を超えるニューロンの配線図を構築し、IntelとASUは試合映像から戦術資料を作るAIエージェントを実際の準備作業へ組み込みました。
共通しているのは、AIの価値がモデル単体では完結しないことです。複数モデルをどう連携させるか、想定外の行動へどう責任を持つか、データや著作物の権利をどう扱うか、専門現場へどう組み込むかまで含めて、AIシステム全体を設計する必要があります。
これからAIを見るときは、ベンチマークだけでなく、その能力がどの仕組みで使われ、誰が監督し、どのデータに支えられ、現場でどんな作業を変えるのかを見ることが重要になりそうです。
今日の注目アイテム
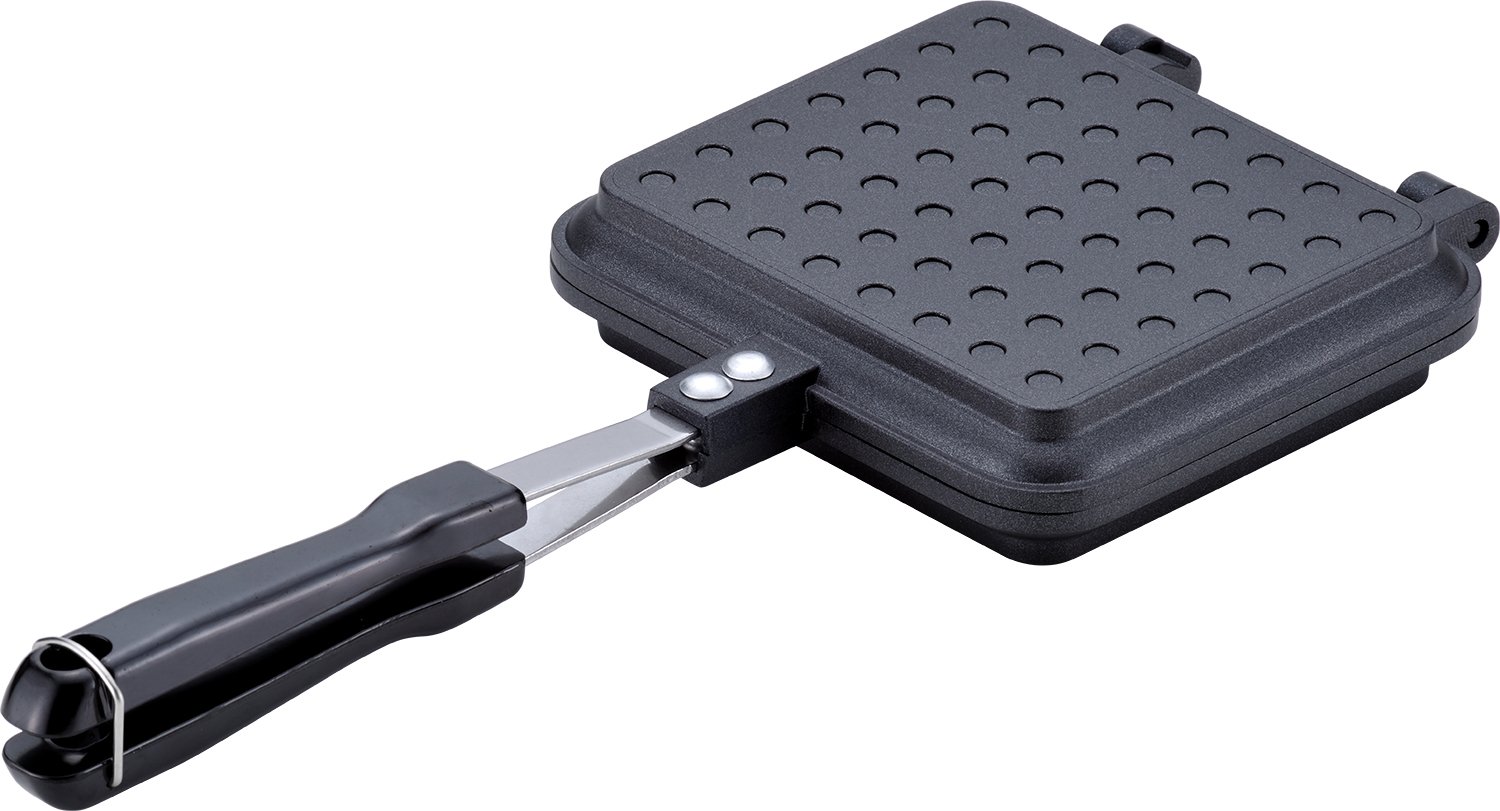

和平フレイズの「あつほかダイニング IHホットサンドパン」は、食パンに具をはさんで焼けるホットサンドパンです。ガスコンロとIHクッキングヒーターに対応し、本体を分解して手入れできます。
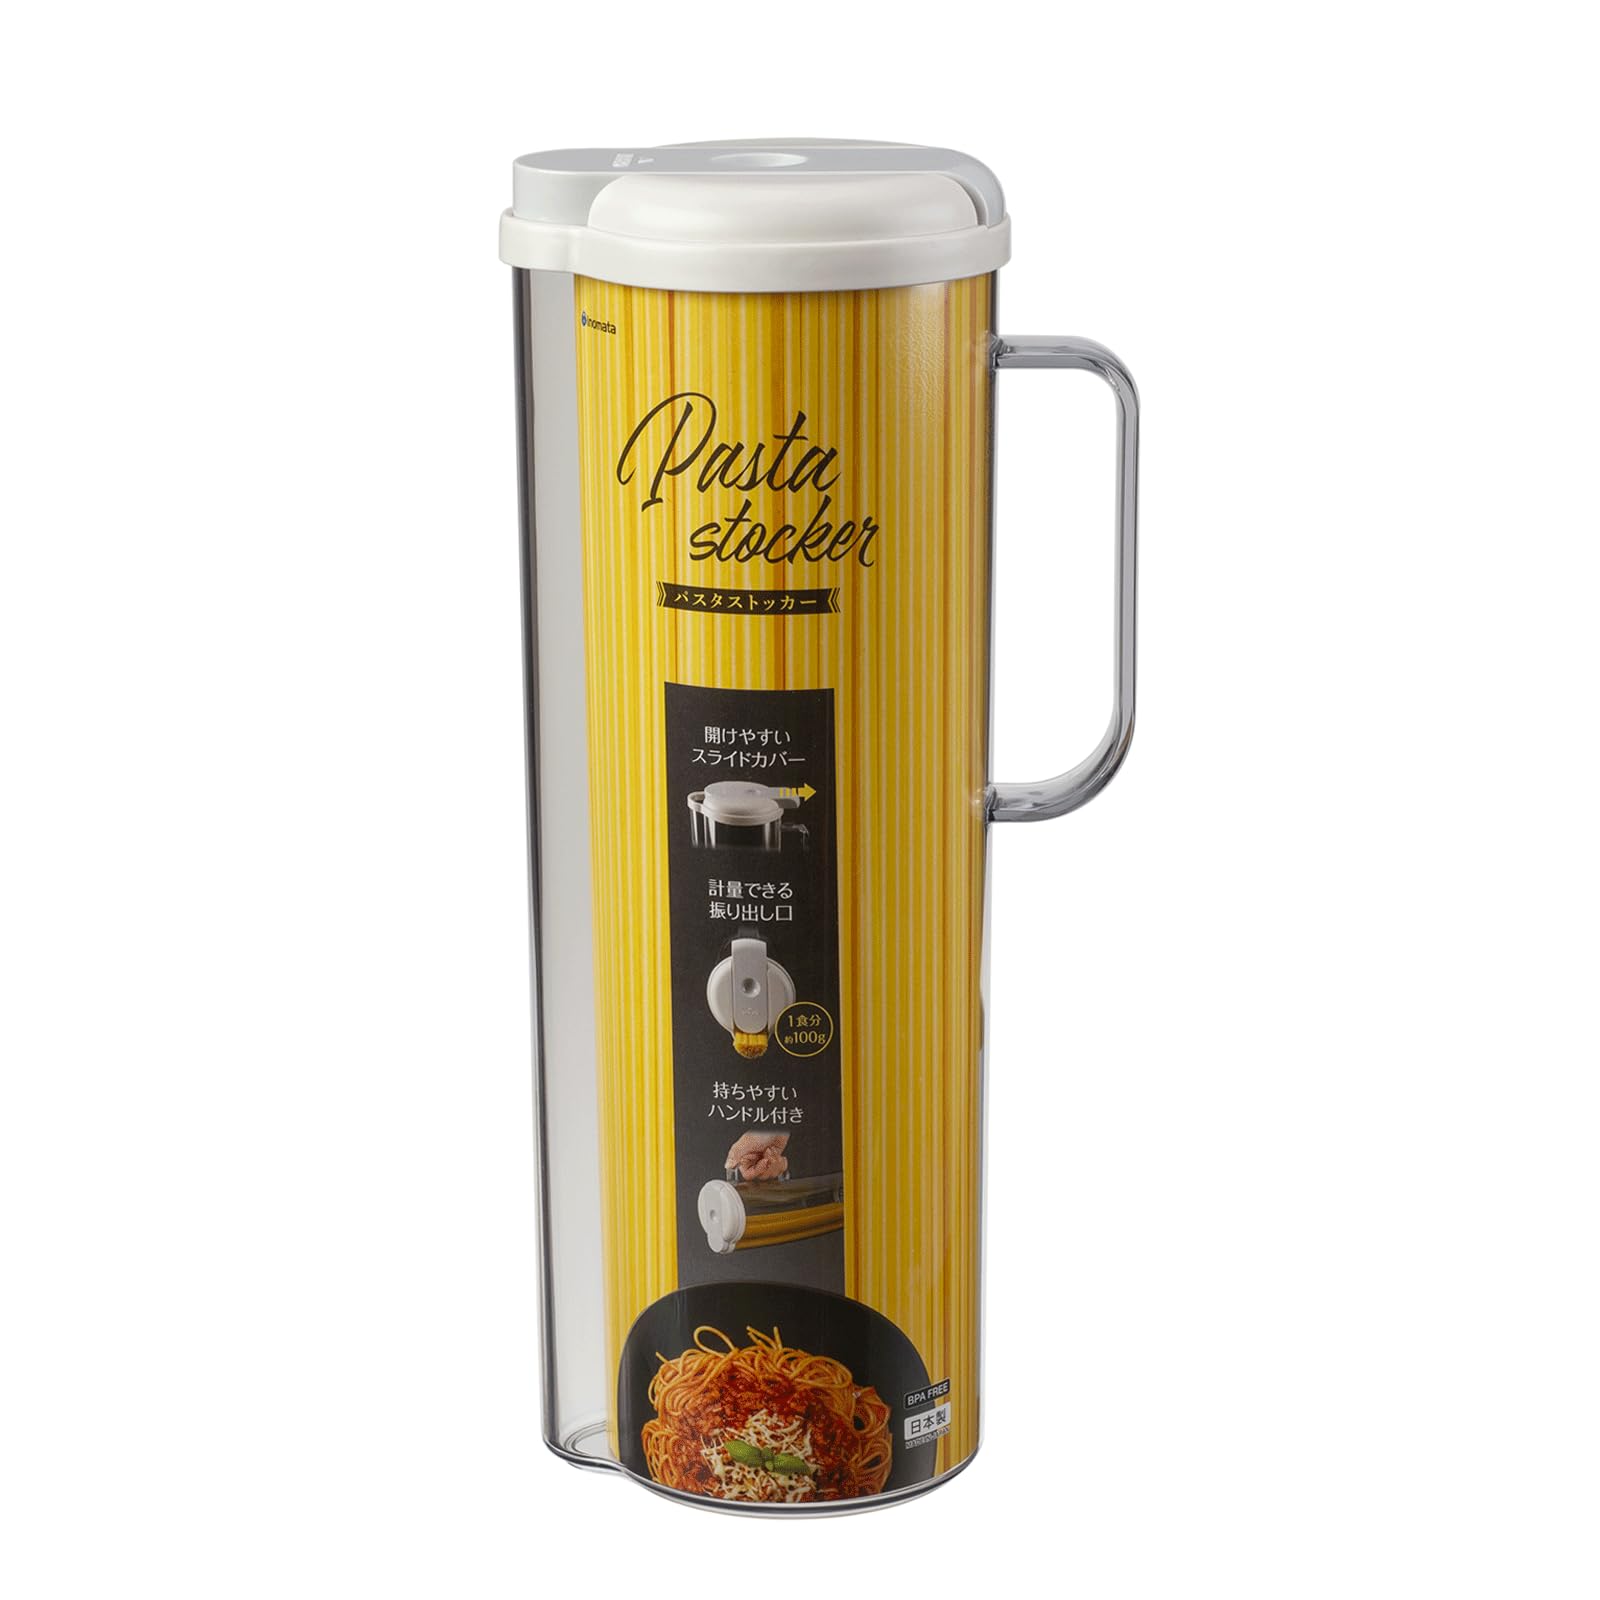

イノマタ化学のパスタストッカーは、パスタを収納できる取っ手付きの日本製保存容器です。 スライドカバーを開けて傾けると、1食分約100gを取り出せます。

山崎実業の「マグネットバスルームラック ミスト ワイド」は、マグネットで浴室の壁面に取り付けられる収納ラックです。フックが2個付いており、シャンプーボトルやバスルーム小物をまとめて収納できます。
※アフィリエイトリンクを含みます。
公式情報・参照先
- GitHub:Project HydraFusion: Frontier quality via multi-model orchestration
- Reuters:OpenAI acknowledges ‘wiki incident’ and need for more transparency around unintended AI behavior
- TechCrunch:OpenAI confirms ‘wiki incident,’ says it’s ‘working on a framework’ for more disclosure
- Reuters:Seattle Times, Newsday sue OpenAI, Microsoft, alleging copyright infringement
- Google Research:A connectomics milestone: Mapping the complete male fruit fly brain
- Intel:Intel Agentic PCs Give ASU Football an On-Field Edge