AIコーディングでは、タスクに合わせてモデルを選ぶ場面が増えています。
軽い修正は高速なモデル、難しい設計やデバッグは高性能モデル、実装後のレビューは別モデルというように、人が役割を分ける運用です。
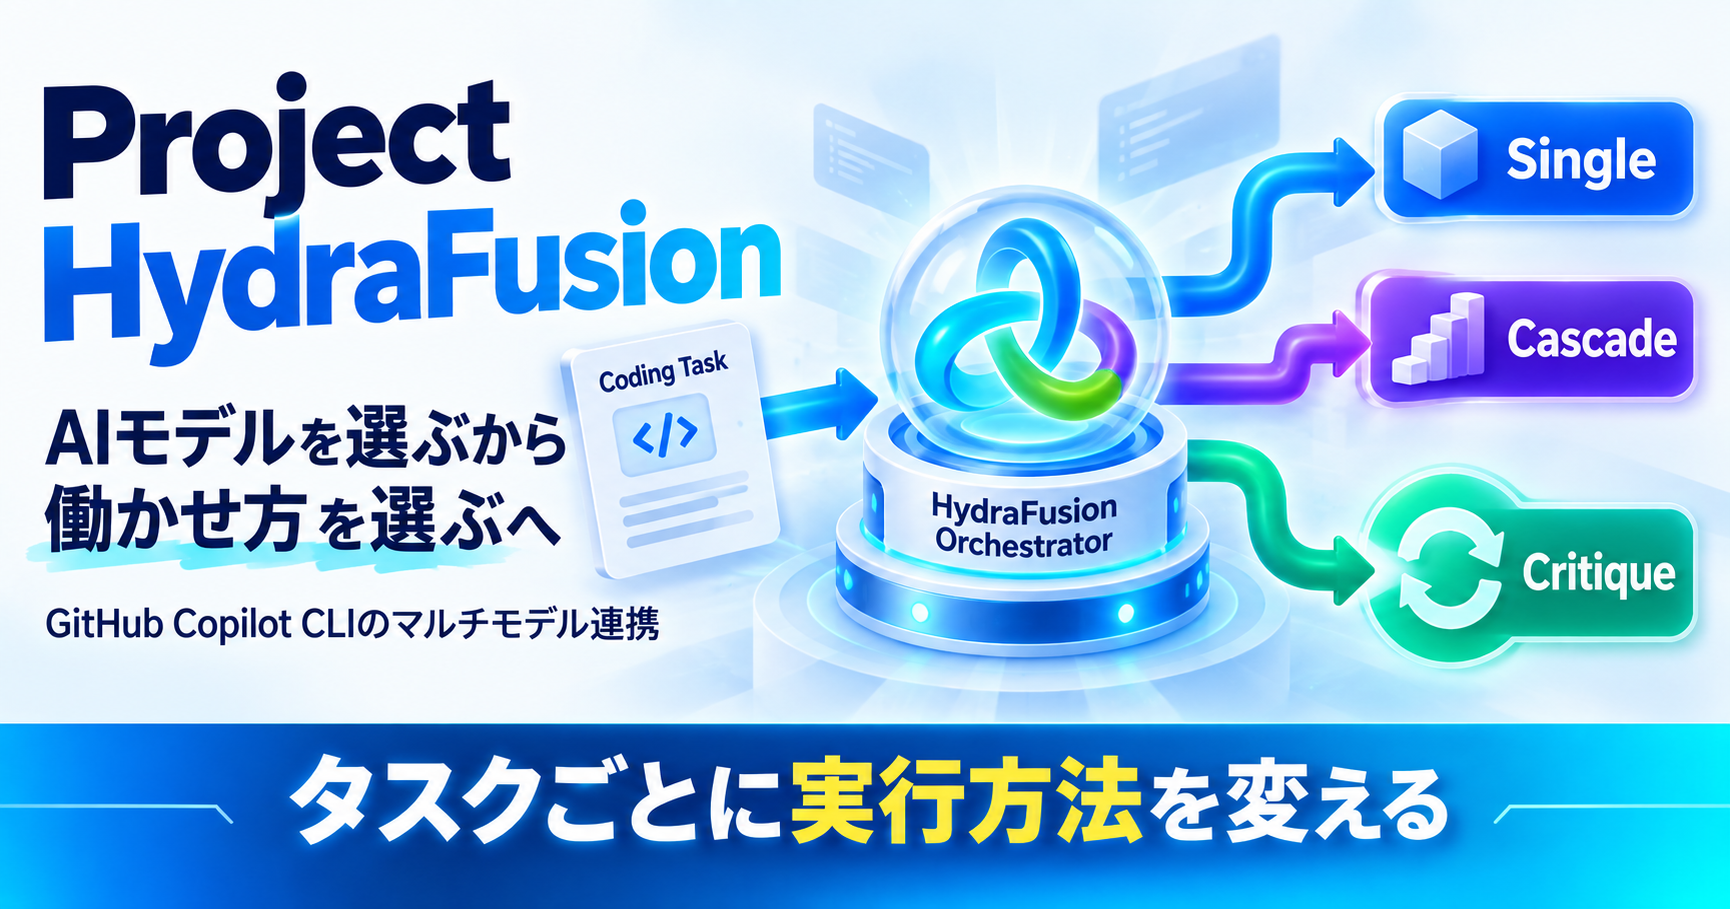
GitHubが2026年9月4日に公開したProject HydraFusionは、このモデル使い分けをさらに一段進めたResearch Previewです。
HydraFusion自体が新しい基盤モデルなのではありません。Copilot CLIで1つのモデルを選ぶ代わりにHydraFusionを選ぶと、タスク内容に応じてSingle、Cascade、Critiqueの3つの実行パターンから処理方法を選び、必要なら複数のAIモデルを組み合わせます。
2026年9月6日時点では、すべてのGitHub CopilotプランからCopilot CLIの実験機能として試せます。
この記事では、HydraFusionの仕組み、通常のAuto model selectionとの違い、3つの実行パターン、ベンチマークの見方、料金・AI Credits、現時点の制約まで見ていきます。
Project HydraFusionは「モデル」ではなく実行方法を選ぶ仕組み
GitHub Copilotでは、すでに複数のAIモデルから1つを選べます。
さらにAuto model selectionを使えば、タスクの複雑さやモデルの稼働状況などを見ながら、Copilot側が利用モデルを選択します。
HydraFusionは、ここからもう一段広い範囲を自動化します。
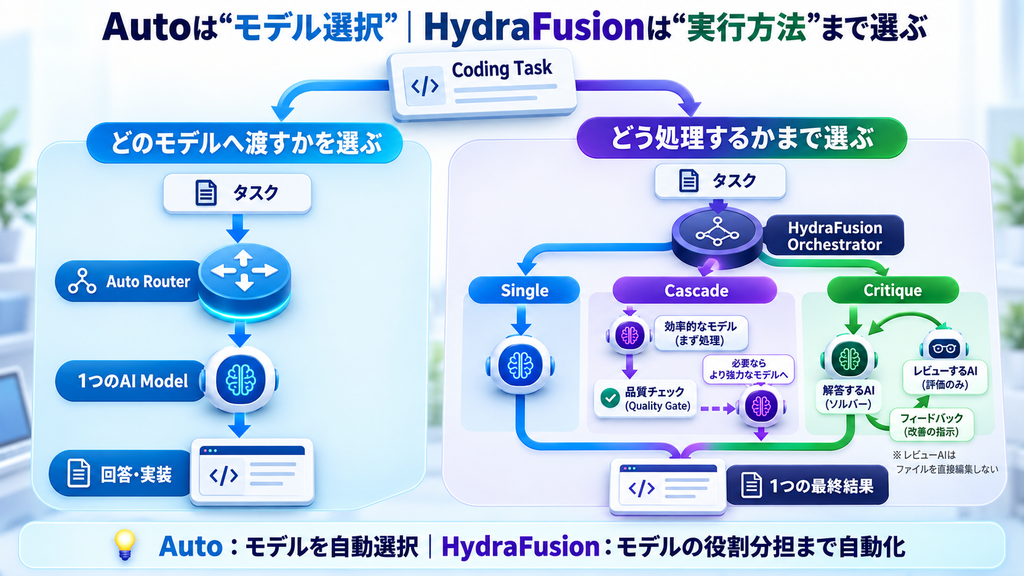
Auto model selectionが主に「このタスクをどのモデルへ渡すか」を選ぶのに対し、HydraFusionは「1つのモデルで終えるか、別モデルへ引き上げるか、別モデルにレビューさせるか」まで実行時に決めます。
例えば、人が手動で次のような運用をしているとします。
軽い修正
→ 高速なモデルへ依頼

難しい修正
→ 高性能モデルへ依頼

重要な変更
→ 別モデルへレビュー依頼
HydraFusionは、この判断の一部をCopilot側へ移します。
GitHubは、推論、コード生成、デバッグ、ツール利用などの能力シグナルを使い、要求される品質へ届くと見込める中で、できるだけ効率のよい実行パターンを選ぶと説明しています。
Single・Cascade・Critiqueの3つから選ばれる
HydraFusionが現在使う実行パターンは3種類です。
| パターン | 処理 | 狙い |
|---|---|---|
| Single | 1つのモデルで処理 | 余計な呼び出しを増やさず処理する |
| Cascade | 効率重視のモデルから始め、必要なら強いモデルへ引き上げる | 高性能モデルを常時使わず品質を確保する |
| Critique | 1つのモデルが作成し、別モデルがレビュー、その後1回修正 | 別の視点で問題を見つける |
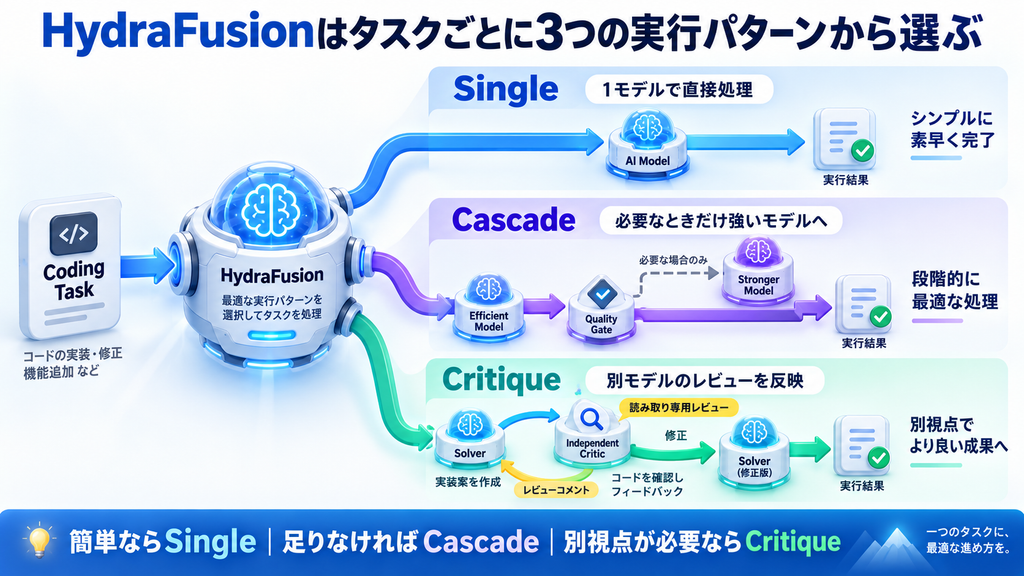
利用者が毎回この3つから選ぶのではありません。
Copilot CLIでHydraFusion (Research Preview)を選んでおくと、HydraFusion側がタスクごとに実行パターンを決めます。
Single|1モデルでそのまま処理する
Singleでは、選ばれた1つのモデルが通常のCopilotエージェントとしてタスクを処理します。
明確な修正や、1つのモデルで十分に完了できると判断されたタスクへ、不要なレビューやエスカレーションを追加しないための経路です。
複数モデルを使える仕組みだからといって、すべての依頼で複数モデルが動くわけではありません。
Cascade|必要なときだけ強いモデルへ引き上げる
Cascadeでは、まず効率重視のモデルが候補を作ります。
その結果を品質ゲートが確認し、基準へ届いていればそこで終了。足りなければ、より強いモデルへエスカレーションします。
つまり、
最初から毎回強いモデルを使う
のではなく、
まず効率重視のモデルで処理
↓
品質ゲート
↓
足りなければ強いモデルへ
という構成です。
この方式なら、比較的軽いタスクまで高コストなモデルへ固定する必要がありません。
ただし、エスカレーションが発生すればモデル呼び出しが増えるため、すべてのタスクで安くなるという仕組みではありません。
Critique|別モデルがレビューしてから1回修正する
Critiqueでは、最初のモデルが作った結果を、別のモデルファミリーに属する独立したcriticがレビューします。
そのレビュー結果を受けて、元のモデルが1回修正します。
実装・回答を作成
↓
別モデルがレビュー
↓
元のモデルが1回修正
GitHub Copilot CLIには、もともと別モデルからセカンドオピニオンを受けるrubber duckエージェントがあります。HydraFusionのCritiqueも、このレビュー方式を利用しています。
criticは読み取り専用で、リポジトリへ直接変更を加えません。ツールを持たない隔離されたコンテキストで評価し、修正そのものは元のモデル側が行います。
同じモデルへ「自分の実装をもう一度レビューして」と頼むより、モデルファミリーを変えることで同じ盲点を共有するリスクを減らす狙いがあります。
私もCodexでは、メイン実装者とは別のサブエージェントへレビューを任せる運用をしています。

HydraFusionのCritiqueは同じ仕組みではありませんが、実装役とレビュー役を分けるという考え方はかなり近いです。
Auto model selectionとの違い
HydraFusionと混同しやすいのが、GitHub CopilotのAuto model selectionです。
どちらも利用者が毎回モデル名を選ばなくてよい機能ですが、自動化する範囲が違います。
| 項目 | Auto model selection | HydraFusion |
|---|---|---|
| 主な役割 | タスクに合うモデルを選ぶ | タスクに合う実行ワークフローを選ぶ |
| 1回の処理 | 基本的に選択したモデルで処理 | 複数モデルが関与する場合がある |
| レビュー | 通常のモデル選択には含まれない | Critiqueで別モデルレビューあり |
| エスカレーション | タスクごとのモデル選択 | Cascadeで処理途中に強いモデルへ進める |
| 提供状態 | 一般提供 | Research Preview |
Auto model selectionでは、キャッシュ効率を保つため、セッション途中で無制限にモデルを切り替える設計にはなっていません。
HydraFusionは、その上で1つの依頼をcompound workflowとして構成し、必要な場合だけ追加のモデル呼び出しを行います。
モデルの数が増えたことで、「どれを選ぶか」だけではなく「どのモデルをどの役割で使うか」が次の運用課題になっているとも言えます。
ベンチマークの67%低コストはすべての作業へ当てはまる数字ではない
GitHubは、HydraFusionを3つのエージェント型コーディングベンチマークで評価しています。
Claude Opus 5を基準にした結果は次のとおりです。
| ベンチマーク | 推定コスト | 品質差 |
|---|---|---|
| TerminalBench 2.1 | 67%低い | +4.9ポイント |
| DeepSWE | 36%低い | -1.5ポイント |
| CheckpointBench | 65%低い | -0.1ポイント |
TerminalBench 2.1だけを見ると、「Opus 5より高品質で67%安い」というかなり強い結果です。
ただし、この67%を普段の開発へそのまま当てはめることはできません。
GitHub自身も、
- 固定されたオフライン評価
- 特定のベンチマーク版
- 特定のHydraFusion構成
- 特定のモデルプール
- 同じMedium reasoning条件
- 同じ価格前提
で測った結果だと明記しています。
DeepSWEでは品質がOpus 5より1.5ポイント低く、CheckpointBenchでも0.1ポイント下回っています。
見るべきなのは「必ず67%安くなる」ではなく、強いモデルをすべての工程へ固定しなくても、必要な場所だけ使うことで品質とコストを両立できる余地があるという点です。
HydraFusionの料金は使われたモデルとトークンで決まる
HydraFusion専用の固定料金が追加されるわけではありません。
GitHubの説明では、HydraFusion内で使われた各モデルのトークン量を集計し、それぞれの標準レートに基づいて利用量が計算されます。
Critiqueで別モデルのレビューが加われば、その分の利用も含まれます。Cascadeで強いモデルへエスカレーションした場合も同様です。
GitHub Copilotでは現在、AIモデルの利用量をAI Creditsで管理しています。1 AI Creditは0.01ドル相当で、利用モデルとトークン量によって消費量が変わります。
Copilot CLIにはセッション単位の上限も設定できます。
/limits set max-ai-credits NUMBER
HydraFusionのように内部で複数モデルが動く可能性がある仕組みでは、実際の作業でコストを見るなら、ベンチマーク値だけでなくセッション単位の利用量も確認した方がよいです。
Copilot CLIでHydraFusionを試す方法
2026年9月6日時点では、HydraFusionはGitHub Copilot CLIで利用できます。
手順は3つです。
/update
↓
/experimental on
↓
/model
/modelの一覧から、
HydraFusion (Research Preview)
を選択します。
すべてのGitHub Copilotプランが対象ですが、会社や組織からCopilotを利用している場合は、管理者側のCopilot CLIポリシーなどによって使える範囲が変わります。
Research Previewなので、通常の安定機能と同じ前提では使わない方がよいです。
最初は「まとまった1回のタスク」で試す
GitHubは現時点のHydraFusionについて、first-turn、single-promptのコーディングタスクから試すことを推奨しています。
特に、Autopilotへ1回で渡せる、ある程度まとまったタスクが現在の検証対象です。
例えば、
- 複数ファイルへまたがる機能追加
- 原因調査から修正・テストまで含むバグ対応
- 既存構造を読んで行うリファクタリング
- 実装後のレビュー価値が高い変更
などです。
反対に、長時間にわたる複数ターンの対話や、途中で細かく指示を変え続ける作業は、今後さらに強化する対象とされています。
そのため、現段階では「長時間の開発を全部HydraFusionへ任せればよい」と考えるより、1回でゴールを定義できる中〜大規模タスクで挙動と利用量を確認する方が現在のResearch Previewの狙いに合っています。
現時点では途中の判断が見えにくい
HydraFusionは内部で複数の処理を行いますが、途中のドラフトをすべて利用者へ表示する設計ではありません。
GitHubは現在、ワークフローの進行段階は表示しつつ、途中のドラフトは保持し、最後に1つの結果を返す方式を採用しています。
理由は、途中の案が後からレビューで破棄・修正される可能性があるためです。
一方で、待っている利用者から見ると「今どこまで進んでいるのか」「何を判断材料にしているのか」が見えにくくなります。
GitHub自身も、この可視性と待ち時間のバランスをResearch Previewで確認していると説明しています。
GitHub Communityでは、調査結果を見せてから判断を求めてほしいタスクで途中内容が表示されず、質問だけが見えてしまうという初期フィードバックも出ています。
また、Plan modeからHydraFusionへ切り替えようとすると以前のモデルへ戻るという報告があり、GitHub側が調査中と回答しています。
こうした部分は、正式提供までに変わる可能性があります。
HydraFusionで重要なのは「最強モデル固定」から離れる考え方
AIコーディングでは、新モデルが出るたびに「どれが一番強いか」が注目されます。
ただ、実際の開発ではすべてのタスクが同じ難易度ではありません。
- 単純な変更
- 難しい原因調査
- 大きな設計変更
- レビューが重要な変更
では、必要な推論量も確認工程も違います。
強いモデルをすべてに固定すれば品質を上げられる場面はありますが、コストや待ち時間も増えます。
HydraFusionは、
どのモデルが最強か
ではなく、
このタスクのどこに、どの程度のモデル能力が必要か
を実行システム側で判断しようとしています。
NVIDIA AVOの記事でも、長時間AIエージェントではモデルだけでなく、周囲のハーネスが重要だと紹介しました。
HydraFusionも、モデル性能そのものではなく、モデルをどう組み合わせ、評価し、必要なときだけ追加能力を使うかというハーネス側の進化として見ると位置づけが明確になります。
まとめ
Project HydraFusionは、GitHub Copilot CLIで複数AIモデルを実行時に組み合わせるResearch Previewです。
新しい基盤モデルではなく、タスクに応じて次の3つから実行方法を選びます。
- Single:1モデルで処理
- Cascade:効率重視のモデルから始め、必要なら強いモデルへ引き上げる
- Critique:別モデルがレビューし、元のモデルが修正する
Auto model selectionが「どのモデルを使うか」を自動化するのに対し、HydraFusionはモデル同士をどう働かせるかまで自動化する点が違います。
ベンチマークでは大きなコスト削減も出ていますが、特定条件のオフライン評価です。普段の開発で同じ削減率になるとは限りません。
現時点ではCopilot CLIのResearch Previewで、長い複数ターン作業より、1回で渡せるまとまったコーディングタスクが主な検証対象です。
AIコーディングの次の競争は、モデル単体の性能だけでなく、複数モデルを必要な場所へ配置するオーケストレーションにも広がっていきそうです。
公式情報・参照先
- Project HydraFusion: Frontier quality via multi-model orchestration|GitHub Blog
- HydraFusion is live in GitHub Copilot CLI|GitHub Community
- About Copilot auto model selection|GitHub Docs
- About the rubber duck agent|GitHub Docs
- Setting an AI credit session limit in GitHub Copilot CLI|GitHub Docs
- Optimizing your AI usage to maximize efficiency and reduce cost|GitHub Docs