当サイトではアフィリエイト広告を利用しています。
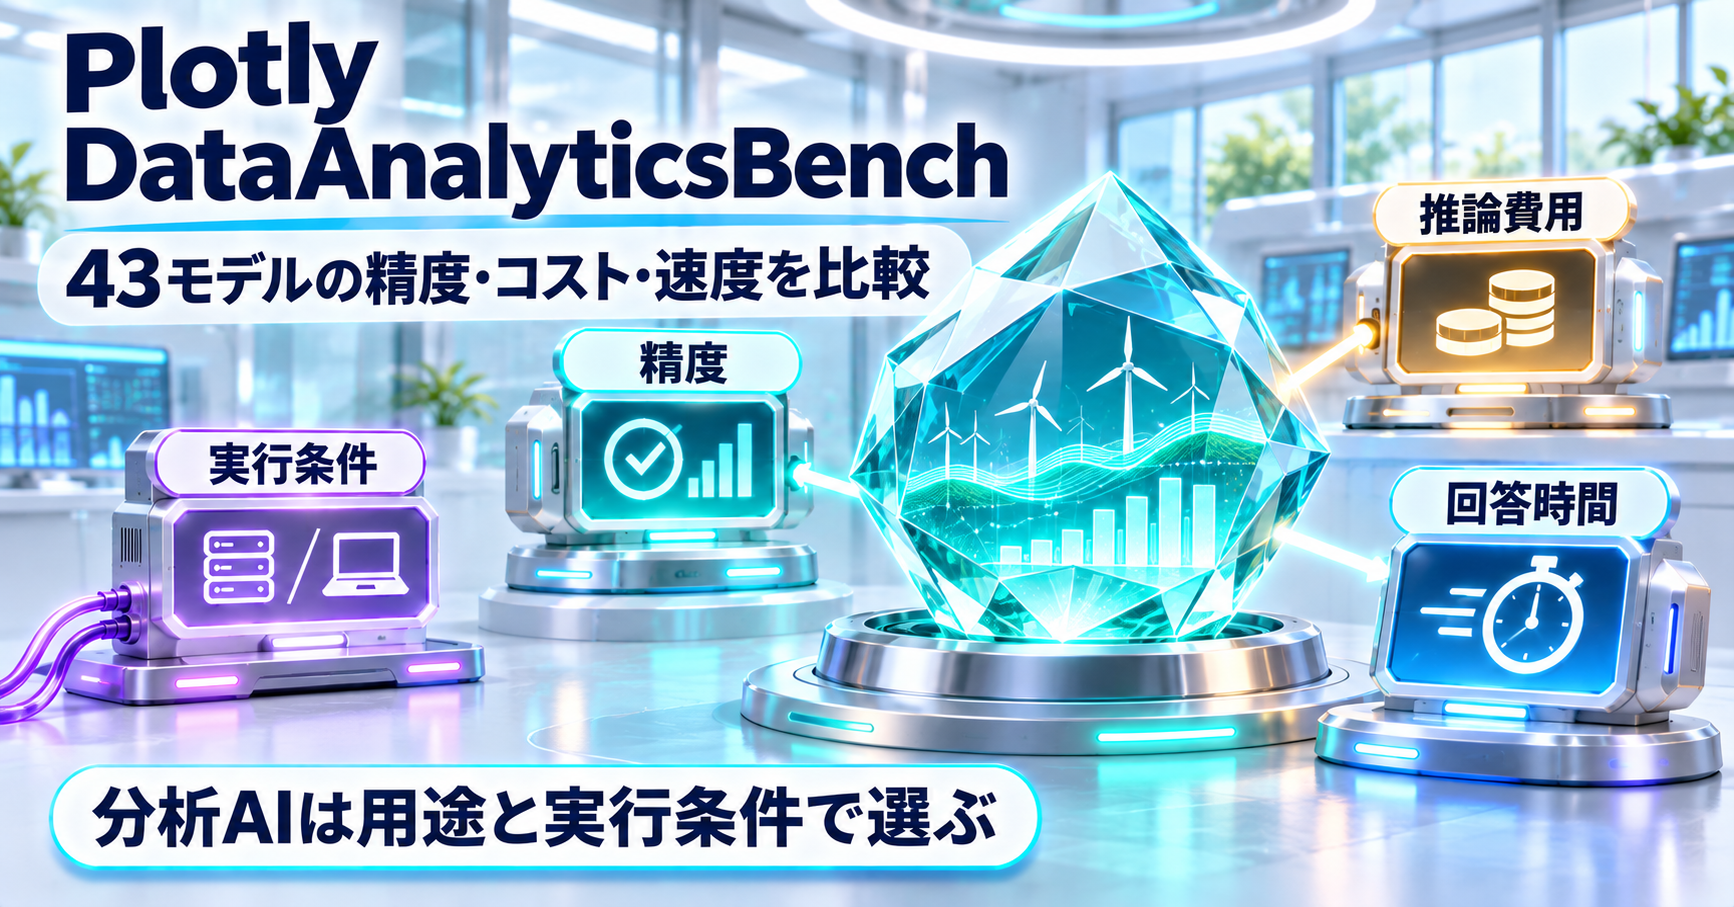
2026年11月6日、Plotlyはデータ分析AIの評価「DataAnalyticsBench」に18モデルを追加し、計43モデルの結果を公開しました。43問を約2,000万行のデータウェアハウスに対して解かせ、正答数、実行費用、所要時間を同じ表で比較しています。
正答数、43問全体の推論費用、回答時間を用途に合わせて比較すると、高得点のモデルと費用や待ち時間を抑えられるモデルを選び分けられます。例えば43問すべてに正解したGPT-6.1 Solは全問実行で2.61ドル、38問正解のGPT-6 Lunaは0.13ドル。いずれもPlotlyの実行環境と当時の料金条件による測定値です。
DataAnalyticsBenchは43問・約2,000万行の分析試験
PlotlyがMilaの研究者と開発したDataAnalyticsBenchは、架空の風力発電事業者のデータウェアハウスを使います。44テーブル、554列、約2,000万行のデータを、Plotly Studio Embeddedのエージェント環境から分析する試験です。
設問は合計43問。単純な集計に加え、曖昧な依頼の扱い、実行できない要求の見極め、データ品質の異常発見、統計的な問いへの回答、埋もれた傾向の探索を扱います。
| 評価の種類 | 何を確かめるか |
|---|---|
| 通常の分析 | データから求める数値や表を導けるか |
| 曖昧な質問 | 前提の不足や解釈の分岐を指摘できるか |
| 実行不能な要求 | データから答えられない条件を認識できるか |
| データ品質 | 重複や異常な計測値などの問題を発見できるか |
| 統計・隠れた傾向 | 誤った結論を避け、深い分析へ進めるか |
集計結果を出す能力と、その集計を信頼してよいか判断する能力の両方が問われます。
43モデルへの拡張で比較できることが増えた
10月14日に公開されたベンチマーク記事は、11月6日の更新で18モデルを追加しました。新たに含まれたモデルにはGPT-6.1 Terra、Hy4、Ripple-65B Preview、Mercury 3、Muse Spark Open、Kimi K3.1 Pro、MiniMax M3.1 Flashなどがあります。
43という数字は評価対象モデル数であり、設問数も43問です。「43モデル × 同じ43問」をPlotlyのハーネスで実行した結果として読みます。
比較表には正答数、43問を通したAPI費用、トークン数、1問あたりの中央値・平均時間、全体の所要時間が並びます。料金は主に実行日のOpenRouter表示価格に基づき、例外的にモデル提供元の定価を用いたケースもあります。
同じ高得点でも費用と時間は大きく異なる
11月6日更新の公式結果から、比較の特徴が見えるモデルを抜粋しました。
| モデル | 正答数 | 43問の費用 | 1問の中央値 | 全43問の時間 |
|---|---|---|---|---|
| GPT-6.1 Sol | 43/43 | 2.61ドル | 18秒 | 22分 |
| GPT-6 Astra | 43/43 | 19.97ドル | 27秒 | 31分 |
| Hy4 | 42/43 | 2.11ドル | 約1.9分 | 2時間56分 |
| Kimi K3.1 Pro | 42/43 | 13.47ドル | 約2.5分 | 3時間27分 |
| Particle-1 | 40/43 | 0.35ドル | 16秒 | 28分 |
| GPT-6.1 Terra | 40/43 | 1.31ドル | 15秒 | 17分 |
| GPT-6 Luna | 38/43 | 0.13ドル | 18秒 | 19分 |
| Claude Haiku 5.5 | 37/43 | 0.38ドル | 14秒 | 15分 |
| Mercury 3 | 35/43 | 0.41ドル | 9秒 | 10分 |
| Ripple-65B Preview | 35/43 | 2.21ドル | 約2.1分 | 2時間18分 |
出典はPlotlyのDataAnalyticsBench公式結果表(2026年11月6日更新)。費用は1モデルが43問を1回解いた全体の推論費用で、業務システムの月額料金ではありません。
GPT-6.1 SolとGPT-6 Astraはともに満点ですが、試験全体の費用は約7.7倍異なります。42問のHy4は費用が2.11ドルと近い一方、全問実行には約3時間かかっています。35問のMercury 3は約10分で終了しました。
業務で大量の分析を回すなら、正答数に加えて1件の待ち時間と、必要な品質を満たす1件あたりの費用が選定条件になります。
「正答」の中身は数値回答と問題発見で異なる
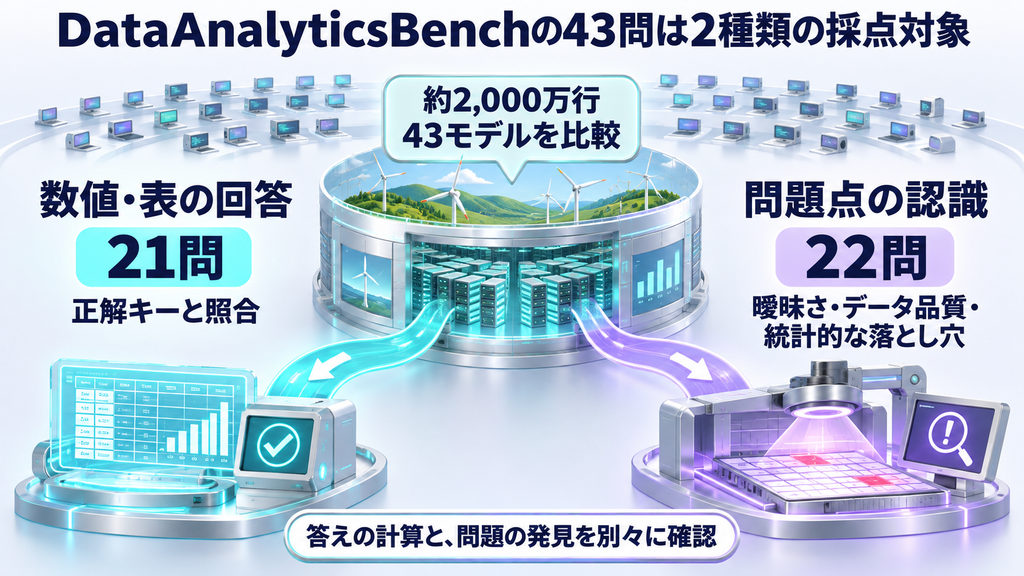
43問は、数値・表形式の回答を正解キーと照合する21問と、曖昧さやデータ不具合、統計的な落とし穴などの問題点を認識したか判定する22問で構成されています。
- 21問:数値や表の回答を、定めた許容誤差内で正解キーと比較する
- 22問:曖昧さ、実行不能、仕込まれたデータ不具合、統計的な落とし穴など、期待される問題点を認識したか判定する
採点にはClaude Sonnet 5を温度0で使用し、部分点はありません。正解キーはSQL、Pandas、Polarsという3通りの独立計算が一致することを確認して作成したとPlotlyは説明しています。
つまり42/43と40/43の差を解釈するには、どの種類の問題を落としたかが重要です。Plotlyの分析では、隠れた傾向の発見にモデル間の差が見られます。クエリ回数を増やしただけで発見数が伸びる関係でもなく、どのデータを調べ、異常に気づくかが結果に影響しています。
この評価では、正しい数値を出すことと、問題のある入力・前提を見抜くことが同じ1問として合算されます。自社の業務では、失敗の影響が大きい種類の設問を重く扱う設計も考えられます。
1〜2問差はノイズの範囲として、社内データの再評価と組み合わせる
Plotlyは各モデルを基本的に1回ずつ実行しており、誤差範囲を示すエラーバーはありません。43問のうち1問は約2.3ポイントに相当し、採点の境界判定やモデルの非決定性で結果が動きます。同社は1〜2問の差をノイズの範囲として扱っています。
さらに、試験データは一つの風力発電ウェアハウスで、質問は英語、実行基盤はPlotly Studio Embeddedです。自社の日本語データ、権限、データベース、BIツールで同じ順位になることを示した評価ではありません。
このためモデル選定では、公開ベンチマークを候補の絞り込みに使い、社内データを模したテストで再確認するのが実務的です。
ローカル実行は「重み公開」と「測定環境」を分ける
Plotlyはオープンウェイトモデルも評価しています。11月7日のローカルモデル解説では、ウェイト公開済みまたは公開予定の22モデルをハードウェア要件別に整理しています。
DataAnalyticsBenchの43モデルはOpenRouter経由で測定されています。ローカル実機で43問を再測定した結果ではありません。ハードウェア要件は主に4ビット量子化時の重みメモリ概算を基にした別の検討材料です。
例えばKimi K3.1 Proは42/43で、オープンウェイトモデルとして高得点ですが、Plotlyは約1.6TB規模の重みとGPUサーバー級の環境を挙げています。Ripple-65B Previewは35/43で、RicursiveはNVIDIA DGX Sparkでの実行例を案内しています。前者の高い正答数と、後者の運用環境の選択肢は別軸で判断します。
Ripple-65B Previewのモデル構造、公開チェックポイント、実行環境の評価軸は次の記事で確認できます。
業務のデータ分析AIを選ぶ4つの評価軸
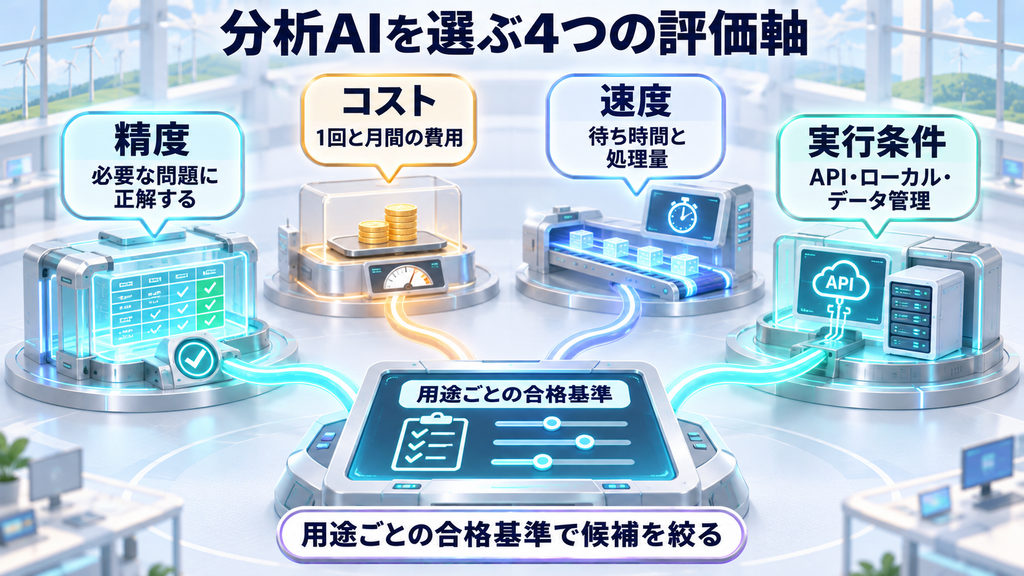
公開結果を実務の選定表へ変えるなら、次の4軸が使えます。
| 評価軸 | DataAnalyticsBenchの測定値/選定時の補助情報 | 自社で追加する確認 |
|---|---|---|
| 精度 | DataAnalyticsBench:43問の正答数、失敗した問題の種類 | 重要な業務質問、データ品質異常、統計判断の再現 |
| コスト | DataAnalyticsBench:43問を通した推論費用 | 1件あたりの呼び出し回数、月間件数、再試行費用 |
| 速度 | DataAnalyticsBench:中央値、平均、全問の所要時間 | 利用者の許容待ち時間、ピーク時の遅延 |
| 実行条件 | 別途確認する補助情報:API利用、重み公開・公開予定、ハードウェア目安 | データ持ち出し条件、利用ライセンス、GPU・運用体制 |
例えば、定型レポートを大量に生成する用途なら、精度の最低条件を満たしたモデルのうち費用と待ち時間が小さい候補を優先できます。データ異常の見逃しが重大な用途なら、総合点に加えてデータ品質や隠れた傾向の発見を個別に検証します。機密データを扱う用途なら、ホスト先とローカル実行の可否が先に決まることもあります。
合格基準を用途ごとに先に定義すると、精度・費用・速度の測定値と、別途確認する実行条件から用途に合う候補を選べます。
まとめ
DataAnalyticsBenchは、約2,000万行のデータウェアハウスを対象に43問を解くデータ分析AI評価です。11月6日に18モデルが追加され、比較対象は43モデルになりました。
DataAnalyticsBenchでは、正答数、43問全体の推論費用、回答時間を同じ評価環境で比較できます。モデルの実行条件は、オープンウェイト/ローカル実行に関する別の情報を選定時の補助材料として確認します。採点には問題発見型の設問も含まれ、集計能力と問題発見の両方を評価する設計です。
モデルを選ぶ際は、精度の合格基準を決め、DataAnalyticsBenchの費用・速度と、別途確認する実行条件で候補を絞り、自社のデータと業務質問で再評価する流れが役立ちます。