当サイトではアフィリエイト広告を利用しています。
今日のAIニュース5選
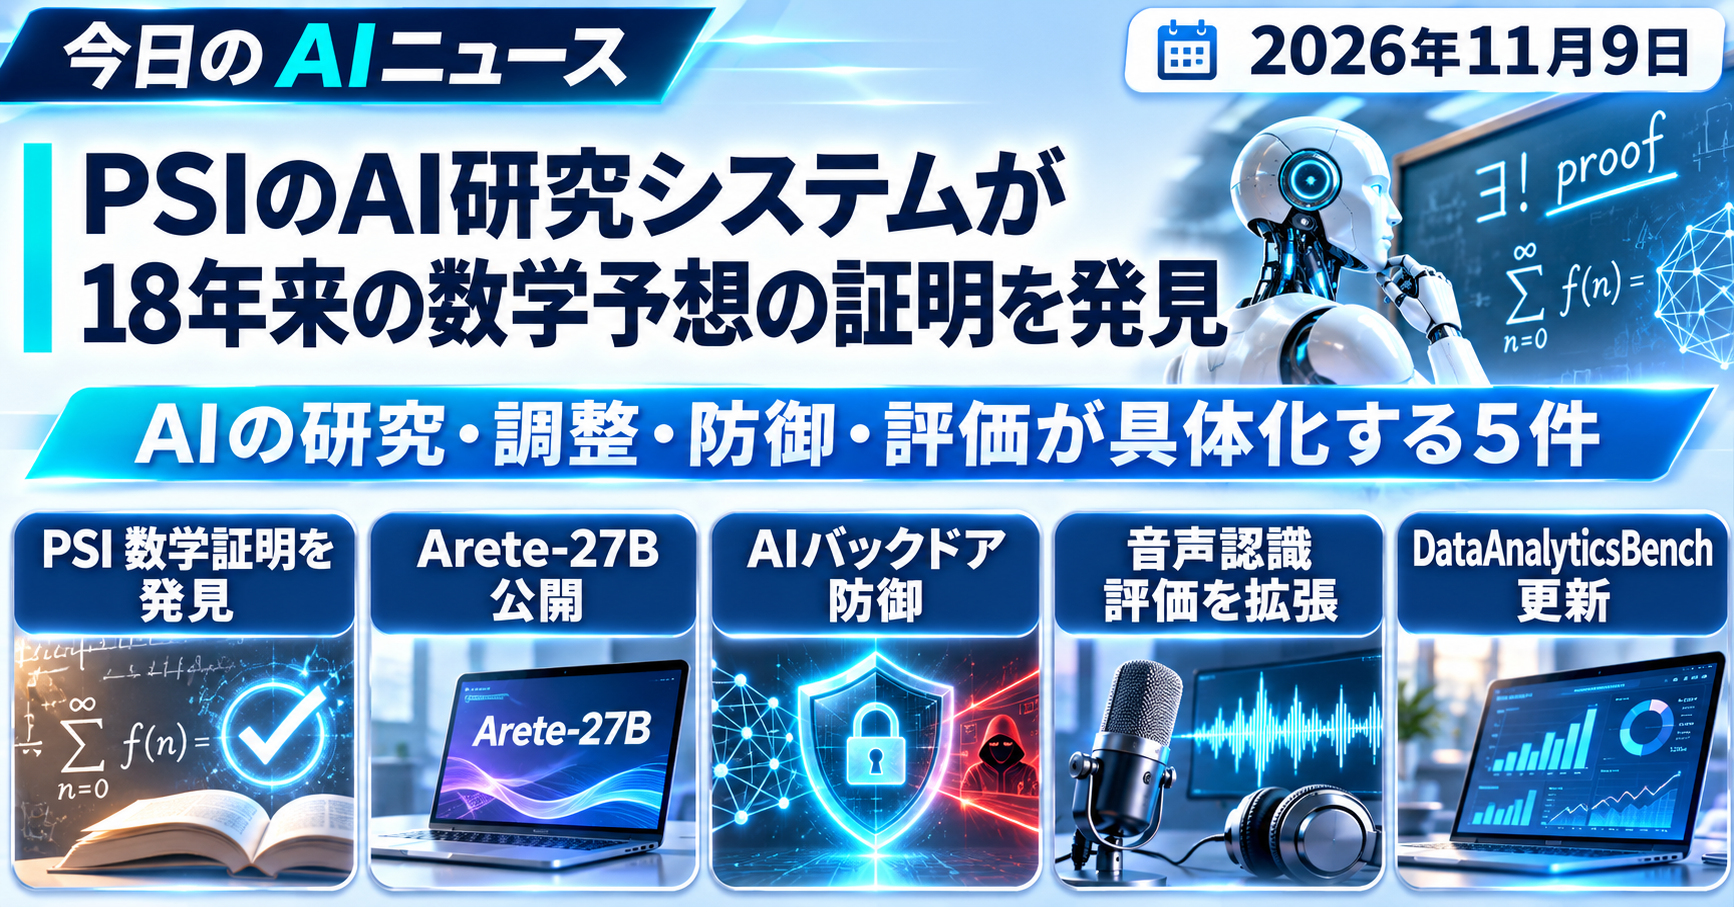
AIが研究者の補助役から、未解決問題の証明探索まで踏み込む事例が出てきました。PSIは11月6日、2008年から未解決だったAaronson–Ambainis予想について、社内のAI研究システムが証明を見つけ、証明支援系Leanによる機械検証を通過したと発表しました。
同じ日には、Nous Researchが公開ウェイトモデルの価値観を後学習で調整したArete-27Bを公開しています。さらに、AIモデルのバックドア防御、音声認識のアクセント評価、データ分析AIの実務ベンチマークにも新しい動きがありました。今回は、モデルの点数に加えて「AIをどう研究・調整・評価・防御するか」まで具体的に追える5件を見ていきます。
1. PSI、AI研究システムがAaronson–Ambainis予想の証明を発見
Physical Superintelligence(PSI)は11月6日、量子計算理論で2008年から未解決だったAaronson–Ambainis予想について、社内開発のAI研究システムが証明を見つけたと発表しました。実行には非公開のAnthropicモデルの複数インスタンスを使い、開始から3日目に完全な証明へ到達したとしています。
Aaronson–Ambainis予想は、ランダムな入力に対して量子コンピューターが通常のコンピューターより指数的に少ない問い合わせ回数で問題を解けるか、という量子クエリ計算量の重要問題に関わります。Scott Aaronson氏とAndris Ambainis氏は、ある多項式の性質が成り立てば、ランダムな入力では量子計算の優位性が多項式程度に抑えられることを示していました。その数学的な予想自体が長く未解決でした。
PSIのシステムが作った証明は、形式証明支援系Leanが各ステップを機械的に検証し、最初の証明と、その後に改良された最終版を受理しました。証明は既存研究のアイデアを組み合わせながら新しい境界を導く構成です。PSIは証明とコードも公開しています。
人間の専門家による検討も進んでいます。2026年8月に特殊な場合を解決していたStanford大学の研究者らがPSIの完全証明を読み、コメントを送り、専門家向けの短い解説を書いているとPSIは説明しています。AIが出した証明をLeanで形式検証し、その後に数学者が読み直す流れまで含め、AI研究システムを未解決問題へ使う新しい研究工程が見えてきました。
2. Nous Research、価値観を再調整した公開モデル「Arete-27B」を公開
Nous Researchは11月6日、AlibabaのQwen3.8-27Bを出発点に、回答の価値観やフレーミングを再調整した公開モデル「Arete-27B」を公開しました。重み、評価用データ、学習データをまとめて公開しています。
学習では、表現の自由、国家イデオロギー、市場経済、教育、データプライバシーと監視、民主主義、環境政策の7分野を対象にしました。約2万件のプロンプトを生成し、評価セットとの重複を除いたデータを使って教師モデルの回答を収集しています。実際の微調整は約5,280万トークン、2エポック、1,202ステップで、手法は教師あり微調整(SFT)のみです。
Nous Research独自の803問評価では、必要な事実をどれだけ含むかを測る事実スコアが、元のQwen3.8-27Bの2.32からArete-27Bの2.98へ上昇しました。同社が「propaganda」と定義した特定の政治的フレーミングを含む回答の割合は22%から0.9%へ低下しています。これらはNous Researchが作成した評価と定義に基づく結果です。
一般能力については、同社のHermes Benchで元モデル65.77%、Arete-27B 65.60%となり、Nous Researchは測定上の差を小さいと評価しています。Terminal-Bench-2.1では67%から70%でした。Nous Researchは、推論条件や評価環境で公式結果との差が生じる点を明記しています。今回の公開は、公開ウェイトモデルの振る舞いを後学習で変え、その変化を事実性・フレーミング・一般能力の複数軸で検証する実例です。
3. NC State、AIモデルのバックドア攻撃を抑える3つの防御技術を公開
米ノースカロライナ州立大学(NC State)は11月6日、AIモデルへ隠されたトリガーを埋め込み、特定条件で悪意ある動作を起こさせる「バックドア攻撃」に対する3つの防御技術を発表しました。モデルの特徴表現、アーキテクチャ、重みという異なる層をそれぞれ対象にしています。
バックドアは、通常の入力ではモデルが正常に振る舞い、特定の語句やパターンなどのトリガーが入ったときだけ攻撃者が狙った出力を起こす仕組みです。普段のテストで挙動が表面化しにくいため、追加学習用のデータやモデルを外部から取り込む場面では安全上の重要な確認点になります。
1つ目の研究はLoRAで微調整したモデルの特徴表現からバックドア方向を抽出し、更新成分をその方向と直交する空間へ投影する方法です。実験では攻撃成功率をほぼ100%から10%未満へ下げながら、元の能力と追加学習で得た能力を維持したと報告しています。2つ目は、トリガーに反応する挙動を専用の「隔離されたExpert」へ集め、運用時にその経路を停止する方式です。
3つ目は、トリガーの事前情報とクリーンな参照モデルがない条件で、重みに残るバックドア関連の表現を取り除く方法です。研究チームはさらに、トリガーを管理者だけが知る権限制御へ使う「secret alignment」という考え方も提示しました。攻撃防御に加えて、モデル内部のどの層へ危険な振る舞いが残るかを分けて扱う設計が進んでいます。
4. Hugging Face、Open ASR Leaderboardにエジプト・ナイジェリア英語を追加
Hugging Faceは11月6日、音声認識モデルを比較するOpen ASR Leaderboardへ、Liva AIが提供するエジプト英語とナイジェリア英語の非公開評価データを追加しました。既存の米国・英国・豪州・カナダ・インドなどのアクセントに加え、評価対象の地域をさらに広げる更新です。
追加されたのは、エジプト英語1.34時間とナイジェリア英語1.55時間の音声です。どちらも自然な会話を収録したデータで、書き起こしには大文字・小文字、句読点、言いよどみなども含まれます。整った読み上げ音声より、実際の会話に近い条件で性能を比べられます。
今回のデータは非公開のまま評価に使われます。評価セットが広く知られると、モデルや開発工程がその問題に合わせて最適化され、実利用での強さよりベンチマーク対策が効く「benchmaxxing」が起きやすくなります。未知のデータを残すことで、モデルが新しい話者やアクセントへどこまで対応できるかを測る狙いがあります。
Leaderboardの集計も、米国英語と非米国英語、さらに英語圏の分類を使った複数グループへ拡張されました。音声AIが世界中の利用者へ広がるほど、平均スコアと地域・アクセントごとの性能差を合わせて見る必要があります。今回の更新は、音声認識の「誰の英語で測った性能なのか」を評価表の中へ持ち込む動きです。
5. Plotly、DataAnalyticsBenchを43モデルへ拡張
Plotlyは11月6日、AIエージェントのデータ分析能力を測る「DataAnalyticsBench」を更新し、新たに18モデルを加えた計43モデルの結果を公開しました。DataAnalyticsBenchは、2,000万行のデータウェアハウスに対して43問の分析課題を解かせる評価で、Milaの研究者と共同で作られています。
評価には、単純な集計に加えて、データ品質の問題を見つける課題、統計的な問いへ意味のある答えを返す課題、データの奥に埋もれた傾向を探す課題まで含まれます。Plotlyによると、43モデル中24モデルは単純な分析問題をすべて解けた一方、難しい部分では差が残りました。
11月6日時点の結果では、GPT-6 AstraとGPT-6.1 Solが43問を全問通過しています。GPT-6 Lunaは38問で、1回の全評価コストは0.13米ドル。オープンウェイトではKimi K3.1 Proが42問で、Plotlyが評価した中では最も正確な公開ウェイトモデルとされています。InceptionのMercury 3は35問、全評価0.41米ドルで、1問あたり中央値9.3秒と同ベンチマーク最速でした。
同じ「データ分析AI」でも、最高得点、利用コスト、応答速度、ローカル実行に必要なメモリの優先順位で選択肢は変わります。Plotlyはコストと精度の両方で他モデルに劣らない組み合わせとして、GPT-6 Luna、Particle-1、Hy4、GPT-6.1 Solをコスト・精度フロンティアに置いています。業務用AIの評価が、1つの総合スコアから実際の運用条件を含む比較へ広がっていることが見える更新です。
まとめ
今回の5件で特に目を引くのは、AIの能力を「答えの質」だけで測る段階から、研究成果の検証方法やモデル内部の振る舞い、評価データの作り方まで含めて扱う動きです。PSIは未解決の数学予想をAI研究システムで探索し、Leanによる形式検証と数学者の読み直しを組み合わせています。Arete-27Bは公開ウェイトモデルの価値観を後学習で変え、その変化を独自評価で可視化しました。
NC Stateはバックドアを特徴・アーキテクチャ・重みの層ごとに防御し、Hugging Faceは音声認識評価へ新しいアクセントと非公開データを追加しました。PlotlyのDataAnalyticsBenchも、精度に加えてコスト、速度、ローカル実行条件まで比較しています。AIを実際に選び、使い、信頼するための評価軸は、検証方法、モデル内部の振る舞い、評価データ、コスト、速度、実行条件へと広がっています。
今日の注目アイテム
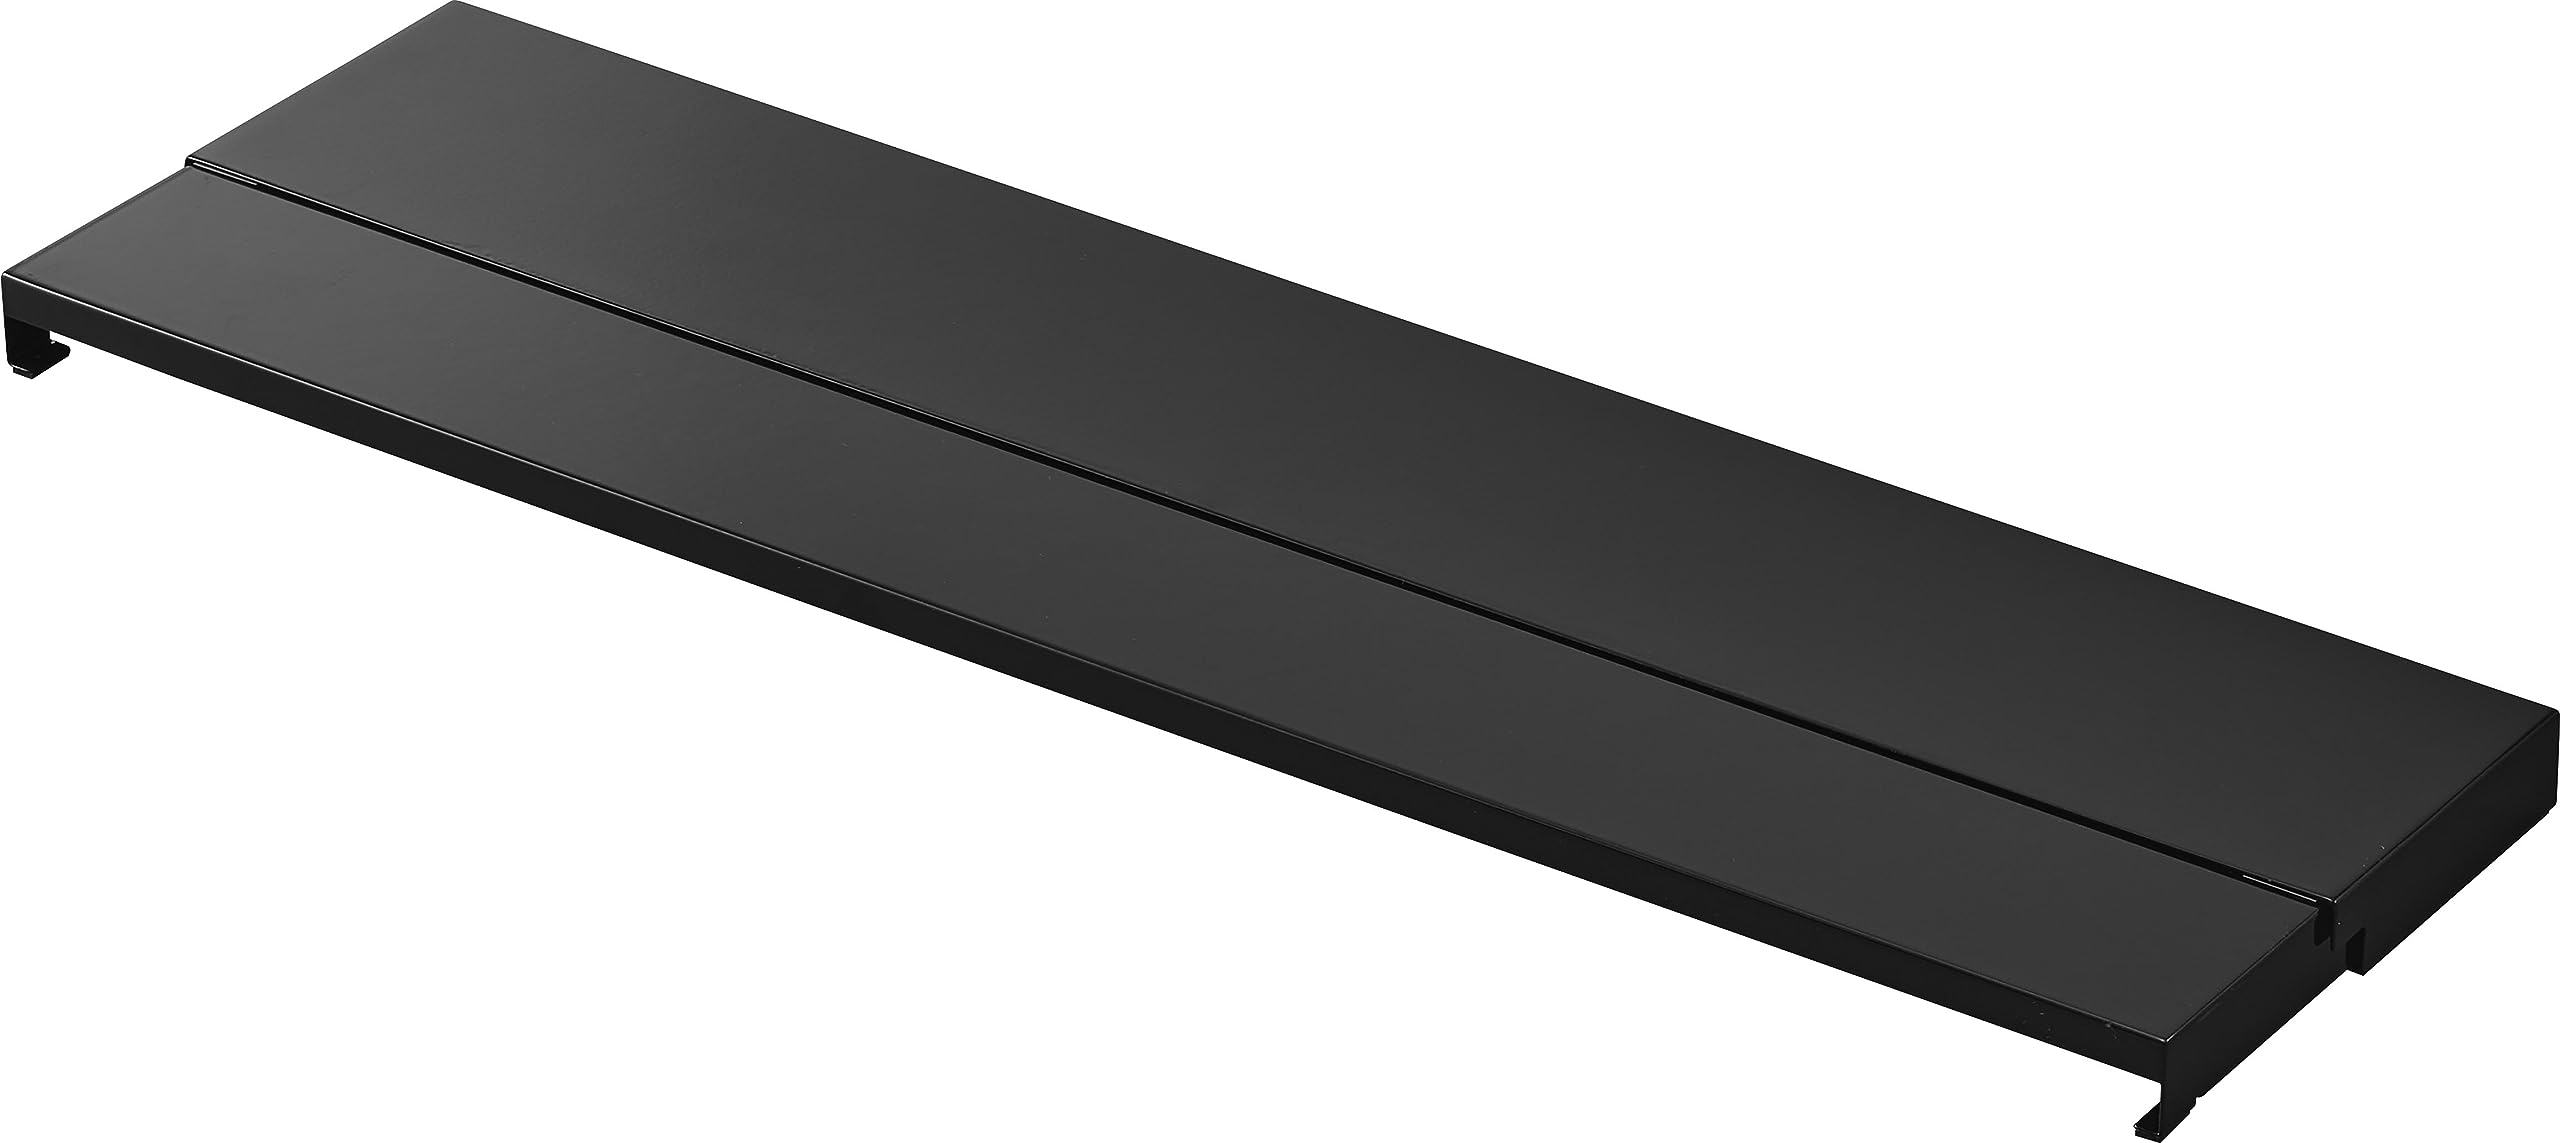

山崎実業のtower排気口カバーは、60cmのコンロ用で、奥行を伸縮できるブラックカラーの商品です。 コンロ奥ラックとしてちょい置きに使え、分解して洗える仕様です。

OXOのストレート型サラダスピナーは、1~3人分に対応し、回転して野菜の水切りができるボウル付きの商品です。 分解可能で、バスケットのみ食洗機に対応し、押すだけの操作とストッパーを備えています。

Toffyのレトロなデザインが特徴の、容量0.8Lのエレクトリックケトルです。 高速沸騰と空焚き防止の機能を備え、カラーはペールアクアと記載されています。
公式情報・参照先
- A proof of the Aaronson-Ambainis conjecture
- Introducing Arete-27B: Qwen3.8-27B Post-Trained To Reinforce Western Values
- Researchers Demonstrate Comprehensive Suite of New Techniques to Protect AI from ‘Backdoor Attacks’
- Egyptian and Nigerian English join the Open ASR Leaderboard
- DataAnalyticsBench: A Data Analytics Benchmark for AI (2026)