当サイトではアフィリエイト広告を利用しています。
2026年11月4日、Ricursive Intelligenceはオープンウェイトモデル「Ripple-65B Preview」を公開しました。
650億パラメータのDense Transformerを12兆トークンで事前学習し、モデル仕様として最大100万トークンのコンテキスト長に対応します。ライセンスはApache 2.0です。開発元はエージェント型コーディング評価のTerminal-Bench 2.1で80.52を記録したと発表しています。
Ripple-65B Previewを選ぶ際は、Preview段階、公開されているチェックポイント、実行環境、実際に使えるコンテキスト長、ベンチマークの実行条件まで合わせて確認する必要があります。
この記事では、Ripple-65B Previewのモデル仕様と公開内容を整理したうえで、公開ウェイトモデルを選ぶときの5つの評価軸へ落とし込みます。
Ripple-65B Previewの基本仕様
まず、公開時点で確認できる主要仕様をまとめます。
| 項目 | Ripple-65B Preview |
|---|---|
| 公開日 | 2026年11月4日 |
| 提供元 | Ricursive Intelligence |
| モデル構造 | 650億パラメータのDense Transformer |
| レイヤー数 | 80層 |
| hidden size | 5,120 |
| 事前学習 | 12兆トークン |
| 事前学習データ | 主に英語とコードのテキスト |
| コンテキスト長 | モデル仕様で最大100万トークン |
| ライセンス | Apache 2.0 |
| 主な公開チェックポイント | BF16のInstructionモデル、NVFP4のInstructionモデル、BF16のBaseモデル |
| Previewの重点 | エージェント型コーディング |
Ricursiveは、自社のAIチップ設計基盤で使う独自モデルをもとに、汎用版としてRipple-65B Previewを公開しました。
「65B」は650億パラメータを表します。RippleはDenseモデルで、モデル全体を使う構成です。MoE(Mixture-of-Experts)は、入力に応じて一部の専門ブロックを選んで動かします。
モデルカードでは、横に広げるより深くする「thin-and-deep」の設計として、hidden size 5,120、80層を採用しています。モデルの重さや実力は、総パラメータ数に加えて構造、精度、推論環境まで一緒に見ます。
Previewで公開された3種類のチェックポイント
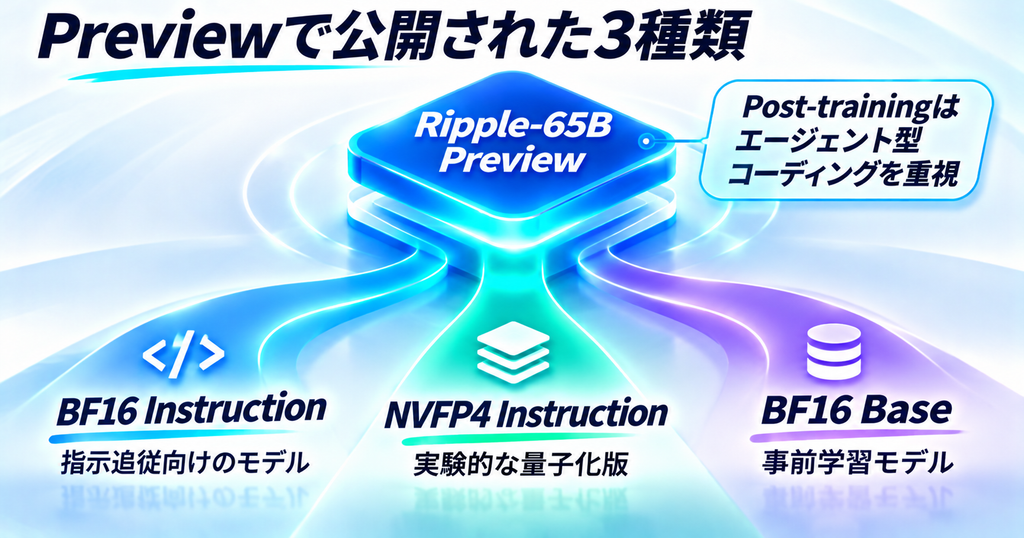
今回の名称には「Preview」が入っています。モデルカードでも、今回のリリースは比較的軽いPost-trainingを行い、特にエージェント型コーディングへ重点を置いた段階と説明されています。
公開内容は大きく3種類です。
- BF16 Instructionモデル:指示追従向けに調整された標準的な公開モデル
- NVFP4 Instructionモデル:メモリ使用量や推論効率を意識した実験的な量子化チェックポイント
- BF16 Baseモデル:Mid-trainingやInstruction tuning前の事前学習モデル
NVFP4版はHugging Face上でもExperimentalと明記されています。精度・互換性は、利用する推論基盤と用途で確認する対象です。
Previewという提供段階は、公開後のPost-training、ランタイム対応、ホスティング条件、ツール側の最適化が更新される余地を含みます。モデル名とバージョンを固定して検証結果を残す運用が重要になります。
650億パラメータのDenseモデルをどう見るか
Ripple-65B PreviewはDense構成です。最近の大規模オープンウェイトモデルではMoE構成も多く、比較時には構造の違いを確認します。
Ricursiveの比較表では、Ripple-65B Previewは総パラメータ650億・Active parameterも650億です。比較対象として挙げられた大型MoEモデルは、総パラメータが数千億規模でも1トークンの処理時に使うActive parameterは数百億という構成があります。
実行コストは、DenseかMoEか、数値精度、GPU構成、バッチサイズ、コンテキスト長、KVキャッシュまで含めて決まります。総パラメータ数は、その中の一つの指標です。
Hugging Face上のBF16モデルリポジトリは約130GBです。Ricursiveはローカル実行例としてNVIDIA DGX Sparkを挙げ、NVFP4チェックポイントも公開しています。
650億というモデル規模では、専用のローカルAI環境やGPUサーバーを使った自前運用が現実的な検討対象になります。
最大100万トークンはモデル仕様と実利用を分けて確認する
Ripple-65B Previewは、モデル仕様として最大100万トークンのコンテキスト長をサポートします。
モデルカードでは、事前学習を8Kのシーケンス長で進め、その後に64KのMid-training、長文向けの学習、128KのSFTやRLなどを重ねています。長い文脈を扱える能力を後段の学習で拡張した構成です。
実際の利用では、次の3つを分けて確認します。
- モデル側の最大対応長:Ripple-65B Previewでは最大100万トークン
- 推論サービスやランタイムの上限:利用するAPI・推論サーバー側で設定される長さ
- 実運用で使える長さ:GPUメモリ、KVキャッシュ、速度、コストを含めて許容できる長さ
実運用では、必要な範囲を絞る設計、検索、要約、キャッシュと組み合わせることで、長いコードベースや大量のログを扱う際の応答時間と計算資源を管理できます。
公開モデルを比較するときは「最大コンテキスト長」の数字を、実際に使うエンドポイントやローカル環境の条件とセットで確認すると判断しやすくなります。
Terminal-Bench 2.1の80.52は何を測っているか
Ricursiveが強く打ち出しているのが、Terminal-Bench 2.1の80.52です。
Terminal-Bench 2.1は、エージェントがコンテナ環境の中で複雑なタスクを完了できるかを見る評価です。公開リポジトリでは、非同期コードのデバッグ、セキュリティ脆弱性の修正、タンパク質合成に関わる作業など、ターミナル上で複数手順を進める課題が含まれると説明されています。
80.52は、ツールを使いながら作業を進めるエージェント型コーディング能力の評価値として読む数字です。
同時に、80.52はRicursive自身が報告した結果です。モデルカードでは、現代のエージェント評価はハーネス、コンテキスト長、要約方法などでスコアが動き、再現が難しいことも明記されています。
Rippleのモデルカードには、Terminal-Bench 2.1で公式のTerminus 2ハーネスを128K・要約ありで使うと、多くの比較モデルでスコアが下がったという説明もあります。モデル本体の能力と、モデルを動かすエージェント環境を一つの数字へまとめて見ると、条件差を見落としやすくなります。
公開ベンチマークを見るときに、モデル・ハーネス・安全制約・タスク条件を分けて読む考え方は、GDPxの記事でも詳しく整理しています。
自社のリポジトリ、ツール、テスト、承認条件を使った評価を追加すると、実運用に即した採用判断につながります。
公開ウェイトでも実行環境の対応は別に確認する
Apache 2.0でウェイトが公開されていることは、自社環境へ持ち込める選択肢を広げます。
実際に動かすには、モデル形式を読み込めるランタイム、十分なメモリ、GPU対応、チャットテンプレート、ツール呼び出し、量子化形式などが必要です。
公開直後のモデルでは、ランタイム側の対応がモデル公開後に進むケースがあります。執筆時点では、llama.cppでRipple-65Bを扱うための対応PR #31715がOpenの状態です。
新しいアーキテクチャを持つ公開モデルでは、ランタイム側の対応状況も運用条件の一つです。ウェイトをダウンロードできることと、普段使っている推論スタックで動かせることを分けて確認します。
ローカル運用を考える場合は、少なくとも次を事前に確認します。
- 使うランタイムがRicursiveアーキテクチャへ対応しているか
- BF16かNVFP4のどちらを使うか
- モデル本体とKVキャッシュを含めて必要メモリを確保できるか
- 必要なコンテキスト長で速度が実用範囲に入るか
- ツール呼び出しやチャットテンプレートが期待どおり動くか
公開ウェイトの価値は「自由に持てる」ことにあります。その自由度を実際の運用へ変えるには、モデル本体と推論環境をセットで評価する必要があります。
Ripple-65B Previewを選ぶ5つの評価軸
Ripple-65B Previewのような公開Previewモデルを選ぶときは、次の5軸に分けると判断材料をそろえられます。
1. Preview段階とPost-trainingの目的
Ripple-65B Previewは、比較的軽いPost-trainingを行い、エージェント型コーディングへ重点を置いたPreviewです。
自分の用途がコード作業なら公開時の重点と合います。一般的な日本語文書作成、翻訳、専門分野のQAなどへ使う場合は、用途別の評価を追加します。
2. モデル構造と実行コスト
650億のDenseモデルでは、総パラメータ数に加えてActive parameter、数値精度、GPU構成をそろえて大型MoEと実行コストを比較します。
利用する精度、GPU、量子化、バッチサイズ、コンテキスト長を固定して速度とメモリを測ると、自社環境でのコストを比較できます。
3. 実際に使えるコンテキスト長
モデル仕様は最大100万トークンです。
APIやローカルランタイムでは上限設定が異なるため、利用先の設定値と、必要メモリ・速度を確認します。長文能力を使いたい場合は、自社の長いコードやログで検索精度や情報保持も評価対象にします。
4. ベンチマークと自社タスクの一致
Terminal-Bench 2.1は、ターミナルで複雑な作業を進める能力を見る評価です。
自社の用途がコード修正、CI対応、ツール操作なら参考になります。用途が会議要約や日本語の顧客対応なら、別の評価軸が必要です。
5. ライセンス・チェックポイント・ランタイム対応
Apache 2.0、BF16、NVFP4、Baseモデルという選択肢があります。
商用利用の設計、推論スタック、量子化、更新手順まで含めて「どのチェックポイントを、どの環境で、どのバージョンとして固定するか」を決めます。
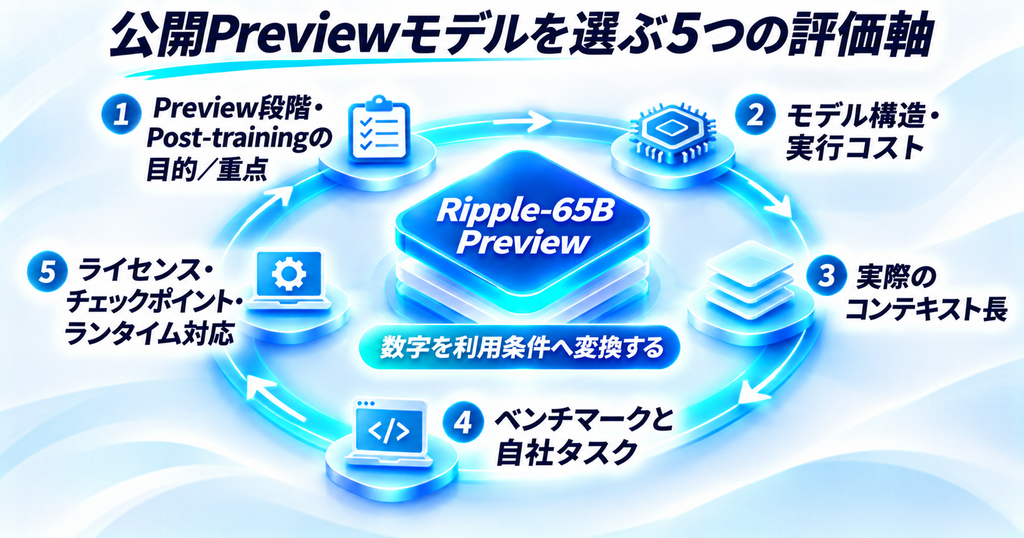
この5つを分けると、ベンチマークや1Mという数字を、実際の利用条件へ落とし込めます。
どんな用途で候補になりやすいか
Ripple-65B Previewは、特に次のような用途で検証候補になります。
- エージェント型コーディングを自前環境で試したい
- オープンウェイトを使い、モデルと推論環境を自社側で管理したい
- 650億規模のDenseモデルと大型MoEモデルを実環境で比較したい
- 長いコードベースやログを扱うワークフローを検証したい
- BF16とNVFP4で精度・速度・メモリの違いを測りたい
日本語利用では、独自評価を用意する価値があります。モデルカードで示されている事前学習データは「主に英語とコード」です。自社の日本語タスクでは、その用途に合わせて品質を測ります。
コード用途では、実際のツール、権限、テスト、コンテキスト長をそろえ、自社リポジトリ上の成功率を測ることが最終的な採用判断につながります。
まとめ
Ripple-65B Previewは、650億パラメータのDense Transformerを12兆トークンで事前学習し、モデル仕様で最大100万トークンのコンテキスト長をサポートするオープンウェイトモデルです。Apache 2.0でBF16、実験的なNVFP4、Baseモデルが公開されています。
RicursiveはTerminal-Bench 2.1で80.52を報告しており、エージェント型コーディングをPreview段階の重点に置いています。
実際に選ぶときは、Preview段階、モデル構造と実行コスト、実際に使えるコンテキスト長、ベンチマークと自社タスクの一致、ライセンス・チェックポイント・ランタイム対応の5軸で見ると、数字を利用条件へ変換できます。
公開ウェイトモデルでは、モデルの性能と同じくらい「自分の環境でどう動かすか」を決められることが価値になります。Ripple-65B Previewは、その自由度と運用条件を一緒に評価する題材として注目できるモデルです。