当サイトではアフィリエイト広告を利用しています。
CSVや顧客データのような表形式データを予測するときは、XGBoostなどを使ってデータごとにモデルを学習し、ハイパーパラメータを調整する流れが一般的です。
NVIDIAが公開したKumo Tabularは、従来とは異なる方法で表形式データを予測するTabular Foundation Modelです。すでにラベルが付いた行を「例」として渡し、その場で新しい行を分類・回帰します。タスクごとの追加学習、勾配更新、ハイパーパラメータ探索を行わずに予測できるのが大きな特徴です。
一方で、どんな表でも自動的に正解を出せる万能モデルではありません。単一テーブルが対象で、学習時の分布から大きく外れるデータでは精度低下があり得ます。実務では従来の機械学習と同じく、手元の検証データで精度を確認する必要があります。
この記事では、2026年10月7日時点のKumo Tabularについて、従来の機械学習との違い、仕組み、Small・Medium・Largeの違い、必要GPU、CPUやMacでの実行、入力制約、商用利用まで確認します。
Kumo Tabularの要点を先に確認
| 項目 | 内容 |
|---|---|
| 主な用途 | 表形式データの分類・回帰 |
| 予測方法 | ラベル付きのContext行を例として、Query行をin-context learningで予測 |
| タスクごとの学習 | 不要 |
| モデルサイズ | Small 約28M、Medium 約62M、Large 約215Mパラメータ |
| 学習データ | 構造因果モデルから生成した合成テーブルのみ |
| 主な入力 | 数値・カテゴリ・欠損を含む単一テーブル |
| 複数テーブル | Kumo Tabularでは非対応。関連テーブルはKumo Relationalの領域 |
| ローカル利用 | structured-data-modelsから学習済みweightsを利用可能 |
| CPU | 現行Model CardにCPUへフォールバックする実行例あり |
| NVIDIA NIM | Linux+NVIDIA GPU向け。Ampere、Hopper、Blackwellをサポート |
| weightsライセンス | OpenMDW-1.1 |
| ライブラリのコード | Apache 2.0 |
Kumo Tabularは、生成AIのように文章を作るモデルではありません。すでに答えが分かっている行と、新しく予測したい行を同じ表として渡し、分類ならクラス確率、回帰なら数値と予測分布を返します。
従来のXGBoost系ワークフローと何が違う?
従来の表形式機械学習では、新しい予測テーマごとに学習工程を作ります。
たとえば「顧客が解約するか」を予測する場合、過去データを学習用と検証用に分け、モデルを学習し、ハイパーパラメータを調整し、精度を確認してから新しい顧客へ適用します。別の予測タスクや別のデータセットへ適用する場合は、その条件に合わせて学習・調整をやり直すのが基本です。
Kumo Tabularは、ラベル付きの行をContextとしてモデルへ渡します。新しいQuery行は、そのContextを参照しながら1回のforward passで予測されます。
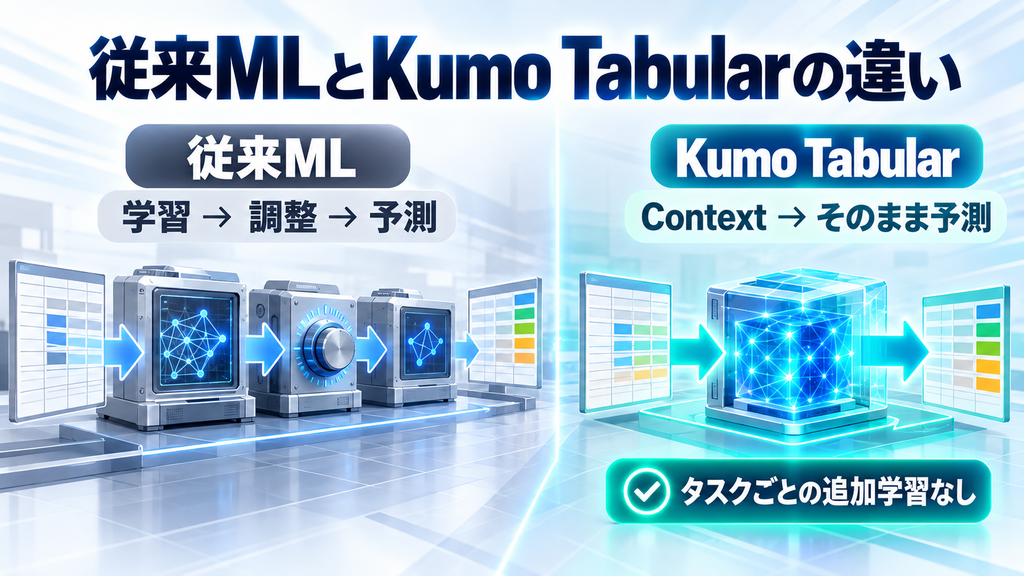
Kumo Tabularではタスクごとの学習工程がないため、新しい表データへ予測モデルを当て、従来手法と比較するところまでの工程を減らせます。
ただし、「機械学習の準備がすべて不要になる」という意味ではありません。列の意味を正しく扱うこと、学習例となるラベル付き行を用意すること、データ漏洩を防ぐこと、検証用データで精度を見ることは引き続き必要です。
ラベル付きContextから新しいQueryを予測する
Kumo Tabularでは、入力を大きく2つに分けます。
- Context:特徴量と正解ラベルが分かっている行
- Query:特徴量はあるが、正解を予測したい行
モデルは表のセルを読み取り、行方向・列方向の関係を処理したうえで、Contextにある答えを手掛かりにQueryを予測します。
分類では各クラスの確率を返します。回帰では単一の予測値だけでなく、999個のquantileを使って予測分布を表現できます。
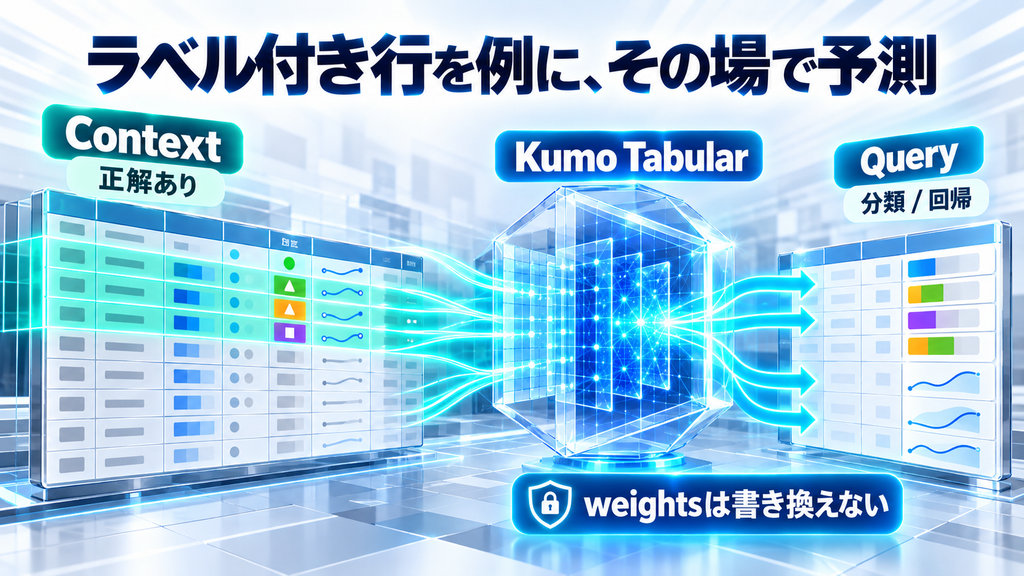
この仕組みはLLMのfew-shot promptingに近い面があります。モデル自体のweightsを書き換えるのではなく、その場で与えられた例から今回の予測ルールを読み取ります。
Kumo Tabularの事前学習には、実在企業の顧客データや医療データではなく、構造因果モデルから生成した合成テーブルが使われています。Smallは約3,500万、Mediumは約7,100万、Largeは約1億3,700万の合成テーブルを学習したとNVIDIAは説明しています。
Small・Medium・Largeは何が違う?
Kumo Tabularは3サイズあります。
| モデル | パラメータ数の目安 |
|---|---|
| Small | 約28M |
| Medium | 約62M |
| Large | 約215M |
公式ドキュメントではLargeが既定値です。ただし、モデルが大きいほど常に実務データで優れるとは限りません。計算資源を抑えたい場合はSmallも含め、同じ検証データで3サイズの精度・処理時間・メモリ消費を比較すると、必要なモデルサイズを判断できます。
必要VRAMの公式最低値はまだ示されていない
2026年10月7日時点で、Kumo Tabularについて「Smallは最低○GB、Largeは最低○GB」といった公式の固定VRAM要件は確認できませんでした。
メモリ使用量は、モデルサイズだけでなくContext行数、列数、Queryのbatch、estimator数、精度形式などで変わります。現在のstructured-data-modelsでも、自動batch sizingやメモリ最適化に関する更新が続いています。
GitHub Issueには、KumoTabular Small、Context 600行、estimator 1、FP16、Query batch 64を8GiBのRTX 3070で動かした利用例があります。ただし、これは特定条件でのユーザー事例です。8GBをKumo Tabular全体の最低要件とは扱えません。
CPUでも動かせるが、中心はGPU利用
NVIDIAのstructured-data-modelsはGPU-native libraryとして開発されています。CUDA環境ではcuDFの追加利用も推奨されています。
一方、現在のKumo Tabular Model Cardには、CUDAが利用できない場合にCPUを選ぶ実行例が掲載されています。そのため、ローカルで機能を試すこと自体はCPUでも可能です。
ただし、Kumo Tabularの強みである高速な表データ処理を活かすならGPUが中心です。NVIDIA NIMとしてコンテナ実行する公式ルートはLinuxとNVIDIA GPUを前提にしており、対応GPU世代はAmpere、Hopper、Blackwellです。
Apple SiliconのMPS対応はまだ開発途中
Apple Siliconについては、structured-data-modelsのGitHubで「Support Apple Silicon (MPS) devices」が未解決Issueとして残っています。
つまり、MacのCPUで試すことと、Apple SiliconのGPUをMPSで本格利用することは分けて考える必要があります。MacのUnified Memoryが大きいだけで、現行Kumo TabularをそのままGPU高速化できるとは限りません。
入力できるデータと制約
Kumo Tabularが得意なのは、数値やカテゴリを中心にした一般的な表形式データです。
たとえば次のような用途があります。
- 顧客が解約するかを分類する
- ローンのデフォルト有無を予測する
- 不正取引かどうかを分類する
- 需要量や価格を回帰予測する
- 処理時間や所要時間を予測する
欠損値を含むデータも想定されています。カテゴリ列は前処理で整列・数値化され、モデルへ渡されます。
一方、現行Kumo Tabularには明確な境界があります。
- 複数の関連テーブルをそのまま扱わない
- 複数ターゲットの同時予測には対応しない
- 自然言語の文章を意味理解するモデルではない
- 学習時に経験した範囲を大きく外れるデータでは精度が落ちる場合がある
複数テーブル間の関係を使いたい場合は、同じstructured-data-modelsにKumo Relationalが用意されています。
日本語のカテゴリ値は「言語理解」とは別
都道府県名、商品カテゴリ、部署名のような日本語文字列をカテゴリ値として扱う場合、その文字列はカテゴリの識別子として処理されます。
これは「日本語の文章の意味を理解して予測する」こととは別です。たとえば自由記述の問い合わせ本文をそのまま読ませて意味分類する用途なら、テキスト用モデルや埋め込みなど別の処理が必要です。
日本語データで使う場合も、実際のDataFrameからsemantic typeが意図どおり推定されるか、カテゴリの扱いが崩れていないか、検証データで精度が出るかを確認する必要があります。
公開ベンチマークの結果と自社データで確認すべきこと
NVIDIAはKumo Tabularについて、TabArenaでELO 1950を記録し、同一のRTX 6000 Pro評価環境でLimiX-2より17倍高速だったと報告しています。BeyondArena、TALENT、ScoringBenchでも高い結果を公開しています。
この数値はKumo Tabularの公開時にNVIDIA側が実施した評価です。
一方、TabArenaの2026年10月6日更新では、Kumo-Tabular、Medium、SmallがTabArenaとBeyondArenaのverified modelsへ追加されました。公開直後より、第三者側で比較できる材料は増えています。
それでも、公開ベンチマークの順位だけで自社データの採用を決めるべきではありません。表形式データは業務ごとに分布や欠損、カテゴリ数、ノイズが大きく違います。
Kumo Tabularを試すときは、同じtrain/validation分割でXGBoost、LightGBM、AutoGluonなど現在使っている手法と比較し、精度だけでなく推論時間や運用工程も含めて判断するのが現実的です。
OpenMDW-1.1で商用利用できる
Kumo TabularのweightsはOpenMDW-1.1で公開されています。NVIDIAのModel Cardでも、商用・非商用の両方で利用できると明記されています。
OpenMDW-1.1は、条件を守る限りModel Materialsの利用、変更、再配布を広く認めるライセンスです。Kumo Tabularを組み込んだ自社サービスや社内システムで利用することも、ライセンス上は禁止されていません。
再配布する場合は、OpenMDW-1.1のライセンス本文と対象となる著作権・出所表示を残す必要があります。
また、モデルから生成された予測結果について、OpenMDW-1.1自体は利用・変更・共有へ追加の制約を課していません。
ここはライブラリ本体と分ける必要があります。
- Kumo Tabularのweights:OpenMDW-1.1
- structured-data-modelsのコード:Apache 2.0
- NVIDIA NIMのコンテナ:NVIDIA側のNIMライセンス条件を別途確認
「オープンウェイトだから全部Apache 2.0」という扱いではありません。
ローカルではPython環境から試せる
Python 3.11以上、PyTorch 2.7以上の環境では、現在の公式案内に従ってstructured-data-modelsをGitHubから導入できます。
pip install git+https://github.com/NVIDIA/structured-data-models.git
その後、pandasなどの表データをTableTensorへ変換し、ContextとQueryに分けてKumoTabularへ渡します。学習済みweightsはHugging Faceから取得できます。
CUDA環境があるならGPU、なければCPUで動作を確認できます。最初はSmallを含めて自分のデータで精度と処理時間を測り、本番利用を考える段階で必要なContext量、メモリ消費、従来モデルとの差まで比較します。
Kumo Tabularが向くケース・従来MLを残したいケース
Kumo Tabularが候補になるのは、新しい表データへ短時間で比較基準となる予測結果を作りたい場面です。
向いているのは次のようなケースです。
- 分類・回帰をすぐ試したい
- データセットごとの学習工程を減らしたい
- 複数の表データへ同じ基盤モデルを使いたい
- ローカルや自社環境へweightsを置きたい
- 従来モデルと比較する新しい基準モデルが欲しい
次のような条件では、Kumo Tabularだけで決めず、従来手法や別モデルも同じ条件で比較します。
- 複数テーブルの関係が予測の中心
- 自由記述テキストや画像が主要特徴
- 学習時の分布から大きく外れる特殊データ
- 説明可能性や既存の特徴量設計が業務上重要
- すでに軽量なXGBoost等で十分な精度・速度が出ている
Kumo Tabularは、XGBoostなどを一律に置き換えるものではありません。「まず学習済み基盤モデルへContextを渡して予測する」という新しい入口が加わったと見る方が実用に近いです。
まとめ
NVIDIA Kumo Tabularは、ラベル付きの表データをContextとして渡し、タスクごとの追加学習なしで分類・回帰できるTabular Foundation Modelです。
採用を判断するときは、公開ベンチマークの順位だけでなく、自分のデータでXGBoostやAutoGluonなどと同じ条件で精度・処理時間・メモリ消費を比較する必要があります。CPUでも動作確認できますが、現在の中心はGPU利用で、Apple SiliconのMPS対応はまだ開発途中です。
Kumo Tabularは従来の表形式機械学習を一律に置き換えるものではありません。タスクごとの学習工程へ入る前に試せる予測手段が増えたことが、実務で見るときのポイントです。
公式情報・参照先
- NVIDIA Kumo Tabular Sets a New Accuracy-Efficiency Frontier for Tabular Prediction|NVIDIA
- Kumo Tabular Model Card|NVIDIA / Hugging Face
- Structured Data Models|NVIDIA GitHub
- KumoTabular API|Structured Data Models
- Structured Data Models – Model一覧
- Kumo Tabular Model Card|NVIDIA NIM
- Kumo Tabular NIM|NVIDIA
- OpenMDW-1.1 License
- TabArena Leaderboard
- Feature request: cohort-level explanations for local Kumo inference|GitHub Issue #1022
- Support Apple Silicon (MPS) devices|GitHub Issue #1031