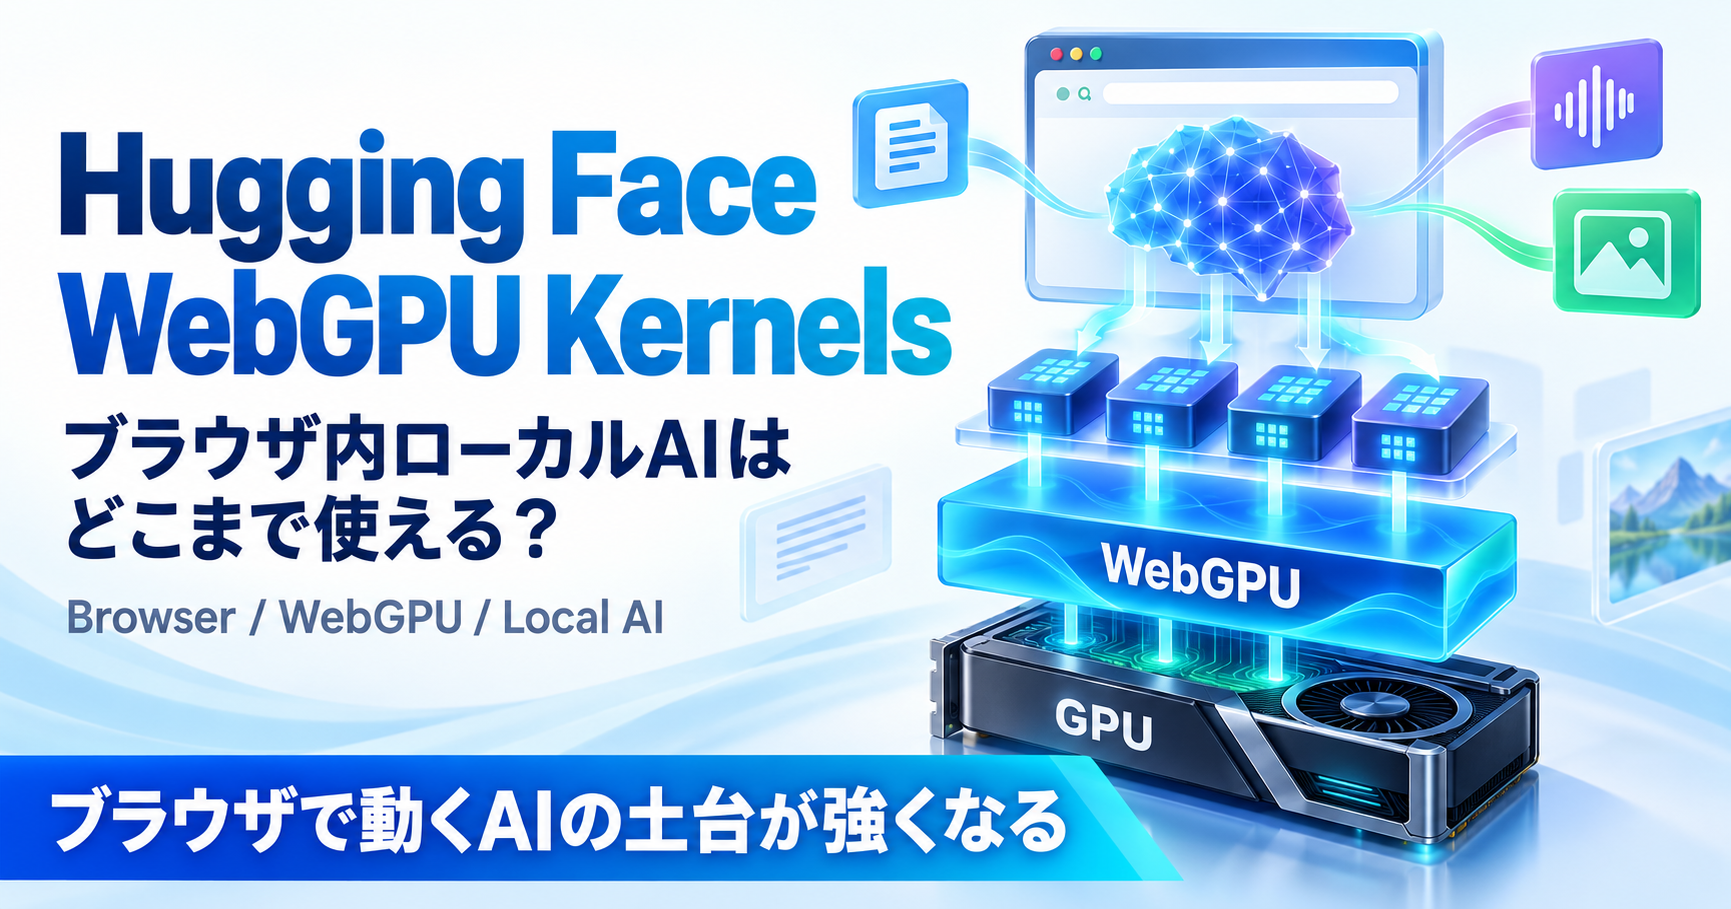
Hugging Faceは2026年9月1日、ブラウザ内AIの高速化に向けて@huggingface/kernelsと207個のWebGPUカーネルを公開しました。
WebGPUを使えば、ブラウザからPCのGPUを利用して機械学習の計算を実行できます。Hugging FaceのTransformers.jsでも、すでにテキスト埋め込み、音声認識、画像分類などをWebGPUで動かせます。
今回の発表で変わったのは、モデルそのものではありません。AIモデルの下で動く行列計算、正規化、AttentionなどのGPU演算を、個別に改善・検証できる土台が公開されたことです。
この記事では、207個のWebGPUカーネルで何が変わるのか、ベンチマークの「2.57倍」をどう読むべきか、Fleetの役割、Windows+NVIDIA環境を含むブラウザ内ローカルAIの現状を整理します。
Hugging Face WebGPU Kernelsとは?
今回公開された中心は、次の2つです。
@huggingface/kernels:Hugging Face Hub上のWebGPUカーネルをJavaScriptから読み込み、実行するためのライブラリ- 207個のWebGPUカーネル:機械学習で使うさまざまなGPU演算を個別パッケージとして公開したコレクション
AIモデルをGPUで動かすとき、内部では行列積、加算、正規化、Softmax、Attention、量子化処理など、多数の演算が順番に実行されます。
WebGPUはブラウザからこれらのGPU計算を扱うための共通APIですが、同じ演算でもGPU、ブラウザ、ドライバ、入力サイズ、データ型によって速い実装は変わります。
Hugging Faceは今回、その最下層に近い演算を独立したカーネルとして公開しました。
各カーネルには演算コードだけでなく、入出力仕様、正しさを確認するテスト、ベンチマークケース、WGSLのシェーダーテンプレートなどがまとめられています。
つまり、ブラウザ内AI全体を一括で改善するのではなく、遅い演算を特定し、カーネル単位で改善して差し替える方向へ進めやすくなりました。
207個のカーネルは何を高速化するのか
公開された207個は、特定の1モデル専用ではありません。
機械学習で広く使われる演算が含まれており、Hugging Faceは例として次のような処理を挙げています。
- 行列積
- 正規化
- 畳み込み
- Attention関連演算
- 量子化処理
- データレイアウト変換
Hub上では各カーネルの仕様や対応データ型、利用例を個別に確認できます。
この形の利点は、上位の推論ライブラリから見たインターフェースを維持しながら、GPUや入力条件に合う実装を選びやすくなることです。
同じ「加算」でも、同じ形状同士の加算とブロードキャストを伴う加算では最適な処理が違います。Hugging Faceの公開カーネルでは、1つの演算に複数の実装候補を持たせ、条件に応じて適した経路を選べる設計になっています。
「2.57倍」はモデル全体が2.57倍速いという意味ではない
Hugging FaceはApple M4 GPU上で、今回のWebGPUカーネルとONNX Runtime WebのWebGPU実装を比較しています。
最初に1,756ケースを測定し、両方で出力が一致して安定した計測ができた809ケースを比較対象にした結果は、次の通りでした。
- 幾何平均:2.57倍
- 中央値:1.90倍
- Hugging Face側が高速:629ケース
- ONNX Runtime Web側が高速:176ケース
- 同等:4ケース
一部では非常に大きな差が出た演算もあります。ただし、この数字を「ブラウザで動かすLLMが2.57倍速くなる」と置き換えることはできません。
このベンチマークは個別のGPU演算を比較した結果です。さらに計測対象はGPU上での処理時間で、カーネルの読み込み、入力データの転送、シェーダーのコンパイル、結果の読み戻しなどは含まれていません。
Hugging Face自身も、実際の性能はGPUやブラウザによって変わり、完全なモデルの速度比較ではないと説明しています。
今回の2.57倍という数字は、ブラウザ内AIの低レイヤーにまだ大きな最適化余地があることを示す材料として見るのが適切です。
FleetはGPU・ブラウザごとの実測を集める
WebGPUでは、1台のPCで速かった実装が別のPCでも最適とは限りません。
GPUだけでなく、ブラウザ、ドライバ、利用できるWebGPU機能でも結果が変わるためです。
そこで同時に公開されたのがFleetです。Fleetはブラウザ上でカーネルの正しさと性能を測定する仕組みで、自分の環境でテストを実行できます。
利用者が同意した場合は、その実行結果がHugging Face側の検証材料にもなり、特定の環境で結果が間違う、極端に遅くなるといった問題の発見や、カーネルの改善、実装候補の選択ルールに使われます。
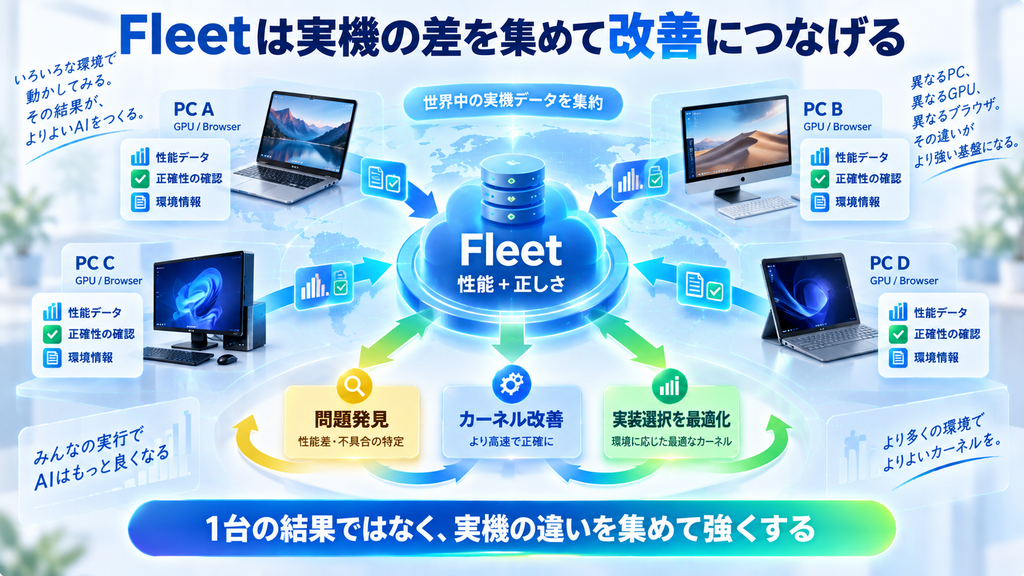
従来の限られた検証用PCだけではなく、実際に使われている多様なGPUとブラウザから結果を集めることで、WebGPU特有の環境差へ対応しようとしているわけです。
ブラウザ内ローカルAIはすでに一部の用途で使える
WebGPUを使ったブラウザ内AI自体は、今回初めて登場したものではありません。
Hugging FaceのTransformers.jsでは、モデル読み込み時にdevice: "webgpu"を指定してGPUを利用できます。公式ドキュメントでは、次の例が公開されています。
- テキスト埋め込みの生成
- Whisperによる音声認識
- 画像分類
これらはサーバーへ推論処理を依頼するのではなく、対応ブラウザ上で端末側のGPUを使って実行できます。
ブラウザ内ローカルAIが向いているのは、例えば次のような用途です。
- テキスト分類や埋め込み生成
- 軽量な音声処理
- 画像分類
- 入力データを外部の推論APIへ送りたくない処理
- インストール作業を減らした社内・個人向けWebツール
一方、大規模モデルの長時間推論や、大きなコンテキストを使う高度な処理では、GPUメモリ、ブラウザの制約、モデルサイズなどが効いてきます。
そのため、現時点のブラウザ内AIを「クラウドAIの完全な代替」と見るより、ローカルで処理できる用途をWebアプリ側へ広げる仕組みとして捉える方が実態に合っています。
WebGPUは対応ブラウザなら同じ性能になるわけではない
WebGPUはWebGLの後継として、描画だけでなく汎用GPU計算を扱えるAPIです。
ただし、2026年9月時点でもMDNはWebGPUを「Limited availability」としており、すべての主要ブラウザ・環境で同じ条件がそろっているわけではありません。
対応している場合でも、利用できる追加機能はGPUやブラウザによって変わります。
実際にブラウザ内ローカルAIを使うときは、単に「WebGPU対応」と書かれているかだけでなく、
- 使用ブラウザでWebGPUが有効か
- GPUが必要な機能へ対応しているか
- ドライバが新しいか
- 対象モデルがその環境で動くか
- 実際の速度とメモリ使用量が許容範囲か
まで実機で確認する必要があります。
Fleetが用意された背景にも、この環境差があります。
Windows+NVIDIA GPUではどう見る?
Windows+NVIDIA GPUのPCでも、対応するChromium系ブラウザなどからWebGPUを利用できます。
ただ、今回Hugging Faceが公開した代表ベンチマークはApple M4 GPUで行われています。2.57倍という数値をGeForce環境へそのまま当てはめることはできません。
Windows+NVIDIA環境で注目したいのは、特定の速度倍率より次の変化です。
ブラウザからGPUを使うAIアプリを配布しやすくなる
CUDAやPython環境を個別に構築しなくても、Webアプリとして提供できる用途が増えます。
利用者側のセットアップを減らせるため、軽量な社内ツールや個人向けAI機能では利点があります。
GPUごとの最適化を共有しやすくなる
カーネルをHub上の独立パッケージとして管理することで、特定GPUや入力条件に向いた実装を追加しやすくなります。
Fleetによる実機データが増えれば、NVIDIAを含む幅広いGPUでどの実装が合うのかも検証しやすくなります。
CUDAの代わりになるわけではない
WebGPUはブラウザから利用できる共通APIであり、NVIDIA専用のCUDAと目的が同じではありません。
最高性能を追うローカル推論では、CUDA対応の専用ランタイムが有利な場面は残ります。WebGPUの強みは、ブラウザから扱えることと、GPUベンダーをまたいだ共通基盤を目指せる点です。
まだ「207カーネルだけでモデル推論が完成」する段階ではない
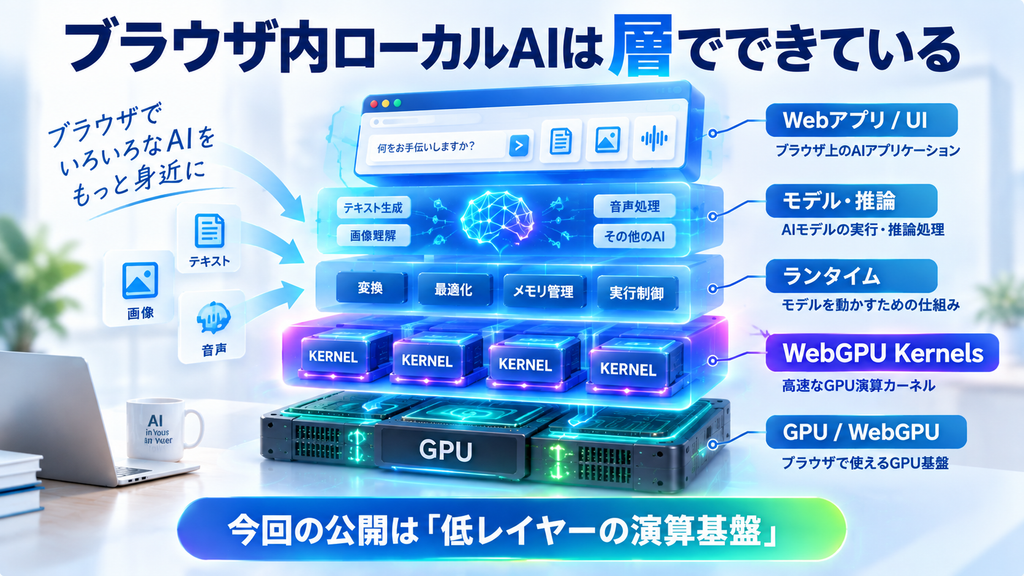
今回の公開は、Hugging Face自身がブラウザ推論スタックの低レイヤー基盤と位置づけています。
モデルを実際に使うには、カーネル以外にも、
- モデル形式
- 量子化
- 推論ランタイム
- メモリ管理
- 実行計画
- モデル読み込み
- アプリ側のUI
など複数の層が必要です。
Hugging Faceは、今後このWebGPUカーネルをより高レベルのモデルツールへ接続していく方針を示しています。
つまり、今回の207カーネルは完成品のAIアプリではなく、今後のブラウザ内推論を高速化するための共有部品です。
この点は、公開直後の速度だけを見るより長期的に重要です。個別のモデルやアプリが変わっても、下の演算基盤を共通で改善できるからです。
クラウドAIとブラウザ内ローカルAIは使い分けが続く
WebGPUが進化しても、すべてのAI処理をブラウザへ移す必要はありません。
ブラウザ内ローカルAIは、次のような条件と相性があります。
- 比較的小さなモデルで処理できる
- 端末側でデータを処理したい
- API利用料を増やしたくない
- オフラインまたは不安定な回線でも使いたい
- Webアプリとして配布したい
一方、巨大モデル、高度な推論、大量処理、複数エージェントの長時間実行などでは、クラウド側の計算資源を使う方が現実的なケースが多くなります。
今後は「クラウドかローカルか」の二択ではなく、軽い処理はブラウザ内、重い処理はクラウドという役割分担が増えていきそうです。
まとめ
Hugging Faceが公開した@huggingface/kernelsと207個のWebGPUカーネルは、ブラウザ内ローカルAIの低レイヤーを強化する取り組みです。
Apple M4 GPUでの比較ではONNX Runtime Webより幾何平均2.57倍という結果が出ていますが、これは個別GPU演算の比較であり、モデル全体が2.57倍高速化するという意味ではありません。
同時に始まったFleetでは、実際のGPU・ブラウザで性能と正しさを測り、環境ごとの差を今後の改善へ使えるようにしています。
ブラウザ内AIでは、すでにTransformers.jsを通じてテキスト埋め込み、音声認識、画像分類などをWebGPUで実行できます。今回のカーネル公開によって、その下にある共通の演算基盤も改善しやすくなりました。
今後見るべきなのは、単発のベンチマーク値より、この207カーネルが高レベルの推論ライブラリへどう組み込まれ、Windows+NVIDIAを含む幅広い実機でどこまで安定して速くなるかです。