ローカルAI

AIサービス・ツール

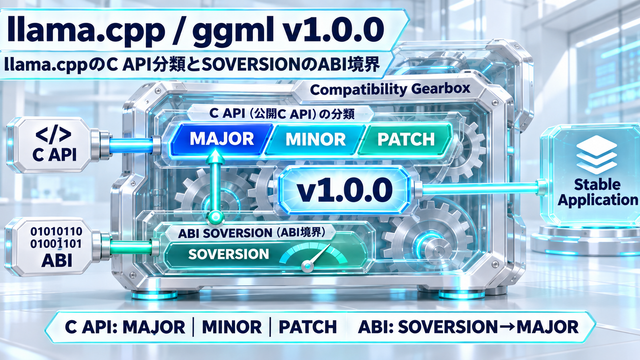
llama.cpp・ggml v1.0.0とは?API・ABI互換性とセマンティックバージョニングで更新を管理する

llama.cppとggmlのv1.0.0を深掘り。llama.cppの公開C APIでは、破壊的変更をMAJOR、後方互換の機能追加・モデル対応をMINOR、API変更なしの修正をPATCHとするルールを採用。ABIはSOVERSIONのMAJOR連動として分けて捉え、ggmlは内蔵版とsystem版の依存管理まで整理します。
AIサービス・ツール
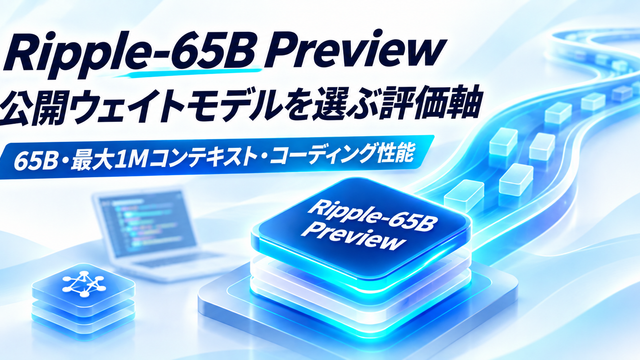
Ripple-65B Previewとは?65B・最大100万トークン・コーディング性能をどう評価するか

Ripple-65B Previewを深掘り。65BのDense構造、12兆トークン事前学習、最大100万トークン対応、Apache 2.0、Terminal-Bench 2.1の80.52を、公開Previewモデルを選ぶ5つの評価軸から解説します。
AIサービス・ツール

NVIDIA Kumo Tabularとは?表形式データを追加学習なしで予測する仕組み・必要GPU・商用利用を解説

NVIDIA Kumo Tabularを解説。表形式データをタスクごとの追加学習なしで分類・回帰する仕組み、XGBoost系との違い、Small・Medium・Large、必要GPU・CPU・Mac対応、入力制約、ベンチマーク、商用利用条件を整理します。
AI・IT

今日のAIニュース5選|DGX Spark 64GB、ChatGPT Finances、AstaBrief 8B【2026年10月4日】

今日のAIニュース5選AIの進化が、巨大なモデルを競うだけではなく、用途ごとに専用の道具へ細かく分かれる方向へ進んでいます。NVIDIAは、ローカルAI向けの「DGX Spark」に64GBのユニファイドメモリ構成を追加しました。ChatG...
AIサービス・ツール

CLM-8BとJevとは?AIエージェントの判断を高速化するSystem Oneモデルを比較

CLM-8BとTypeSafe Jevを比較。生成LLMと異なるSystem Oneモデルの仕組み、Choice・Score・Noul、速度評価、料金、ローカル実行、ライセンス、日本語対応、AIエージェントでの使い分けを解説します。
AI・IT

新Mac mini / Mac StudioはローカルAIに向く?M4・旧Mac Studioとの違いとメモリ別の選び方

M6 / M5 Pro Mac miniとM5 Max / M5 Ultra Mac StudioをローカルAI目線で比較。旧世代との価格・性能差、最大32GB〜512GBのユニファイドメモリ、帯域幅、クラウドAIとの使い分けをまとめます。
AIサービス・ツール

Perplexity Portable Computerとは?ローカルAIエージェントの仕組み・必要GPU・Windows対応

Perplexity Portable Computerを解説。モデル・計画・ツール実行をPC内で動かすローカルAIエージェントの仕組み、クラウドへ送る条件、対応GPU、24GB VRAM要件、DGX Spark、Windows対応状況を2026年9月時点の公式情報からまとめます。
AI・IT

Microsoft Project Zenithとは?64GB・250GB/sで見るローカルAI開発PCの新基準

Microsoft Project Zenithは、64GB以上のユニファイドメモリと250GB/s以上の帯域を基準にした開発者向けWindows体験です。30B超モデルのローカル実行、既存PCとの差、Ryzen AI Halo、クラウドAIとの使い分けを解説します。
AIサービス・ツール

Hugging Face WebGPU Kernelsとは?ブラウザ内ローカルAIはどこまで使える?

Hugging Faceが公開した207個のWebGPUカーネルとFleetを解説。ベンチマーク2.57倍の意味、ブラウザ内ローカルAIの用途、Windows+NVIDIA環境で見るポイント、高レベル推論基盤との関係を整理します。
AI・IT

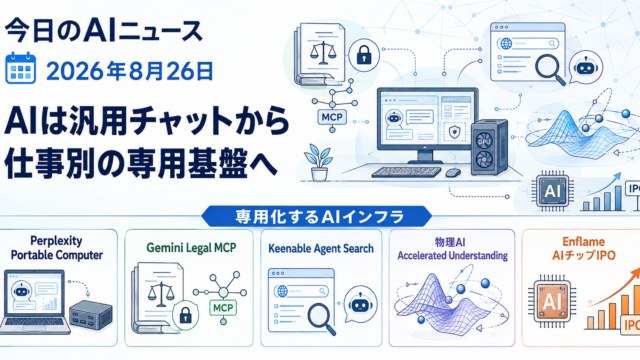
今日のAIニュース5選|Perplexity Portable Computer、Gemini Enterprise for Legal、Keenable【2026年8月26日】

今日のAIニュース5選AIが広がるほど、「一つの強いモデルを何にでも使う」だけでは足りない場面が増えています。法務では、社内ルールや権限を引き継ぎながら契約書や訴訟資料を扱う専用環境が必要です。ローカルAIでは、機密ファイルを外へ出さず、長...