当サイトではアフィリエイト広告を利用しています。
2026年11月13日、llama.cppとggmlにそれぞれv1.0.0のタグが作成されました。
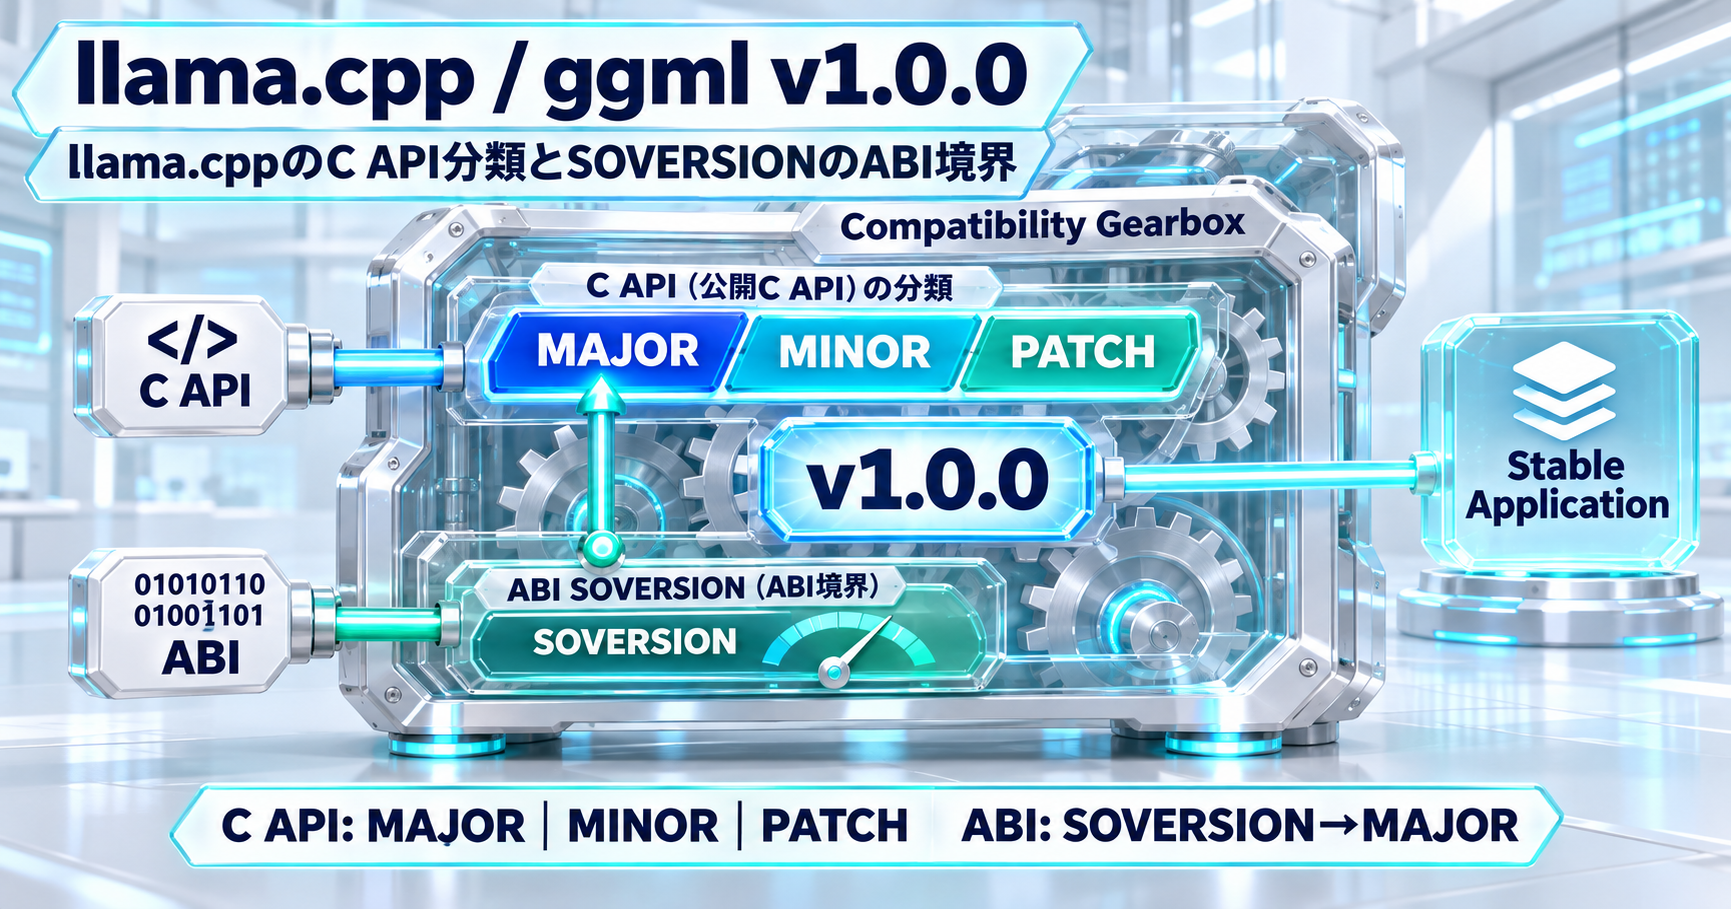
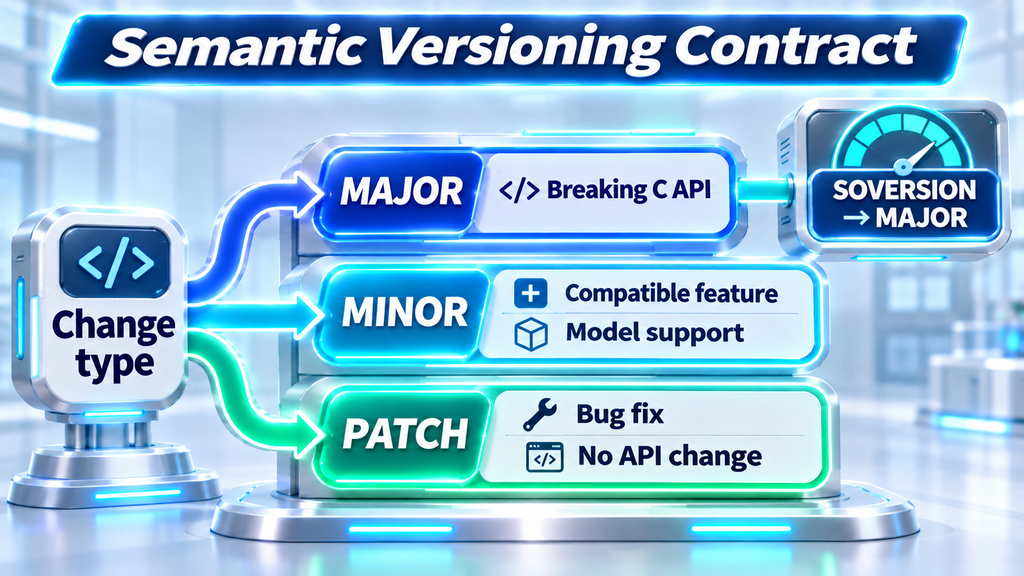
今回の節目で実務上大きいのは、ローカルAI基盤の更新をMAJOR/MINOR/PATCHのバージョン番号から読み取る基準が明確になったことです。llama.cppでは、公開C APIの破壊的変更をMAJOR、後方互換の機能追加・モデル対応・API追加をMINOR、API変更を伴わないバグ修正をPATCHとして扱う方針が明文化されています。
v1.0.0では実際に非推奨APIの削除が行われました。アプリや社内ツールへllama.cpp/ggmlを組み込む側では、モデル対応、API・ABI、依存ライブラリの更新境界を分けて管理する運用が重要になります。
v1.0.0は互換性の境界をバージョン番号へ結び付けた
llama.cppのv1.0.0準備スレッドでは、主要メンテナーがllama.cppとggmlの両方をメジャー更新し、非推奨APIや古い機能を整理する方針を示していました。
背景にあるのは、利用するアプリやパッケージが増えたことで、破壊的変更の影響範囲も大きくなったことです。メンテナーは、v0系ではAPIの破壊的変更が入ってもメジャーバージョンを上げないことがあった一方、v1以降はAPI/ABIの非互換をバージョンへ正しく反映すると説明しています。
実際のv1.0.0タグでは、llama.cppとggmlのCMake設定がどちらも1.0.0になっています。バージョン番号は、下流アプリが更新判断へ使う互換性の指標として機能します。
MAJOR・MINOR・PATCHで更新時に確認する範囲が変わる
llama.cppのリリース文書では、セマンティックバージョニングの境界を次のように定義しています。
| バージョン | 変更の基準 | 下流側で最初に確認すること |
|---|---|---|
| MAJOR | 公開C API(include/llama.h)の破壊的変更 | ソース修正、再ビルド、リンク、回帰テスト |
| MINOR | 後方互換の機能追加、モデル対応、API追加 | 新機能・モデル対応の必要性、既存処理の回帰テスト |
| PATCH | API変更を伴わないバグ修正 | 修正対象と既存ワークロードの回帰テスト |
この区分で特に重要なのが、新しいモデル対応はMINORへ入ることです。
ローカルAIでは、新モデルを使うために最新版へ追随したい場面が多くあります。v1以降は、モデル対応を取り込みたい更新と、アプリ側の修正が必要な破壊的更新をバージョン番号で区別できます。
PATCHはAPI変更を伴わない修正です。APIを直接組み込む側では、まずバージョン番号から変更の種類を絞り、そのうえで実際のリリース差分とテスト結果を確認できます。
APIとABIは別の互換性として管理する
APIは、ソースコードから呼び出す関数、型、引数などの契約です。llama.cppではinclude/llama.hが公開C APIの中心として明示されています。
ABIは、コンパイル済みバイナリ同士が関数シンボル、型のレイアウト、呼び出し規約などを通じて接続するための契約です。ソースコードが同じでも、共有ライブラリ側のABIが変われば、既存バイナリの再ビルドや再リンクが必要になります。
llama.cpp v1.0.0ではlibllamaのSOVERSIONがMAJORバージョンに連動します。ggml側の共有ライブラリもSOVERSIONをGGML_VERSION_MAJORへ連動させています。v1.0.0ではどちらもMAJORが1です。
この構成では、MAJOR更新をAPI/ABIの互換性境界として扱えます。ソースから直接組み込むアプリは公開ヘッダーとのコンパイルを確認し、共有ライブラリを配布する構成ではロード・リンク・実行まで確認する必要があります。
v1.0.0では実際に非推奨APIを削除した
v1.0.0では、準備用のPRでメジャー更新のタイミングに合わせて非推奨APIを整理しています。
llama.cpp側のllama : pruneでは、主に次の変更が行われました。
llama_set_warmupの削除llama.hでDEPRECATED指定されていた35個の関数を削除- 非推奨だった
llama_context_params::defrag_tholdを削除 - 非推奨だった
--defrag-tholdオプションを削除 - NextN/speculative関連APIの一部を
llama-ext.hから公開ヘッダーllama.hへ移動
ggml : pruneは、llama.cppリポジトリ内の内蔵ggml側をv1.0.0へ向けて整理したPRです。ここでは、GGML_OP_ADD1やggml_mul_mat_set_prec、ggml_rope_custom、ggml_upscale_ext、ggml_flash_attn_ext_set_precなどの非推奨要素が削除されています。ここで列挙しているのは、llama.cppリポジトリ内の内蔵ggml側の変更です。
この変更は、MAJOR更新が「下流側で移行作業を行うタイミング」であることを具体的に示しています。v0系で非推奨警告へ対応していたアプリほど、v1への移行箇所を小さくできます。
安定リリースのvX.Y.ZとnightlyのbNNNNは役割が違う
llama.cppには、セマンティックバージョンのリリースとnightly/development buildの2つの流れがあります。
| 種類 | 形式 | 主な用途 |
|---|---|---|
| 安定リリース | vX.Y.Z | アプリ組み込み、パッケージ配布、依存バージョン固定 |
| nightly | bNNNN | 最新変更の検証、新機能・修正の早期確認 |
| 開発ビルド | X.Y.Z-dev | masterなど開発状態からのビルド |
llama.cppのリリース文書では、安定リリースは手動ワークフローでannotated git tagとして作成されます。リリースの正本はタグで、GitHub Release objectは作成しない運用です。
利用経路としては、llama-install.sh、パッケージマネージャー、リリースタグからのソースビルドが案内されています。
ソースからリリース版をビルドする場合、LLAMA_BUILD_IS_DEVは既定でONです。クリーンな1.0.0というバージョン文字列にするには、リリースタグ上で-DLLAMA_BUILD_IS_DEV=OFFを指定する運用が示されています。
本番環境ではvX.Y.Zを固定し、nightlyは別の検証レーンで追う構成にすると、安定運用と最新モデル対応の確認を分けられます。
llama.cppに内蔵されたggmlとsystem ggmlは依存管理が異なる
llama.cppはggmlのコードを内部に持ち、既定ではその内蔵版を使います。v1.0.0のCMakeでもLLAMA_USE_SYSTEM_GGMLの既定値はOFFです。
一方、LLAMA_USE_SYSTEM_GGML=ONにすると、システムへインストールされたggmlを別ライブラリとして利用できます。
ggml-orgのversioning discussionでは、llama.cpp内部のggmlコピーは、公式にリリースされたggmlと差が出る場合があると説明されています。このため、依存管理は次の2つに分かれます。
| 構成 | バージョン管理の単位 | 更新時の確認 |
|---|---|---|
| 内蔵ggmlを使う | llama.cppのタグを一つの単位として固定 | ビルド、モデル読み込み、推論、利用バックエンド |
| system ggmlを使う | llama.cppとggmlを別依存として管理 | ヘッダー、リンク、共有ライブラリ、推論まで組み合わせ確認 |
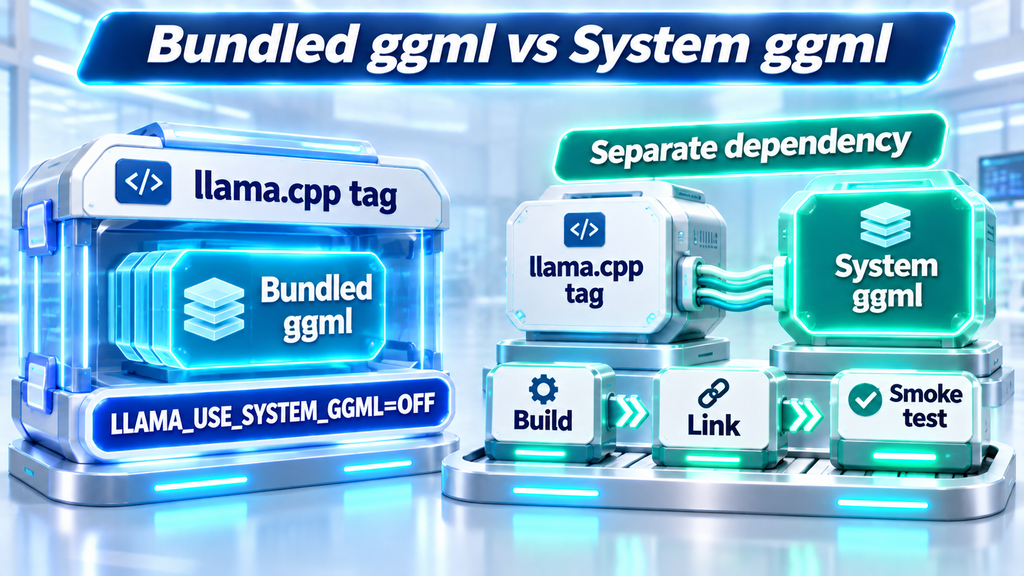
パッケージ配布や社内共通ライブラリでsystem ggmlを使う場合は、llama.cppとggmlのバージョン、ビルド結果、リンク結果を同じ変更単位で確認します。
公開C API・CLI・モデル対応を別のテストへ分ける
llama.cppのリリース文書がMAJOR判定の基準として明示しているのは、include/llama.hの公開C APIです。
一方、v1.0.0の整理では--defrag-tholdのようなCLIオプションも削除されています。CLIやserverをスクリプトから呼び出している環境では、C APIのコンパイル確認とは別にコマンドラインやHTTP経路の回帰テストも必要です。
モデル対応はMINORで追加されます。モデルを読み込めること、利用する量子化形式、CPU/CUDA/Metal/Vulkanなどのバックエンドで期待する速度と結果が出ることは、API互換性とは別の確認項目です。
運用上は、次の3層に分けることで更新時の確認対象を明確にできます。
- API/ABI層:コンパイル、リンク、共有ライブラリ
- 実行インターフェース層:CLI、server、起動オプション
- モデル・バックエンド層:モデル読み込み、量子化、推論結果、性能
SemVerは1層目の更新リスクを早く判定する信号になり、2層目と3層目は自分の利用経路に合わせたテストで確認します。
ローカルAI基盤を更新するときの6つの手順
llama.cpp/ggmlを継続運用する場合、更新工程は次のように組めます。
本番はvX.Y.Zを固定する
安定タグを本番の依存基準にし、nightlyは検証用として分離します。MAJOR更新は移行ブランチで先にコンパイルする
削除・変更された公開APIをコンパイルエラーから特定し、呼び出し箇所を更新します。共有ライブラリを再ビルド・再リンクする
ABI境界が変わるMAJOR更新では、アプリ本体と配布ライブラリを同じ組み合わせで作り直します。CLI/serverの起動経路を回帰テストする
自動起動スクリプト、オプション、APIゲートウェイなど実際の運用経路を確認します。代表モデルとバックエンドでスモークテストする
モデル読み込み、短い生成、メモリ使用量、主要バックエンドを確認します。nightlyは次回更新の先行検証に使う
必要な新モデル対応や修正を早めに試し、安定タグへ入った段階で本番更新へ進めます。
この運用では、「新モデルを早く使いたい」という要求と「アプリの互換性を維持したい」という要求を別の更新レーンで管理できます。
まとめ
llama.cppとggmlのv1.0.0は、ローカルAI基盤を長期運用するうえで、バージョン番号を互換性判断へ使う基準を明確にしたリリースです。
llama.cppでは、公開C APIの破壊的変更をMAJOR、後方互換の機能追加・モデル対応・API追加をMINOR、API変更を伴わない修正をPATCHとして扱います。共有ライブラリのSOVERSIONもMAJORへ連動し、APIとABIの更新境界を運用へ反映できます。
v1.0.0では実際に非推奨APIが削除され、メジャー更新が下流アプリの移行タイミングとして機能しました。安定タグとnightlyを分け、内蔵ggmlとsystem ggmlの依存関係を区別し、API/ABI、CLI、モデル・バックエンドを別々にテストすることで、ローカルAI基盤の更新リスクを管理できます。