当サイトではアフィリエイト広告を利用しています。
Anthropicは2026年11月13日、AIの安全性評価を設計・実行・報告するための実務ガイド「Building strong safety evaluations」を公開しました。
安全性評価の結果は「適切応答率98%」のような一つの数字で示されることがあります。その数字の信頼性は、何を測ったか、どのシナリオを使ったか、誰が採点したか、何件試したか、どの程度の不確実性があるかで変わります。
Anthropicが今回まとめた中心は、安全性評価を再現可能な測定として設計することです。測定対象の定義、AIグレーダーと人間専門家の照合、事前登録、十分なサンプル数、信頼区間、設定差の記録を一続きの評価工程として扱います。
Anthropicは安全性評価を「測定」として設計する
Anthropicは安全性評価を、特定の入力に対してモデルが適切に行動したかを測る評価として説明しています。
能力評価が「タスクを成功できたか」を見るのに対し、安全性評価では、モデルの応答が危害につながる可能性、危害を増減させるか、危害の深刻さなどを扱います。
評価はDesign、Run、Reportの3工程で進め、Safetyは全工程を横断する条件として組み込みます。
| 区分 | 確認すること |
|---|---|
| Design | 何を測るか、どの設計で答えるか、現実へ一般化できるか |
| Run | 難易度、汚染、グレーダー、事前登録、サンプル数 |
| Report | 信頼区間、カテゴリ別結果、実行設定、再現条件 |
| Safety(横断条件) | 専門家体制、隔離環境、監視、責任ある開示 |
評価の問いから報告方法までを一つの測定系として設計することが、このガイドの中心です。
最初に「何を測るか」を定義する
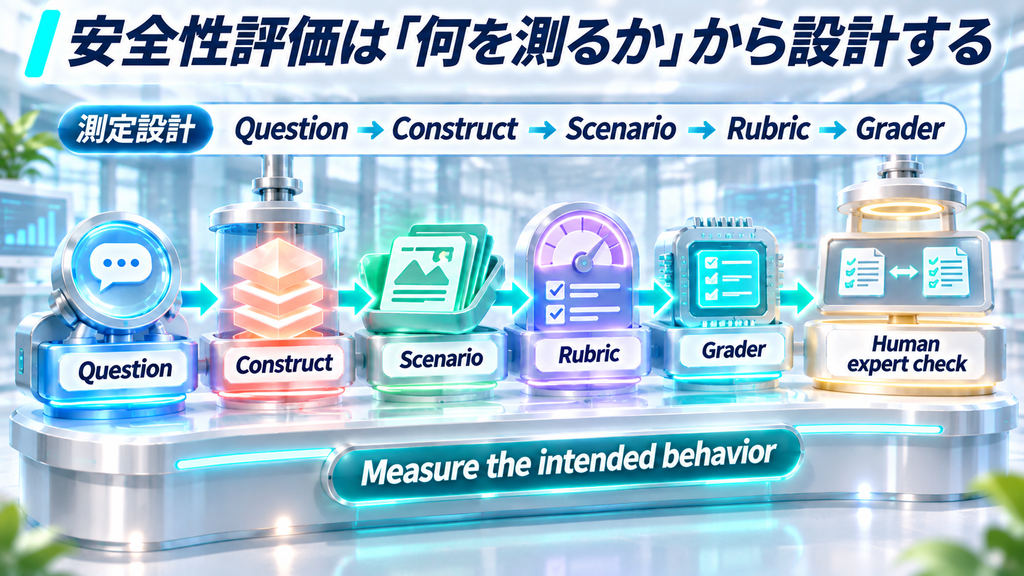
評価設計の最初の論点が、測定したい概念を明確にすることです。統計や測定論では、実際に測りたい概念を指して「構成概念(construct)」と呼びます。
安全性評価では「拒否率」を指標にすると分かりやすい場面があります。フィッシングや詐欺の具体的手順を求める依頼なら、危険な支援を拒否できるかは重要です。
同じ指標を自傷・自殺に関する会話へそのまま使うと、測りたい安全性とずれる場合があります。危機にある利用者へ一律に応答を拒否するモデルは、拒否率だけなら高得点になっても、適切な支援につなげるという目的を満たしません。
Anthropicはマルチターン安全性評価で、リスク領域ごとのルーブリックに基づく「appropriate response rate」を使っています。何が適切かは、自傷、詐欺、サイバー、バイオなど領域ごとに定義します。
観察と因果では評価設計が変わる
評価で答えたい問いによって、設計も変わります。
「モデルAとモデルBで安全性スコアが違うか」は観察的な比較です。結果の差は分かりますが、何が差を生んだかまでは特定できません。
「システムプロンプトの変更で安全性が改善したか」のような因果関係を確認する場合は、比較する条件以外をそろえ、変更する変数を一つに絞る必要があります。
たとえばモデル、プロンプト、推論設定、グレーダーを同時に変えてスコアが上がっても、その変化を一つの要因へ帰属できません。
この区別を最初に決めると、評価後に言える結論の範囲も決まります。
マルチターン評価では現実に近いシナリオを作る
実利用の安全上の問題には、複数ターンの文脈で現れるものがあります。
Anthropicは、ユーザーが会話の途中で目的を少しずつ明かしたり、モデルが拒否したあとに別の言い方で再度要求したりする状況をマルチターン評価へ入れています。
マルチターン評価では、専門家がシナリオ仕様を作り、別のモデルが模擬ユーザーとしてテスト対象モデルの返答へ反応しながら会話を進め、最後にグレーダーが会話全体を採点します。
シナリオを作る際は、深刻度、口調、人物像、状況など複数の条件を独立して組み合わせます。特定の深刻度が特定の口調と常にセットになっていると、どの条件が結果へ影響したかを切り分けにくくなるためです。
Anthropicは、単発の安全性評価では最近のモデルがAPI上で94〜98%に集中しており、既知の失敗を確認する回帰テストとしての意味が大きくなっていると説明しています。差を測るには、長い会話、自然な表現、現実の利用パターンなどを取り入れて評価の解像度を上げます。
AIグレーダーは人間専門家と照合してから使う
大量の評価データを人間だけで採点するのは難しいため、現在のAI評価では別のモデルをグレーダーとして使う方法が広く使われています。
Anthropicは、AIグレーダーを使う場合に次の点を重視しています。
- 正解が明確な項目は実行テストや完全一致などの決定的な採点を優先する
- 解釈が必要な項目は基準を狭く具体的にする
- 一つの総合点より、原子的なYes/No基準へ分ける
- 応答の長さや選択肢の順番による偏りを確認する
- 評価対象モデルと別のモデルで採点する方法も検討する
- グレーダー自体が壊れた項目を警告し、評価から除外できるようにする
- 人間専門家のラベルと照合する
特に重要なのが最後の人間照合です。
専門家にはグレーダーの判定を見せずにサンプルへラベルを付けてもらい、人間同士の一致度と、人間・AIグレーダー間の一致度を比較します。人間同士は一致するのにAIグレーダーだけ外れる場合、ルーブリックやグレーダー設定を見直す材料になります。
Anthropicは偶然一致を補正するCohenのカッパ係数のような統計量も例として挙げています。
事前登録で分析方法を先に固定する
評価結果を見てから、都合のよい指標や切り口だけを選ぶと、結果の解釈が不安定になります。
Anthropicは、結果を見る前に分析計画を書き出す「事前登録(preregistration)」を推奨しています。
事前に記録する項目として、次のようなものを挙げています。
- 主指標
- 比較するモデルや設定
- 報告するデータの切り口
- 改善・悪化と判断するしきい値
- 分析方法
途中で計画を変える必要が出た場合は、変更した事実と理由を報告します。
事前登録の役割は、結果を見てから評価基準を動かす余地を減らし、同じデータからどの結論を出すかを追跡しやすくすることです。
複雑なマルチターン100件・比較的単純なシングルターン1000件はAnthropicの実務上の最低ライン
Anthropicはサンプル数について、実務上の最低ラインを具体的に示しています。
- 複雑なマルチターン評価:100項目
- 比較的単純なシングルターン評価:1,000項目
100件・1,000件はAnthropicが自社の経験から示す最低ラインで、評価ごとの設計に応じて必要なサンプル数は変わります。
モデル出力には確率的なばらつきがあるため、各テストケースを複数回実行し、その広がりも報告します。サンプル数が増えるほど、小さな差を検出しやすくなります。
小さなモデル差を見る場合は、同じ項目へ両モデルを実行するペア比較を使い、項目ごとの差に対する信頼区間を計算する方法も示しています。
同じタスクを複数回実行して安定性を見る考え方は、Microsoft ThinkingBoxの反復評価にもつながります。最終状態と反復成功率を分けて見る仕組みはこちらの記事で整理しています。
数ポイント差は信頼区間と設定差まで含めて読む
Anthropicは、すべての推定値に不確実性を付けて報告することを勧めています。
同社のAPI上のマルチターン安全性評価では、信頼区間が±10ポイントを超える場合があります。評価結果が数ポイント違っていても、信頼区間が広ければ、その差は標本のばらつきで説明できる可能性があります。
具体例として、恋愛詐欺に焦点を当てたマルチターン評価では、Claude Opus 5が98%、Opus 5.5が94%でした。4ポイントの差に統計的有意性は確認されず、モデル間の優劣は結論づけられませんでした。
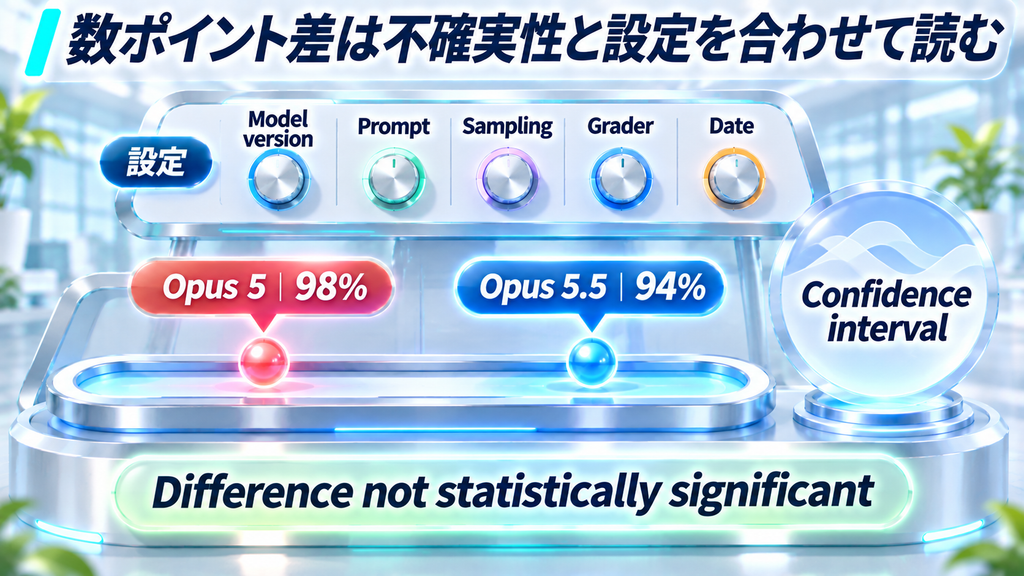
評価結果を比較するときは、信頼区間に加えて実行設定もそろえます。
AnthropicはClaude Fable 5.1のマルチターン安全性評価で、API上のraw modelと、システムプロンプトが適用されるclaude.aiの設定との適切応答率に最大34ポイントの差が出たと報告しています。
記録する主な条件は次の通りです。
- モデルの正確なバージョン
- サンプリング設定
- システムプロンプト
- グレーダーのバージョン
- 評価日
- ツール・ハーネス・製品面の設定
モデル名だけが同じでも、設定が変われば同じ測定とは扱えません。
評価環境は隔離と監視を含めて設計する
安全性評価そのものが危険な操作を引き起こす場合もあります。
Anthropicはサイバー評価などで標準の安全策を外してモデルの基礎的な挙動を測る場合があるため、インターネットアクセスのないサンドボックスで実行し、リアルタイム監視で停止できるようにすることを推奨しています。
Web検索が必要な評価ではネットワーク接続を完全に切れないため、Anthropicはリアルタイム監視を導入しています。
評価を走らせる環境の権限、ネットワーク、監視、停止条件も、安全性評価の設計に含まれます。
実務では「設計・実行・報告」を一つの評価シートにする
社内でAI評価を作る場合、Anthropicの指針は評価シートへ落とし込めます。
| 項目 | 記録する内容 |
|---|---|
| 評価目的 | 何を判断するための評価か |
| 構成概念 | 具体的に何を安全・不安全として測るか |
| シナリオ | 対象ユーザー、状況、難易度、言語、製品面 |
| ルーブリック | 合格・不合格を決める基準 |
| グレーダー | 種類、バージョン、人間照合の結果 |
| 事前登録 | 主指標、比較、切り口、しきい値 |
| サンプル | 項目数、反復回数、抽出方法 |
| 統計 | 点推定、信頼区間、比較方法 |
| 実行設定 | モデル、プロンプト、sampling、tool、harness |
| 報告 | カテゴリ別結果、変化しなかった項目、制約 |
評価を実施する組織の独立性や、どこまでモデル・証拠へアクセスできるかは別の論点です。独立評価の主体とアクセス条件については、NYCAIRRの記事で整理しています。
Anthropicは実行・ログ・採点の基盤としてUK AI Security InstituteのInspectを、マルチターン行動評価の自動化例としてPetriを挙げています。共通フレームワークを使う場合も、構成概念、グレーダー検証、サンプル設計、統計報告まで含めて評価条件を残すことが再現性につながります。
まとめ
Anthropicの「Building strong safety evaluations」は、安全性評価を再現可能な測定設計として扱うための実務指針です。
特に軸になるのは、次の4点です。
- 測りたい構成概念をデータ収集前に定義する
- AIグレーダーを人間専門家の判断と照合する
- 分析方法を事前登録し、十分なサンプル数を確保する
- 信頼区間と実行設定を含めて結果を報告する
Anthropicが示した98%対94%の例では、4ポイント差に統計的有意性は確認されませんでした。モデル比較では、点数の大小に加えて、その差を検出できる評価設計になっているかを確認する必要があります。
AI安全性評価を社内で作る場合も、「何点だったか」の前に「何を、どの条件で、どの測定器を使って、どの不確実性で測ったか」を残すことが、再現可能な評価につながります。