当サイトではアフィリエイト広告を利用しています。
今日のAIニュース5選
11月12日、Googleは高速・高効率なGemini 4 Hydrogenを公開しました。同じ日、NVIDIAではJensen Huang氏が社長・CEO・取締役を退任し、CFOのColette Kress氏が暫定CEOに就任しています。高速モデルをどう使い分けるかという技術側の変化と、AI計算基盤の中心企業で起きた経営移行という性質の異なる大きな動きが重なりました。
その周辺でも、AMDは次世代GPUの選択肢を増やし、IBMはAIエージェントの実行時ID保護を強化、SalesforceはAI自身が仮説と実験を回す研究開発エージェントを公開しています。モデル能力に加えて、計算基盤、権限管理、研究開発の進め方まで変化が広がっています。
1. Google、Gemini 4 Hydrogenを公開
Googleは11月12日、Gemini 4シリーズの新モデル「Gemini 4 Hydrogen」を公開しました。CarbonやArgonが深く長時間の推論を重視するのに対し、Hydrogenは日常的なコーディングやエージェント処理を速く効率よく実行する役割に置かれています。Google AI Studio、Gemini API、Gemini for business、Geminiアプリ、Google Searchなどへグローバルに展開され、Geminiアプリの無料ユーザーも、プロンプトに適すると判断された場合は自動モデル選択を通じて利用できます。
Hydrogenは100万トークンのコンテキストを持ち、API料金は100万入力トークンあたり1.50ドル、100万出力トークンあたり7.50ドルです。100万トークンの範囲全体で同じ単価が適用されます。Googleは、速度を重視するコーディングや反復作業、複数エージェントのワーカーや検証役などを主な使い方として挙げています。
さらにGoogle Antigravityには「Orchestrator」が加わりました。1つのセッション内で、難しい判断をCarbon、実装や検証をHydrogenといった形で動的に切り替える仕組みです。GoogleのTerminal-Bench 4.0評価では、Carbonに近いタスク成功率を保ちながら、平均でクォータ消費を24%減らし、完了時間を19%短縮したとしています。
Gemini 4は、最上位モデルを一律に使う構成から、推論の深さと実行速度に合わせてモデルを組み合わせる構成へ広がっています。Hydrogenの登場で、モデル選択には能力差に加えて、待ち時間やトークンコストも設計要素として加わりました。
2. NVIDIA、Jensen Huang氏がCEOを退任
NVIDIAは11月12日、Jensen Huang氏が社長、CEO、取締役を即時退任したと発表しました。Executive Vice President兼CFOのColette Kress氏が暫定CEOを兼務し、取締役会は常任CEOの選定を開始しています。候補は社内外から検討するとしています。
Kress氏は2013年からNVIDIAのCFOを務め、同社の財務部門を率いてきました。取締役会では同時に、Harvey C. Jones氏をNVIDIA初の取締役会議長に任命しています。経営の役割を暫定CEOと新たな議長へ分けたうえで、常任CEOを探す体制です。
NVIDIAの取締役会は、現在の経営チームが事業、顧客対応、技術ロードマップを継続して実行できると説明しています。11月17日に予定されている2027会計年度第3四半期の決算発表も、従来の予定どおり実施するとしています。
生成AIの学習・推論基盤では、GPUからネットワーク、ラックスケールシステム、ソフトウェアまでNVIDIAの影響が広がっています。現時点の経営体制は暫定CEOへの移行で、常任後継者は選定中です。今後は、次のCEO決定と既存ロードマップの実行状況が具体的な確認点になります。
3. AMD、Instinct MI450Xを追加しMI455Xの推論結果を公開
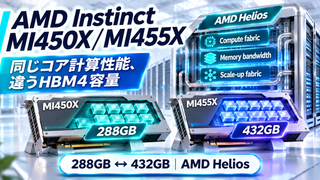
AMDは11月12日、Instinct MI400シリーズの更新を発表し、新たに「Instinct MI450X」を追加しました。MI450XはGPUあたり288GBのHBM4を搭載し、MI455Xと同じコア計算性能、メモリ帯域、スケールアップ/スケールアウト接続能力を持ちます。両GPUは同じHeliosラックスケール基盤とROCmソフトウェア基盤で利用する設計です。
違いの中心はメモリ容量です。AMDは、MI450Xを必要なメモリ容量と運用コストを合わせやすい選択肢として位置付け、MI455Xはより大きなモデル、長いコンテキスト、高い同時実行数に向けたメモリ余裕を持つ構成と説明しています。同じラック基盤の中で、ワークロードに応じてGPUのメモリ構成を選べるようになります。
AMDはMI455Xの実測推論結果も公開しました。AMD Performance LabsがDeepSeek-R1をMLPerf Inference Offline構成で測定した結果は、GPUあたり毎秒21,333トークンです。同社はこの値を、公開済みのNVIDIA Vera Rubin NVL72のMLPerf v6.1結果と比較し、最大30%高いスループットとしています。
この30%という差は、AMDが自社環境で測定したMI455Xと、MLPerfで公開されたVera Rubinの特定構成を比べた値です。モデル、システム構成、ソフトウェアで結果は変わるため、今回の発表で確認できるのはDeepSeek-R1のMLPerf Offlineという条件での比較です。次世代GPU競争は、単体GPUの演算性能に加えて、メモリ容量を選べる製品構成とラック全体の推論性能まで比較対象になっています。
4. IBM、AuthMind買収でAIエージェントの実行時ID保護を強化
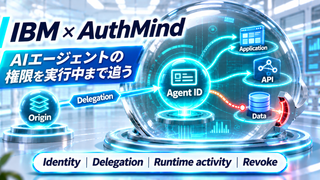
IBMは11月12日、IDセキュリティ企業AuthMindの買収を公表し、HashiCorp Vaultを中心とするAIエージェントのセキュリティ機能を強化する方針を示しました。Vaultが担うIDベースのアクセス制御、シークレット管理、短命な認証情報に、AuthMindの実行時ID可視化と脅威検知を組み合わせます。
IBMが示したエージェント保護は5つの領域に分かれます。エージェントごとに信頼できるIDと所有者を登録し、誰の権限を委任するかを定め、最小権限でアプリやデータへのアクセスを許可します。その後も、実際に使われた権限と行動を監査し、危険なアクセスを検知した場合はリアルタイムで制限・取り消しにつなげます。
AuthMindの中核技術には「identity activity graph」があります。人、マシン、AIエージェントと、それらが接続するリソースの関係やアクセス経路を結び、ネットワーク通信や実行時の振る舞いから、管理外で動くエージェント、通常と異なるアクセス、過剰な権限、ポリシー違反の兆候を追跡する仕組みです。
AIエージェントは、認証を通過した後も複数のツールやデータへ接続し、別のエージェントへ仕事を委任できます。そのため、実行開始時の認証から「誰から権限を受け、どこへアクセスし、その権限をどう使ったか」まで継続して追えることが重要になります。IBMの今回の動きは、エージェントIDを発行する段階から実行中の行動までを一続きで管理する方向を示しています。
5. Salesforce、AI研究開発を自動化するSFR-AutoR&Dを公開
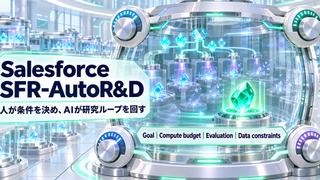
Salesforce AI Researchは11月11日、研究開発の仮説立案から実験・検証までをAIエージェントが回す「SFR-AutoR&D」を公開しました。人が研究目標、対象となるコードやモデル、改善指標、計算予算などを与えると、エージェントが改善案を考え、実装し、基準となる方法と同じ条件で比較実験を行います。結果が裏付けられた改善だけを残し、その結果を次の仮説につなげます。
構成は、既存コードのアルゴリズムやシステム改善を探す「AutoR&D-Engineer」と、新しい学習方法を考えてモデルを訓練・評価する「TrainForge」の2種類です。両者を支える共通基盤としてAutoInfraがあり、複数の学習・推論実験を並行実行します。
SalesforceはSFR-AutoR&Dを、自社で使う埋め込みモデルSFR-Embedding V3の改善にも利用しています。さらにオープンソースのEmbeddingGemma 2を対象にした実験では、MTEB英語v2の公開検索10タスクで、検索順位の品質を表すnDCG@10を6.13ポイント改善したと報告しました。別の約9時間の実験では、品質をほぼ維持したままスループットを36%高め、遅延を17%下げたとしています。
研究者が手作業で仮説、実装、実験、評価を順番に進めていた工程を、エージェントが連続して回す点が今回の特徴です。Salesforceの事例では、埋め込みモデルの改善サイクルを約80時間で実行しました。探索範囲は人が設定した目標、予算、評価、データ制約の中にあり、検証で基準を上回った結果だけが採用されます。
今回のSFR-AutoR&Dの事例が示すのは、研究開発の仮説・実装・評価の反復をAIエージェントに任せ、短時間に試行回数を増やす使い方です。
まとめ
11月12日は、Gemini 4 Hydrogenの公開とNVIDIAのCEO交代という、AIの利用側と供給側で大きな出来事が重なりました。HydrogenではCarbonなどと役割を分けるOrchestratorまで示され、モデル選択には性能順位に加えて、速度とコストを含む運用設計が求められています。NVIDIAは暫定CEO体制に入り、常任CEOの選定と既存ロードマップの実行が次の確認点です。
AMDはMI450Xを加えて同じHelios基盤内のメモリ容量選択を広げ、IBMはAuthMindを取り込んでAIエージェントのIDと権限を実行中まで追う設計を前に進めました。SalesforceのSFR-AutoR&Dは、AIが仮説・実験・検証を繰り返し、研究開発そのものの反復速度を上げる方向を示しています。
5件の対象はモデル、経営、GPU、セキュリティ、研究開発と異なります。Googleではモデルの使い分け、NVIDIAでは常任CEOの選定と既存ロードマップの実行、AMDではGPUのメモリ構成、IBMではエージェント権限の実行時管理、Salesforceでは人が条件を設定した研究開発の自動化が、それぞれ確認点として残ります。
今日の注目アイテム
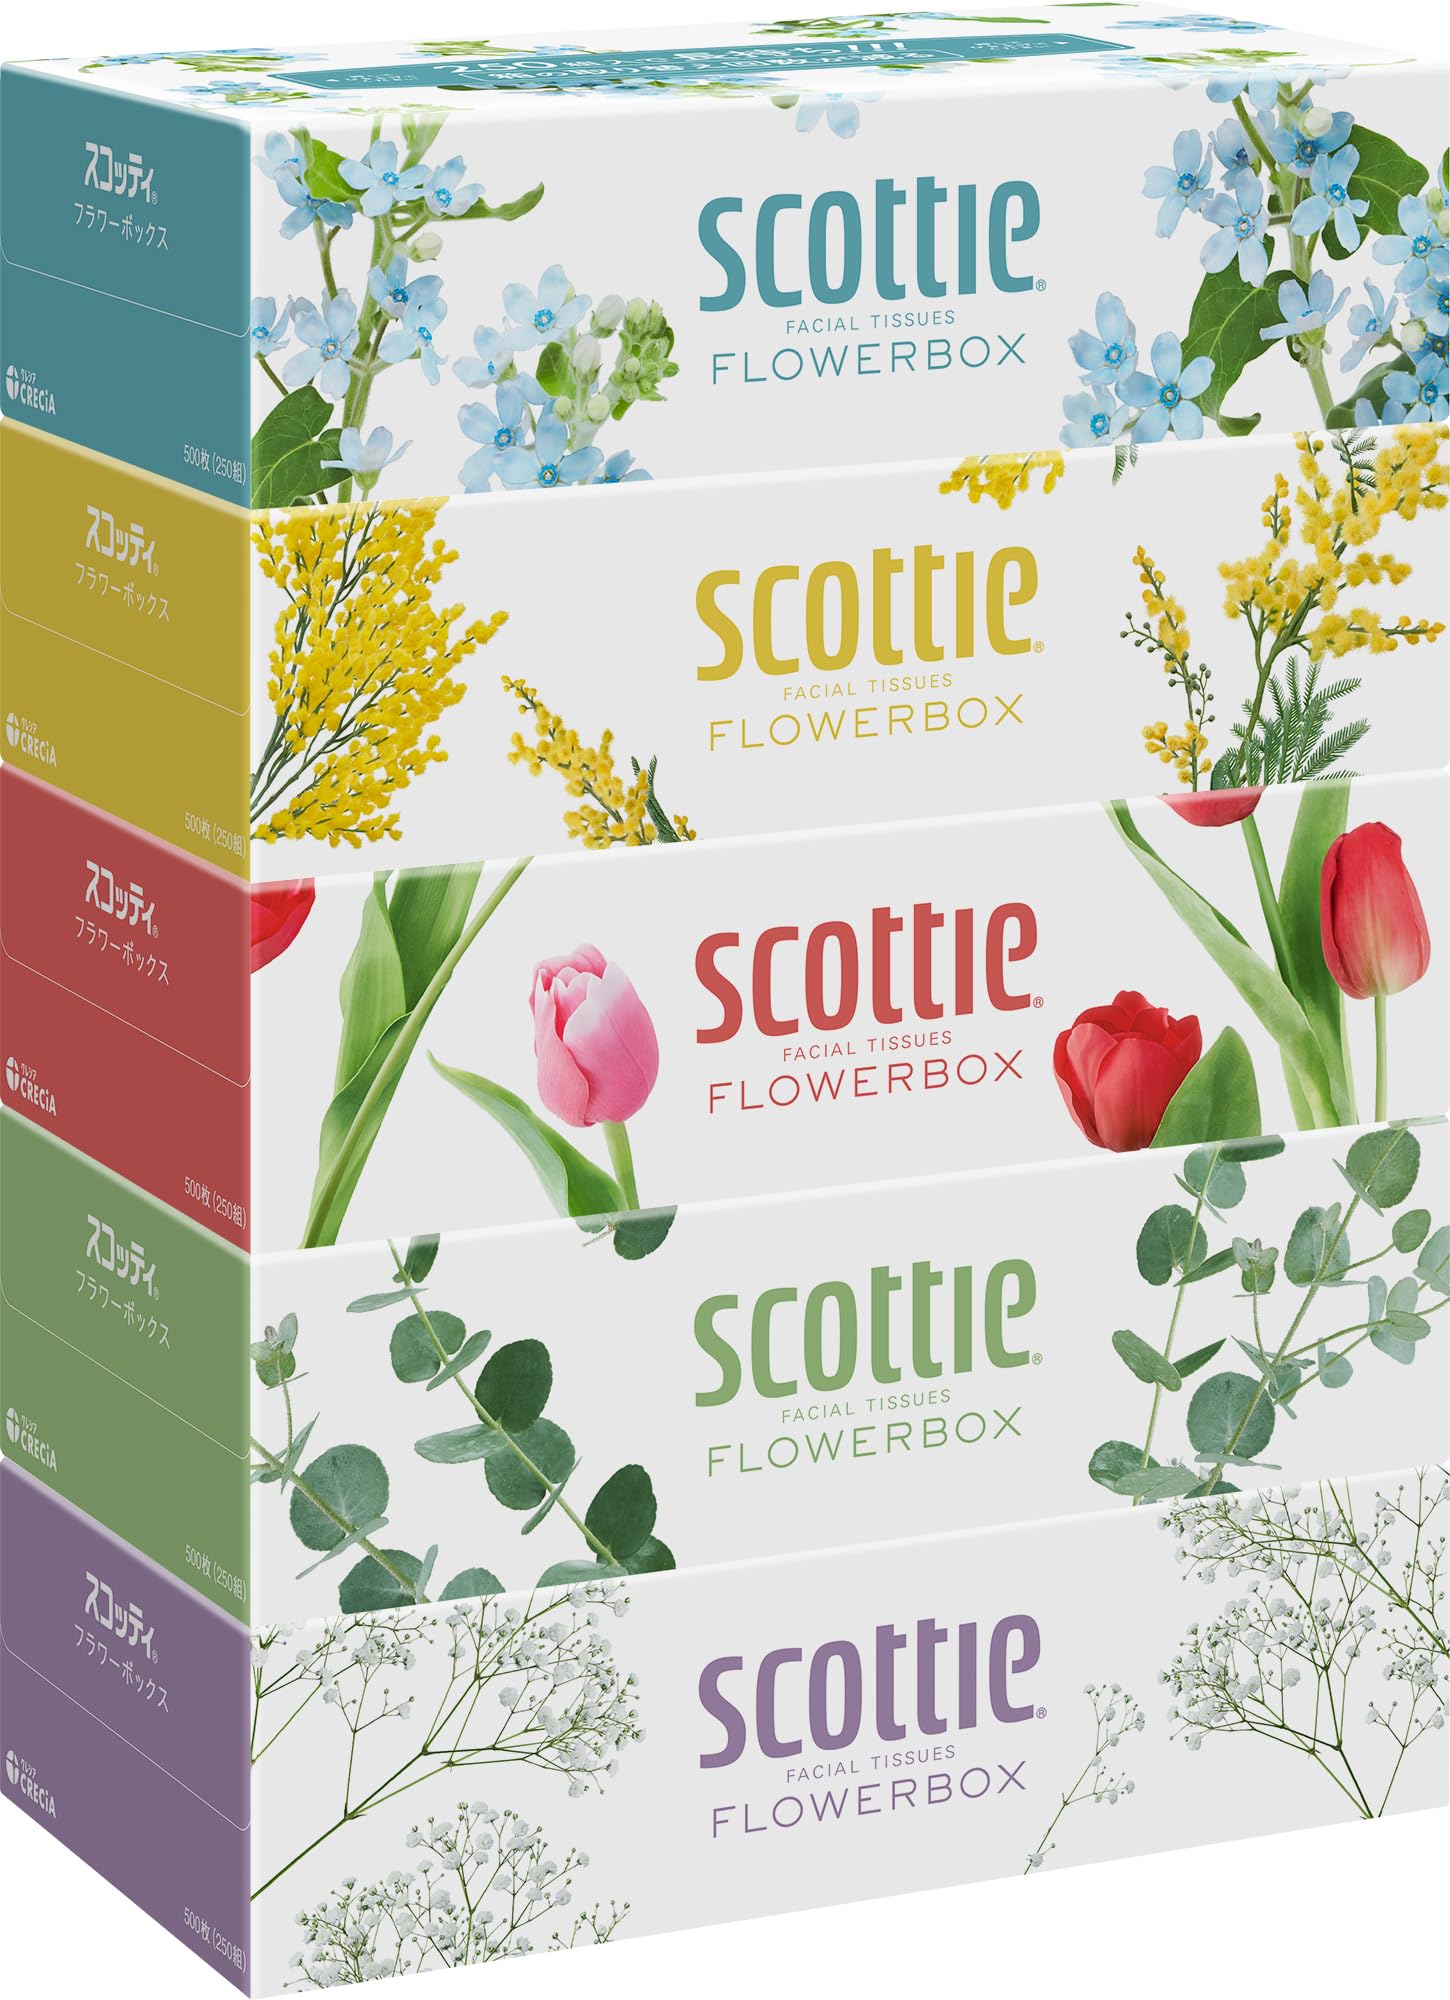

スコッティのフラワーボックスは、1箱あたり500枚(250組)のボックスティッシュ5箱セットです。 日用品として使いやすいボックスティッシュを、まとめて用意できます。
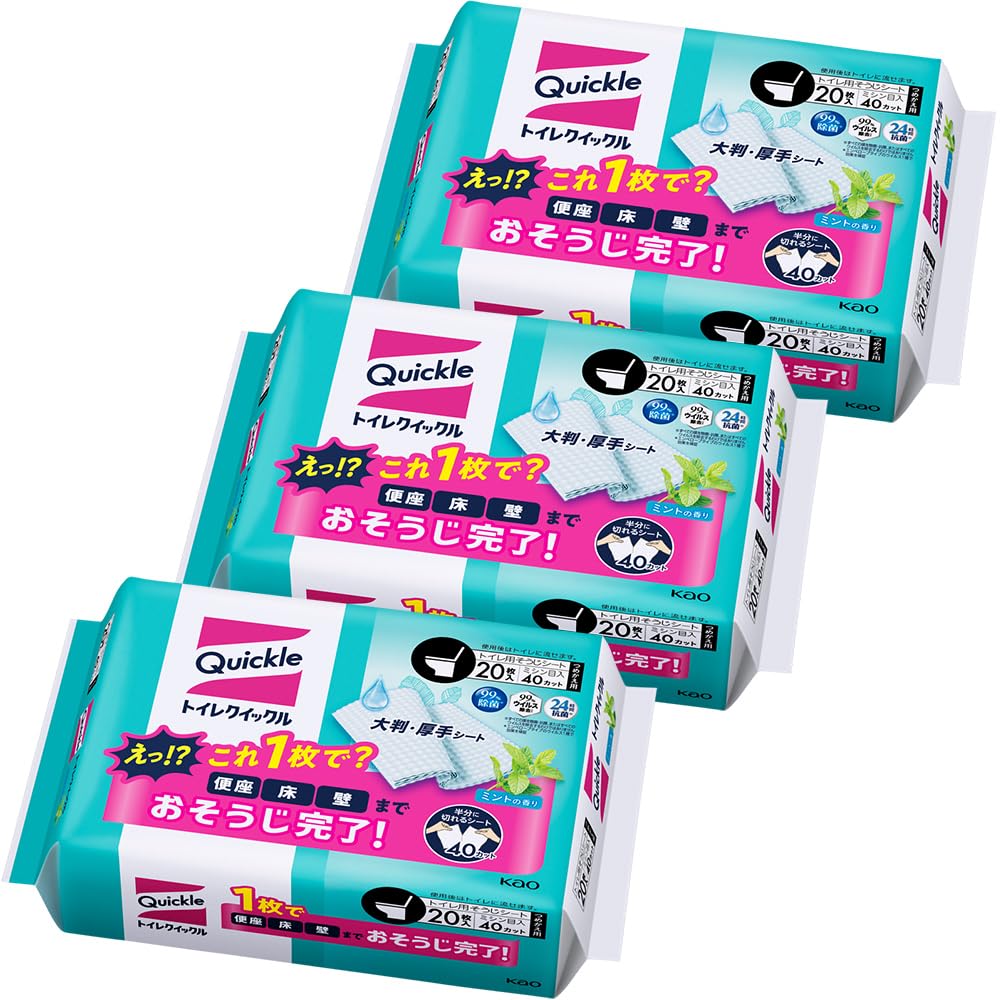

クイックルのトイレ用つめかえシートで、ミントの香りのジャンボパックです。20枚入りが3個セットになった、使い捨てクロスです。
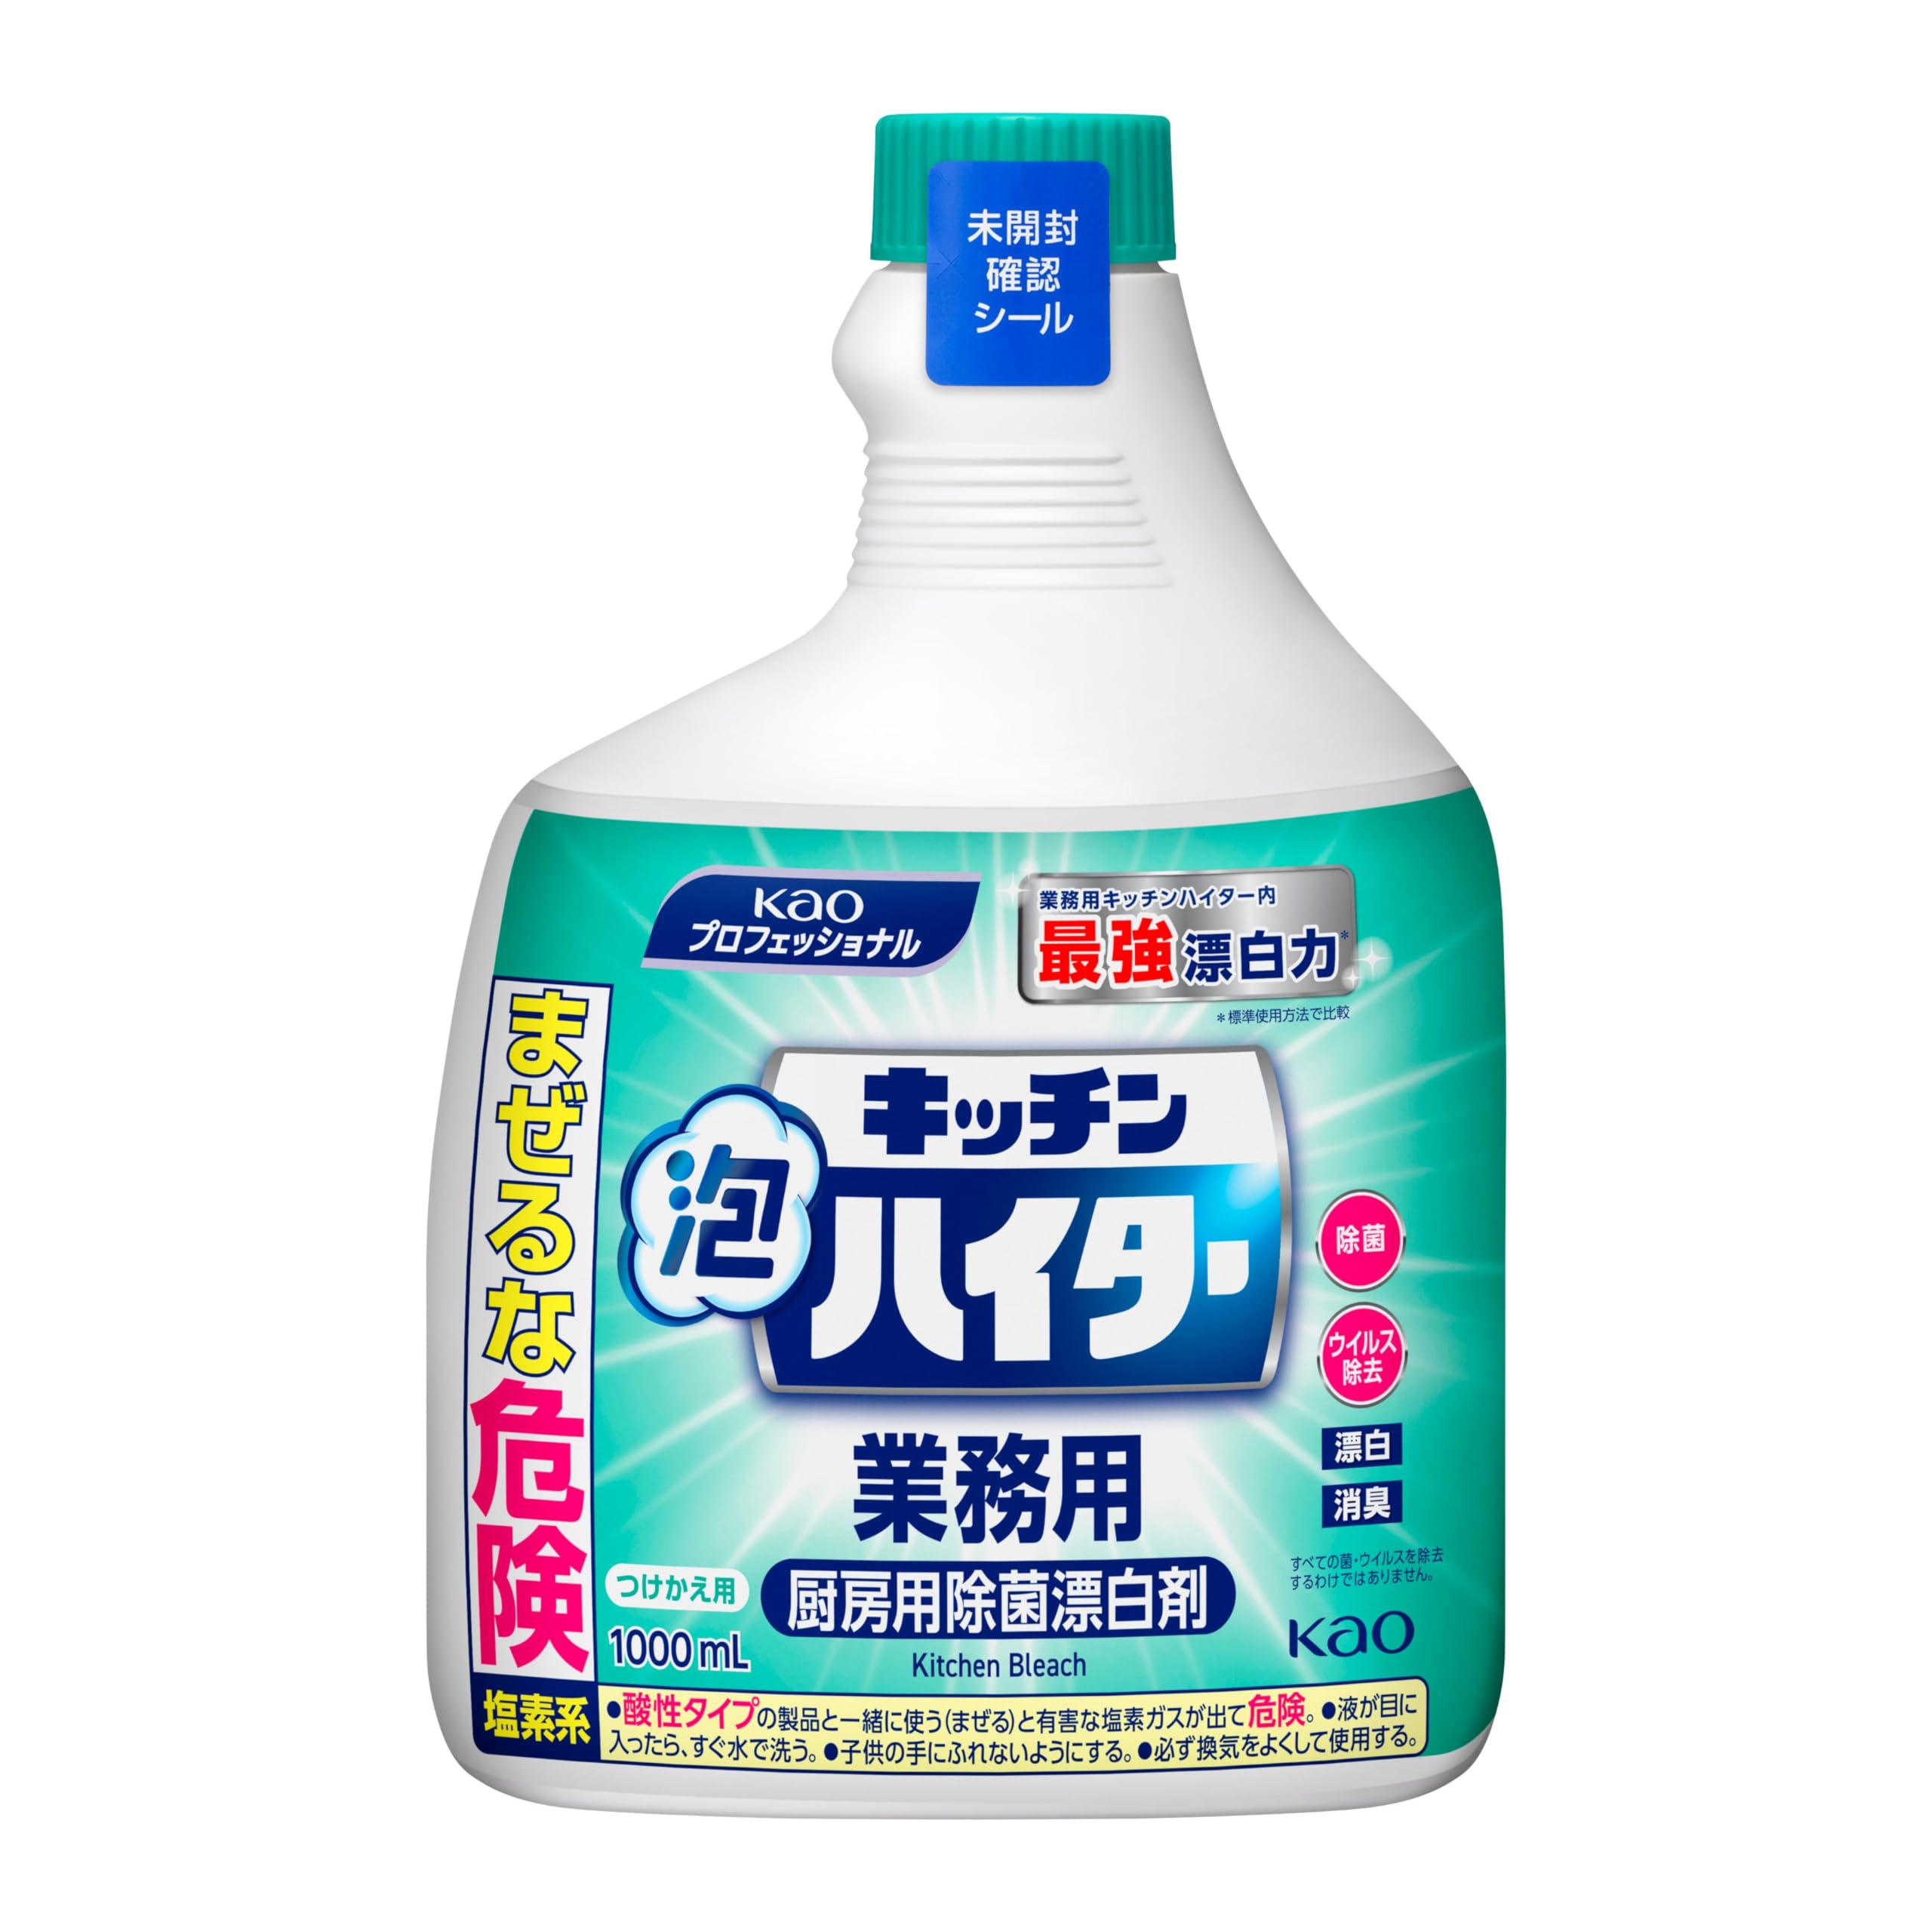

花王の「キッチン泡ハイター」つけかえ用で、容量1000mLの業務用・厨房用です。塩素系で、除菌・漂白・消臭をうたう商品です。