当サイトではアフィリエイト広告を利用しています。
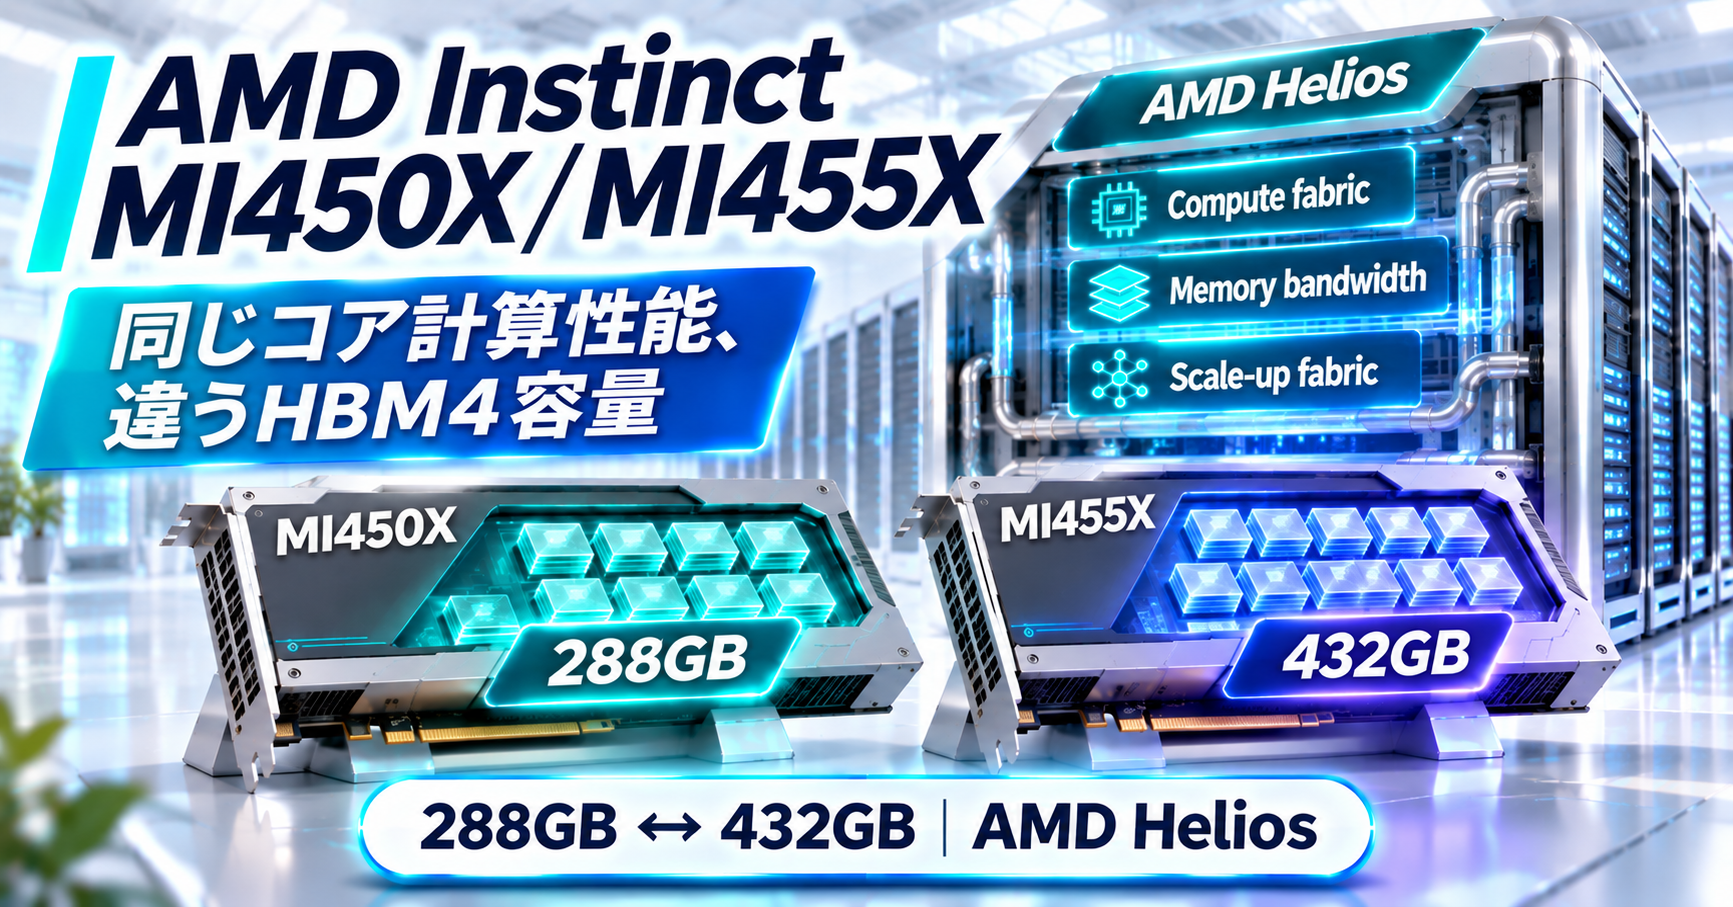
AMDは2026年11月12日、Instinct MI400シリーズへ「MI450X」を追加し、MI455Xを搭載したAMD HeliosでDeepSeek-R1の推論性能を測定した結果を公開しました。
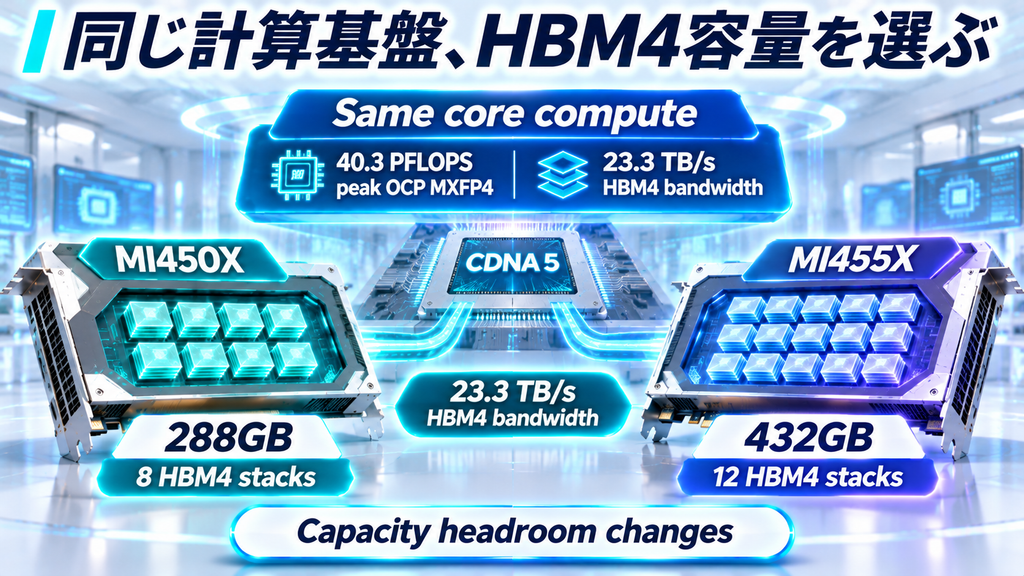
MI450XとMI455Xの違いは、ピーク演算性能やメモリ帯域よりHBM4の容量にあります。MI450Xは288GB、MI455Xは432GBのHBM4を搭載し、AMDは両GPUについてコア計算性能、メモリ帯域、スケールアップ/スケールアウト接続能力を同等と説明しています。
この構成では、選択したGPU分割構成で1GPUあたりに必要となるメモリ量が288GB内に収まるか、432GBの余裕が必要かが選択軸になります。MI455Xで示された21,333 tokens/s/GPUという推論値も、DeepSeek-R1をMLPerf Inference Offline構成で測定した特定条件の結果として読む必要があります。
MI450XとMI455Xはコア計算性能をそろえ、HBM4容量を分けている
MI450XはAMD Helios向けに追加されたInstinct MI400シリーズのGPUです。5th Gen AMD CDNA 5アーキテクチャを採用し、MI455Xと同じHeliosラックスケール基盤で使う設計です。
主な違いを並べると、メモリ容量の差が中心であることが分かります。
| 項目 | Instinct MI450X | Instinct MI455X |
|---|---|---|
| GPUアーキテクチャ | CDNA 5 | CDNA 5 |
| HBM4容量 | 288GB | 432GB |
| HBM4スタック数 | 8 | 12 |
| ピークメモリ帯域 | 23.3TB/s | 23.3TB/s |
| ピークOCP MXFP4性能 | 40.3PFLOPS | 40.3PFLOPS |
| スケールアップ帯域 | 3.6TB/s | 3.6TB/s |
| スケールアウト帯域 | 600GB/s | 600GB/s |
| Heliosでの位置付け | 選択したGPU分割で1GPUあたりの必要メモリが288GB内に収まる構成 | 1GPUあたりにより大きなメモリ余裕が必要な構成 |
MI455XはMI450XよりHBM4が144GB多く、容量は1.5倍です。一方、公開仕様ではピークメモリ帯域は両方23.3TB/sです。
MI455Xで増える主な余裕は、GPU上に保持できるデータ量です。ピークメモリ帯域は両GPUとも23.3TB/sでそろっています。
288GBと432GBの差はモデル・コンテキスト・同時実行数に効く
AI推論では、モデルの重みに加えてKVキャッシュや中間データもHBMを使います。長いコンテキストや高い同時実行数ほど必要容量が増えます。
AMDはMI455Xの追加メモリ余裕が、次の用途で価値を持つと説明しています。
- より大きなモデル
- より長いコンテキスト
- より高い同時実行数
選択したGPU分割構成で、モデル重み・KVキャッシュ・中間データなどを含む1GPUあたりの必要メモリ量が288GB内に収まり、必要なスループットや応答目標を満たせるなら、MI450Xを選ぶ余地があります。AMDはこの構成を、運用費の最適化につながる選択肢として位置付けています。
反対に、モデルやKVキャッシュをGPU間へ細かく分割したくない処理、高い同時実行数を維持したい推論、大きなメモリ余裕を持たせたい環境では、432GBのMI455Xが候補になります。
メモリやネットワークを含むシステム全体でAIアクセラレータを選ぶ考え方は、Google TPU 8tx・8i Maxの記事でも扱っています。長大コンテキストでメモリ供給がどう設計条件になるかを確認できます。
Heliosは72基のMI450XまたはMI455Xを使う共通ラック基盤
AMD Heliosは、72基のInstinct MI455XまたはMI450X、AMD EPYC “Venice” CPU、AMD Pensando “Vulcano” AI NICなどを組み合わせるラックスケールの参照設計です。
Heliosは、OEM/ODMがシステムを構築するためのラックスケール参照設計として位置付けられています。
共通基盤を使うことで、MI450XとMI455Xは次の要素を共有します。
- CDNA 5ベースのGPU計算基盤
- 23.3TB/sのメモリ帯域
- UALoEによるスケールアップ接続
- UALinkによるスケールアウト接続
- ROCmソフトウェア基盤
- Heliosのラック・冷却・ネットワーク設計
この共通性があるため、GPU選択の中心を「コア計算性能の高低」より「1GPUあたりに必要なメモリ容量」へ寄せられます。システム設計側では、モデルサイズ、コンテキスト長、同時実行数、必要GPU数と分割方法を先に見積もり、各GPUに載るメモリ量に合わせてMI450XとMI455Xを選ぶ形になります。
MI455XはDeepSeek-R1で21,333 tokens/s/GPUを記録
AMD Performance Labsは2026年10月、MI455Xを搭載したAMD HeliosでDeepSeek-R1の推論を測定しました。
AMDが公開した値は、21,333 tokens/s/GPUです。測定にはMLPerf InferenceのOffline構成が使われています。
AMDはこの値を、MLPerf Inference v6.1で公開されているNVIDIA Vera Rubin NVL72のClosed Division結果と比較し、最大30%高いスループットと説明しています。
AMD側とNVIDIA側では、比較に使われた結果の出所が異なります。
| 比較対象 | 結果の出所 |
|---|---|
| AMD Instinct MI455X / Helios | AMD Performance Labsによる2026年10月の測定 |
| NVIDIA Vera Rubin NVL72 | MLPerf Inference v6.1の公開済みClosed Division結果 |
AMD側の21,333 tokens/s/GPUは、AMDがMLPerf Inference Offline構成を使って測定した値です。NVIDIA側はMLCommonsへ公開されたv6.1の結果です。
「最大30%」は、AMDが示したDeepSeek-R1/MLPerf Inference Offlineという特定条件の比較値です。モデル、レイテンシ条件、ソフトウェア構成が変わる評価では、それぞれの条件に対応する結果を確認します。
MLPerf Offlineは応答速度よりスループット上限を見る
MLPerf InferenceのOfflineシナリオでは、すべてのリクエストを最初からシステムへ渡し、最大スループットで処理します。
この条件が向いているのは、バッチ処理や大量リクエストをまとめて捌くときの処理量の上限を見る評価です。
対話型AIで重要になる初回トークンまでの時間や、一定の応答遅延を守りながらどこまで負荷を上げられるかは、ServerやInteractiveなど別のシナリオも合わせて見る必要があります。
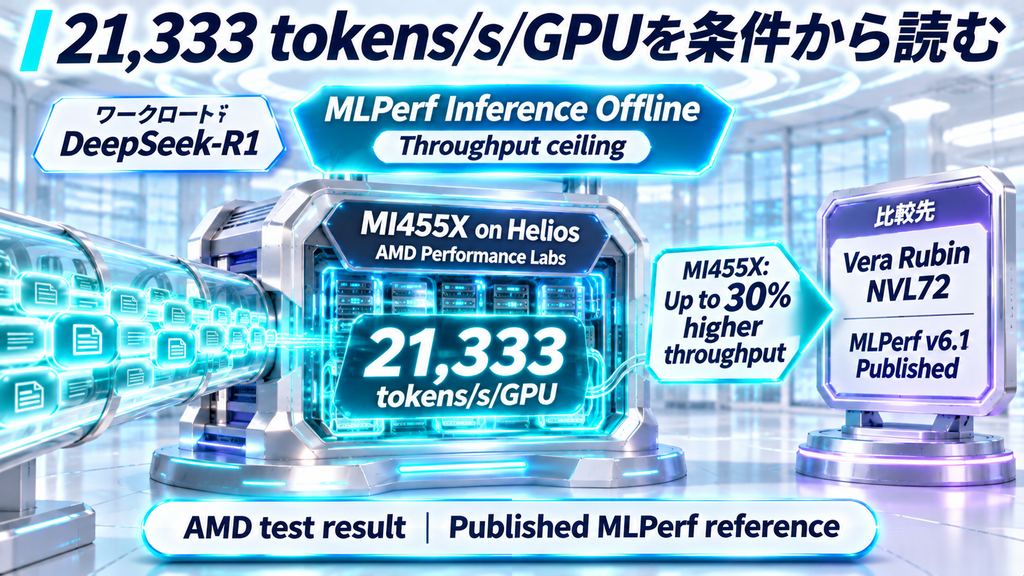
MI455Xの21,333 tokens/s/GPUは、DeepSeek-R1をOffline条件で高スループット処理した結果として読むと位置付けが明確になります。
ベンチマーク比較では5つの条件をそろえる
AI GPUの性能値は、数値と評価条件をセットで確認します。
1. モデル
今回の21,333 tokens/s/GPUはDeepSeek-R1の結果です。別のモデルでは演算量、メモリアクセス、並列化特性が変わります。
2. シナリオ
Offlineはスループット上限を見る条件です。対話用途ではServerやInteractiveのレイテンシ条件も確認します。
3. 精度・実装・ソフトウェア
低精度化、推論エンジン、カーネル最適化、並列化方法によって結果は変わります。評価対象は、ハードウェアとソフトウェアスタックを組み合わせたシステム性能として捉えます。
4. GPU数とラック構成
単体GPU、8GPUサーバー、72GPUラックでは通信構成が異なります。大規模モデルではGPU間の接続帯域も性能へ影響します。
5. 結果の出所
同じ公開MLPerf提出結果同士か、ベンダー社内測定を含む比較かを確認します。今回のAMD対NVIDIA比較は、AMD社内測定とMLPerf v6.1公開結果を組み合わせた比較です。
MI450XとMI455Xは「1GPUあたりの必要メモリ量」から選ぶ
今回の製品追加から作れる選定軸はシンプルです。両GPUの公開仕様ではコア計算性能、メモリ帯域、接続能力がそろっているため、まずGPU分割後の1GPUあたりに必要となるメモリ量を見ます。
| 確認項目 | MI450Xを検討しやすい条件 | MI455Xを検討しやすい条件 |
|---|---|---|
| モデル・実行時データ | GPU分割後、1GPUあたり288GB内で余裕を確保できる | 1GPUあたり288GBを超える、または余裕を広く取りたい |
| コンテキスト | 分割構成ごとの1GPUあたり必要容量が288GB内に収まる | 長いコンテキストで1GPUあたりの必要容量が増える |
| 同時実行数 | 1GPUあたりのKVキャッシュを含め288GB内に収まる | 高い並列度で1GPUあたりのメモリ消費が増える |
| GPU分割 | 現在の分割数で十分 | より大きなモデルを少ない分割で扱いたい |
| 運用設計 | 容量を合わせて運用費を最適化 | メモリ余裕を優先する |
実際の選定では、自分のモデルを想定するコンテキスト長・バッチサイズ・同時実行数で動かし、GPUあたりのメモリ使用量と処理量を測ります。
まとめ
AMD Instinct MI450XとMI455Xは、同じHelios基盤でコア計算性能・メモリ帯域・接続能力をそろえながら、GPU単位のHBM4容量を288GBと432GBへ分けたGPUです。
MI450Xは、選択したGPU分割構成で1GPUあたりの必要メモリ量が288GB内に収まる場合の選択肢となります。MI455Xは、大きなモデル、長いコンテキスト、高い同時実行数で1GPUあたりに必要となるメモリへ追加の余裕を持たせます。
MI455Xの21,333 tokens/s/GPUと最大30%高いという比較は、DeepSeek-R1をMLPerf Inference Offline構成で測定したAMDの結果です。Offlineは最大スループットを測る条件であり、対話型推論の評価ではレイテンシを含む別シナリオも合わせて確認します。
GPUを選ぶときは、GPU分割後の1GPUあたりに必要なHBM容量、コンテキスト、同時実行数、GPU間通信、実際の推論条件を先に決めることで、MI450XとMI455Xの違いを運用要件へ結び付けられます。
公式情報・参照先
- AMD Advances the Instinct MI400 Series for AI and Scientific Computing|AMD
- AMD Instinct MI450X GPUs|AMD
- AMD Helios Rackscale Solution|AMD
- Accelerator Specifications|AMD
- AMD CDNA Architecture|AMD
- Where the Industry Is Investing: A Look at MLPerf Inference v6.1|MLCommons
- MLPerf Inference Submission Guide|MLCommons