当サイトではアフィリエイト広告を利用しています。
2026年11月2日、Anthropicは大規模言語モデルの推論元を暗号学的に検証する研究プロトタイプ「FlashProve」を公開しました。
FlashProveが確かめるのは、受け取った応答が、あらかじめ指定されたモデルの重みから生成されたかという点です。モデル提供者は重みそのものを公開せず、利用者側は強力なGPUを持たなくても証明を検証できます。
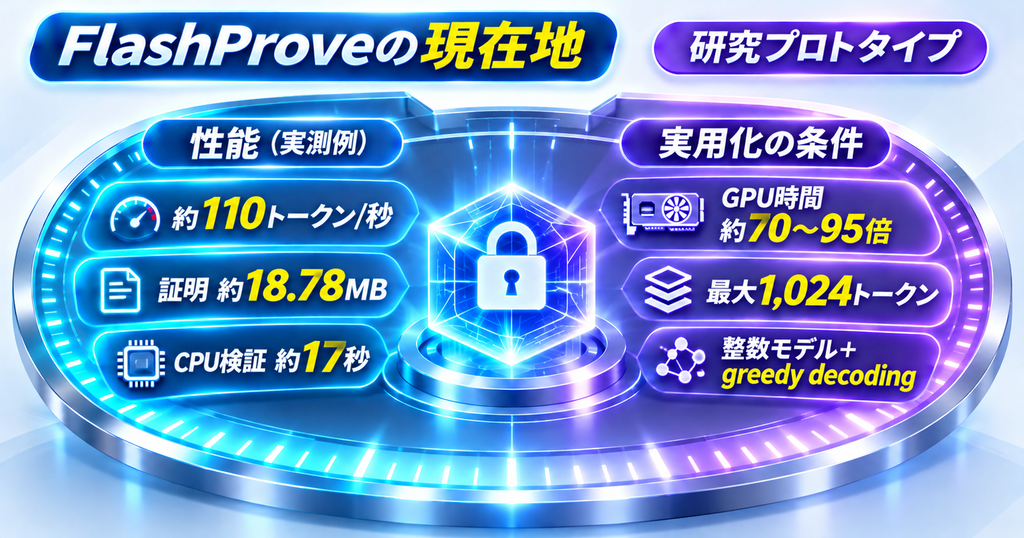
公開評価では、4000億パラメータのMixture-of-Experts(MoE)モデルであるLlama 4 Maverickの4ビット量子化版を使い、単一のNVIDIA H100で証明生成を約110トークン/秒まで高速化しました。証明は約18.78MBで、24スレッドのCPUによる検証は約17秒です。
その代わり、証明生成に使うGPU時間は通常の推論と比べて約70〜95倍かかります。現在の実装には1,024トークンの文脈、整数モデル、各段階で最も確率の高いトークンを選ぶgreedy decodingなどの条件もあります。
この記事では、FlashProveのCommit→Prove→Verifyの仕組み、zkSNARKで何を隠して何を証明するのか、性能と計算コスト、実用化に残る条件を整理します。
FlashProveは事前にコミットした指定モデル由来かを検証する
AIサービスで表示されるモデル名からは、実際に使われたモデル重みや推論計算まで利用者側で直接確認できません。
FlashProveは、モデル提供者が事前に特定の重みへ暗号学的なコミットメントを作り、その後の応答がその重みに基づく計算結果であることを証明します。
利用者が確認できる対象は、次のようなものです。
- 事前にコミットされたモデル重みと整合するか
- 指定した入力に対して、検証対象の出力トークンがそのモデルの計算結果と整合するか
- 証明からモデル重みや途中計算を復元できないか
FlashProveの証明対象はモデル同一性と推論計算の整合性です。回答内容の事実性、推論の有用性、安全性そのものは別の評価対象です。
この仕組みは、モデル評価、第三者ルーティング、監査などで、指定したモデルが実際に使われたかを暗号学的な証明で確認する用途につながります。
Commit→Prove→Verifyの3段階で推論元を確認する
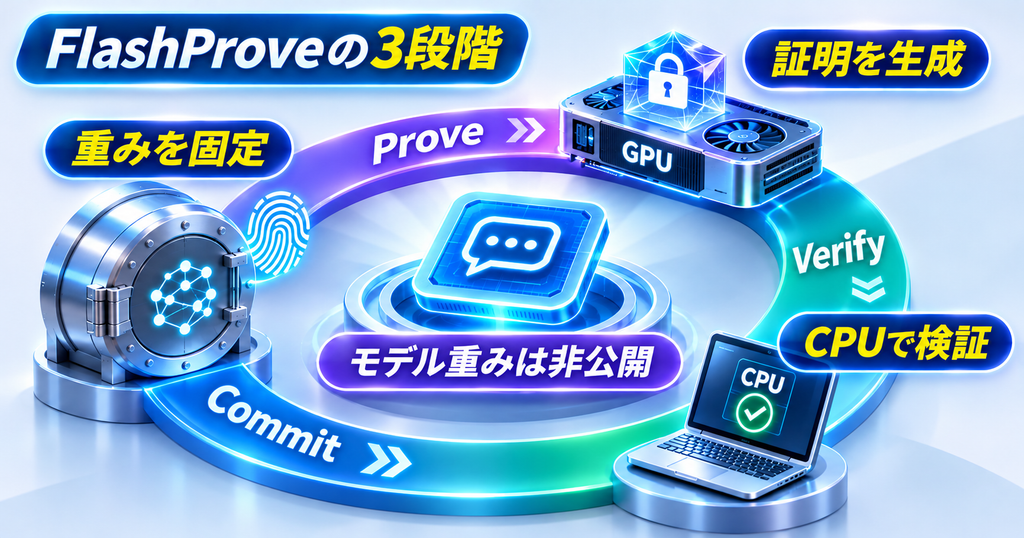
FlashProveは、大きく3段階で動きます。
1. Commit:モデル重みを固定する
最初にモデル提供者が、使うモデル重みに対する短いコミットメントを作成して公開します。
コミットメントは、特定の重み一式を指し示す暗号学的な指紋として働きます。重みそのものは公開しません。
Anthropicの評価では、このオフライン処理に約39分かかり、作成したコミットメントは技術上の条件から約1,600万リクエストまで利用できます。
2. Prove:応答に対応する証明を作る
モデルが入力を処理した後、証明者側が、コミット済みのモデルがその入力から検証対象の出力を生成したことを示す証明を作ります。
FlashProveはこの処理をpost-hoc、つまり応答生成後にまとめて行う設計です。複数リクエストをバッチ処理し、GPU上で証明を生成します。
3. Verify:利用者側で証明を確認する
利用者側は、コミットメント、入力、応答、証明を使って検証します。
モデル重みを保持したり、4000億パラメータのモデルを自分で再実行したりする必要はありません。公開評価では、検証側はCPUだけを使い、24スレッドで約17秒、1スレッドで約21秒でした。
zkSNARKで「重みを隠したまま正しい計算だった」と示す
FlashProveが使う中心技術は、zkSNARK系の暗号学的証明です。
zkSNARKでは、証明を作る側が大きな計算を実行したことを、短い証明で検証側へ示せます。さらにzero-knowledgeの性質によって、証明から秘密情報を読み出せないようにします。
FlashProveでは、次の情報を隠す設計です。
- モデル重み
- 推論中の中間値
- MoEで各層のどのexpertが使われたか
一方、モデルのアーキテクチャは秘匿対象に含まれていません。現在のシステムはMoE構造を前提に効率化しており、アーキテクチャを隠す仕組みは今後の研究対象です。
暗号学的な安全性の主張はLeanで形式化されています。Leanは証明支援系で、定理や安全性の主張を機械的に検査できる形へ落とし込みます。
Leanによる形式検証がどのような役割を持つかは、Claudeによるフェルマーの最終定理の形式化を扱った記事でも詳しく整理しています。
約110トークン/秒でも、証明生成コストは推論の約70〜95倍
FlashProveの公開結果は、証明生成が大規模モデルでも現実的な速度へ近づいたことを示しています。
主な測定条件と結果は次の通りです。
| 項目 | 公開された条件・結果 |
|---|---|
| 対象モデル | Llama 4 Maverick、4000億パラメータのMoE |
| 重み | 公開4ビット量子化版 |
| 証明者 | NVIDIA H100 1枚+CPU 24コア |
| 文脈 | 1,024トークン |
| オフラインCommit | 約39分 |
| Commitの利用範囲 | 約1,600万リクエスト |
| 24リクエストの証明生成 | 約223秒 |
| 証明生成スループット | 約110トークン/秒 |
| 証明サイズ | 1件あたり約18.78MB |
| CPU検証 | 24スレッド約17秒、1スレッド約21秒 |
| Commitのダウンロード量 | 約6.5MB |
| vLLM推論とのGPU時間比較 | 約70〜95倍 |
約110トークン/秒は、24リクエストをまとめて処理したときの証明生成スループットです。通常のチャットで利用者が見る生成速度とは指標が異なります。
Anthropicの測定では、24件をまとめた場合、証明生成に必要なGPU時間はvLLMで同じモデルを処理する場合の約72倍でした。vLLM側を高負荷で動かした比較では約94倍です。
速度の改善と、計算コストの大きさを分けて見る必要があります。
post-hoc方式は応答生成と証明生成を分離する
FlashProveは、応答後に証明を作るpost-hoc方式を採用しています。
この設計では、通常の推論と証明生成を別の処理として動かせます。証明生成の重い計算をユーザー向け応答のクリティカルパスから外し、複数の完了済みリクエストをまとめて処理できます。
そのため、利用者は先に応答を受け取り、証明による保証は後から得る形になります。
実用化を考えると、用途によって必要なタイミングが変わります。
- 一般的なチャット:応答を先に返し、必要なログだけ後から検証
- 第三者モデルルーター:請求やSLA確認のために一定割合を証明
- モデル評価:評価対象のモデルが途中で差し替わっていないか確認
- 監査:一定期間の推論記録をまとめて検証
現在のpost-hoc設計は、重要なトラフィックや監査対象を選んで後から確認する運用へ組み込みやすい構成です。
実用化には「何を信頼の起点にするか」も必要になる
FlashProveで指定モデル由来を確認するには、利用者が正しいコミットメントIDを持っている必要があります。
公開実装の検証ガイドでは、コミットメントIDを検証対象のサーバーとは独立した信頼できる経路から取得するよう求めています。
検証するサーバー自身が「このIDが正しい」と渡したものだけを使うと、どのモデルを基準に検証しているのかという信頼の起点が同じサーバーへ戻ってしまうためです。
実運用では、たとえば次のような仕組みが必要になります。
- モデル提供者が公式にコミットメントIDを公開する
- 監査機関が利用するIDを別経路で保持する
- モデル更新時に新しいコミットメントへ切り替える
- 検証側が使用するverifier自体も信頼できる配布経路から取得する
実運用では、証明の基準となるIDや検証プログラムをどう配るかという設計も必要です。
現在のFlashProveには5つの大きな制約がある
FlashProveはAnthropic自身が「research prototype」と位置付けている研究成果です。GitHubでもresearch artifactとして公開され、現在はmaintainedではなく、contributionも受け付けていません。
実用化を考えると、主に次の制約があります。
文脈は最大1,024トークン
現在のシステムが証明する文脈は最大1,024トークンです。
長い会話や大規模文書を扱う現在のLLMサービスでは、より長いコンテキストへ拡張する必要があります。
整数モデルとgreedy decodingが基準
証明対象は、公開重みを整数化したモデルの計算と、各段階で最も確率の高いトークンを選ぶgreedy decodingです。
候補から確率的にトークンを選ぶサンプリングや浮動小数点推論を使う実際の生成結果は、途中で整数モデルの結果とずれる場合があります。
アーキテクチャは隠さない
FlashProveは重みと中間計算を隠しますが、モデルアーキテクチャは秘匿対象に含めていません。
MoE構造を利用して証明コストを抑える設計でもあります。
高速C++実装はLeanとの完全一致が形式証明されていない
安全性の主張はLeanで形式化されていますが、日常利用を想定した高速C++ verifierとLean仕様が完全に同一であることは形式証明されていません。
Anthropicは、C++ verifierがテストした証明ではLean verifierと一致したと説明しています。
証明そのもの以外のサイドチャネルは範囲外
現在のzero-knowledge保証は、証明ファイルから重みを漏らさないことを対象にしています。
証明生成時間などを観測して情報を推測するサイドチャネル攻撃は、今回のリリースでは範囲外です。
FlashProveが実用段階へ進むときに見るべき4つの条件
FlashProveの実用化では、暗号学的な検証機能と実装コストを合わせて見る必要があります。
確認したいのは次の4点です。
| 条件 | 確認したいこと |
|---|---|
| 証明コスト | 通常推論に対するGPU時間の上乗せをどこまで下げられるか |
| 検証遅延 | ユーザーや監査者が証明を受け取るまでの時間 |
| 対象範囲 | 長文脈、サンプリング、denseモデルなどへ対応できるか |
| 信頼の配布 | コミットメントIDとverifierを独立した信頼経路で配れるか |
現在のFlashProveは、4000億パラメータ級のモデルでも暗号学的証明を生成できるところまで到達しました。
次の焦点は、通常のAIサービスへ組み込める計算コストと運用方法まで下げられるかです。
モデル提供が複数のクラウド、ルーター、代理APIをまたぐ環境では、モデル同一性を独立に検証する手段が価値を持ちます。FlashProveは、そのためのソフトウェアだけで完結する選択肢を具体的な性能値まで示した研究です。
まとめ
FlashProveは、モデル提供者が重みを公開せずに、応答がコミット済みのモデルから生成されたことを暗号学的に証明する研究プロトタイプです。
仕組みは、重みを固定するCommit、証明を作るProve、利用者側で確認するVerifyの3段階です。
Llama 4 Maverickの公開評価では、単一H100で約110トークン/秒の証明生成、約18.78MBの証明、CPUで約17秒の検証まで高速化しました。
一方、証明生成には通常推論の約70〜95倍のGPU時間が必要です。1,024トークンの文脈、整数モデルとgreedy decoding、MoE前提、高速実装とLean仕様の形式的な同一性など、実用化へ向けた条件も残っています。
FlashProveの意味は、AIの回答内容を評価する仕組みとは別に、「指定したモデルがその応答を生成した」という出所を検証する層を追加できることです。
今後は証明コスト、長文脈、生成方式への対応と、コミットメントを安全に配布する運用が、実サービスへ入るかを判断するポイントになります。