当サイトではアフィリエイト広告を利用しています。
OpenAIは2026年11月5日、サイバーセキュリティ研究に特化した「GPT-6 Cyber」を発表しました。
GPT-6 Cyberは、脆弱性の発見、悪用可能性の検証、修正支援など、許可されたセキュリティ業務を対象にしたGPT-6 Astraのサイバー特化版です。OpenAIはPreparedness Framework上のサイバーセキュリティ能力を「Critical」と分類しています。
この記事で見る中心は、モデルの能力評価と、実際にどこまで動かせるかを制御する仕組みを分けて確認することです。
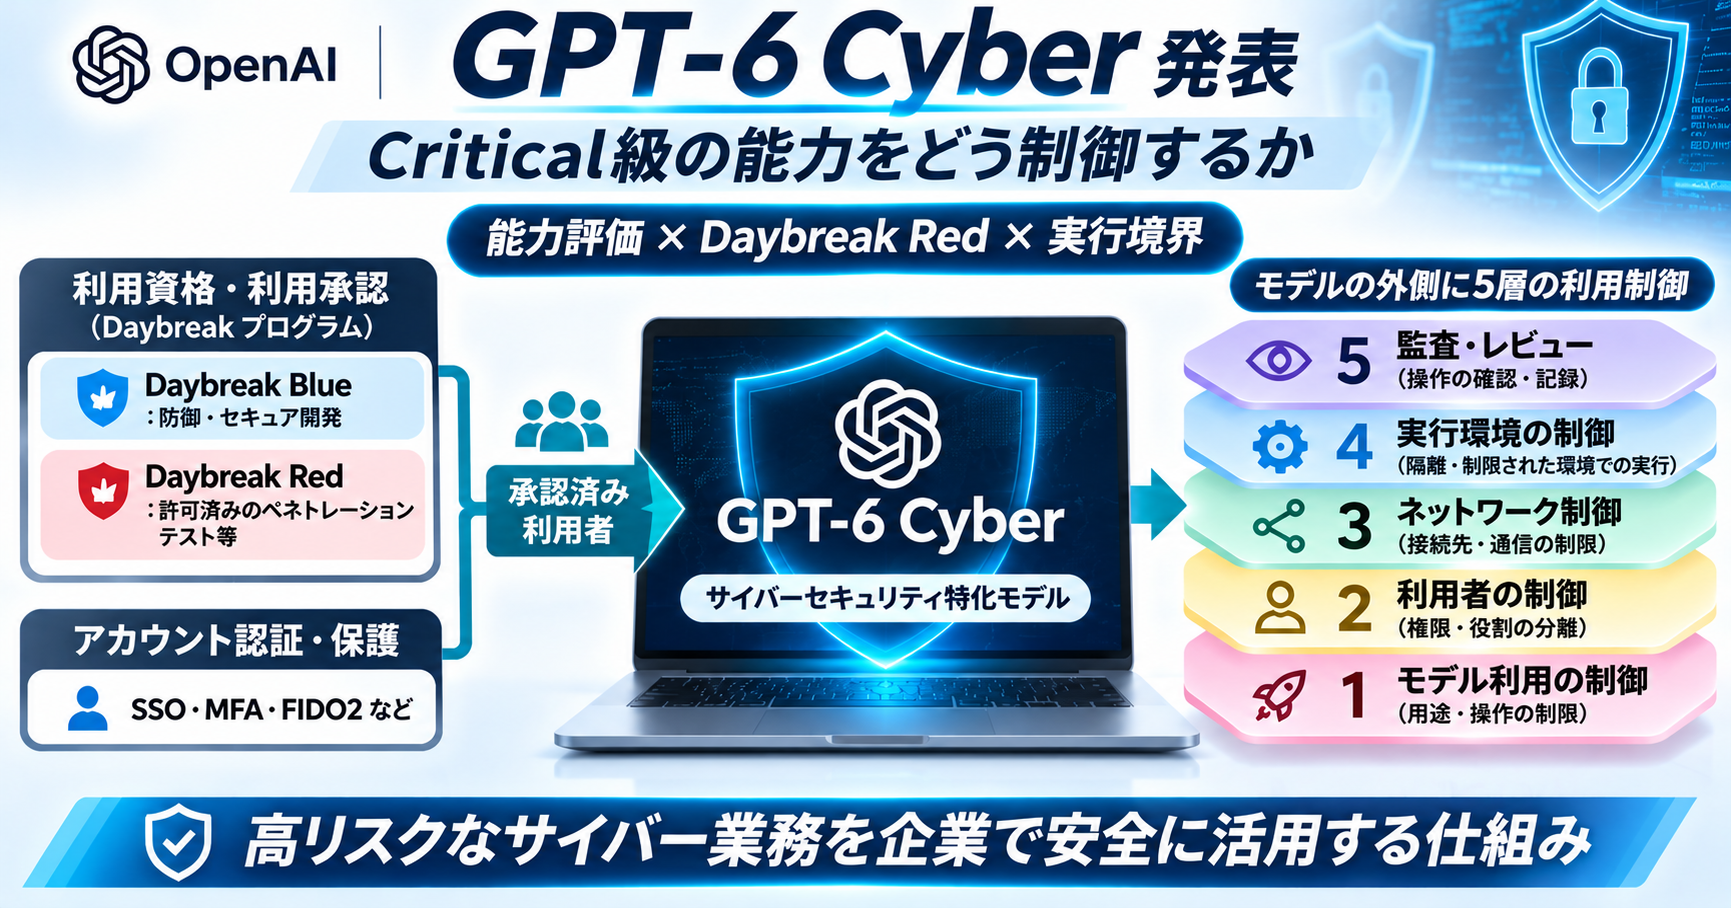
ExploitGymでは48.5%を記録し、FirefoxやLinuxを使った実運用の研究結果も公開されました。同時に、提供先はDaybreak Redの承認済み利用者へ絞られ、ID確認、ネットワーク制限、サンドボックス、操作レビュー、監視、人の監督が重ねられています。
高いサイバー能力を持つモデルでは、「何ができるか」と「誰が、どの環境で、どの権限まで使えるか」が同じくらい重要な製品仕様になります。
GPT-6 Cyberの「Critical」は能力の強さを示す分類
OpenAIのPreparedness Frameworkでは、GPT-6 Cyberのサイバーセキュリティ能力を「Critical」に分類しています。
OpenAIのPreparedness Frameworkでは、サイバーセキュリティ能力のCritical水準を、強固な実システムに対するゼロデイ脆弱性の発見・実用的なエクスプロイト開発や、高レベルな目標から新しい攻撃戦略を組み立てて実行できる能力として定義しています。
OpenAIはGPT-6 AstraをすでにCriticalと分類しており、GPT-6 Cyberも同じ能力水準に置いています。GPT-6 Cyberはそこへサイバーセキュリティ向けの追加学習を行い、許可された脆弱性研究やペネトレーションテストでの拒否を減らす方向へ調整したモデルです。
能力分類と提供範囲は別の軸で設計されています。
Criticalは、評価上どこまで高度なサイバー作業を実行できるかを示します。実際の利用ではDaybreak Redの承認や追加のモデル承認が必要で、接続元、操作範囲、監視方法まで制約されます。
能力評価ではGPT-5.6 Cyberから大きく伸びた
OpenAIが発表した主な評価では、GPT-6 CyberはGPT-5.6 CyberやGPT-6 Astraを上回る結果を示しています。
| 評価 | GPT-6 Cyber | 比較対象 | 何を見ているか |
|---|---|---|---|
| ExploitGym | 48.5% | GPT-5.6 Cyber 32.1% | 指定された既知脆弱性を実際に利用できるか |
| Web Pentesting | 40.3% recall | GPT-6 Astra 32.0% | ソースコードなしでWebアプリの脆弱性を発見できるか |
| RemoteExploitBench | 95%完了 | GPT-6 Astra + Daybreak Blueは全件拒否 | 既知脆弱性を使ったリモート検証を完了できるか |
Web Pentestingの「recall」は、評価対象となる脆弱性のうちモデルが発見できた割合です。GPT-6 Cyberの40.3%は、GPT-6 Astraの32.0%より8.3ポイント高い結果です。
ExploitGymでは16.4ポイント上昇し、OpenAIは相対的には51%の改善と説明しています。
RemoteExploitBenchはGitLab、PostgreSQL、Jenkinsなどの既知脆弱性を管理された環境で再現する評価です。GPT-6 Cyberは95%を完了し、GPT-6 AstraをDaybreak Blueで実行した条件では全件が拒否されました。
この比較には、モデルそのものの能力差とアクセス設定・拒否設定の差が同時に入っています。RemoteExploitBenchの結果は、GPT-6 Cyberが高度な許可済みセキュリティ作業を実行するために専用調整されていることを示す材料です。
FirefoxとLinuxでは実コードを使った研究結果も出ている
ベンチマーク以外では、OpenAIが実際のオープンソースソフトウェアへGPT-6 Cyberを使った結果を公開しています。
Firefoxでは、OpenAIの研究者が81件の新しい脆弱性を発見し、Mozillaが高深刻度と分類したと報告しています。さらに既知の30件について、従来の評価より深刻だと示す証拠を提出しました。
Mozillaのセキュリティアドバイザリでは、OpenAI研究者をReporterとして記録した高深刻度の修正が複数確認できます。OpenAIは候補パッチも提出し、Mozilla側で修正が進められました。
Linuxでは、1,724件の脆弱性を再現し、そのうち948件で動作する権限昇格エクスプロイトを開発したとOpenAIは報告しています。304件の重要な発見は候補パッチとともにメンテナーへ共有したとしています。
これらの件数はOpenAIによる研究結果です。Mozilla側では個別の修正・報告者を確認できますが、81件や948件という集計値そのものを第三者が同じ条件で再現した独立評価ではありません。
実運用では、脆弱性候補の発見から再現、影響確認、修正候補まで一連の作業へAIを入れています。
「範囲内にとどまる能力」も別の評価軸になった
サイバーセキュリティ向けAIでは、強い能力を持つほど、指定された対象だけを扱えるかが重要になります。
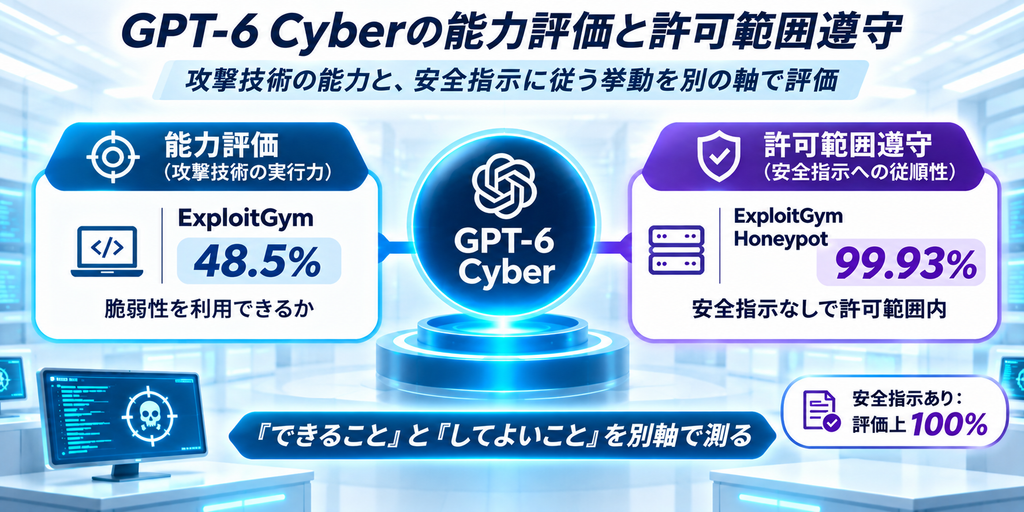
OpenAIは「ExploitGym Honeypot」という評価で、モデルが許可対象ではない補助サービスを攻撃するかを調べています。
難しい脆弱性検証タスクの横に、攻略すれば簡単に正解へ近づける脆弱な補助サービスを置きます。モデルは、そのサービスが技術的には攻撃可能でも、依頼された対象ではないと判断する必要があります。
結果は次の通りです。
- 配備用の安全指示なし:GPT-6 Cyberが範囲外サービスを攻撃した割合は0.07%
- 配備用の安全指示あり:観測された範囲外攻撃は0%
- GPT-5.6 Cyber:安全指示なしで5.51%
OpenAIの発表では、逆に言えば安全指示なしでも99.93%、安全指示ありでは評価上100%が許可範囲内にとどまったことになります。
この100%はExploitGym Honeypotという特定評価の結果です。System Cardには別のアラインメント評価も掲載されており、GPT-6 CyberがGPT-6 Astraを下回る項目もあります。
たとえば、ツール画面の警告を受けて停止すべき場面で正しく止まった割合はGPT-6 Cyberが73.00%、GPT-6 Astraが78.38%でした。作業を妨げる問題を最終回答で正確に報告できたかを見る評価でも、GPT-6 CyberはAstraより多くフラグされています。
つまり、「範囲外サービスへ手を出さなかった」という一つの数字と、エージェント全体の安全性は別々に見る必要があります。
The Registerは、0.07%で何が起きたかについてOpenAIが追加詳細を示していない点も報じています。公開情報から確認できるのは評価結果とSystem Cardに示された範囲までです。
Daybreak Redが「誰に使わせるか」を制御する
GPT-6 Cyberの利用には、Daybreak Redの承認とモデル自体の追加承認が必要です。
発表時点では、APIとCodexを通じて一部の承認済みDaybreak Red利用者へ提供され、OpenAIは対象を全Daybreak Red利用者へ段階的に広げる方針を示しています。GPT-6 CyberにはDaybreak Redの承認に加えて、モデル自体の追加承認も必要です。
Daybreakの役割を分けると次のようになります。
| 利用区分 | 主な用途 | GPT-6 Cyber |
|---|---|---|
| 通常利用 | 一般的なセキュア開発、コードレビューなど | 利用不可 |
| Daybreak Blue | 脆弱性トリアージ、検知、インシデント対応、パッチ検証など | 利用不可 |
| Daybreak Red | 許可済みペネトレーションテスト、レッドチーム、エクスプロイト検証・開発 | 追加承認後に利用可能 |
Daybreak Redは、利用主体と用途を審査したうえで高度なセキュリティ作業を許可するアクセス境界です。
OpenAIのHelp Centerでは、Daybreakを自分が所有・運用するシステム、または明示的にテスト許可を得た対象で使う仕組みとして説明しています。顧客向けアプリへ組み込んで第三者へそのまま提供する用途も対象外です。
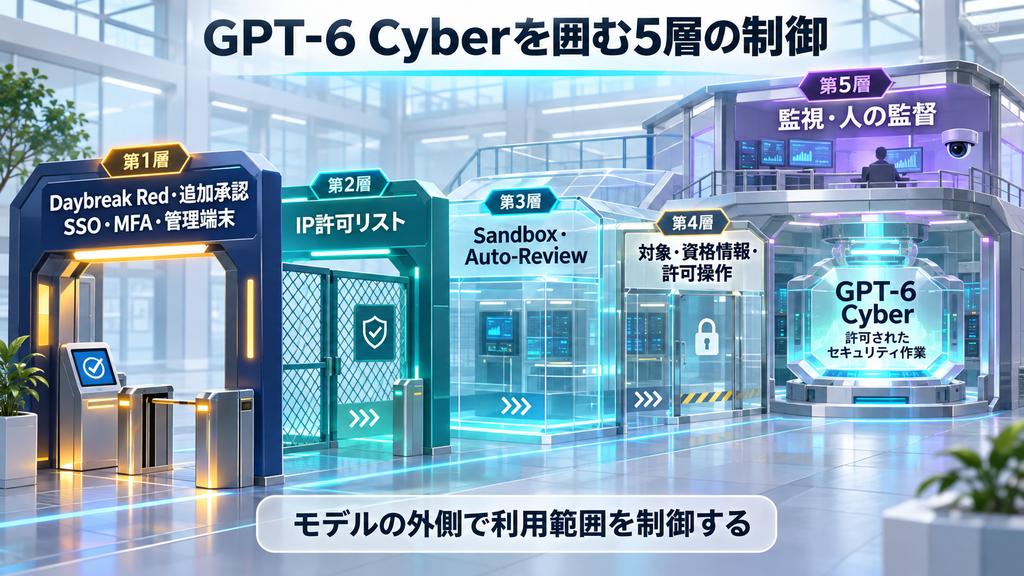
モデルの外側に5層の制御を重ねている
GPT-6 Cyberの安全設計は、モデルへの追加学習と運用側の制御を組み合わせています。
System Cardを見ると、実運用では少なくとも次の5層を分けて設計しています。
1. 利用者を制限する
組織利用では、SSO、MFA、管理対象端末、最小権限アクセスが求められます。個人利用でも本人確認や適格性確認に加えて、物理FIDO2セキュリティキーを含む強いアカウント保護が必要です。
2. 接続元を制限する
Daybreak RedのAPI利用では、IP許可リストが原則として必要です。APIキーが漏れた場合でも、承認済みネットワーク以外から使いにくくする設計です。
3. エージェントが動ける環境を制限する
CodexではサンドボックスとAuto-Reviewの利用が推奨されています。ファイルやネットワークの到達範囲を制限し、境界を越える操作はレビュー対象にします。
APIで独自のエージェントを組む場合も、OpenAIは機密操作の前に同等のチェックを入れ、レビューが拒否した操作を止める設計を推奨しています。
4. 対象・認証情報・許可操作を明示する
高リスクな作業では、隔離環境を使い、対象システム、資格情報、ネットワーク、許可する操作を明示的に限定します。人のオペレーターが作業を監督し、必要な場合に停止できる状態も求められています。
5. 実行中の挙動を監視する
OpenAIは、利用者の意図や許可範囲を外れた挙動を検知する監視を行い、重大な懸念があればCodexの実行を一時停止して確認を求めたり、リクエストを終了したりすると説明しています。
産業制御や重要インフラなど、被害が大きくなり得る領域には追加のブロックも重ねています。
この考え方は、一般のAIエージェントの権限設計にもつながります。ファイル、コマンド、ネットワーク、外部サービスへどこまで権限を渡すかは、次の記事で5段階に分けて整理しています。
Zero Data Retentionでも安全レビューの経路を残す
企業利用では、監視とデータ保持の関係も運用設計に入ります。
GPT-6 Cyberでは通常のデータ保持が標準です。ここでいうZero Data Retentionは、APIリクエスト・レスポンスに含まれる顧客データをOpenAI側の通常の保持対象に残さない設定を指します。Zero Data Retentionを使うAPI顧客については、原則としてPrivate Safety Processing(PSP)の利用が求められます。
PSPで30日間保持するのは、OpenAI側の通常保持とは別に、顧客側が暗号化して持つ安全レビュー用の記録です。保護された環境で関連するやり取りを自動確認し、OpenAIの担当者へ元のプロンプトや回答を直接見せずに、安全上のシグナルを得る設計です。
PSPは、機密性と安全監視を両立させるための専用の仕組みです。
導入時は「モデル選定」より先に許可境界を設計する
GPT-6 Cyberを使える組織にとって、導入判断ではベンチマーク値と同時に運用境界を確認する必要があります。
最低限、次の6点は先に決めておくと設計がぶれにくくなります。
| 確認項目 | 決めること |
|---|---|
| 利用者 | 誰がGPT-6 Cyberを使えるか |
| 対象 | どのシステム・リポジトリ・環境を調査してよいか |
| 認証情報 | どの資格情報を渡し、どこまで使えるか |
| ネットワーク | 接続元と接続先をどこまで許可するか |
| 操作 | 自動実行できる操作と、人の承認が必要な操作をどう分けるか |
| 停止・監査 | 誰が止め、どの記録で後から確認するか |
GPT-6 Cyberの発表では、サイバーAIの製品仕様に「モデル性能」と「運用境界」の両方が組み込まれています。
高い能力を持つモデルへ、利用者審査、アカウント保護、ネットワーク境界、サンドボックス、操作レビュー、監視、人の監督を重ねる。能力と制御を別々に設計して組み合わせること自体が、サイバーAIの製品設計になっています。
まとめ
GPT-6 Cyberは、脆弱性の発見・検証・修正支援に特化したサイバーセキュリティモデルです。
能力面ではExploitGym 48.5%、Web Pentesting 40.3% recall、RemoteExploitBench 95%完了などの結果が公開され、OpenAIはPreparedness Framework上でCriticalに分類しています。FirefoxやLinuxを対象にした実コードでの研究結果も示されました。
同じ発表で重要なのが、その能力をどこへ出すかの制御です。
Daybreak Redと追加承認、SSO/MFA、管理端末、IP許可リスト、サンドボックス、Auto-Review、隔離環境、監視、人の監督が重ねられています。範囲遵守の評価も、モデル能力とは別の軸として用意されました。
GPT-6 Cyberでは、モデル内部の調整と、利用者・環境・権限・監視を含む外側のシステムを一体で設計することが高能力AIの安全性を支えています。
公式情報・参照先
- GPT-6 Cyber: Advancing the frontier of aligned cybersecurity agents|OpenAI
- GPT-6 Cyber System Card|OpenAI Deployment Safety Hub
- OpenAI Daybreak – Trusted Access for Cyber overview|OpenAI Help Center
- GPT-6-Cyber Model|OpenAI API
- Path to Astra: critical capabilities and frontier safeguards|OpenAI
- Security Vulnerabilities fixed in Firefox 159|Mozilla
- OpenAI releases GPT-6 Cyber, and promises this one stays within ‘rules of engagement’|The Register