当サイトではアフィリエイト広告を利用しています。
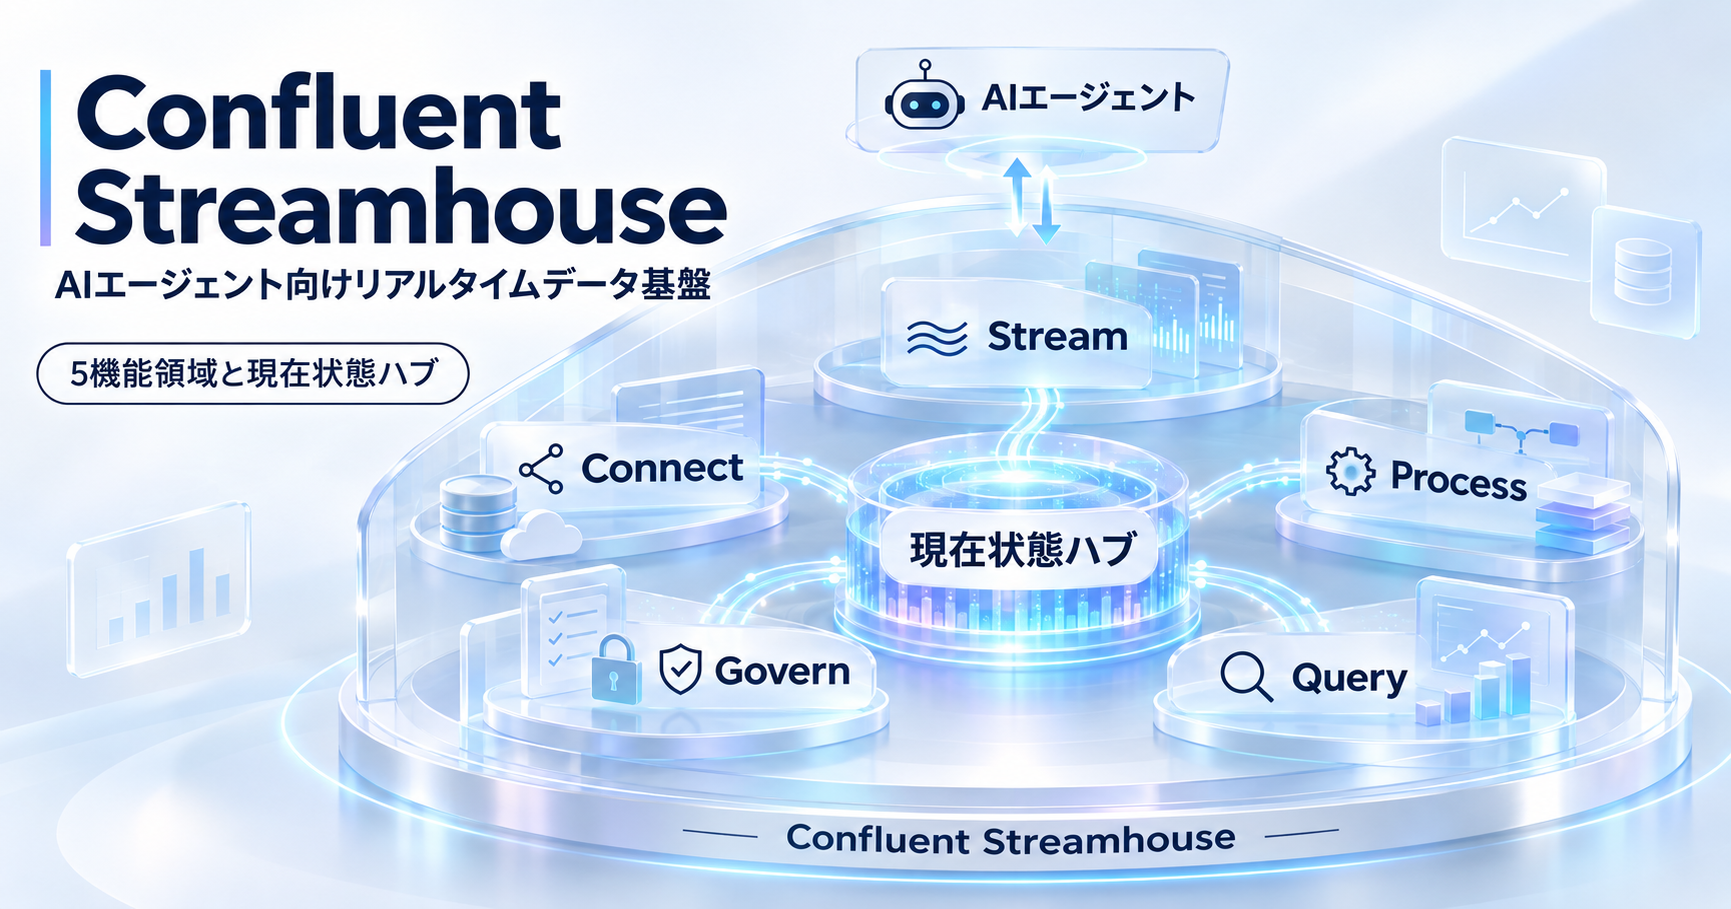
Confluentは2026年11月4日、AIエージェントやアプリケーションが企業の最新状態を参照するための「Streamhouse」構想と、それを支えるData Streaming Platformの新機能を発表しました。
今回のポイントは、Stream、Connect、Process、GovernにQueryを加えて5本柱とし、ストリーミングデータを取得・処理・統制するところから、AIエージェントやアプリへ低遅延で提供するところまでを一つの基盤で扱うことです。Queryの中核となるLightning TablesはAWSで一般提供されました。
Streamhouseは、2026年9月15日にAiven、Confluent、Redpanda、StreamNative、Ververicaが設立したStreamhouse Working Groupが公開定義を管理する、ベンダー中立のアーキテクチャカテゴリです。11月4日のConfluent発表は、その考え方を自社のData Streaming Platformで実装するための製品構成を具体化したものです。
この記事では、Streamhouseが何を解決するのか、Confluentの5本柱とQueryの役割、Lightning TablesとReal-Time Context Engineの提供条件まで分けて解説します。
- Streamhouseは「現在の業務状態」を継続して維持するアーキテクチャ
- AIエージェントではデータの更新時差がそのまま判断差になる
- ConfluentはData Streaming Platformを5本柱に拡張した
- Queryはアプリ・AIエージェント・分析へ別々の読み方を提供する
- Lightning TablesはKafkaの状態を低遅延で読めるようにする
- Real-Time Context EngineはMCPでAIエージェントへ現在状態を渡す
- StreamhouseとLakehouseは「現在状態」と「履歴分析」をつなぐ
- Streamhouse・Query・Lightning Tablesは提供レイヤーが違う
- AIエージェント基盤ではデータ層と実行層を別々に確認する
- 企業がStreamhouse型の基盤を検討するときの確認項目
- まとめ
- 公式情報・参照先
Streamhouseは「現在の業務状態」を継続して維持するアーキテクチャ
Streamhouse Working Groupは、Streamhouseを「企業の現在状態を継続的に利用できるようにし、業務アプリケーション、分析、AIエージェントがその状態を使って動けるデータアーキテクチャ」と定義しています。
構成要素は次の5段階です。
- Capture:業務システムで起きた変化を取得する
- Transport:イベントを継続的に運ぶ
- Transform:複数のイベントを加工・結合し、業務状態へ変換する
- Govern:スキーマ、品質、アクセス権、系譜などを管理する
- Serve:アプリ、AIエージェント、分析基盤が使える形で提供する
この考え方には3つの性質があります。
- Real-time / Always Current:業務イベントが起きるたびに状態を更新する
- Production-native / Mission Critical:本番サービスで使える可用性、正確性、復旧性、追跡性を前提にする
- Decentralized:各システムにあるデータの配置を活かし、分散したまま接続・再利用する
AIエージェントが業務を実行するとき、モデルが高性能でも、参照している在庫、予約、配送、顧客状態が古ければ判断結果は現実とずれます。Streamhouseは、この「判断時点の業務状態」を維持して各利用者へ渡す層を担います。
AIエージェントではデータの更新時差がそのまま判断差になる
Confluentは発表の中で、欠航した航空便の振り替えを例にしています。
航空会社では、航空機の現在地、出発時刻、座席在庫などを別々のシステムが持っています。更新時刻がずれると、各システムだけを見れば成立する旅程でも、航空機の到着が間に合わず実際には接続できない組み合わせが生まれます。
AIエージェントが自律的に再予約まで進める場合、この更新差は予約変更、通知、後続処理まで連鎖します。
Streamhouseでは、航空機の移動、遅延、座席予約といった変化をイベントとして継続取得し、現在の運航状態として更新します。エージェントやアプリは、その同じ状態を参照して判断します。
生成AI向けのデータ基盤では、文書検索や長期知識に加えて、「今この瞬間の業務状態をどの遅延で渡せるか」が設計項目になります。
ConfluentはData Streaming Platformを5本柱に拡張した
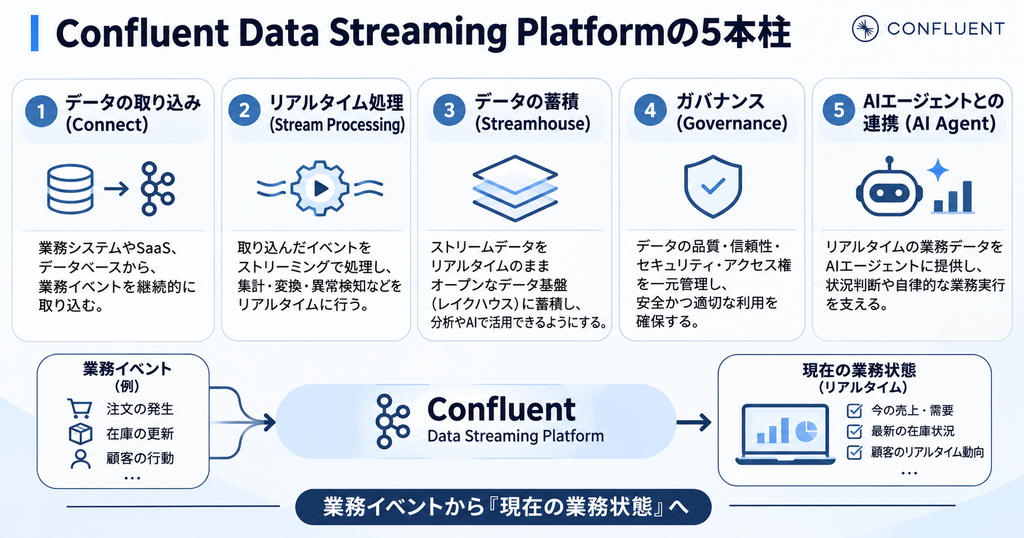
ConfluentはStreamhouseを構築する自社基盤として、Data Streaming Platformを5つの柱で構成しています。
| 柱 | 主な役割 |
|---|---|
| Stream | Apache KafkaとKoraを基盤に、業務イベントを耐久性のあるストリームとして保持・配信する |
| Connect | 150を超えるマネージド/カスタムコネクタで、データベースや業務システムを接続する |
| Process | Apache Flinkでイベントを加工・結合し、現在の業務状態を継続的に作る |
| Govern | スキーマ、カタログ、系譜、品質、暗号化、アクセス制御を管理する |
| Query | 現在の業務状態をアプリ、AIエージェント、分析基盤へ提供する |
11月4日の発表で加わった中心的な変化がQueryを第5の柱として明確にしたことです。
これまでのストリーミング基盤は、「イベントを流す」「加工する」部分が中心でした。Queryは、その結果として維持される現在状態を、利用側が直接読める提供面にします。
Queryはアプリ・AIエージェント・分析へ別々の読み方を提供する
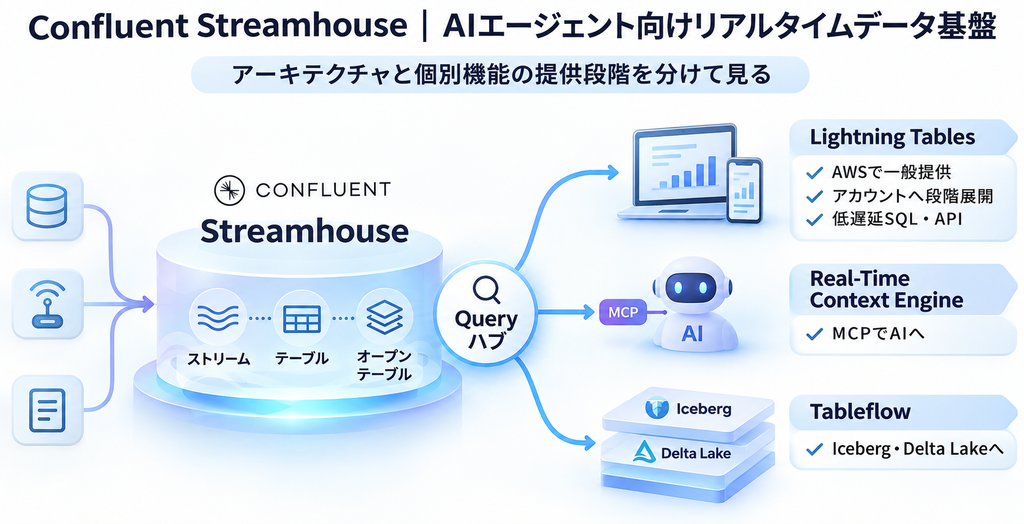
Queryには、利用者ごとに異なる提供経路があります。
| 利用先 | 主な仕組み | 役割 |
|---|---|---|
| 業務アプリケーション | Lightning Tables | SQLやAPIで現在状態を低遅延に読む |
| AIエージェント | Real-Time Context Engine | Model Context Protocol(モデルコンテキストプロトコル、MCP)経由でLightning Tablesの現在状態を読む |
| 分析基盤 | Tableflow | ストリーミングデータをApache IcebergやDelta Lake形式へ公開する |
この構成では、一つのストリームから作った業務状態を、用途ごとに別のパイプラインで再構築する工程を減らせます。
業務アプリは短い応答時間で現在状態を参照し、AIエージェントはMCPを通じて同じ状態へアクセスし、分析基盤はオープンなテーブル形式で履歴分析へつなげます。
Confluent Cloudにはこのほか、現在時点を一度だけ読むSnapshot Queriesと、更新を継続的に受け取るStreaming Queriesもあります。Queryという柱は、現在状態を用途に合わせて提供する複数の読み出し方法をまとめた提供レイヤーです。
Lightning TablesはKafkaの状態を低遅延で読めるようにする
Lightning Tablesは、Apache Kafkaのトピックデータをクエリ向けのテーブルへ継続的にマテリアライズする、フルマネージドの読み取り専用サービング層です。
トピックでLightning Tableを有効にすると、Confluent Cloudが新しいデータを継続的に取り込み、SQLで参照できる状態を維持します。アプリケーション側で別のKafka consumer、Flinkジョブ、サービング用データベースやキャッシュを用意する構成を減らす狙いがあります。
発表時点の主な提供条件は次のとおりです。
| 項目 | 発表・ドキュメントで確認できる内容 |
|---|---|
| 提供段階 | AWSで一般提供(GA) |
| 対応クラスター | AWS上のBasic、Standard、Enterprise、Dedicated |
| 必要なスキーマ | Avro、Protobuf、JSON Schema |
| 主な問い合わせ | キー検索、条件フィルター、範囲検索、並び替え、件数制限 |
| インターフェース | Cloud Console、HTTP API、MCP、CLI、JDBC |
| データ更新 | Kafkaトピックへ新しいデータが到着してから100ミリ秒以内にテーブルを更新するとドキュメントで説明 |
| クエリ性能 | Confluent内部テストで10〜100ミリ秒、1,000件/秒超 |
| SQLの性質 | 読み取り専用 |
性能値はConfluentの内部テスト値です。実際の遅延や処理量は構成とワークロードで変わります。
現在のLightning Tables SQLは、低遅延の参照用途に範囲を絞っています。集約関数、GROUP BY、JOIN、サブクエリ、UNION、DDL、INSERT・UPDATE・DELETEはサポート対象外です。複雑な履歴分析にはSnapshot Queriesなど別の問い合わせ方法を使います。
一般提供の発表と同時に、ConfluentのドキュメントではLightning Tablesをアカウントへ段階的に展開していると案内しています。AWSの対応リージョン・対応クラスターであっても、機能がまだ表示されないアカウントがあります。
Real-Time Context EngineはMCPでAIエージェントへ現在状態を渡す
AIエージェント向けの入口がReal-Time Context Engineです。
Real-Time Context Engineは、Lightning Tablesに対するMCPのインターフェースとして動きます。エージェントはMCP経由で、次の流れでデータを参照できます。
- 利用可能なトピックを確認する
- トピックのスキーマを確認する
- 必要な条件でデータを問い合わせる
Confluentのドキュメントでは、MCPツールとしてlistTopics、getMetadata、queryDataが公開されています。
アクセス制御も既存のConfluent Cloudの権限へ接続されています。AIエージェントがMCPから問い合わせる場合も、Kafka側で読み取り権限を持つトピックだけがデータ参照の対象になります。
これにより、AIエージェントへ最新状態を渡す経路と、トピック単位のアクセス制御を同じデータ基盤上で扱えます。
StreamhouseとLakehouseは「現在状態」と「履歴分析」をつなぐ
Streamhouse Working Groupは、Streamhouseをベンダー中立のカテゴリとして公開しています。Confluentの実装も、既存のデータウェアハウスやLakehouseと接続して使う設計です。
役割を時間軸で見ると違いが明確です。
- Streamhouse:イベントが起きるたびに現在状態を更新し、業務アプリやAIエージェントの判断へ使う
- Lakehouse:蓄積した履歴を大規模に分析し、レポート、探索、学習などへ使う
ConfluentのTableflowは、KafkaのストリーミングデータをApache IcebergやDelta Lakeのテーブルとして公開し、Lakehouse側へつなぎます。Lightning Tablesはミリ秒級の参照を狙い、Tableflowは分析基盤向けのオープンテーブルを作る役割です。
つまり企業側は、「今の状態を読む経路」と「長期履歴を分析する経路」を同じストリームから派生させられます。
Streamhouse・Query・Lightning Tablesは提供レイヤーが違う
今回の発表を読むときは、名称ごとの位置付けを分けると提供状況を判断できます。
| 名称 | 位置付け | 2026年11月6日時点の状態 |
|---|---|---|
| Streamhouse | ベンダー中立のデータアーキテクチャカテゴリ | 2026年9月15日にWorking Groupが公開定義を発表 |
| ConfluentのStreamhouse構成 | Data Streaming PlatformでStreamhouseを構築する製品構成 | 2026年11月4日に新機能群を発表 |
| Query | Confluent Data Streaming Platformの第5の柱 | Lightning Tables、Real-Time Context Engine、Tableflowなどを含む提供面 |
| Lightning Tables | Kafkaの現在状態を低遅延で読むサービング層 | AWSで一般提供、アカウントへ段階展開 |
| Real-Time Context Engine | Lightning TablesをAIエージェントへMCPで公開する入口 | 一般提供 |
| Tableflow | ストリームをIceberg・Delta Lakeテーブルへ公開する仕組み | Queryから分析基盤へ渡す経路として提供 |
今回の発表は、アーキテクチャ、プラットフォームの柱、個別機能の提供段階に分けると、実際に利用できる範囲を判断できます。
AIエージェント基盤ではデータ層と実行層を別々に確認する
Streamhouseが主に担うのは、AIエージェントが参照する業務状態を継続更新し、ガバナンスされた形で提供するデータ層です。
企業でエージェントを実行するには、さらに次の設計が必要です。
- エージェントが誰の権限で動くか
- 読み取りと書き込みの範囲をどう分けるか
- 重要操作をどこで人へ戻すか
- 実行履歴をどこまで監査できるか
- データ更新の遅延とエージェント実行のタイミングをどう合わせるか
常時稼働AIエージェントの権限・監査・承認設計は、Snowflake CoCo・CoWork Botsの記事で詳しく扱っています。
Streamhouseのようなデータ層と、エージェント実行・承認の層を組み合わせることで、「最新の状態を読めること」と「その状態を使って安全に行動すること」を別々に設計できます。
企業がStreamhouse型の基盤を検討するときの確認項目
Confluentの発表から、AIエージェント向けリアルタイムデータ基盤で見るべき項目は次の5つにまとめられます。
| 確認項目 | 確認する内容 |
|---|---|
| データ鮮度 | 業務イベント発生からエージェントが読めるまで何秒・何分か |
| 状態の作り方 | どのイベントを結合・加工して「現在状態」にするか |
| ガバナンス | スキーマ、品質、系譜、アクセス権をどこで管理するか |
| 提供経路 | アプリ、AIエージェント、分析基盤へどのインターフェースで渡すか |
| 提供段階 | アーキテクチャ構想、GA、段階展開、対応クラウドを区別できるか |
AIエージェントの判断を設計するときは、入力される業務状態の鮮度と一貫性が確認項目になります。更新時刻がずれたデータを組み合わせると、現実には成立しない判断につながるためです。
Streamhouseの価値は、リアルタイム処理そのものより、業務イベントから現在状態を作り、統制し、利用側へ継続的に提供する一連の設計を一つのアーキテクチャとして扱うことにあります。
まとめ
Confluentが2026年11月4日に発表したStreamhouse関連の新機能は、AIエージェントやアプリケーションが企業の最新状態を参照するためのデータ基盤を具体化したものです。
Streamhouseは、企業の現在状態を継続的に取得・変換・統制・提供するベンダー中立のアーキテクチャカテゴリです。Confluentは自社Data Streaming PlatformをStream、Connect、Process、Govern、Queryの5本柱で構成し、Queryを現在状態の提供面として加えました。
Lightning TablesはAWSで一般提供され、Kafkaのデータを読み取り専用テーブルとして低遅延に参照できます。Real-Time Context Engineを通じてMCPからAIエージェントへ同じ状態を渡せるため、リアルタイムの業務コンテキストをAIの判断材料へ接続できます。
導入を評価するときは、Streamhouseというアーキテクチャ、Queryというプラットフォームの柱、Lightning Tablesなど個別機能の提供段階を分けて確認すると、現在使える範囲と設計上の役割を判断できます。
公式情報・参照先
- Confluent Introduces Its Streamhouse Architecture to Power AI With Real-Time Business Context|Confluent
- Your Business, Always Current. Streamhouse – The Data Architecture for the Age of AI.|Confluent
- What’s New in Q4’26 Confluent Data Streaming Platform|Confluent
- Streamhouse|Streamhouse Working Group
- Lightning Tables in Confluent Cloud|Confluent Documentation
- Lightning Tables Support and Limitations|Confluent Documentation
- Real-Time Context Engine in Confluent Cloud|Confluent Documentation
- Confluent advances evolution toward becoming AI streamhouse|TechTarget