当サイトではアフィリエイト広告を利用しています。
今日のAIニュース5選
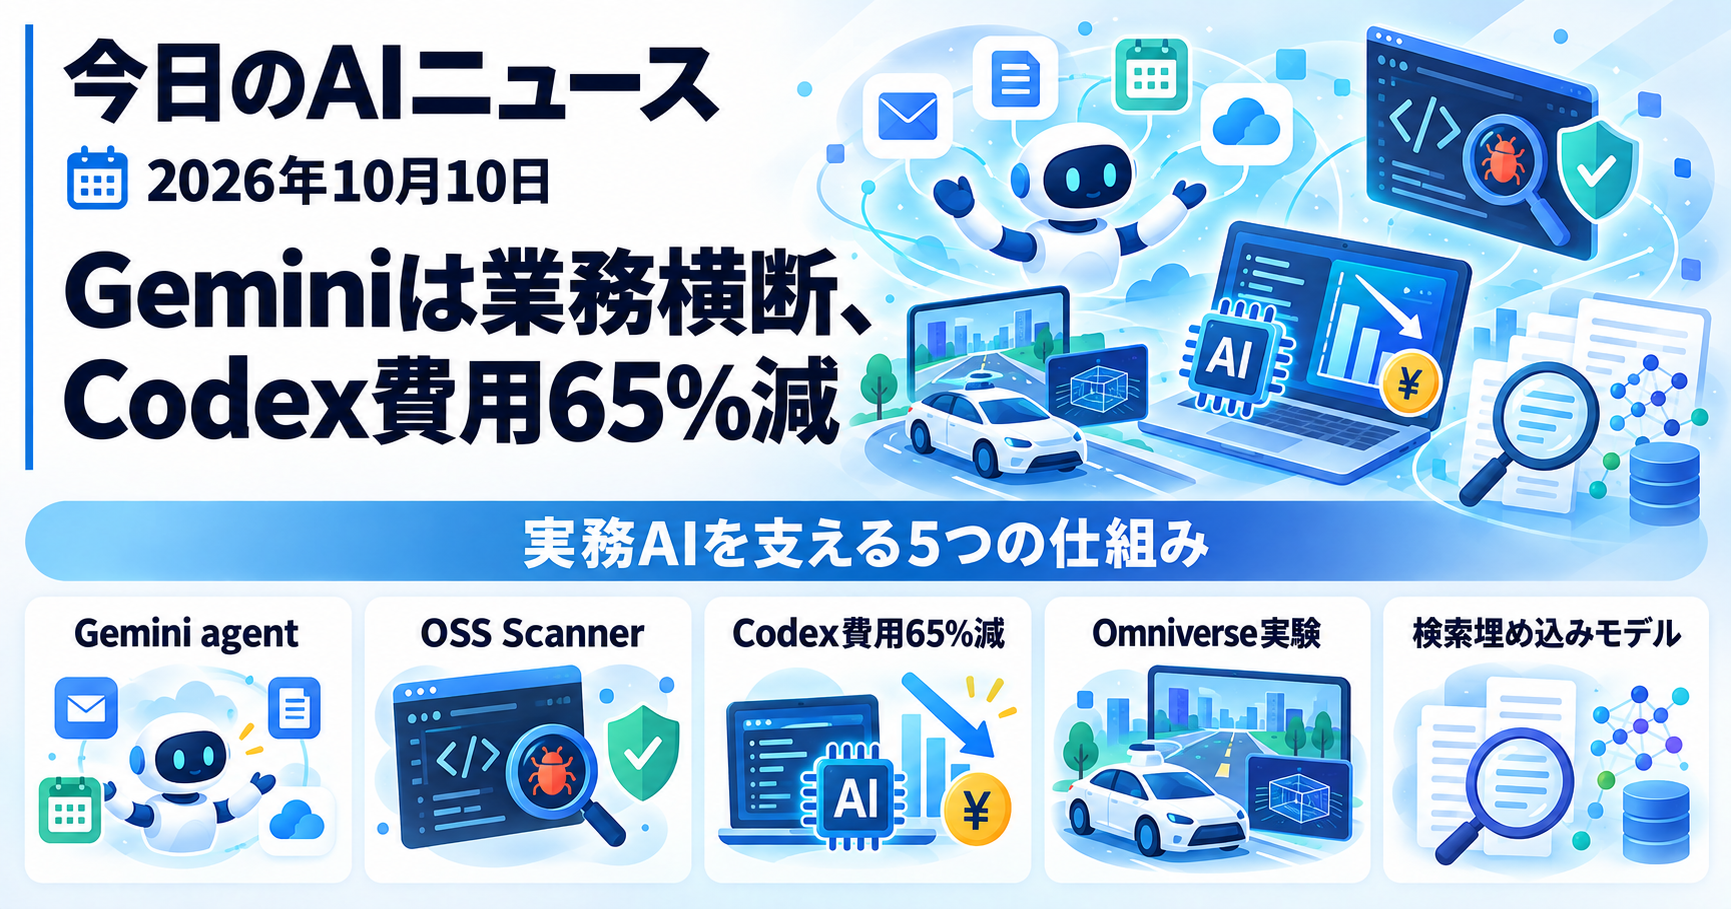
生成AIを現場で使う動きが広がる中、注目するべきなのはモデルの性能だけではありません。社内の仕事をどうつなぐか、費用をどう抑えるか、結果をどう検証するかという部分まで変化しています。
Google Cloudは、メール、資料、開発環境をまたいで仕事を進める企業向けの「Gemini agent」を発表しました。Anthropicは、重要インフラの防御支援と、オープンソースの安全確認を無料で行う「OSS Scanner」を含む新しい取り組みを始めています。
開発現場では、日本のLegalOn TechnologiesがCodexのモデルと予算を使い分け、推定日次費用を約65%削減した事例が公開されました。NVIDIAは、ロボットや自動運転の仮想実験をエージェントで組み立てる方法を紹介しています。
検索分野ではPerplexityが、文書の登録に大型モデル、問い合わせには小型モデルを使える「pplx-embed-v2-late」を公開しました。
今日はこの5本から、仕事の入口、安全確認、開発費用、物理世界の検証、情報検索という別々の部分で、AIを使うための仕組みがどう具体化しているかを見ていきます。
1. Google Cloud「Gemini agent」発表 業務アプリを横断し、長時間の仕事も引き継ぐ
Google Cloudは10月8日、「Gemini at Work 2026」で企業向けの統合型AIエージェント「Gemini agent」を発表しました。
このGeminiは新しい言語モデル単体の名前ではなく、利用者の目的を受け取り、必要なモデルやツールを選んで仕事を進めるエージェントです。GmailやGoogleドキュメント、スプレッドシート、カレンダーなどのWorkspaceに加え、社内の業務システムや開発環境とも接続する構想です。
たとえば、メールと予定表から会議を調整し、社内資料を調べ、分析結果を表にまとめてスライドへ反映する流れが想定されています。処理はクラウドで続くため、PCやスマートフォンを切り替えても作業の文脈を引き継げます。
大きな特徴が、仕事を分担するエージェントの扱いです。必要な作業ごとに短期間働くサブエージェントを作るほか、部署で共有する「同僚エージェント」を用意できます。同僚エージェントには独立したメールアドレスなどを割り当て、利用者のアカウントを借りるのではなく、そのエージェント自身の権限と履歴を管理する設計です。
モデルの選択も固定ではありません。GoogleはGemini系とAnthropicのClaude系を仕事に合わせて使い分けられることを示し、利用費用の制御や監査ログの整備も打ち出しています。
ただし、今回の統合型Gemini agentは企業向けのプライベートプレビュー段階です。発表されたすべての機能が一般のGoogleアカウントですぐ使えるわけではありません。
前日のChatGPTの更新は、質問内容に合わせた画面の表示方法が中心でした。今回のGemini agentは、その外側にある複数の仕事や社内システムをどう一つにつなぐかに重点を置いています。
2. Anthropic「Cyber Mission」開始 OSS Scannerでオープンソースを無料検査
Anthropicは10月8日、重要なソフトウェアや社会インフラを守る長期的な取り組み「Anthropic Cyber Mission」を発表しました。
最初に力を入れるのは、電力、上下水道、交通などの重要インフラと、企業システムの土台になっているオープンソースソフトウェアです。
重要インフラ向けには「Critical Infrastructure Defense Program(CIDP)」を設け、高性能モデル、現場の技術者、脅威調査を組み合わせて防御側を支援します。一方、ソフトウェア開発者にとって身近なのが、新しい「OSS Scanner」です。
OSS Scannerでは、参加を希望するオープンソースプロジェクトの管理者が登録すると、Anthropicの高性能モデルが定期的にコードを調べ、問題の候補を報告します。参加プロジェクトには無料で提供されます。
報告書には、問題の内容に加えて確認方法や修正案も含まれます。従来は人が確認してから開発者に届けていた情報を、早い段階で共有する狙いがあります。
一方、報告内容をそのまま確定的な結果として扱うことはできません。OSS Scannerはモデルによる報告を人間が個別確認する前に届ける方式なので、重複報告や誤った重要度判定が混じる可能性があります。
Anthropicは初期の検証で、48プロジェクトに関する重要度の高い報告97件を専門家が確認し、85件が同社の脆弱性報告基準を満たしたと説明しています。ただし、これは限定された検証結果であり、すべての利用時に同じ正確さが保証されるわけではありません。
今回のサービスは、すべての公開リポジトリを無条件に調べるものではなく、参加申請と対象の審査があります。最終的に報告を確かめ、修正を取り込む仕事は開発者側に残ります。
10月8日分で取り上げた「Cyber Verification Program」は、高度なサイバー能力を誰に使わせるかというアクセス管理の発表でした。今回のCyber Missionは、その能力を防御現場へ届ける具体的な支援策です。
3. LegalOn、Codexの推定日次費用を約65%削減 モデルと予算を仕事別に使い分け
OpenAIは10月8日、日本のLegalOn TechnologiesによるCodexの運用事例を公開しました。
LegalOnは開発者へ高性能なモデルを広く使えるようにしてきました。しかし、簡単な仕事にも最も高性能なモデルを使い続けると、予算が膨らみます。かといって利用を一律に制限すれば、開発の速さを損なうおそれがあります。
そこで同社が進めたのが、仕事の難しさに応じたモデルの役割分担です。
要件が明確なコード実装や簡単な処理には「GPT-6 Luna」、一般的な設計・分析・文書作成には「GPT-6.1 Sol」、難しい設計や複数エージェントをまとめる仕事には「GPT-6 Astra」を使う方針を整理しました。
さらに、Fastモードは原則として制限し、必要な場合だけ利用を認める運用へ変更。部署や利用者単位で予算を設定し、既存事業と新規事業では予算の使い方を変えています。
OpenAIが掲載した事例では、こうした対策によって従来のGPT-5.5利用時と比べた推定日次費用が約65%減少したとしています。既存事業ではおよそ20%の費用効率改善を求める一方、新規事業には積極的にAIを使える予算を配分しました。
注意したいのは、この65%がLegalOnの利用条件による推定日次費用の比較だということです。単にLunaへ切り替えるだけで誰でも65%安くなるわけではありません。モデル選択、Fastモードの扱い、予算の配分が組み合わさった結果です。
同社はさらに、AIによる作業時間の短縮だけでなく、一つの機能を公開するまでにかかった費用と、顧客へ届けた価値を結び付けて評価する仕組みも整備しています。
Codexを多く使う開発チームにとっては、利用量を減らすことそのものより、難しい仕事には強いモデル、日々の処理には軽いモデルという使い分けを組織で共有した点が参考になります。なお、これは新機能の発表ではなく、既存のCodexを使った企業の実践事例です。
4. NVIDIA、Omniverseの開発例公開 ロボットや自動運転の仮想実験をエージェントで構築
NVIDIAは10月8日、フロンティアAIモデルとシミュレーション基盤「Omniverse」を組み合わせた複数の開発例を紹介しました。
シミュレーションは、現実の機械や環境を仮想空間に再現し、動作を事前に試すための技術です。ロボットや自動運転の研究では、実機だけで試験を繰り返すと費用や安全面の制約があります。
今回の実演では、開発者が自然な言葉でAIエージェントへ指示し、Omniverseの物理計算、描画、センサーの機能を組み合わせて検証用アプリを作っています。
たとえば倉庫向けの実演では、GPT-6 Astraを使ってヒューマノイドロボットを操作するシミュレーターを構築しました。倉庫の空間やロボットの動き、物理的な挙動をつないで、一人称・三人称の視点から試せるようにしています。
自動運転の実演では、サンフランシスコの道路を基にした仮想環境を用意し、交通状況やセンサーの条件を変えたとき、モデルの判断がどう変化するかを比較できるようにしました。
さらに、実際のカメラやLiDAR(レーザーで周囲までの距離を測るセンサー)の記録とシミュレーション結果を比較し、差を手がかりに仮想環境を修正する事例もあります。
ロボットの運動を試す一つの実験では、障害物を越える動作を100回試して64回成功したとしています。ただし、これは仮想環境での個別実験の値で、実物のロボットが現場でも同じ結果になるという意味ではありません。
AIが指示一つで完成品を必ず作れるという話でもありません。開発者が結果を確認し、修正を重ねる工程の中で、AIがコード生成やシミュレーション構築を支援しています。
今回の発表は、新しいモデルの発売ではなく開発事例の公開です。文章や画像の生成だけでなく、「現実で試す前の実験環境を作る仕事」にもAIの利用範囲が広がっています。
5. Perplexity「pplx-embed-v2-late」公開 文書は大型、検索は小型モデルで処理
Perplexityは10月7日、文章や画像、文書ページを検索するための新しい埋め込みモデル「pplx-embed-v2-late」を公開しました。
埋め込みモデルは、文章などの内容を数値に変換し、質問と関係の深い情報を探すためのものです。企業内検索や、資料を探してからAIが回答するRAGなどで使われます。
今回は0.6Bと9Bの2種類が公開されました。どちらも文章による回答を自由に生成するモデルではなく、検索対象を見つけるための専用モデルです。
特徴は、2つのモデルが同じ埋め込み空間を共有していることです。資料を登録するときは大きな9Bモデルを使い、利用者が質問するたびの処理には小さな0.6Bモデルを使う構成が可能です。
資料の登録処理は一度だけ、検索は毎日何度も行うというシステムなら、品質と問い合わせ時の負荷を分けて考えられます。
また、文書全体を一つの数値のかたまりで表すのではなく、単語や文章の構成要素ごとに128次元のベクトルを作り、質問と細かく照らし合わせる「Late Interaction」という方式を採っています。長い文書の一部にある関連情報を拾うための工夫です。
モデルは文章だけでなく画像や画像化された文書ページの検索にも対応します。ただし、公開されている実装ではテキストと画像は別々に処理し、一つの入力で両方を混ぜる使い方には対応していません。
モデルウェイトはHugging Faceで公開され、ライセンスはMITです。手元や自社サーバーで運用する選択肢がありますが、検索の精度、必要なメモリ量、インデックスの容量は実際のデータで確認する必要があります。
公開された性能値はPerplexity側の評価条件によるものです。検索モデルの精度が高くても、最終的なAIの回答が常に正しくなるとは限りません。
大きなモデルで資料を準備し、小さなモデルで何度も検索するという設計は、検索を大量に使うサービスで特に意味を持ちそうです。
まとめ
今日の5本を見ると、生成AIの実用化にはモデルの性能とは別に、いくつもの仕組みが必要なことが分かります。
Google CloudのGemini agentは、社内の仕事をまたいで処理を進める入口をまとめようとしています。AnthropicのOSS Scannerは、その裏側で利用されるオープンソースの安全確認を速くします。
LegalOnは、Codexをどの仕事に使うかを見直し、推定日次費用を約65%減らしました。NVIDIAは、ロボットや自動運転の仮想実験をAIと組み合わせて作る方法を示しています。
Perplexityは、資料を登録する作業と検索する作業で異なるサイズのモデルを選べるようにしました。
仕事をどうつなぐか、どこで人が確認するか、費用をどこで抑えるか、実行結果をどう試すか、必要な情報をどう探すか。こうした使い方の設計が、日常的に役立つAIの完成度を左右するようになっています。
今日の注目アイテム
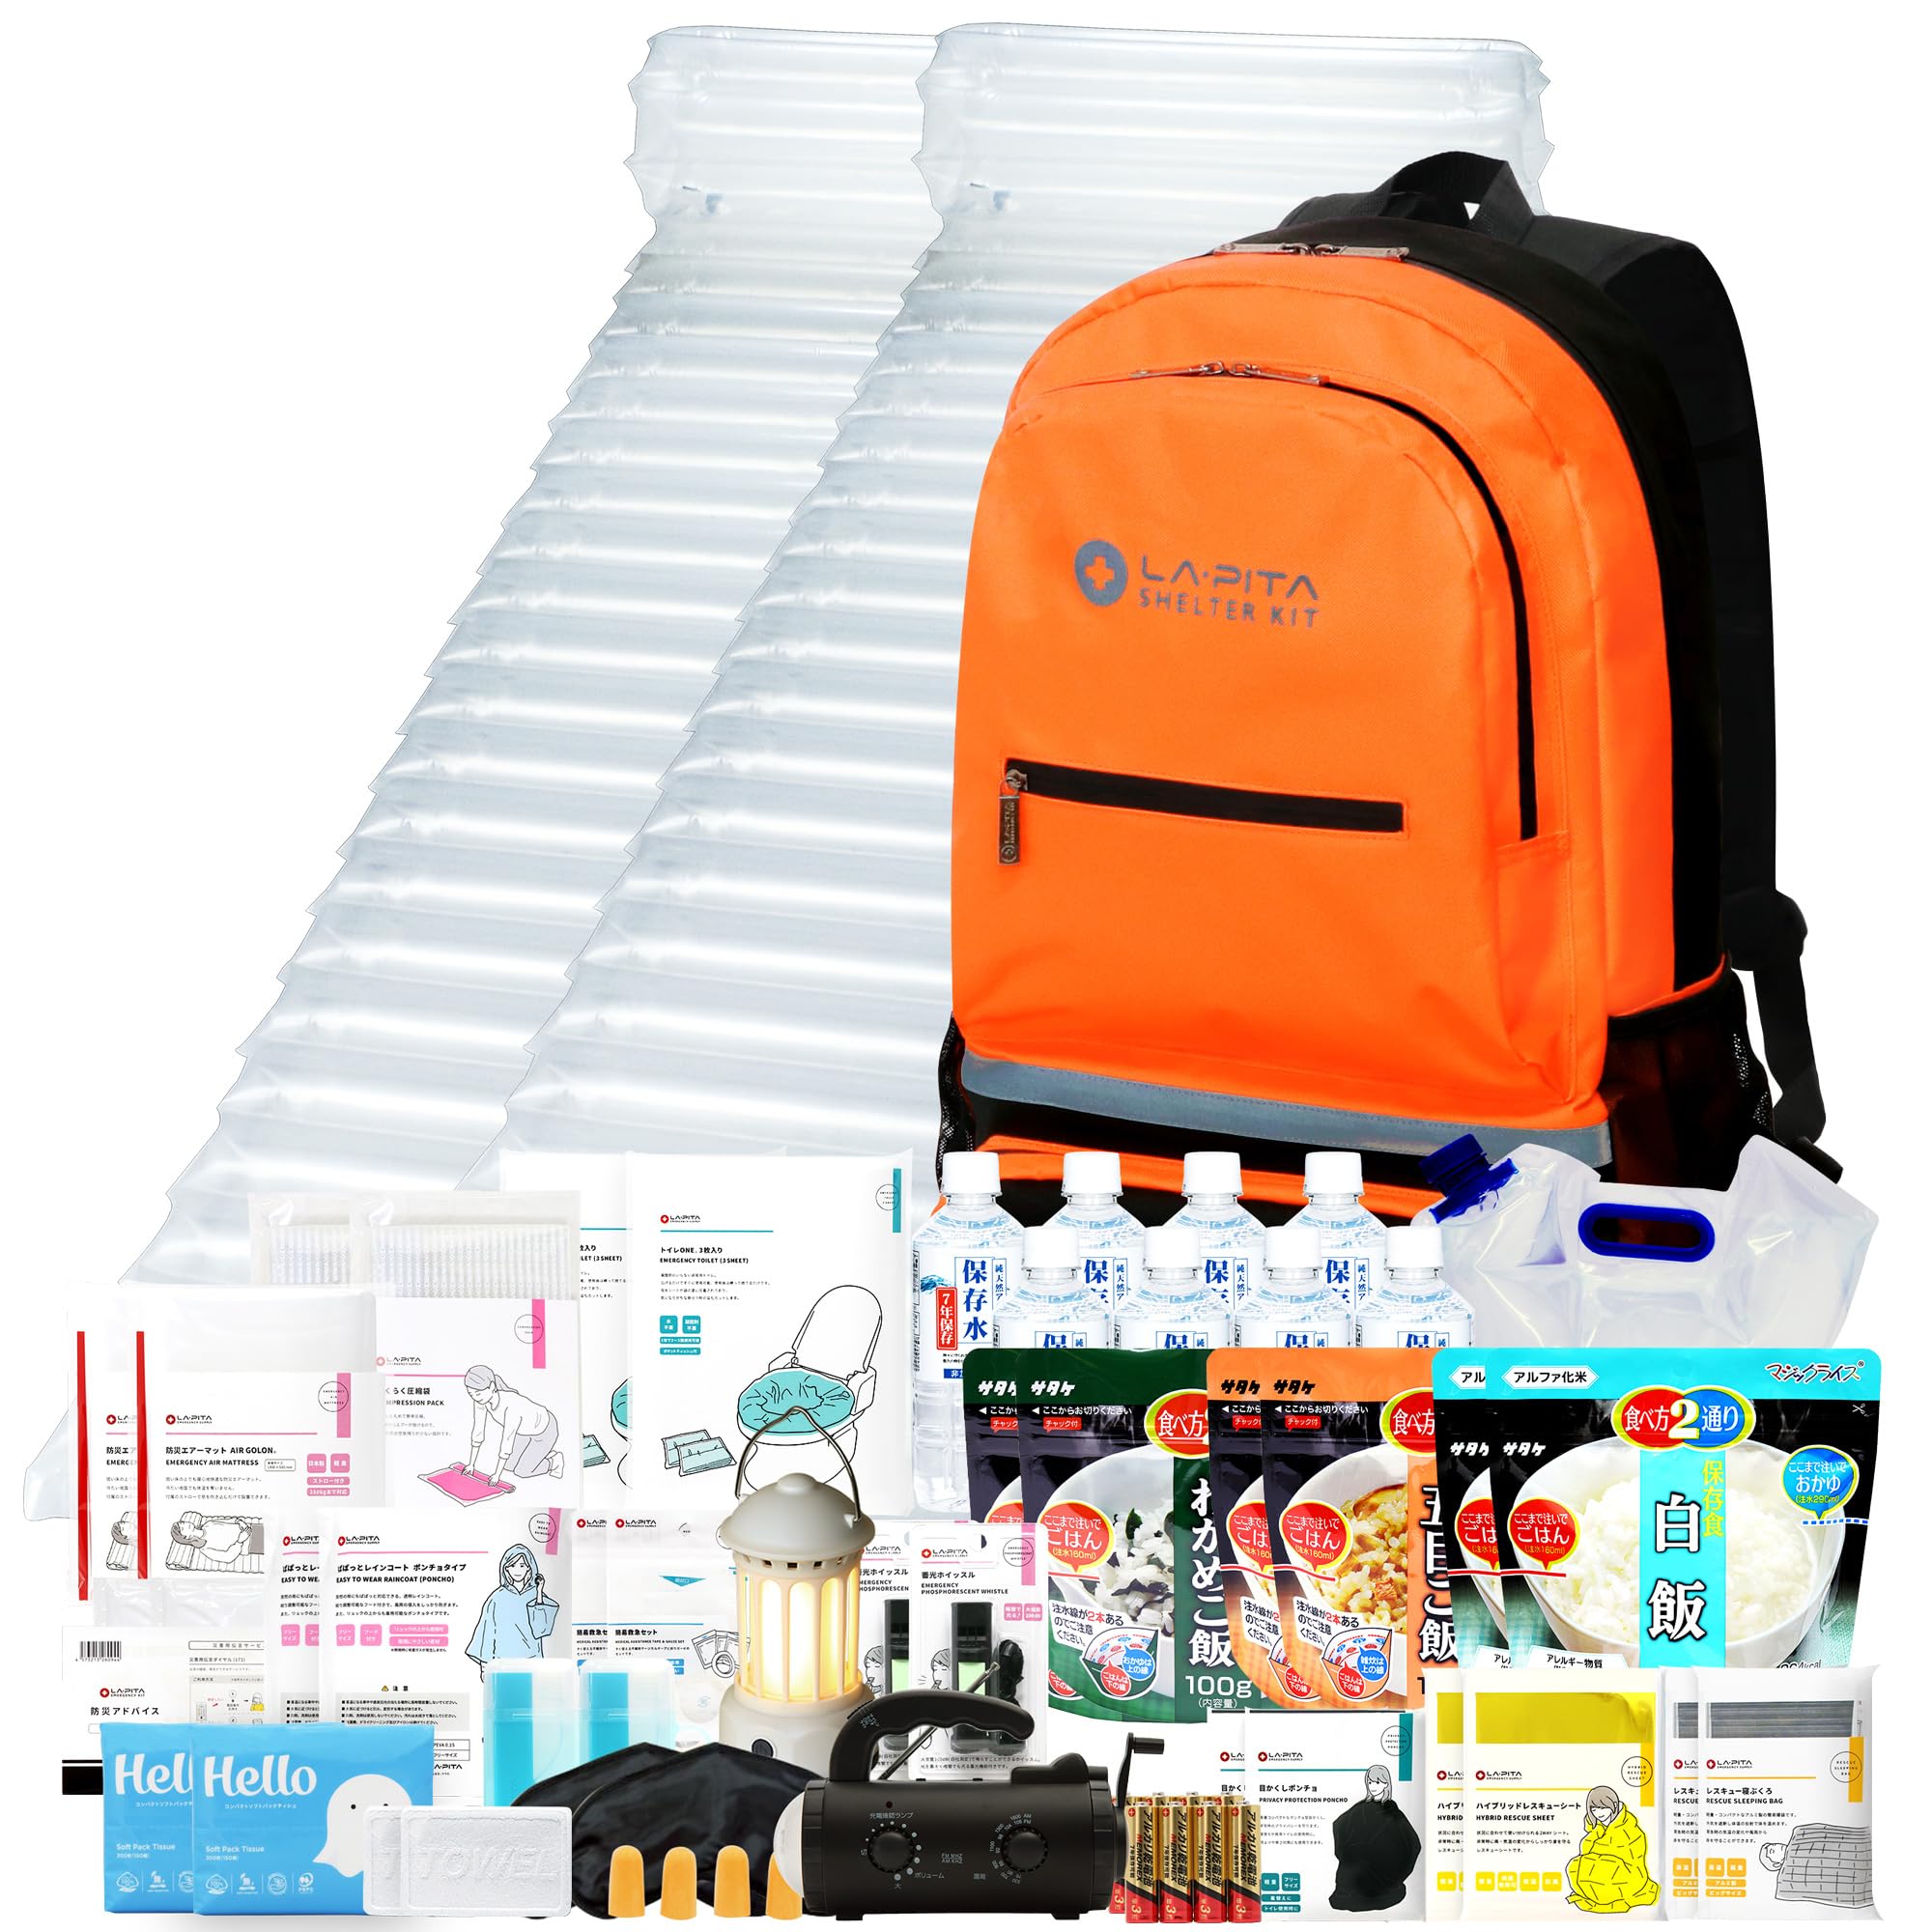

LA・PITAのSHELTERプレミアムは、2人用のオレンジ色の防災リュックセットです。 非常用トイレや国産米の非常食、日本製保存水を含む災害対策用品がまとめられています。
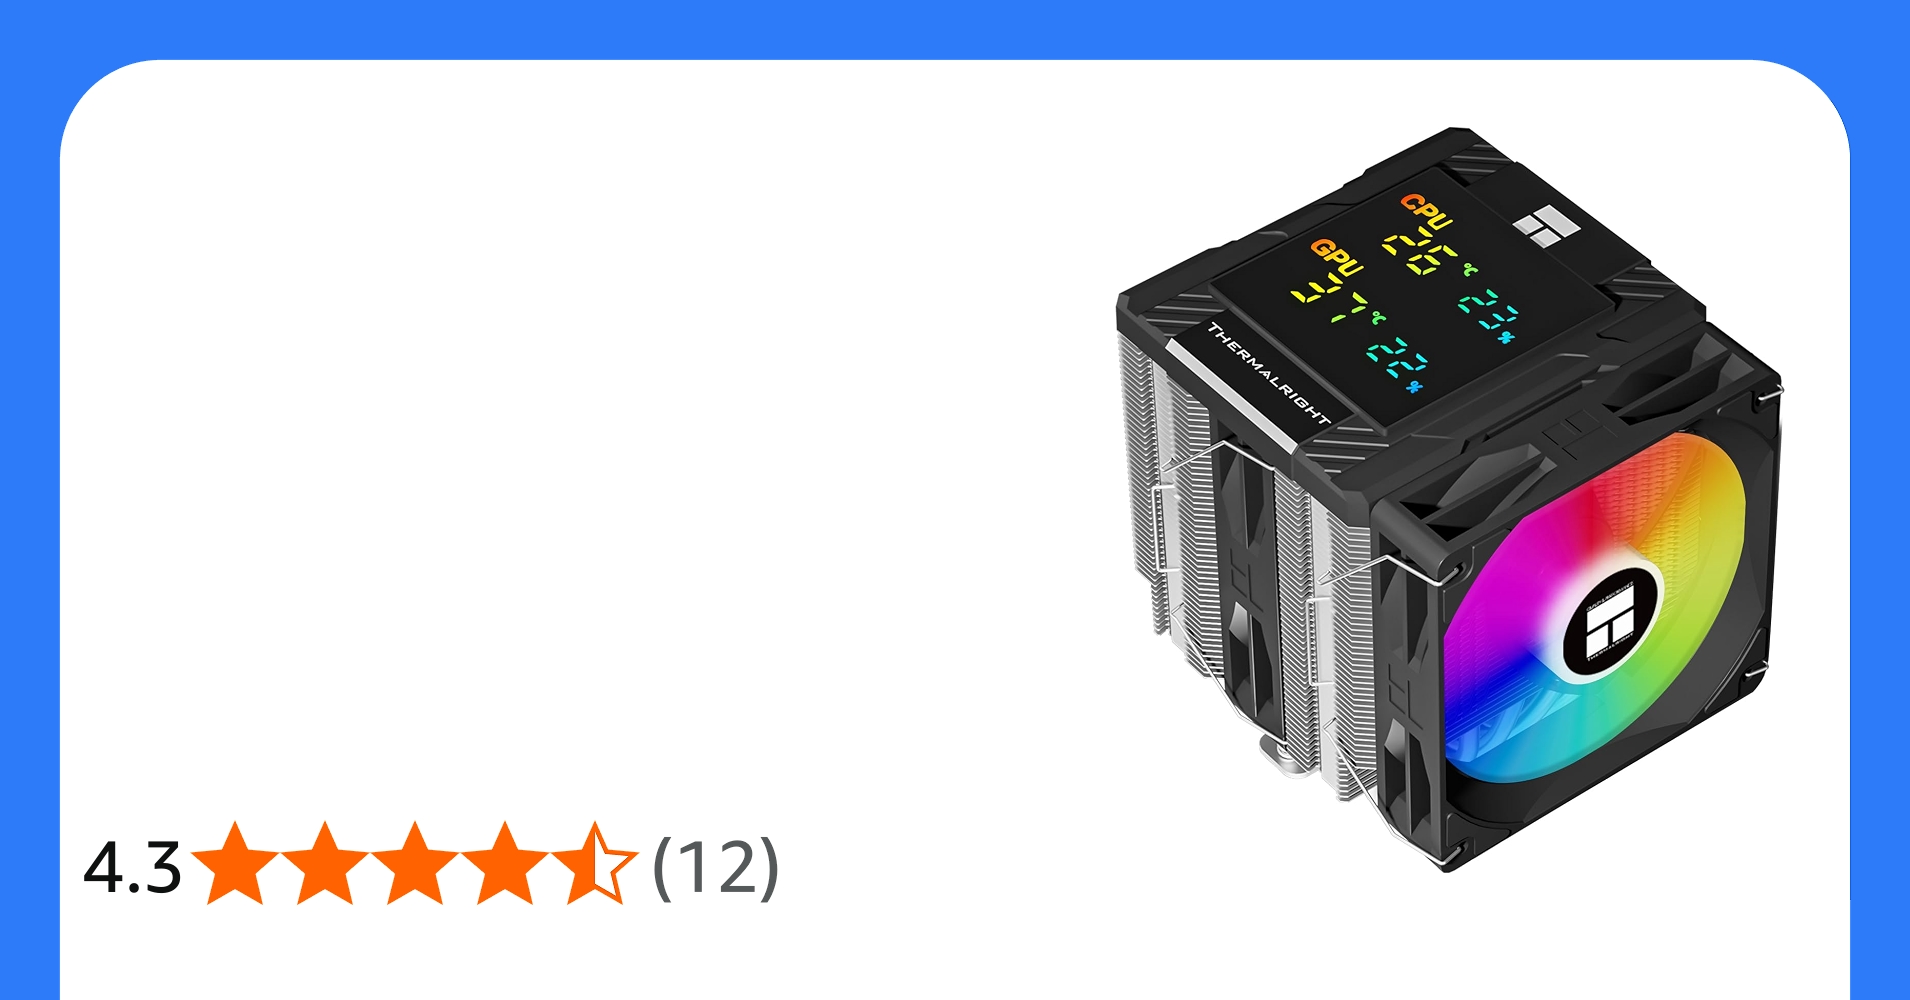

6本の純銅ヒートパイプとデュアル120mm PWMファンを備えたツインタワー型CPUクーラーです。デジタルスクリーンでCPU・GPUの温度などを確認できるため、冷却性能と状態表示を自作PCに取り入れたい方に選びやすいモデルです。
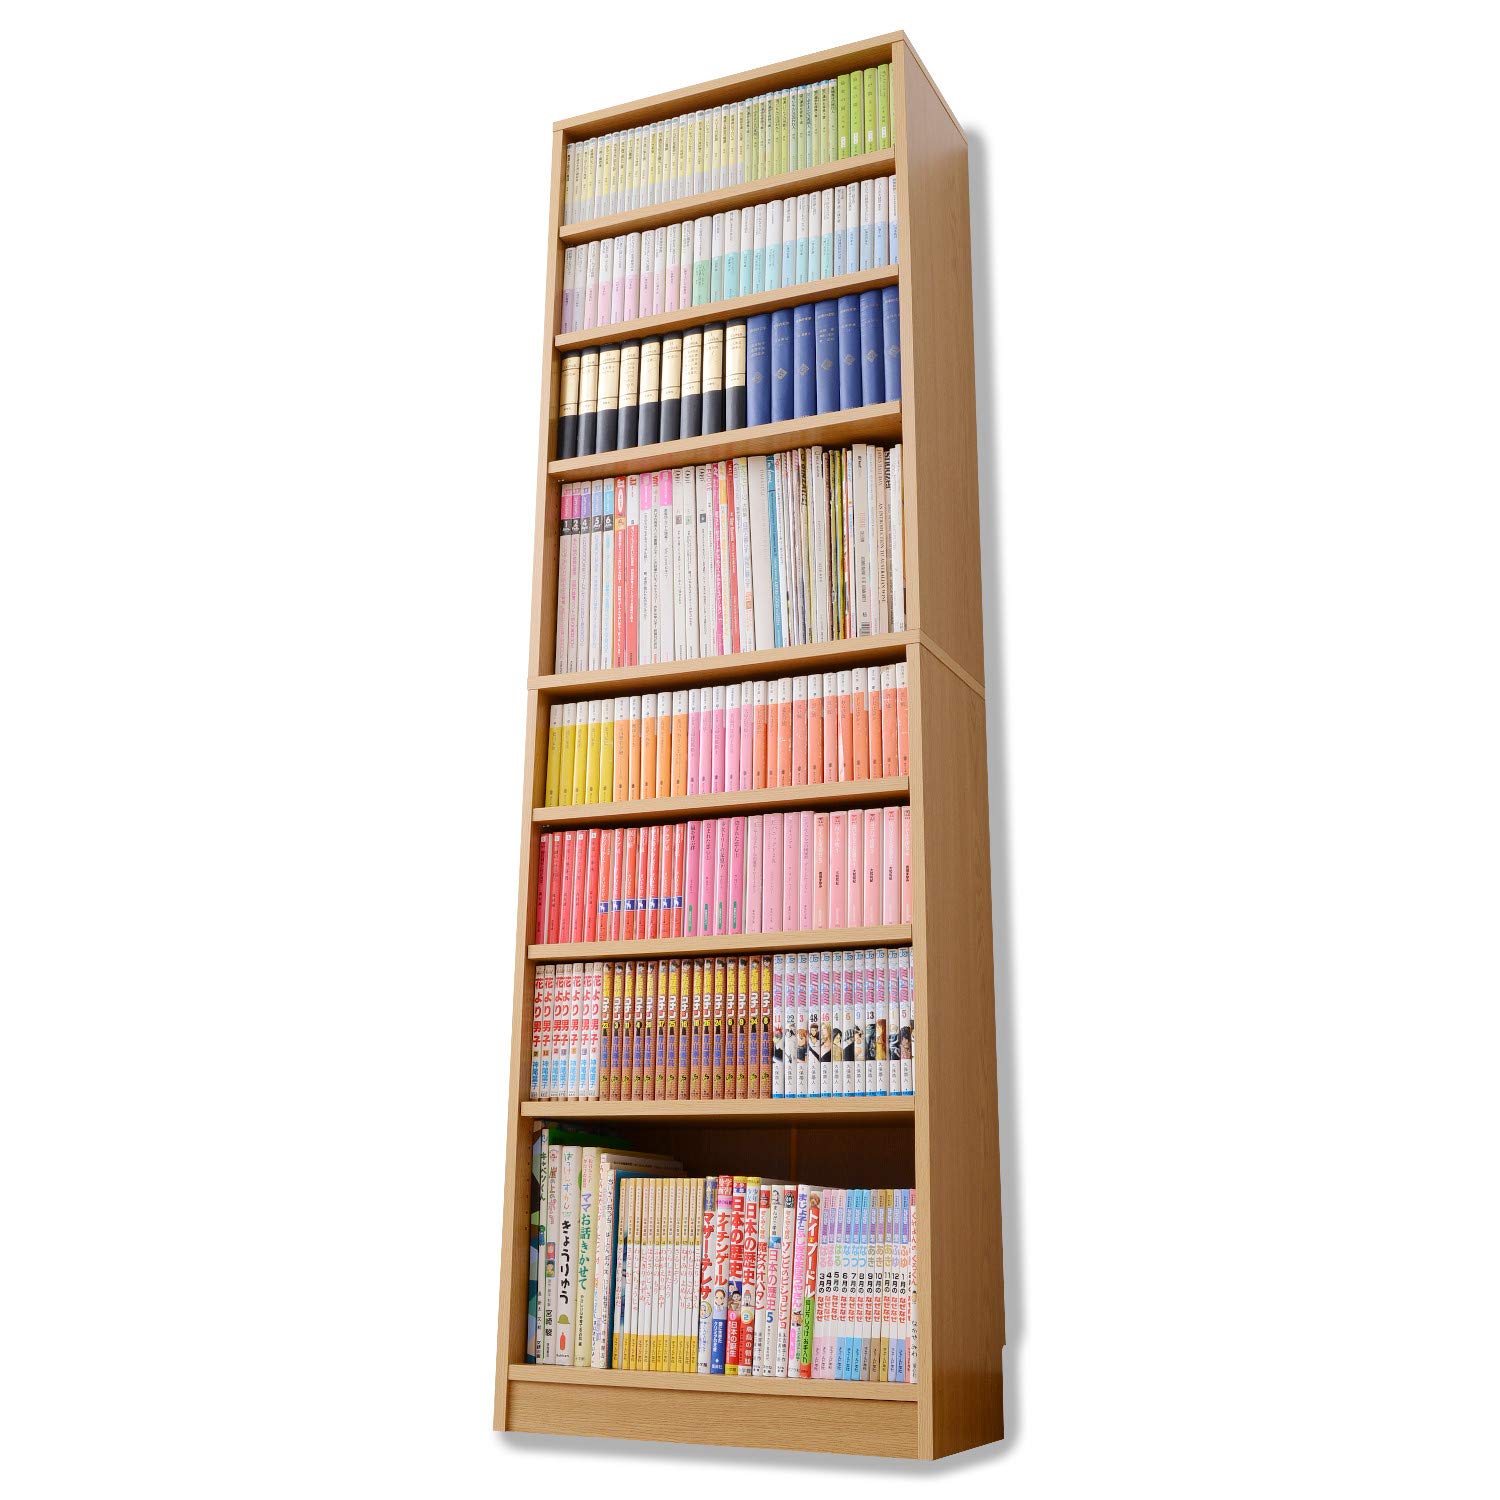

山善の本がすっきりオープンラックは、幅56cmの本棚で、棚板を約2cm間隔で高さ調整できます。 可動式棚6枚と固定棚1枚が付属し、本やCD、DVDなどの収納に使えるライトブラウンのラックです。
公式情報・参照先
- Google Cloud:Welcome to Gemini at Work 2026: Introducing the Gemini agent
- The Verge:Google is launching a one-stop Gemini agent for your work tasks
- Anthropic:Introducing the Anthropic Cyber Mission
- Anthropic:Launching an opt-in vulnerability-finding service for open-source software
- OpenAI:LegalOn halves Codex costs while maintaining development speed
- NVIDIA:Into the Omniverse: How Developers Turn Ideas Into Simulations With Frontier AI Agents
- Perplexity / Hugging Face:pplx-embed-v2-late-0.6b
- Perplexity / Hugging Face:pplx-embed-v2-late-9b