当サイトではアフィリエイト広告を利用しています。
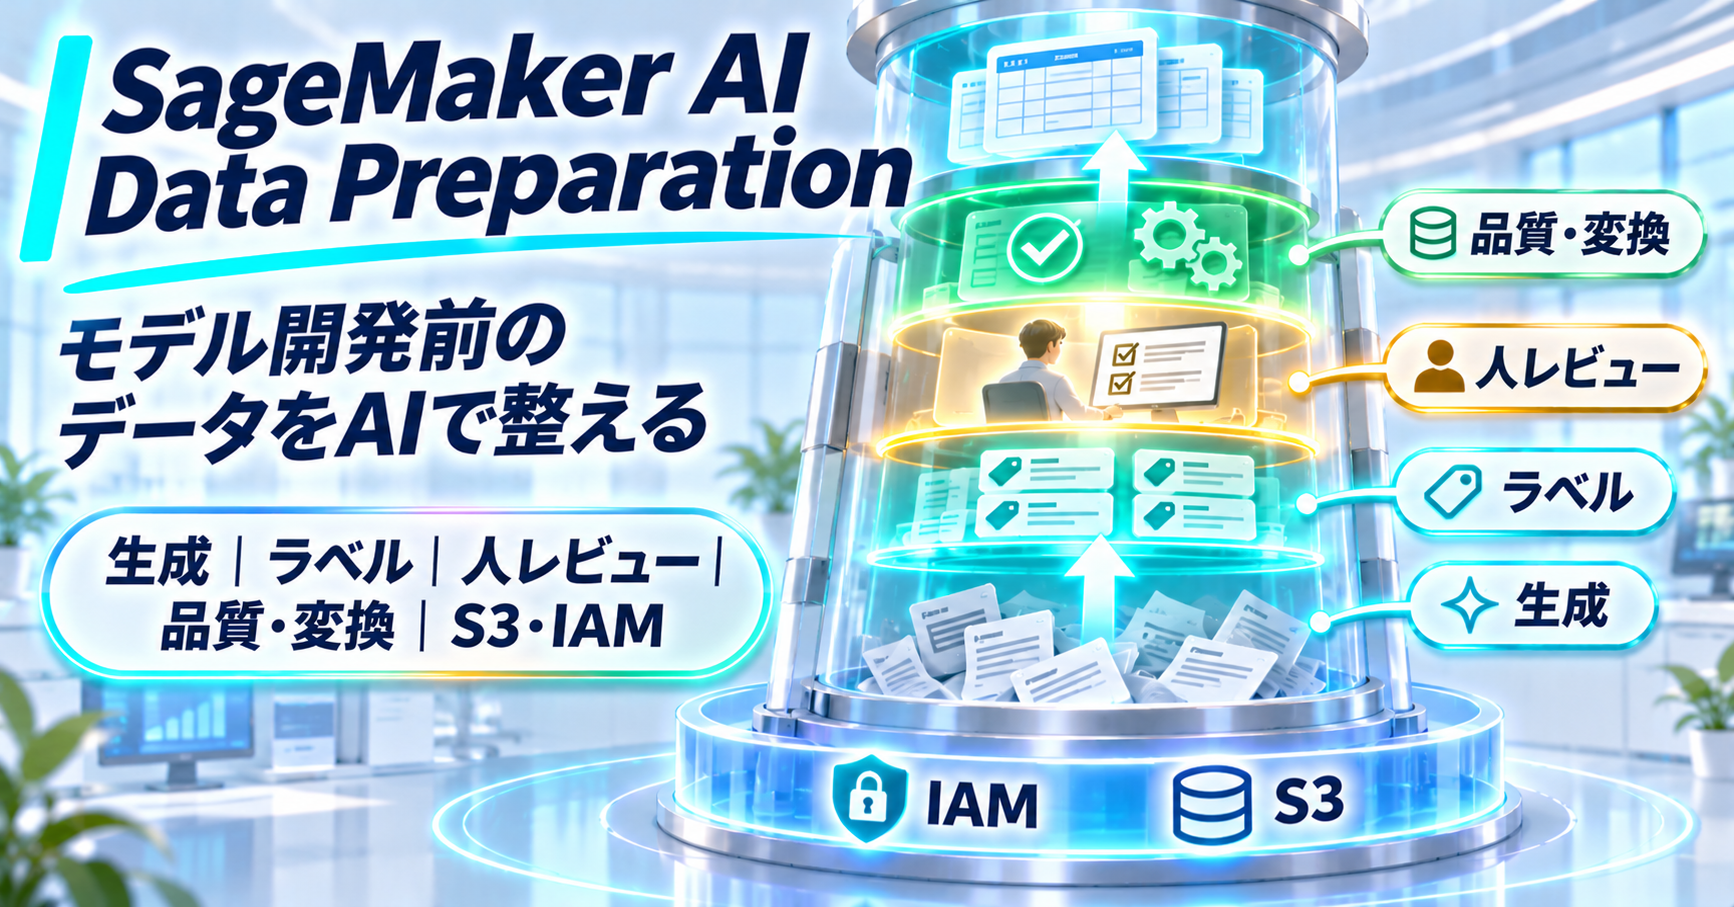
AWSは2026年11月17日、Amazon SageMaker AIにAI Data Preparationを追加し、一般提供を開始しました。モデル開発前のテキストデータを対象に、合成データ生成、自動ラベル付け、人によるレビュー、データ品質評価、データ変換をSageMaker上で実行できます。
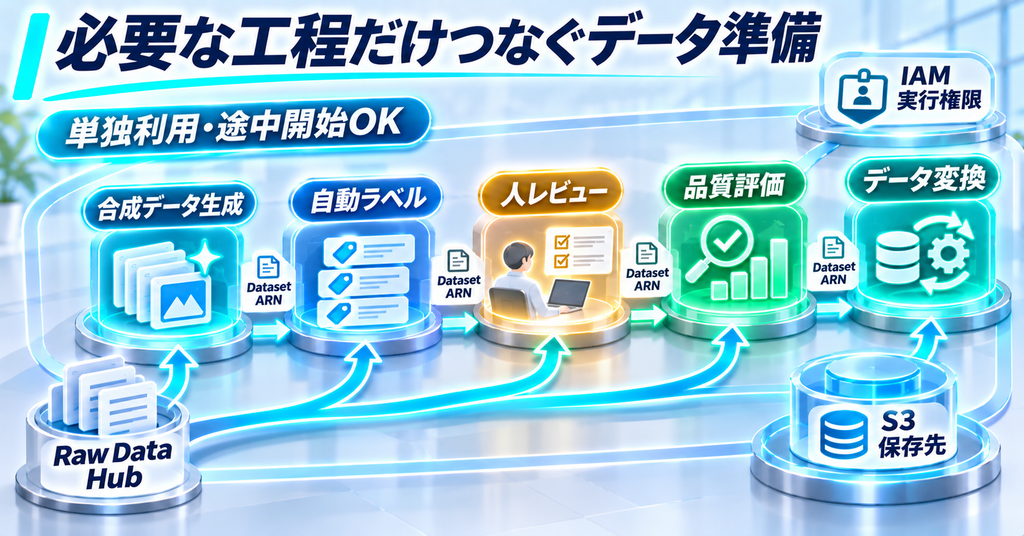
各機能は単独でも組み合わせても使えます。ジョブが生成したデータセットはSageMakerのHubへ登録され、データセットARNを次の工程へ渡せます。Python SDKから直接実行でき、Agent Toolkit for AWSのAI・MLスキルを使えば、自然言語で仕様作成や実行計画を進められます。
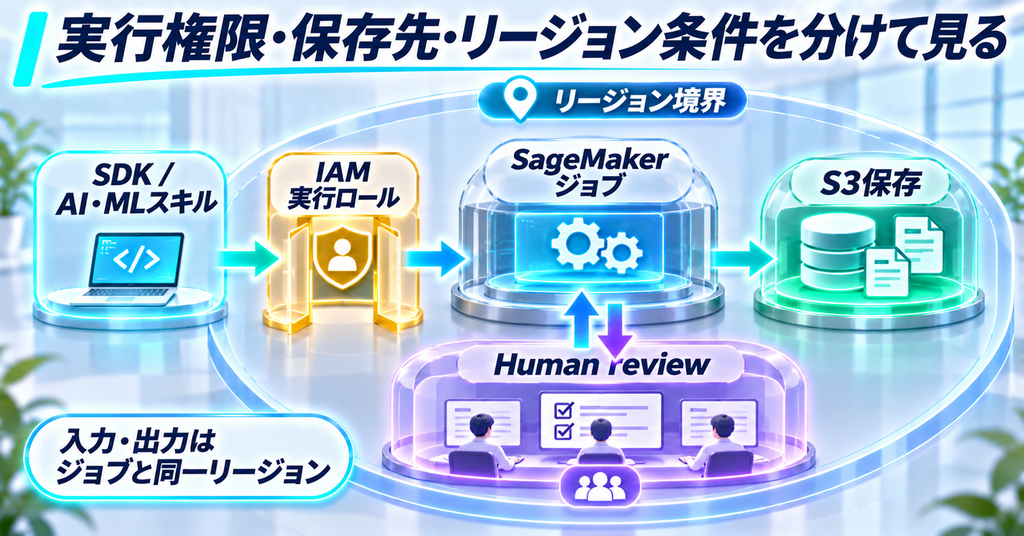
実務では、データ生成、自動ラベル、人レビュー、品質検査・変換、IAM実行権限・S3保存先・リージョン配置条件を分けて管理すると、AIに任せる処理と人が確認する地点を明確にできます。
SageMaker AI Data Preparationは5つの機能をデータセットでつなぐ
AI Data Preparationの主要機能は次の5つです。
| 機能 | 主な役割 | 次に渡すもの |
|---|---|---|
| Synthetic data generation | 仕様、既存データ、文書を使って学習・評価・テスト用データを生成 | 生成データセット |
| Auto-labeling | 未ラベルデータへラベルを付け、タスクに応じて信頼度やgrader評価を付与 | ラベル済みデータ、必要に応じたレビュー対象 |
| Human-in-the-loop annotation | 人が低信頼ラベルや評価用データを確認・修正 | 人の修正を含むデータ |
| Data quality evaluation | 重複、PII、品質ルール、リークなどを評価 | 品質レポート、問題行 |
| Data transformation | 重複除去、フィルタ、秘匿化、分割、結合、形式変換 | 学習・評価に使うデータセット |
SageMaker AI Data Preparationは、必要な工程から開始し、必要な機能だけをつなげられます。データが不足していれば合成データ生成から始め、既存データの品質だけ確認したい場合はData quality evaluationから始められます。
ジョブがデータを生成するとAmazon S3へ保存され、Hubへデータセットとして登録されます。次の工程は、そのデータセットARNを入力として受け取ります。
合成データ生成は仕様と検証条件を先に作る
Synthetic data generationは、学習・評価・テストに必要なデータが少ない場合に、仕様へ沿ったレコードを生成する機能です。
元になる文書やシードデータを使って生成内容をグラウンディングでき、生成後のレコードには検証条件を設定できます。
検証は大きく2種類あります。
- 構造チェック:必須項目、値の範囲、文字数、項目間の整合などをPythonで確認
- 意味チェック:文脈に合うか、ラベルと本文が対応するかなどをLLMで確認
意味チェックを使う設定では、レコードごとにモデル呼び出しが増えるため、処理時間とモデル利用料も増えます。
仕様、検証条件、品質評価を一つの流れで残すことで、後から「何を条件に作ったデータか」を追えます。
自動ラベルはタスクごとに信頼度・評価方法を使い分ける
Auto-labelingは、未ラベルのテキストデータへモデルでラベルを付けます。対応タスクごとに評価方法が異なり、行単位の信頼度を算出するタスクでは、その信頼度を人レビューへ回す行の選別に使えます。
対応する代表的なタスクは、分類、固有表現抽出、抽出型QA、順序尺度の採点、LLM-as-a-judge、要約です。
信頼度の作り方はタスクによって異なります。分類、固有表現抽出、抽出型QAでは複数モデルの合意率を使い、順序尺度やLLM-as-a-judgeでは同じモデルの複数サンプル間の一致度を使います。要約は行ごとの信頼度を出さず、別のgraderがサンプルを評価します。
分類などの認証対象タスクでは、評価用の人手ラベルと目標精度を用意すると、信頼度のしきい値を決めて受け入れる行とレビューへ送る行を分けられます。
運用では、行単位の信頼度を出すタスクは信頼度としきい値でレビュー対象を選び、要約はgrader評価を使うなど、タスクごとの評価方法に合わせて人の確認を組み込みます。
人レビューは低信頼データと評価セットへ集中させる
Human-in-the-loop annotationでは、モデルが判断しきれない行や、評価用に人の正解ラベルが必要なデータをLabel Studio Community Editionで確認できます。
典型的な使い方は次の3つです。
- 自動ラベルで低信頼になった行の修正
- held-out評価セットの人手ラベル作成
- ドメイン知識が必要な曖昧データの判断
人の修正は、修正結果を取り込んだ新しいデータセット版として登録できます。修正前の状態を残したまま比較できます。
Label Studioの共有スペースにはロールベースアクセス制御がありません。同じSageMaker StudioドメインでLabel Studioを開ける利用者は、他の担当者のプロジェクトも参照できます。全レビュー担当へ見せられないデータを扱う場合は、ドメインを分けてレビュー環境を分離する設計が必要です。
学習用データと評価用データを分け、人が確認した評価セットで調整結果を測る具体例は、Nous ResearchのArete-27Bの記事でも扱っています。
品質評価と変換で学習前に問題を落とす
Data quality evaluationは、学習や評価へ使う前にデータセットを検査する工程です。
確認方法は3種類あります。
| 方法 | 確認する内容 |
|---|---|
| Built-in metrics | 重複、PII、言語、トピック、長さ、多様性など |
| Data quality rules | 自社ルールやLLM-as-a-judge条件に合うか |
| Exploratory analysis | 事前に想定していなかった問題をエージェントが探索 |
AWSの発表では、ラベルノイズやanswer leakageも品質問題として挙げられています。
問題が見つかった後はData transformationで修正します。組み込み操作では、重複除去、フィルタ、PIIの秘匿化、分割、結合、形式変換を実行できます。Pythonの独自処理や、自然言語からPythonコードを作るCodeGenも利用できます。
変換ジョブは入力データセットをそのまま残し、通常は新しいデータセット版として結果を登録します。品質評価と変換を往復させると、どの修正で品質条件を満たしたかを追跡できます。
IAM実行権限・S3保存先・リージョン配置条件を分けて管理する
AI Data Preparationのジョブは、利用者が管理するIAM実行ロールで動きます。元データ、生成データ、ラベルは利用者自身のAmazon S3バケットへ保存されます。
AWS公式ドキュメントでは、すべての入力・出力S3ロケーションをジョブと同じAWSリージョンへ置く必要があります。
2026年11月18日時点の提供地域は次の通りです。
| 対象 | 提供リージョン |
|---|---|
| AI Data Preparationの主要ジョブ | 米国東部(バージニア北部)us-east-1、米国西部(オレゴン)us-west-2 |
| Human-in-the-loop annotation | 上記2リージョンに加え、欧州(アイルランド)eu-west-1、アジアパシフィック(東京)ap-northeast-1 |
東京リージョンで追加提供されているのはHuman-in-the-loop annotationです。合成データ生成、自動ラベル、品質評価、変換の主要ジョブは、同日時点ではバージニア北部とオレゴンが対象です。
AI Data Preparationが扱うデータ種別はテキストです。画像、音声、動画は対象外です。主要ジョブの多くはAmazon Bedrockモデルを呼び出すため、利用するモデルの料金とクォータもAWSアカウント側で確認します。
Python SDKとAI・MLスキルは同じジョブを実行する
合成データ生成、品質評価、変換、自動ラベルはAmazon SageMaker Python SDKから実行できます。必要なSDKは3.30.0以降、Pythonは3.10以降です。
Agent Toolkit for AWSのAI・MLスキルを使う場合も、裏側では同じSageMaker AI Data Preparationジョブを実行します。
AI・MLスキルは、自然言語の依頼から仕様、実行計画、コードを作り、ジョブ実行やAWSリソース作成の前に利用者へ確認を求めます。実行内容はNotebookやスクリプトとして保存できるため、後から再実行できます。
自動化する範囲を広げても、実行ロール、S3保存先、仕様、承認、生成されたコードを確認できる状態を維持することが管理上のポイントです。
実務導入では5つの管理点を決める
AI Data Preparationをモデル開発へ組み込むときは、次の5点を先に決めます。
- 生成条件:どの文書・シードデータを根拠に、何を生成するか
- ラベル受け入れ条件:どのタスクで、どの信頼度・精度条件を使うか
- 人レビュー条件:誰が、どの行を、どのドメインで確認するか
- 品質・変換条件:重複、PII、リーク、形式を何で合否判定し、どう修正するか
- 実行権限・保存先・配置条件:IAMロール、S3バケット、リージョンをどこへ固定するか
この5点を記録すると、生成したデータがどの条件で作られ、どの行を人が直し、どの品質検査を通り、どのIAM権限で実行され、どのS3保存先に、どのリージョン条件で配置されたかを追えます。
まとめ
Amazon SageMaker AI Data Preparationは、モデル開発前のテキストデータを生成、ラベル付け、人レビュー、品質評価、変換までつなぐデータ準備機能です。
各機能は単独利用でき、データセットARNで必要な工程をつなげられます。行単位の信頼度を出す自動ラベルでは信頼度で人レビュー対象を選び、要約ではgrader評価を使うなど、タスクごとの評価方法に合わせて人の確認を組み込みます。品質評価で重複・PII・リークなどを確認し、変換後のデータを新しい版として残せます。
実務では、生成条件、ラベル受け入れ条件、人レビュー条件、品質・変換条件、IAM実行権限・S3保存先・リージョン配置条件の5点を固定すると、AIによる自動化と人の確認を同じデータ準備フローで管理できます。
公式情報・参照先
- Amazon SageMaker now supports AI data preparation capabilities to build high-quality datasets for model development | AWS
- Announcing AI data preparation capabilities in Amazon SageMaker | AWS Machine Learning Blog
- Preparing Data with SageMaker AI Data Preparation | Amazon SageMaker AI
- Auto-labeling | Amazon SageMaker AI
- Human-in-the-loop annotation | Amazon SageMaker AI
- Data quality evaluation | Amazon SageMaker AI
- Data transformation | Amazon SageMaker AI
- Regions and limits for SageMaker AI Data Preparation | Amazon SageMaker AI
- Get started with SageMaker AI Data Preparation | Amazon SageMaker AI