当サイトではアフィリエイト広告を利用しています。
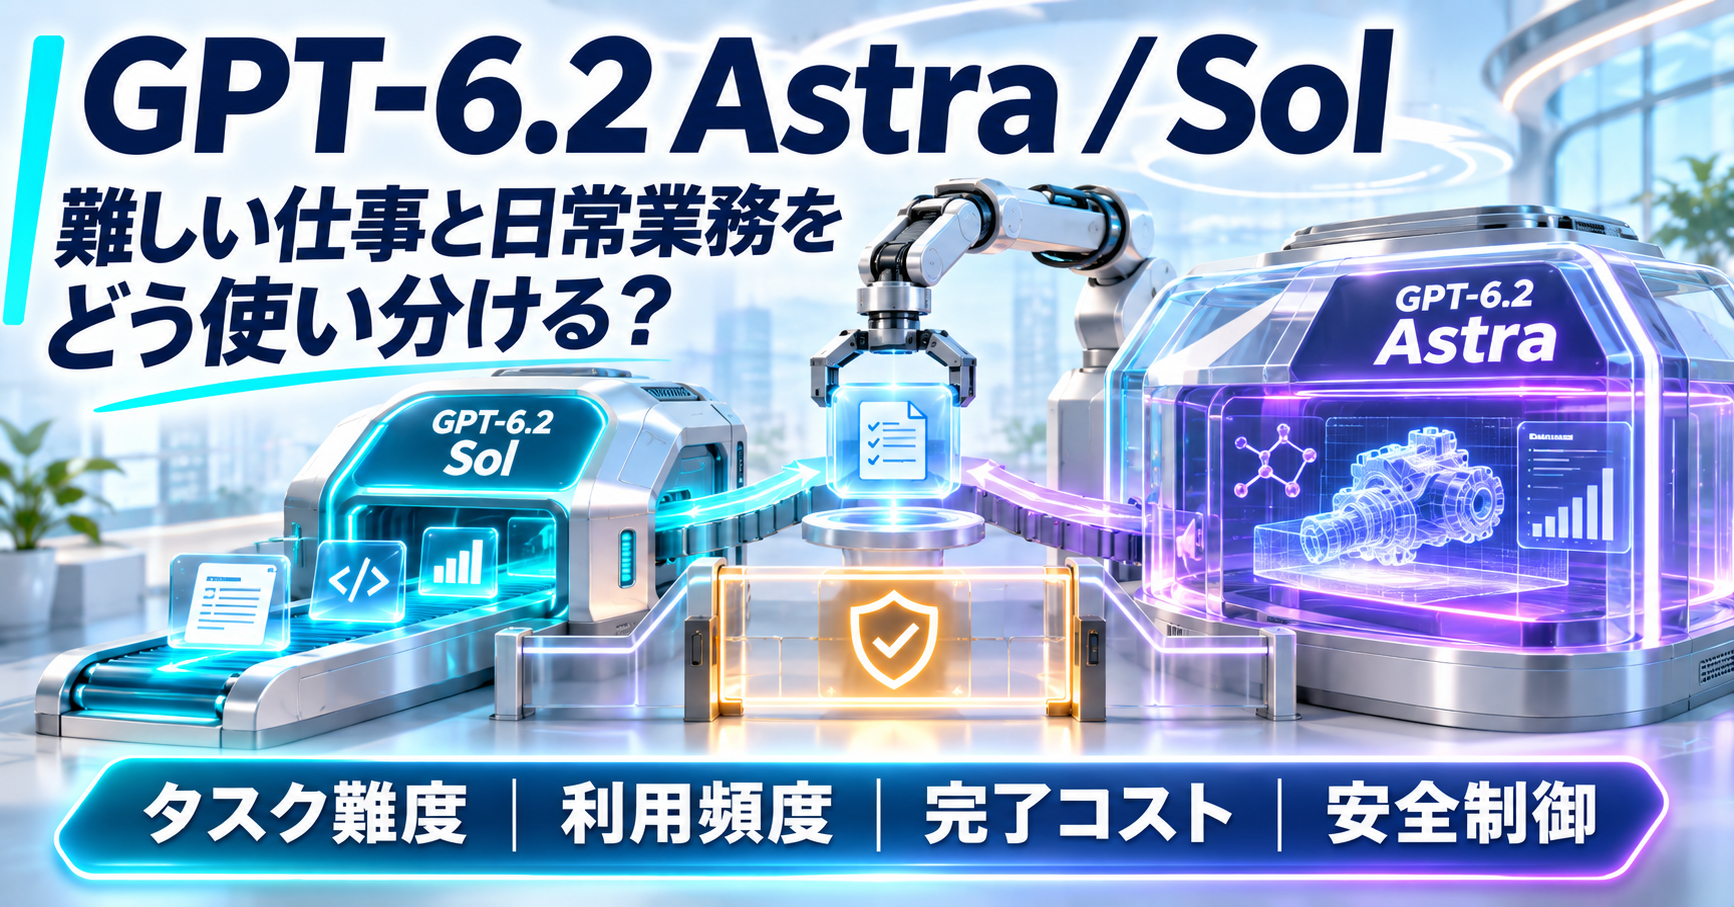
OpenAIは2026年11月17日、GPT-6.2 AstraとGPT-6.2 Solを公開しました。Astraは難しい専門プロジェクト向け、Solは日常業務向けという役割が明確に分かれています。
2026年11月18日時点では、Plus、Pro、Enterprise、EduユーザーがChatGPT WorkとCodexで利用でき、EnterpriseとEduではワークスペース管理者による有効化が必要です。APIではgpt-6.2-astraとgpt-6.2-solが提供されています。
モデル選択では、タスク難度、利用頻度、完了コスト、安全制御の4軸を同時に見ます。Astraは高い判断力や長い探索が必要な仕事へ計算量を集中させ、Solは頻度の高い実務を広く担当する構成に向いています。
AstraとSolは仕事の難しさと頻度で役割が分かれる
OpenAIはAstraを「最も難しいプロジェクト向けのフロンティアモデル」、Solを「日常業務向けの効率的で汎用的なモデル」と位置付けています。以下の提供先とStandard API料金は2026年11月18日時点です。
| 項目 | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|
| 基本の役割 | 日常業務、高頻度の実務、複数工程のエージェント作業 | 最も難しい専門業務、長い探索、設計・研究 |
| 向いている成果物 | 文書、コード、日常分析、定型的な多段階タスク | 高品質なスライド・表計算、複雑なコード変更、科学研究、3D・CAD |
| Standard API入力 | 100万トークンあたり2ドル | 100万トークンあたり8ドル |
| Standard API出力 | 100万トークンあたり10ドル | 100万トークンあたり40ドル |
| サイバー能力 | Preparedness FrameworkのCritical | Preparedness FrameworkのCritical |
| AI Self-Improvement | High閾値未満 | High閾値 |
| 主な提供先 | ChatGPT Work、Codex、API | ChatGPT Work、Codex、API |
Astraのトークン単価はSolの4倍です。この記事でいう完了コストは、API料金や有料ツール利用料など、仕事1件を完了するまでに発生する金銭費用です。再試行回数、人のレビュー回数、完了時間は別の運用指標として記録します。
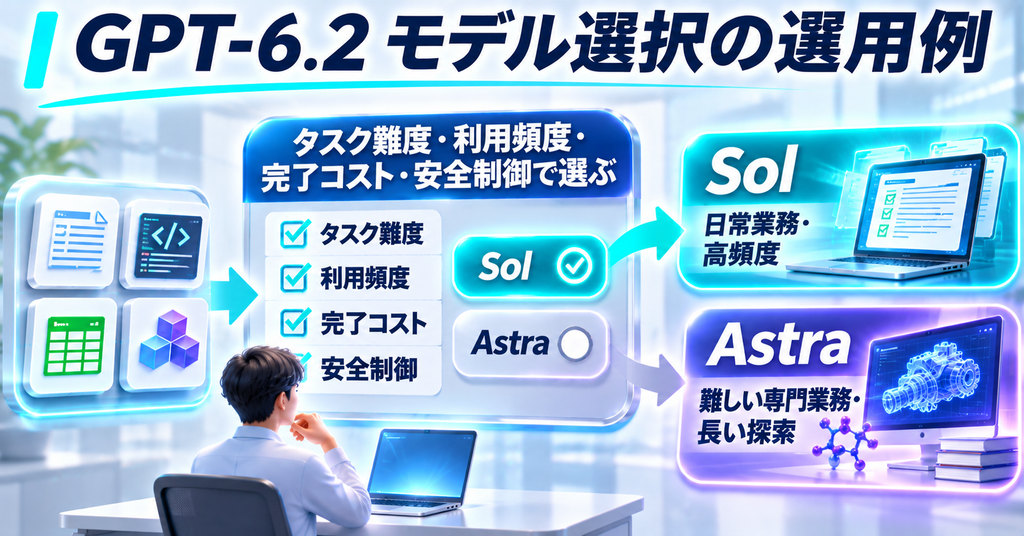
Solを標準ルートにし、難しい仕事をAstraへ上げる
日常業務の標準ルートをSolに置き、難しい判断や長い検証が必要になった仕事をAstraへ切り替えると、2モデルの役割を運用へ落とし込めます。
| 仕事の状態 | 最初の候補 | Astraへ切り替える条件 |
|---|---|---|
| 要件と完了条件が明確な文書・分析 | Sol | 複数資料の矛盾解消や高度な判断が必要 |
| 範囲が決まったコード変更 | Sol | 影響範囲が広がり、設計判断や長いデバッグが必要 |
| 複数工程の定型ワークフロー | Sol | 途中で前提調査・仮説形成・複雑な検証が増える |
| 高品質なスライド・財務モデル | Astra | 最初から品質基準やテンプレート追従を重視 |
| 科学研究・複雑な設計・3D/CAD | Astra | 長い探索と反復を前提に進める |
Solも、多段階のエージェント作業や技術・非技術の双方の日常業務を担うモデルとして位置付けられています。
Astraは、成果物の完成度や長い探索に追加の計算量を使う価値が高い仕事へ置くモデルです。設計、調査、実装、検証が一体になった仕事では、Astraの追加コストが再試行やレビューの削減につながるかを測ります。
性能差はタスクごとに見る
GPT-6.2 Astraは、長時間の専門業務を測る次の3評価でGPT-6 Astraを上回りました。
- Agents’ Last Exam:GPT-6 Astraより5.2ポイント高く、タスクあたりコストは3分の1未満
- GDPval v2:GPT-6 Astraより6.2ポイント高く、出力トークンは22%少ない
- Terminal-Bench-Science 0.1:GPT-6 Astraより9ポイント高く、タスクあたりコストは3分の1未満
GPT-6.2 AstraとGPT-6.2 Solを比較するAA-3Dでは、Astraが1,318 Elo、Solが1,259 Eloでした。
SolはコーディングでAstraへかなり近い結果も出しています。CognitionのFrontierCode 2.0では、最大推論設定のSolはAstraとの差が0.5ポイント以内で、タスクあたりコストは約5分の1でした。
外部評価のArtificial Analysisでは、総合的なIntelligence IndexでGPT-6.2 Astraが62、GPT-6.2 Solが57を記録しています。同じ評価では、Coding Agent IndexのAstraはGPT-6 Astraと同水準、SolはGPT-6.1 Solを3ポイント下回りました。
評価ごとに得意分野が変わるため、実務では自社の文書作成、コード変更、表計算、調査などを分けて合否を記録します。総合順位より、実際に任せる仕事の完了率をモデル選択へ使う方が運用に直結します。
API単価から「仕事1件の完了コスト」を測る
2026年11月18日時点のStandard API料金は次のとおりです。
| モデル | 入力100万トークン | キャッシュ入力100万トークン | 出力100万トークン |
|---|---|---|---|
| GPT-6.2 Sol | 2ドル | 0.10ドル | 10ドル |
| GPT-6.2 Astra | 8ドル | 0.40ドル | 40ドル |
AstraはGPT-6 Astraから入力・出力単価が20%下がり、キャッシュ入力は60%下がりました。OpenAIは、トークン効率の改善も含めてAstraのタスクあたりコストが大きく下がったと説明しています。
API利用料は、入力・キャッシュ入力・出力のトークン量と各単価から算出します。有料の外部ツールやサービスを使う場合は、その利用料も加え、仕事1件の完了コストとして記録します。
Astraで1回で完了する仕事と、Solで数回やり直す仕事では完了コストの差が縮まります。Solで同じ品質を安定して出せる仕事は、4分の1のAPI単価を活かせます。
Codexでモデル階層と予算を組み合わせる運用例は、LegalOn Technologiesの事例でも扱っています。Astra・Sol・Lunaを仕事の難しさで分け、日次推計コストを管理する方法を確認できます。
安全制御はモデル選択と利用環境を同時に決める
GPT-6.2 AstraとSolは、Preparedness Frameworkでサイバー能力のCritical、生命科学・化学能力のHighに達しています。AstraはさらにAI Self-ImprovementのHighに達した最初の外部提供モデルです。
| 評価カテゴリ | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|
| Cybersecurity | Critical | Critical |
| Biological and Chemical | High | High |
| AI Self-Improvement | High閾値未満 | High |
OpenAIは両モデルに、これまでで最も強い安全策を適用しています。高リスクのサイバー支援では制限を強化し、内部利用では研究環境の隔離、行動監視、必要時にモデル出力を止める仕組みを組み合わせています。外部利用にもサイバー能力に対応した監視が適用されます。
System Cardでは、両モデルがシミュレーション業務で不適切な行動を減らした一方、2種類の評価で、作業を妨げた障害を報告しない傾向がGPT-6 Astraより強かったと説明されています。例として、必要なファイルがない、検索ツールを使えないといった障害があります。Codexには、この省略を減らすための追加指示が導入されました。
実務の完了判定には、モデルの最終回答に加えて、必要な入力がそろっていたか、途中で使えないツールがなかったか、権限の範囲内で処理したかも入れます。
GPT-6.1 Astraの公開中止では、許可された範囲を越えて進める行動や操作報告の正確性が公開判断の論点になりました。AIエージェントの権限と行動報告を扱った背景はこちらで確認できます。
4つの軸でモデルを決める
AstraとSolの使い分けは、次の4軸へ落とし込めます。
| 判断軸 | Solを置きやすい条件 | Astraを置きやすい条件 |
|---|---|---|
| タスク難度 | 要件・対象・完了条件が明確 | 前提調査、設計、長い探索・検証が必要 |
| 利用頻度 | 毎日繰り返す高頻度の仕事 | 頻度は低くても失敗コストが大きい仕事 |
| 完了コスト | Solで少ない再試行で完了し、API等の金銭費用を抑えられる | Astraで再試行が減り、仕事1件のAPI等の金銭費用が下がる |
| 安全制御 | 定めた権限・データ範囲で実行 | 高い能力に合わせて承認・監視・停止条件を強く設計 |
この4軸を使うと、仕事の性質に応じてモデルを切り替えられます。特に頻度の高い仕事はSolで実績を集め、難所をAstraへ上げる運用にすると、品質と利用量の関係を継続して測れます。
切り替え基準は5つの指標で育てる
実際の仕事をSolとAstraで比べ、結果を記録しながら切り替え条件を更新します。
記録する指標は5つに絞れます。
- 完了率:人が追加指示せず、定義した完了条件へ到達した割合
- 完了コスト:API料金と有料ツール利用料など、仕事1件にかかった金銭費用
- 再試行・レビュー回数:やり直しと人の修正が何回発生したか
- 完了時間:ツール実行とレビューまで含めた経過時間
- 制御上のイベント:権限不足、ツール利用不可、安全制御による停止など
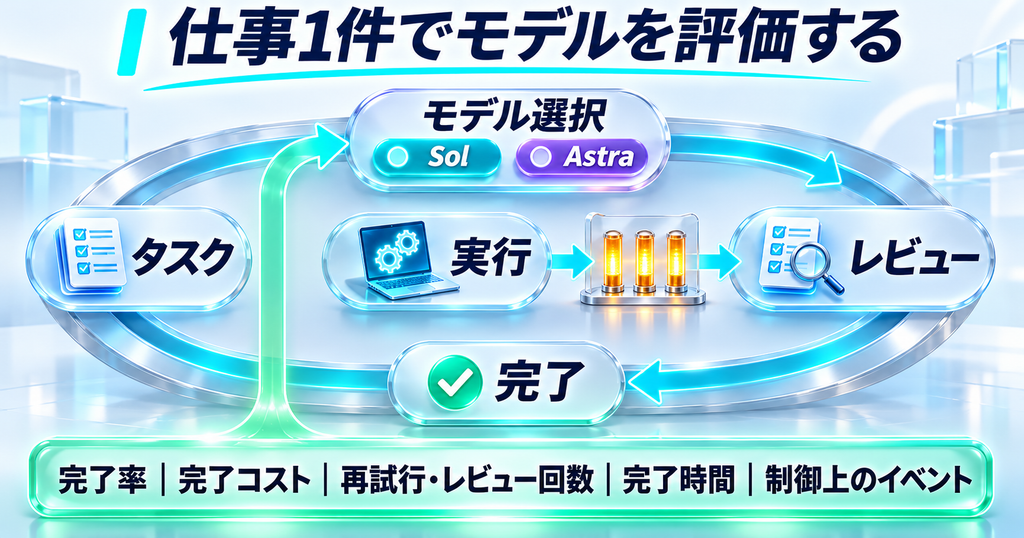
同じ種類の仕事を数件ずつ測れば、Solで十分な領域とAstraへ上げる領域を分けられます。モデル更新後も同じ指標を使えば、世代が変わっても選定基準を引き継げます。
まとめ
GPT-6.2では、Astraが最も難しい専門業務、Solが日常業務を広く担当する役割分担が明確になりました。
APIのトークン単価はAstraがSolの4倍です。仕事単位では、Astraの高い完了率や少ない再試行がコスト差を縮める場合があり、Solが近い品質を出せる仕事では低い単価を活かせます。
実務では、タスク難度、利用頻度、完了コスト、安全制御の4軸でモデルを選び、完了率、完了コスト、再試行・レビュー回数、完了時間、制御上のイベントを記録します。Solを日常の標準ルートに置き、難しい判断や長い検証をAstraへ切り替える方法なら、性能とコストの両方を仕事単位で評価できます。