当サイトではアフィリエイト広告を利用しています。
Alibabaは2026年11月16日、Qwenシリーズの新しい旗艦モデル「Qwen4-Max」を公開しました。総パラメータ数は2.4兆、1トークンを処理するときに活性化するパラメータは710億、コンテキスト長は100万トークンです。
Qwen4-Maxでは、この3つがそれぞれ別の役割を持ちます。2.4兆はモデル全体が持つ規模、710億は1トークンの処理で使う規模、100万トークンは一度に扱える文脈の長さを示します。
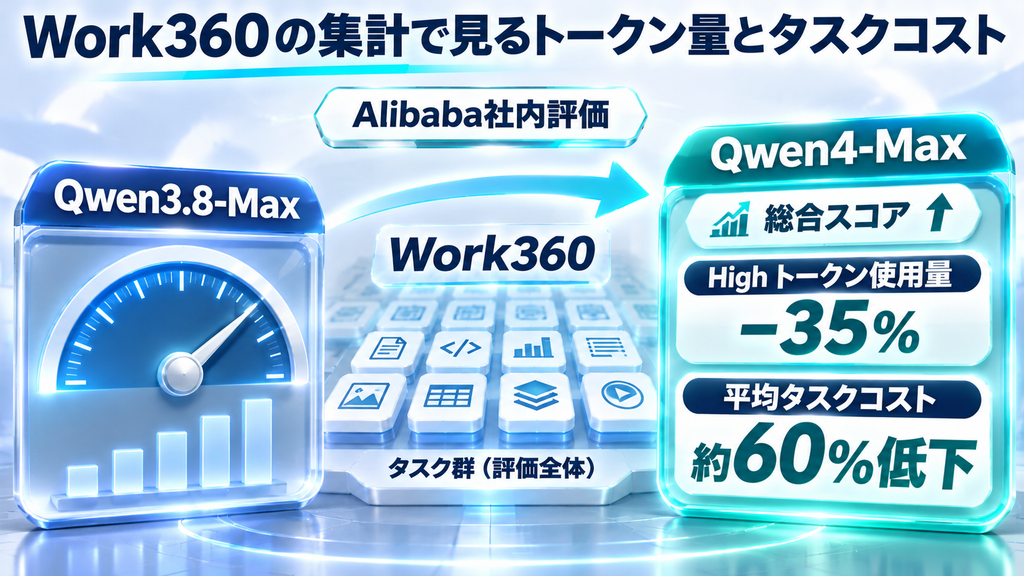
さらにAlibabaの社内評価「Work360」では、前世代のQwen3.8-Maxより総合スコアを上げながら、High reasoning modeのトークン使用量を35%減らし、1タスクあたりの平均コストを約60%下げたと説明しています。Qwen4-Maxは、「モデル全体の規模」「1トークンあたりの計算」「長文脈」「仕事1件を終えるまでのコスト」の4つの軸で評価できます。
Qwen4-Maxは2.4兆パラメータのMoEで、1トークンごとに710億を使う
Qwen4-MaxはMixture-of-Experts(MoE)方式のモデルです。MoEでは、モデル内部に複数の専門的な処理部分を持ち、入力されたトークンごとに必要な一部を選んで動かします。
Qwen4-Maxの2.4兆パラメータは、モデル全体が持つパラメータの総数です。実際に1トークンを処理するときは710億パラメータを活性化します。総パラメータに対して、各トークンで使う計算経路を絞る設計です。
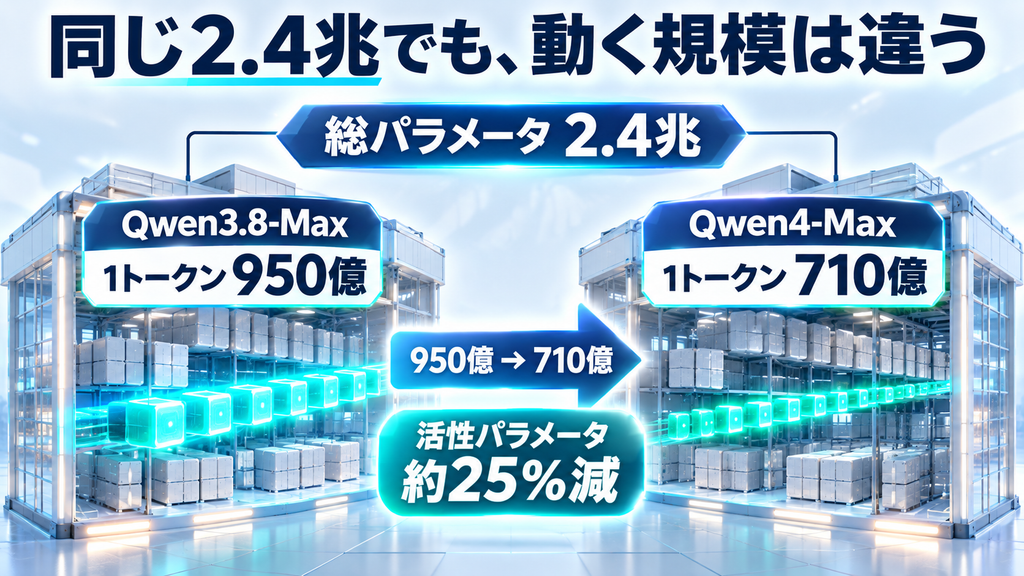
前世代のQwen3.8-Maxも総パラメータ数は2.4兆でしたが、1トークンあたりの活性パラメータは950億でした。Qwen4-Maxは同じ総規模のまま、活性パラメータを約25%減らしています。
| 指標 | Qwen3.8-Max | Qwen4-Max | 読み取れること |
|---|---|---|---|
| 総パラメータ数 | 2.4兆 | 2.4兆 | モデル全体の規模 |
| 1トークンあたりの活性パラメータ | 950億 | 710億 | 各トークンで使う計算経路の規模 |
| 活性パラメータの変化 | 基準 | 約25%減 | 同じ総規模で疎な実行へ進んだ |
この違いから、モデル全体の規模と、推論時に毎トークンで活性化するパラメータ規模を区別できます。活性パラメータ数は推論効率を見る一つの指標で、実際の処理時間や費用には入力長、出力量、推論設定、キャッシュ、ツール実行なども影響します。
100万トークンは長い仕事を入れるための文脈容量
Qwen4-Maxは100万トークンのコンテキスト長を持ちます。長いコードベース、複数文書、画像や動画を含む入力を一つの仕事の中で扱うときに使える文脈容量です。
Alibaba Cloud Model Studioの仕様では、最大入力は非思考モードで991,808トークン、思考モードで983,616トークンと案内されています。最大出力にも別の上限があり、非思考モードは131,072トークン、思考を含む設定では最大262,144トークンです。
実運用では、100万トークンを必要な資料や履歴を保持できる文脈容量の上限として扱います。入力が長くなるほど処理するトークンも増えるため、長文脈を使う仕事では、どの情報を毎回送るか、同じ前置き情報をキャッシュできるかまでコスト設計に入ります。
Qwen4-Maxは明示的・暗黙的なキャッシュにも対応しています。長いシステムプロンプト、共通資料、繰り返し参照するコードなどが多いワークロードでは、キャッシュのヒット率も仕事1件の総コストへ影響します。
Work360ではHigh設定のトークン使用量を35%削減
AlibabaはQwen4-Maxの業務評価として、721の専門分野を扱う社内ベンチマーク「Work360」を公開しています。
この評価では、Qwen4-MaxがQwen3.8-Maxを総合スコアで上回りながら、High reasoning modeで使うトークン量を35%削減し、1タスクあたりの平均コストを約60%下げたと説明しています。
| Work360の確認点 | Qwen4-Maxの結果 |
|---|---|
| 比較対象 | Qwen3.8-Max |
| 総合評価 | Qwen3.8-Maxを上回る |
| High reasoning modeのトークン使用量 | 35%削減 |
| 1タスクあたりの平均コスト | 約60%低下 |
モデル評価では、「100万トークンあたりの単価」に加えて、仕事を完了するまでのトークン使用量と、1件あたりの最終費用を確認します。出力を短くできても再試行が増えれば総消費量は増えます。反対に、推論単価が高めでも1回で仕事を終えられれば、タスク単位では費用を抑えられる場合があります。
Work360の数値はAlibabaの社内評価条件で測定された結果です。業務導入時は、自社のプロンプト、ツール、データ、成功条件で同じタスク群を固定し、削減率を実測します。
タスクコストはモデル単価と別に「仕事1件」で測る
Qwen4-Maxの発表で実務上参考になるのは、モデルの価格表とタスク単位の評価を分けている点です。
仕事1件の総コストには、少なくとも次の要素が入ります。
- 入力トークン
- 出力トークンと推論で使うトークン
- キャッシュのヒット・ミス
- ツール呼び出し回数
- 再試行回数
- 複数モデルを使う場合の各モデル呼び出し
- 成功判定までに必要な追加処理
たとえばコード修正で、安価なモデルを3回やり直すケースと、より高性能なモデルが1回でテストまで通すケースでは、再試行を含む仕事1件の総額で最終費用を判断します。成功したタスク1件を基準にすると、モデルの速度・精度・推論量・費用を同じ単位で比較できます。
精度・費用・回答時間を同じ評価環境で比較する考え方は、Plotly DataAnalyticsBenchの記事でも詳しく扱っています。
Qwen4-Maxを評価するときは4つの数字を役割ごとに見る
Qwen4-Maxの仕様と評価結果は、次の4軸に分けると実務へ落とし込みやすくなります。
| 評価軸 | Qwen4-Maxで確認できる値 | 実務で見る意味 |
|---|---|---|
| モデル全体の規模 | 総パラメータ2.4兆 | モデル全体が持つ総パラメータ数 |
| 1トークンの実行規模 | 1トークンあたり活性パラメータ710億 | 各トークンで使う計算経路の規模 |
| 文脈容量 | 100万トークン | 長い資料・コード・履歴を扱う余地 |
| タスク効率 | Work360でHighのトークン35%減、平均タスクコスト約60%減 | 仕事を終えるまでの総消費量と費用 |
この4つは役割が異なります。総パラメータ数はモデル全体の規模を示し、活性パラメータ数はMoEで1トークンごとに選ばれる計算経路の規模を示します。コンテキスト長は保持できる文脈量、タスクコストは実際の仕事1件にかかる費用を示します。トークン使用量は、その費用に影響する消費量として別に確認します。
モデル比較では、用途ごとに必要な条件を決めます。長い資料を扱う仕事なら文脈容量、反復処理が多いエージェントならタスク単位のトークン量、応答品質を重視する仕事なら成功率やレビュー修正量まで測定対象に入ります。
自分の業務では同じタスク群を固定して測る
Qwen4-Maxを自社の仕事へ入れる場合、自分の業務に近いタスクを固定して比較すると運用判断へつながります。
最低限、次の項目を記録するとモデル間の違いを追えます。
- タスクの種類と成功条件
- 使用モデルと推論設定
- 入力・出力トークン
- キャッシュ利用量
- ツール呼び出し回数
- 再試行回数
- 完了までの時間
- 人が修正した箇所
- 成功したタスク1件あたりの費用
同じ自社タスク群を複数モデル・複数設定で回し、成功条件、トークン使用量、完了までの時間、仕事1件あたりの費用を実測すると、外部ベンチマークの評価を自社業務の判断材料へ結び付けられます。Qwen4-Maxの活性パラメータ削減が自社環境でどこまで速度や費用へ効くかも、完了率と総消費量を合わせて測ることで判断できます。
Qwen4-MaxはQwenCloud APIなどから利用できる
Qwen4-MaxはQwenCloudのToken PlanとAPI、QwenWork、QwenStudioなどで提供されています。Alibaba Cloud Model Studioではモデル名「qwen4-max」として案内され、東京リージョンを含む提供情報も掲載されています。
入力はテキストに加えて画像・動画に対応し、出力はテキストです。深い推論、ツール呼び出し、Web検索、構造化出力などをサポートしています。
Alibabaは今回のQwen4-Maxとは別に、小規模なQwen4モデルをオープンウェイトで公開する計画も示しています。Qwen4-Maxの利用を検討する場合は、現在のAPI・クラウド提供条件と、今後の小規模Qwen4の公開計画を分けて確認すると選択肢を整理できます。
まとめ
Qwen4-Maxは2.4兆パラメータのMoEモデルで、1トークンあたり710億パラメータを活性化します。前世代のQwen3.8-Maxは同じ2.4兆規模で950億を活性化していたため、Qwen4-Maxでは活性パラメータが約25%減りました。
100万トークンのコンテキストは長い仕事を保持する容量で、入力・出力には個別の上限があります。Work360では、High reasoning modeのトークン使用量を35%削減し、1タスクあたりの平均コストを約60%下げたとAlibabaは報告しています。
モデル選定では、総パラメータ数、活性パラメータ数、コンテキスト長、成功した仕事1件あたりの総コストを別々の指標として測ると、Qwen4-Maxの設計と自社ワークロードへの適合を判断できます。