当サイトではアフィリエイト広告を利用しています。
Googleは2026年11月10日、Gemini 4 Carbonの提供範囲を開発者、企業、科学者、一般ユーザーへ広げました。CarbonはGemini 4シリーズの最上位モデルで、複雑なコーディングやデバッグ、長時間のエージェント作業、サイバーセキュリティ、科学研究などを主な対象にしています。
Gemini 4シリーズでは、Argonが大半のソフトウェアエンジニアリングと知識労働を担当し、Carbonがモデルの知能限界を試すような高難度タスクを担当します。今回の一般提供で、仕事の難しさに応じてモデル層を選ぶ構成がより明確になりました。
モデル選択では、タスク難度、推論量、利用経路、完了までの費用を見ながら処理を振り分けます。
実務でのモデル選択では、CarbonとArgonの役割差、API料金と提供先、推論量とコストの関係、ルーティング基準の4点が判断材料になります。
Gemini 4 Carbonは高難度タスクを担当する最上位層
Carbonは11月10日の一般提供より2週間前、Fairwind Programを通じて一部のサイバーセキュリティ防御側へ先行提供されていました。今回の発表で、有料API、企業向け環境、Google AI Ultra向けの各サービスへ利用範囲が広がっています。
Googleが示しているCarbonとArgonの役割は明確です。
| 項目 | Gemini 4 Argon | Gemini 4 Carbon |
|---|---|---|
| 基本の位置付け | 大半のソフトウェア開発・知識労働 | 最も難しい推論・長時間タスク |
| 代表的な用途 | 複雑な実務、コーディング、法務・財務、研究 | 複雑な多段階コーディング、デバッグ、科学研究、サイバーセキュリティ |
| 推論の使い方 | 深い推論を長時間維持 | Argonより多くのトークンを使い、探索・深い推論・長い検証ループを行う |
| 運用上の役割 | 日常の高難度業務を広く担当 | 難所、設計、監査、長い検証が必要な仕事へ集中 |
Carbonは、長い探索と検証を続ける仕事へ計算量を投入する特徴を持ちます。
複数ファイルや複数システムにまたがる原因調査、設計の選択肢が多いアーキテクチャ検討、長い実験ループを伴う科学研究では、この追加の推論量が価値を持ちます。
要件と完了条件が整理されたソフトウェア開発や通常の知識労働では、Google自身がArgonを主力の選択肢として位置付けています。
同じトークン単価でも、仕事1件の費用は推論量で変わる
APIの導入価格はCarbonとArgonで共通です。2026年11月30日までは、100万入力トークンあたり2ドル、100万出力トークンあたり10ドルです。12月1日からは、両モデルとも100万入力トークンあたり4ドル、100万出力トークンあたり20ドルが適用されます。
| 期間 | 入力100万トークン | 出力100万トークン |
|---|---|---|
| 2026年11月30日まで | 2ドル | 10ドル |
| 2026年12月1日から | 4ドル | 20ドル |
単価が共通でも、CarbonはArgonより多くのトークンを使って探索・推論・検証する設計です。実際の仕事1件にかかる費用は、モデル名に加えて、推論量、ツール呼び出し、再試行、処理時間まで含めて見る必要があります。
提供経路にも違いがあります。
- 開発者・企業:CarbonはGoogle AI Studioの有料Gemini APIやGemini for businessなどで利用可能
- Google Antigravity:Google AI Ultraユーザー向けにCarbonを展開
- Geminiアプリ・Google検索のAI Mode:CarbonはGoogle AI Ultraユーザーへ展開
- Argon:GeminiアプリとAI ModeではGoogle AI ProとUltraの両方へ提供
APIでモデルを直接選ぶ開発と、Googleの各サービスで利用する場合では、選べる契約や提供経路も確認項目になります。
外部ベンチマークでは「推論量をどこまで上げるか」も選択肢になる
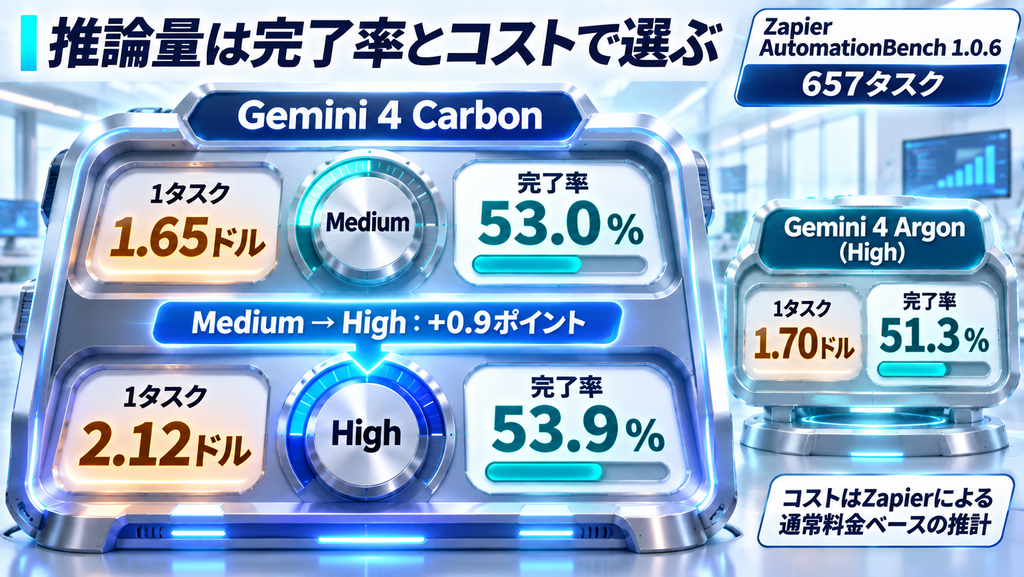
ZapierのAutomationBench 1.0.6は、営業、マーケティング、業務、サポート、財務、人事の6分野で、業務ツールを使った657件のエンドツーエンドタスクを評価しています。
Carbonの結果は、推論努力の設定によって変わりました。
| モデル・設定 | 完了率 | 1タスクあたりコスト |
|---|---|---|
| Carbon Low | 31.5% | 1.02ドル |
| Carbon Medium | 53.0% | 1.65ドル |
| Carbon High | 53.9% | 2.12ドル |
| Argon High | 51.3% | 1.70ドル |
このコストはZapierが通常料金を使って算出した推計値で、現在の導入価格による実請求額とは別です。
Carbonの完了率はLowからMediumで21.5ポイント上がり、MediumからHighでは0.9ポイント上がりました。MediumはHighより低い推計コストで、Argon Highを上回る完了率を記録しました。
CursorBench 4.0でも、曖昧な複数ファイル作業に対してCarbon Highが60.4%、Mediumが60.1%、Argon Highが52.9%でした。ここでもCarbonのMediumとHighは近いスコアです。
ベンチマークの結果は特定の評価環境を示します。実務では、自分の仕事でMedium相当の推論量が十分か、Highへ上げることで失敗や人のレビューがどこまで減るかを測る材料として使えます。
公式の役割分担から作る、実務向け5つのルーティング軸
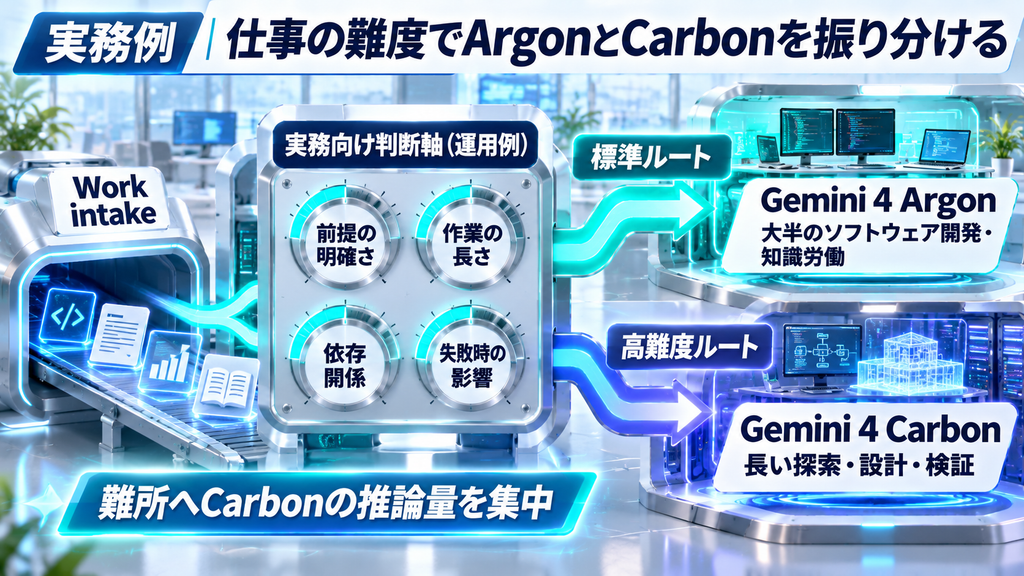
以下の5軸は、Googleが示すCarbonとArgonの役割分担を、実務上のルーティング条件へ置き換えた運用例です。前提の明確さ、作業の長さ、依存関係、失敗時の影響、エージェント構成の5軸で、振り分け条件を具体化できます。
| 実務上の判断軸 | Argonを置きやすい条件 | Carbonを置きやすい条件 |
|---|---|---|
| 前提の明確さ | 対象、条件、完了判定が整理済み | 前提調査や仮説形成から必要 |
| 作業の長さ | 既知の工程を順に実行 | 長い探索、反復、検証ループ |
| 依存関係 | 単一領域や限定されたシステム | 複数システム・複数資料を横断 |
| 失敗時の影響 | テストで早く戻せる | 設計判断や監査など再作業が重い |
| エージェント構成 | 単独または定型ワークフロー | 複数エージェントの統括・監査 |
前提と完了条件が明確ならArgonから始める
修正対象、参照資料、完了条件、テスト方法が整理されている仕事は、Argonを主力に置きやすい領域です。
たとえば既存仕様に沿った機能追加、定型的な分析、決められた形式の資料作成では、必要な判断範囲が見えています。こうした仕事は、完了率と処理費用を記録しながらArgonで回すことで標準ルートを作れます。
調査・設計・検証が一体ならCarbonを検討する
Carbonの対象は、答えを出す前に広い探索が必要な仕事です。
複数の設計案を比較するアーキテクチャ設計、原因が複数箇所にまたがる不具合調査、研究資料から仮説を立てて検証を繰り返す作業、複雑な脆弱性の分析などが当てはまります。
GoogleはCarbonについて、複雑な多段階コーディングとデバッグ、オープンエンドな科学研究を代表例として挙げています。
Carbonを統括役に置き、軽い処理を別モデルへ振り分ける
Google Antigravityでは、Carbonの一般提供と合わせて「/swarm」がプレビューされています。1つのプロンプトから複数エージェントを協調させる機能です。
Googleは、Carbonをアーキテクチャ設計、調整、監査といった深い推論が必要な役割へ置き、より高速で軽いモデルを並列ワークスペースで組み合わせる使い方を示しています。
この構成は、モデルの使い分けを1回ごとの手動選択から、ワークフロー内部の役割分担へ広げます。
たとえばソフトウェア開発なら、次のように分けられます。
- Carbonが要件とリポジトリ全体を読み、設計方針を決める
- 複数の実装担当へ範囲を分割する
- 軽いモデルが独立した作業領域で実装やテストを進める
- Carbonが変更を横断確認し、矛盾や抜けを監査する
- 最終テストと人のレビューで完了を判定する
Carbonの推論量は、難しい判断と全体整合へ集中させる構成にすると、モデル階層の役割を活かしやすくなります。
完了した仕事を単位にコストを評価する
現在のCarbonとArgonはトークン単価が共通です。実務の費用差は、1件の仕事を終えるまでに使うトークン、ツール実行、再試行、人のレビュー時間から生まれます。
確認したい指標は次のようになります。
- タスク1件あたりの入力・出力トークン
- 推論努力の設定
- 完了までの再試行回数
- 人が修正した回数と内容
- テストや評価の合格率
- 完了までの経過時間
- 成功した仕事1件あたりの費用
Carbon Highで1回で終わる仕事と、Argonで複数回やり直す仕事では、再試行を含む総費用が変わります。要件が明確な仕事では、Carbonの追加推論量が成果へどれだけつながったかを完了率とレビュー結果で確認します。
モデルの役割分担とコスト管理を実運用へ落とし込んだ事例として、LegalOn TechnologiesのCodex運用も参考になります。難しい判断を高性能モデルへ集め、定型的な実装を別モデルへ振り分け、仕事単位で費用を見る考え方を整理しています。
最初に決めておきたいルーティングルール
Carbonの運用では、最初の振り分け条件と切り替え条件を決めておくと評価しやすくなります。
| 仕事 | 最初の候補 | Carbonへ寄せる条件 |
|---|---|---|
| 仕様が確定した実装 | Argon | 影響範囲が広がり設計判断が増えた |
| 定型的な資料・分析 | Argon | 複数資料の矛盾解消や深い仮説検証が必要 |
| 複数システムの設計 | Carbon | 最初からCarbonで全体構造を検討 |
| 原因不明の複雑な障害 | Carbon | 長い探索と検証を継続 |
| 複数エージェントの統括 | Carbon | 設計、分割、監査を担当 |
| 独立した実装サブタスク | Argonや軽量モデル | 上位モデルが設計した範囲を実行 |
このルールと一緒に、モデル名、推論努力、トークン量、成功・失敗、やり直し回数を記録します。数週間分の実績がたまれば、自分の環境でCarbonを使う価値が高い仕事を特定できます。
まとめ
Gemini 4 Carbonの一般提供で、Gemini 4シリーズはArgonを広い実務の主力、Carbonを最も難しい推論・長時間エージェント作業へ置く構成になりました。
両モデルはAPIのトークン単価が共通でも、Carbonはより多くのトークンを使って探索・推論・検証します。モデル選択では、単価とベンチマーク順位に加えて、タスク1件の完了率、再試行、人のレビュー、完了までの総費用を確認することが重要です。
実務では、前提と完了条件が明確な仕事をArgonへ、長い探索や設計・監査を伴う仕事をCarbonへ振り分け、結果を仕事単位で計測する方法から始められます。Carbonを統括役として使うマルチエージェント構成も、Gemini 4のモデル階層を活かす具体的な設計です。