当サイトではアフィリエイト広告を利用しています。
AIエージェントでは、すべての処理で大きな生成AIに文章を書かせる必要はありません。「次にどのツールを使うか」「この候補は採用できるか」「人へ確認を戻すべきか」のように、必要なのが選択や採点だけという場面も多くあります。
CLM-8BとTypeSafeのJevは、こうした判断を高速に処理するためのモデルです。どちらも長い文章を生成するのではなく、候補から選ぶ、数値で評価する、該当なしを返すといった処理を担当します。
ただし、使い方はかなり違います。JevはTypeSafeが提供するホスト型APIで、CLM-8BはQwen3-8Bを土台にしたオープンウェイトのモデルです。
この記事では、2026年10月3日時点のCLM-8BとJevについて、仕組み、速度評価、料金、ローカル実行、日本語利用、AIエージェント内での役割を比較します。
CLM-8BとJevの違いを先に比較
現在確認できる主な違いは次のとおりです。
| 項目 | Jev | CLM-8B |
|---|---|---|
| 提供元 | TypeSafe | Contrastive-LMプロジェクト |
| 現行モデル | Jev 1.13 | CLM-v0.1-8B |
| 提供方式 | ホスト型API | オープンウェイト・ローカル実行 |
| 主な処理 | Choice / Score / Noul | Choice / Score / Noul、候補ランキング |
| 文章生成 | しない | しない |
| 出力 | 型付きの値、確率分布、信頼度 | 候補ごとのスコア・確率 |
| 料金 | 入力100万tokenあたり0.042ドル、出力課金なし | モデル利用料なし。実行環境の費用は別途必要 |
| コンテキスト | 最大64K token | 公式クイックスタートは2,048 token。GPUメモリに応じて拡張可能 |
| カスタマイズ | 顧客ごとのFine-tuningなし | Projection headのFine-tuningが可能 |
| ライセンス | TypeSafeのサービスとして利用 | コード・CLM-8B weightsはApache 2.0 |
| 言語 | 英語が最も高精度。CJKを含む他言語も利用可能だが要検証 | Model Cardの言語は英語。日本語は用途ごとの検証が必要 |
JevはGPU環境を自分で用意せず、APIからすぐ使える構成です。CLM-8Bは自分の環境へ置けるため、ローカル運用、推論基盤の管理、用途別のFine-tuningまで含めて自分で制御できます。比較するときは、単純な「どちらが速いか」だけでなく、APIとして使いたいのか、自分でモデルを持ちたいのかを先に決める必要があります。
System Oneモデルは文章ではなく「次の判断」を返す
ChatGPTやClaudeのような生成AIへ「この3つから最適なものを選んで」と頼むと、内部では文章を1tokenずつ生成しながら回答を作ります。選択結果が1つあれば十分でも、通常の生成モデルは自然言語を作る仕組みを通ります。
JevやCLM-8Bが狙っているのは、この処理を判断専用に分けることです。
たとえばAIエージェントが次の3つを候補として持っているとします。
- Web検索を続ける
- ローカルファイルを確認する
- ユーザーへ確認を求める
判断モデルには現在の状態と候補を渡し、それぞれを評価してもらいます。必要なのは説明文ではなく、「どれを選ぶか」と、その判断にどの程度の確信があるかです。
Jevでは主に次の3種類の処理が用意されています。
- Choice:複数候補から選ぶ
- Score:条件に対して数値で評価する
- Noul:候補のどれにも当てはまらない場合を含めて判断する
CLM-8BもTypeSafe互換のAPI形式でChoice / Score / Noulを扱えます。さらに、自由に用意した複数の候補行動をまとめてランキングする使い方もできます。
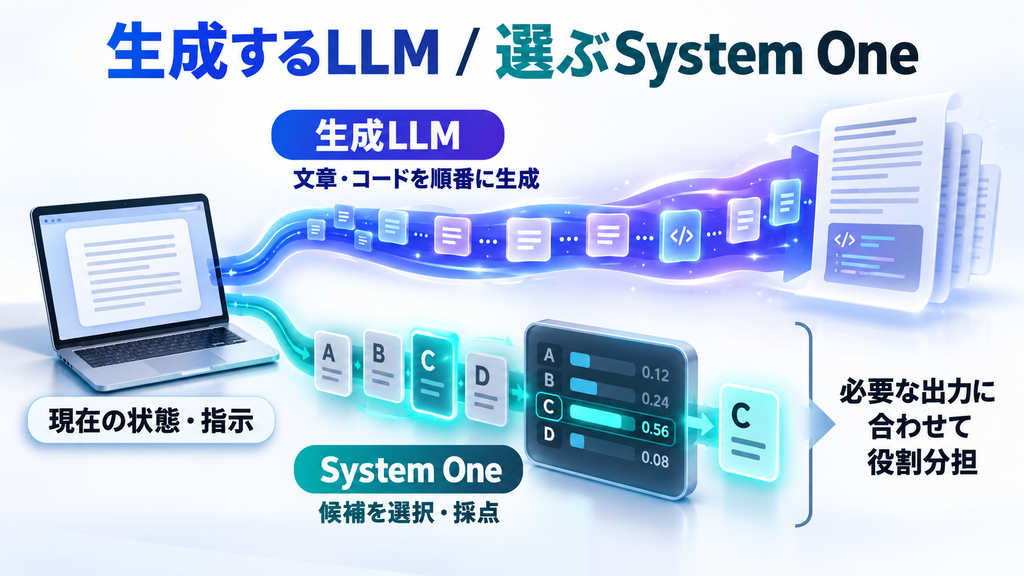
この仕組みは、大きな生成モデルを完全に置き換えるものではありません。長い計画を作る、コードを書く、文章を生成する処理は従来のLLMへ任せ、その途中で何度も発生する小さな判断を専用モデルへ分ける設計です。
JevはAPIですぐ使える判断専用モデル
TypeSafeは2026年9月に、System One Modelの最初の公開モデルとしてJevを発表しました。執筆時点の現行モデルはJev 1.13です。
Jevへ渡すのは、現在の状態と質問です。質問には選択肢や評価条件を型として指定し、返答も同じ型で受け取ります。
文章を自由生成させないため、アプリ側で結果を解析し直す必要がありません。たとえばChoiceなら選ばれた候補、各候補の確率、信頼度をそのまま後続処理へ渡せます。
現行料金は入力100万tokenあたり0.042ドルで、出力は課金対象になりません。コンテキストは1リクエスト最大64K tokenで、状態部分は最大32K tokenです。
一方、Jevは顧客ごとのLoRAやFine-tuningを提供していません。用途への調整は、状態、指示、評価基準、候補の設計を通じて行います。
Jevが苦手とする判断も公開されている
TypeSafeはJev 1.13について、次のような処理で精度が落ちやすいことを公開しています。
- 複雑な計算や数値推論
- 日付・時刻の比較
- 間接的で回りくどい指示
- 関係の薄い情報を大量に含む状態
- 矛盾する指示や敵対的な入力
などです。
Jevは型どおりの出力を返せますが、型が正しいことと判断内容が正しいことは別です。重要な操作では、信頼度に応じて別の検証処理や人の承認へ回す構成にします。
AIエージェントへ実行権限を与える際の考え方はこちらの記事で詳しく整理しています。
CLM-8Bは判断モデルをローカルへ持ち込める
CLM-v0.1-8Bは、Qwen3-8Bを土台にしたContrastive Language Modelです。通常のQwen3-8Bをそのまま文章生成に使うのではなく、凍結したQwen3-8BのEncoderに、状態用と候補行動用の小さなProjection headを追加しています。各Projection headは約2,000万パラメータです。
現在の状態と候補行動をそれぞれベクトルへ変換し、その近さから候補を評価します。
この方式には、候補側の計算結果を先に保存できる利点があります。
たとえばエージェントが毎回同じ100種類のツールから1つを選ぶ場合、100個の候補を毎回最初から計算する必要はありません。候補側のEmbeddingをキャッシュしておき、その時点の状態だけを新しく計算して比較できます。
同じ候補集合から何度も選択する処理ほど、この構造を活かせます。
24GB GPUは公式クイックスタートの構成例
CLMの公式クイックスタートでは、Qwen3-8BをvLLMで起動し、最大コンテキストを2,048 tokenに設定する例が掲載されています。24GB GPUへ収めることを意識した構成例で、必要VRAMは量子化、コンテキスト長、実行方式によって変わります。
公式リポジトリには最大長を8,192 tokenへ増やす設定例もあり、その分GPUメモリが必要です。CLM-8Bではモデル利用料とは別に、GPU、推論サーバー、監視、更新を自分で持つコストも比較対象になります。
「最大9倍低遅延」はCLM開発チームによる評価
CLM開発チームは、コンピューター操作、ゲーム、ツール呼び出しの評価で、CLM-8BがJevと同程度の品質を保ちながら最大9倍低いレイテンシになったと報告しています。候補行動をキャッシュし、約1,000候補から選ぶ条件では13倍高速だったという結果も公開しています。
この比較はCLM開発チーム自身による評価で、現在のJev 1.13と第三者が同一環境・同一条件で比較した結果ではありません。
Jev側も、自社評価として70〜500ms程度のend-to-endレイテンシや、生成LLMより低コスト・高速な判断処理を示しています。
現時点では、両者の公開数字を並べただけで「CLM-8Bの方が常に速い」とは判断できません。実際の状態長、候補数、ネットワーク遅延、GPU、キャッシュの有無によって結果が変わります。
81.6%・87.6%はVerifierとして候補を選んだ評価
CLMプロジェクトは、Fine-tuningしたVerifierを使い、DeepSWEで81.6%、Terminal-Bench 2.1で87.6%という結果も公開しています。この数値はCLM-8B単体のコード生成性能ではなく、生成済みの候補から解答を選ぶVerifierとしての評価です。
DeepSWEではOpus 5、Terminal-BenchではFable 5が複数の候補解を生成し、その候補の中からFine-tuning済みCLM Verifierが良いものを選びました。
つまり、この評価が示しているのは生成役と評価役を分けたときのVerifierとしての能力です。Zero-shotのCLM-v0.1-8Bをそのまま使った性能とも区別する必要があります。
AIエージェントでは「考える役」と「選ぶ役」を分けられる
CLM-8BやJevの使いどころは、AIエージェント全体の中へ置くと明確になります。
たとえば次のような構成です。
- 大きな生成LLMが計画や候補を作る
- CLM-8BまたはJevが候補を採点する
- 信頼度が高ければ次の行動へ進む
- 信頼度が低い、または重要操作なら人や強いモデルへ戻す
- 実行結果を次の状態として、再び判断する
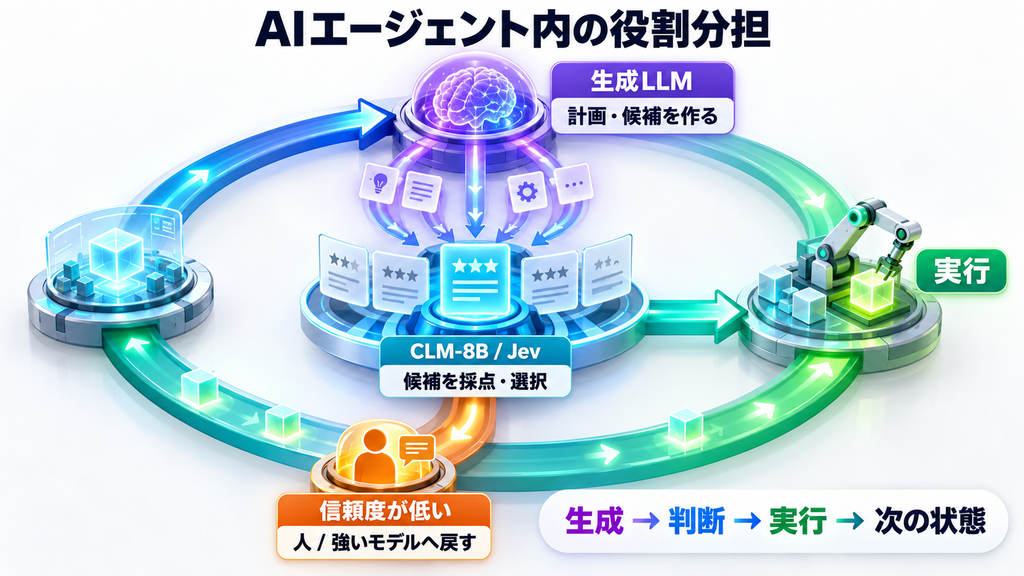
この分担なら、毎回すべての判断へ高価なモデルを呼ぶ必要はありません。逆に、判断モデルだけで長い計画やコードまで作らせる必要もありません。
複数モデルを役割ごとに組み合わせる考え方は、GitHub Project HydraFusionの記事でも扱っています。
AIエージェントではモデル単体だけでなく、どのモデルへ何を任せるか、失敗時にどう戻すかまで含むハーネスが重要です。
日本語で使うなら独自評価が必要
日本語利用では、JevとCLM-8Bで確認できる情報量に差があります。Jevは英語を中心に学習しており、TypeSafeは英語で最も高い精度になると案内しています。CJKを含む他言語も入力できますが、同等精度を保証しているわけではありません。
CLM-v0.1-8BのModel Cardで明示されている言語は英語です。基盤のQwen3-8Bが多言語を扱えることだけを理由に、CLMの判断性能も日本語で同等とは判断できません。
日本語の分類やルーティングへ使う場合は、本番で使う文章と候補を用意し、正解率、候補順による変化、信頼度の校正まで確認してから組み込む必要があります。
JevとCLM-8Bはどちらを選ぶ?
用途によって選択基準が異なります。
Jevが候補になる場合
- GPUや推論サーバーを管理したくない
- APIからすぐにChoice / Score / Noulを使いたい
- 長めの状態をそのまま判断へ渡したい
- モデルの更新やホスティングをサービス側へ任せたい
CLM-8Bが候補になる場合
- 判断処理をローカルまたは自社環境で動かしたい
- オープンウェイトを使いたい
- 同じ候補行動を大量に繰り返し評価したい
- 用途専用のVerifierへFine-tuningしたい
- 推論基盤まで自分で管理できる
どちらを選んでも、文章生成や複雑な長時間推論まで置き換えるモデルではありません。
生成LLMは候補を作る。判断モデルは選ぶ。コードや人が実行条件を管理する。
この役割分担が、CLM-8BとJevを見るときの中心になります。
まとめ
CLM-8BとJevは、AIエージェントの中で頻繁に発生する「選ぶ・採点する・該当なしを判定する」処理を、文章生成から切り離すためのモデルです。
Jevはホスト型APIからすぐ使え、CLM-8Bはオープンウェイトを自社環境へ置いて運用・Fine-tuningできます。公開されている速度評価は条件が異なるため、比較ではレイテンシの数字だけでなく、API運用かローカル運用か、候補数、キャッシュ、必要なカスタマイズまで見る必要があります。
AIエージェントが長時間・大量に動くほど、判断のたびに大きな生成モデルを呼ぶコストは積み上がります。生成、判断、検証、実行をどのモデルや仕組みへ分けるかが、CLM-8BとJevを使うときの判断軸です。