当サイトではアフィリエイト広告を利用しています。
OpenAIは2026年11月16日、医療チーム向けcomputer-use agentsの評価結果と導入事例を公開しました。2026年11月16日時点で、computer useはOpenAI APIから利用でき、ChatGPT WorkとCodexでも提供されています。ChatGPT側での利用はワークスペース設定の対象です。
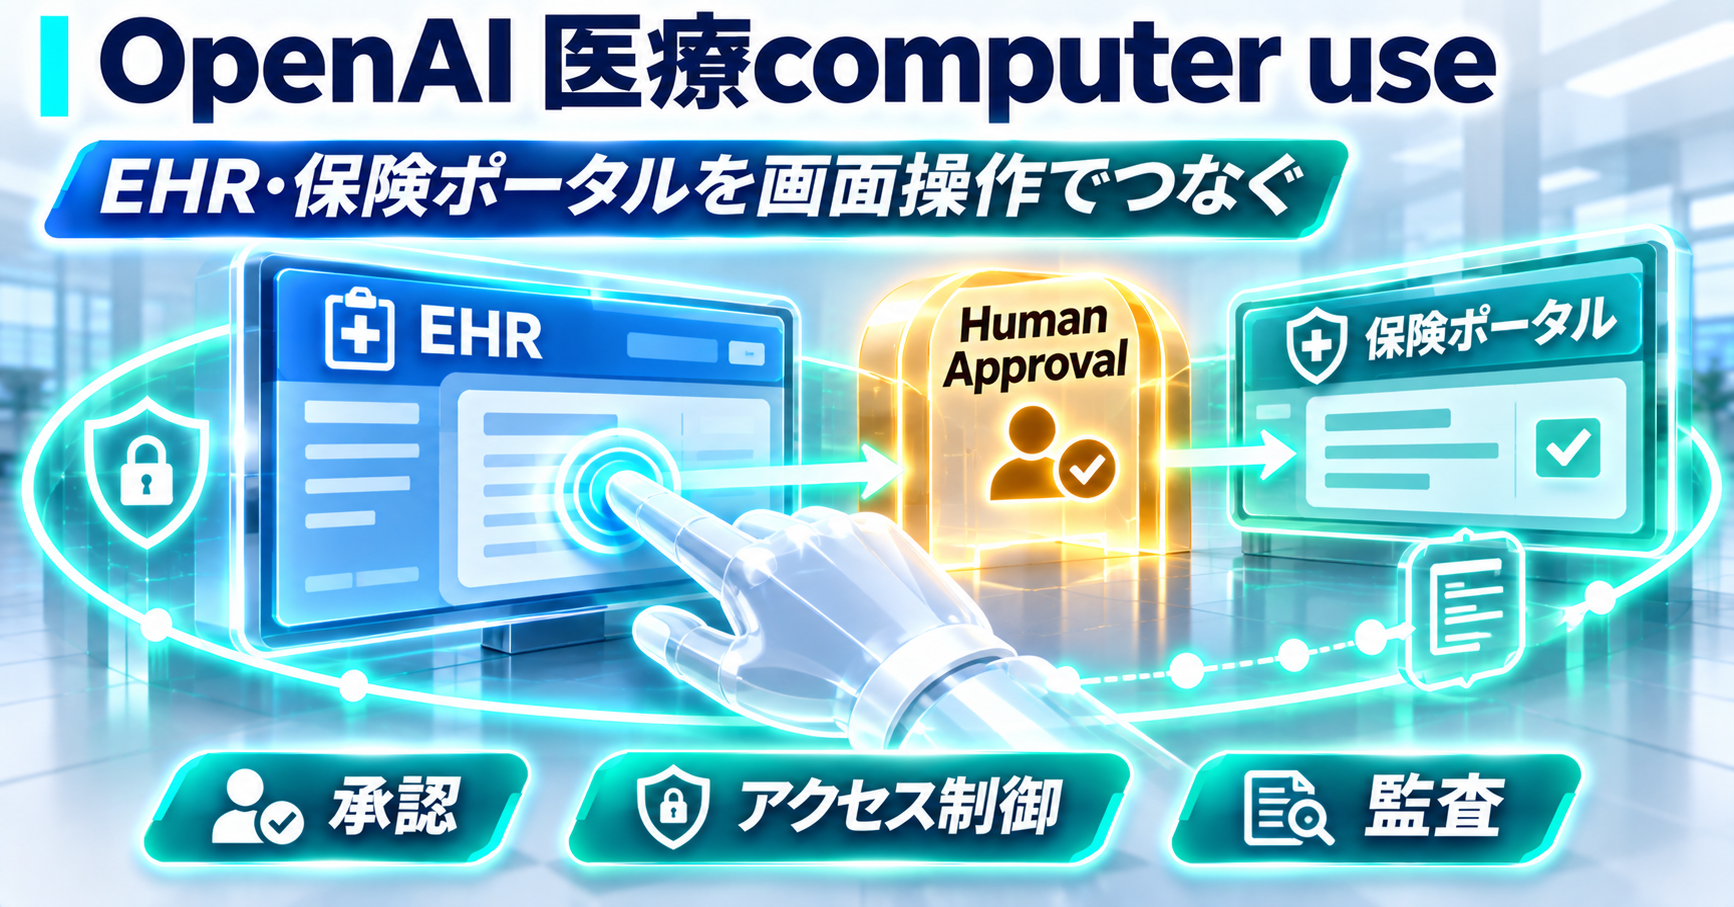
computer useは、AIが画面を読み、クリックや入力を行い、複数のアプリケーションをまたいで作業する仕組みです。医療では、EHR(電子健康記録)、保険会社のポータル、紹介・文書送信などの既存システムを横断し、APIの対応範囲外にある画面操作を補完できます。
実運用では、エージェントが触れるアプリを限定し、臨床判断や送信・確定操作の前に人のレビューを置き、スクリーンショットや操作記録で結果を検証できる状態を作ります。さらに、安全性・有用性・業務性能・コストを別の指標で測ることで、どこまで自動化できるかを判断できます。
医療computer useは既存システム間の画面操作をつなぐ
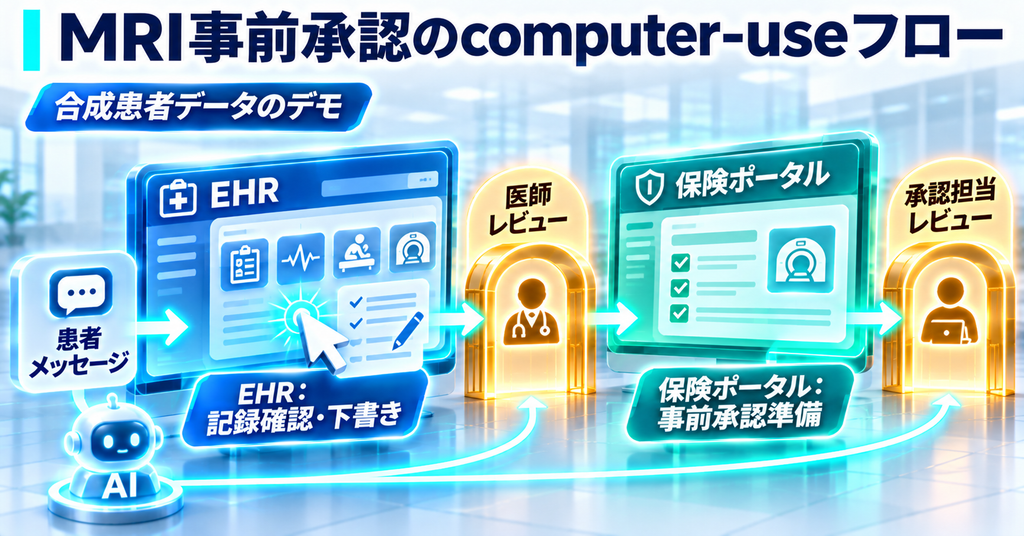
OpenAIが公開したデモでは、腰痛を訴える患者のMRI検査を例に、EHRと保険会社のポータルをまたぐ流れを示しています。デモには合成患者データが使われています。
computer-use agentはEHR内の受診記録、理学療法の記録、過去の画像検査を確認し、MRIのオーダー、診療記録、患者への返信を下書きします。これらは臨床家がレビューする前提です。
その後、同じ記録を使って保険会社のポータルへ移り、MRIの事前承認リクエストを準備します。こちらは承認業務の担当者がレビューします。
この流れでは、AIが一つの画面で文章を作る役割から、複数システムを移動しながら次の作業へ進む役割へ広がっています。
| 工程 | computer useが行う作業 | 制御・レビュー |
|---|---|---|
| EHR確認 | 受診記録、理学療法、画像検査などを読む | 組織が対象アプリとアクセス範囲を設定 |
| 臨床文書の準備 | MRIオーダー、診療記録、患者返信を下書き | 臨床家が内容をレビュー |
| 保険ポータル操作 | 必要情報を移し、事前承認リクエストを準備 | 承認業務の担当者がレビュー |
| 次工程への引き継ぎ | 同じ患者文脈を使って別システムへ進む | 組織が承認手順を設定 |
CVS Healthでも、文書送信、紹介処理、専門医相談など、既存アプリケーションをまたぐ業務にcomputer useを使っています。OpenAIの発表では、ある本番ワークフローが数カ月分の文書送信バックログを週末で処理し、別の仕組みは1日数万件の相談に必要なシステム操作を担当しています。
Abridgeは退院時の調整、Cigna Healthcareは複数システムに分散した会員情報の収集、Ambienceは保険会社サイトでの事前承認準備といった用途を公開しています。
人の承認は臨床判断と確定操作の前に置く
医療computer useでは、エージェントが進める工程と、人へ戻す工程を先に決めます。
OpenAIのMRIデモでは、患者への返信やMRIオーダーは下書きの状態で臨床家へ渡され、保険ポータル側の事前承認リクエストも担当者が確認します。
Ambienceの例では、患者記録に曖昧な点があるとエージェントが停止し、臨床家へ確認します。提出前にも承認を待つ構成です。
OpenAIのcomputer use向け安全ガイドも、実アカウントや実データへ影響する操作では次の制御を求めています。
- ブラウザやVMなど実行環境を限定する
- 許可するサイトや操作を絞る
- 画面上のテキストを信頼済み命令として扱わない
- データ送信や取り消しにくい変更の前に確認を入れる
- ステップ数、時間、コストなど実行上限を持たせる
- 最終結果を実システム上で確認する
医療では「どこまで考えさせるか」と「どこまで確定操作させるか」を別に設定できます。文章の下書きや情報収集を自動化し、診療判断や提出・送信の前に人へ戻す設計が取りやすくなります。
アクセス制御で操作範囲を決め、監査ログで利用状況を確認する
ChatGPT for Healthcareは、ロールベースアクセス制御(RBAC)と監査ログを備えています。RBACは利用者の役割に応じて機能や接続先を制限し、監査ログは利用状況を後から確認するために使います。組織はcomputer-use agentが使うアプリケーションや環境も設定できます。
OpenAIの医療向け発表では、組織が承認ステップとエージェントのアクセス範囲を構成できると説明しています。
医療computer useの制御項目は、アクセス権限、承認、実行環境、監査を含め、次のように分けられます。
| 項目 | 設計する内容 |
|---|---|
| 利用者権限 | 誰がcomputer useを使えるか |
| アプリ権限 | EHR、保険ポータルなど触れてよい接続先 |
| 操作権限 | 読み取り、入力、送信、確定など許可する操作 |
| 承認 | どの操作で人へ戻すか |
| 監査ログ | ChatGPT for Healthcareの利用状況を後から確認するための記録 |
| 実行環境 | ブラウザ、VM、セッション、ネットワーク境界 |
HIPAA対応のワークフローでは、OpenAIとのBusiness Associate Agreement(BAA)の対象となるサービスを使い、必要なセキュリティ設定とデータ保持設定を適用し、接続先システムにも保護を広げる必要があります。
AIエージェントの権限を読み取り・書き込み・外部操作に分け、重要操作だけ人の承認へ回す考え方は、次の記事で詳しく整理しています。
CUA Agent Kitのスクリーンショットやトレースも保護対象になる
CVS Healthは本番運用で、検証チェック、人の監督、スクリーンショット、操作記録を組み合わせています。
CVS Healthが公開したCUA Agent Kitでも、computer-use agentの実行時にスクリーンショット、アクション履歴、ターゲット情報、トレースを保存できます。これらは、操作が正しく終わったかを後から確認する材料になります。ここで扱う実行証跡はCUA Agent Kitが保存するもので、前節のChatGPT for Healthcareの監査ログは同製品が備える管理機能です。
同じAgent Kitのセキュリティ説明では、トレースやログに認証情報、Cookie、セッショントークン、ネットワーク要求・応答、DOMスナップショットなどが含まれる場合があると明記されています。
医療データを扱う環境では、監査証跡そのものも機微情報として扱います。ログを残す設計と同時に、次の項目を決めておく必要があります。
- 誰が監査証跡を閲覧できるか
- どこへ保存するか
- 保存時に暗号化するか
- 何日・何カ月保持するか
- いつ削除するか
- 外部へ共有するときにどこまでサニタイズするか
監査性を上げるほど証拠データが増えるため、操作権限とログ権限を別に管理する設計が必要です。
評価は臨床安全性・有用性と業務性能・コストを分ける
OpenAIは、臨床ワークフローと医療事務ワークフローで異なる評価を行っています。
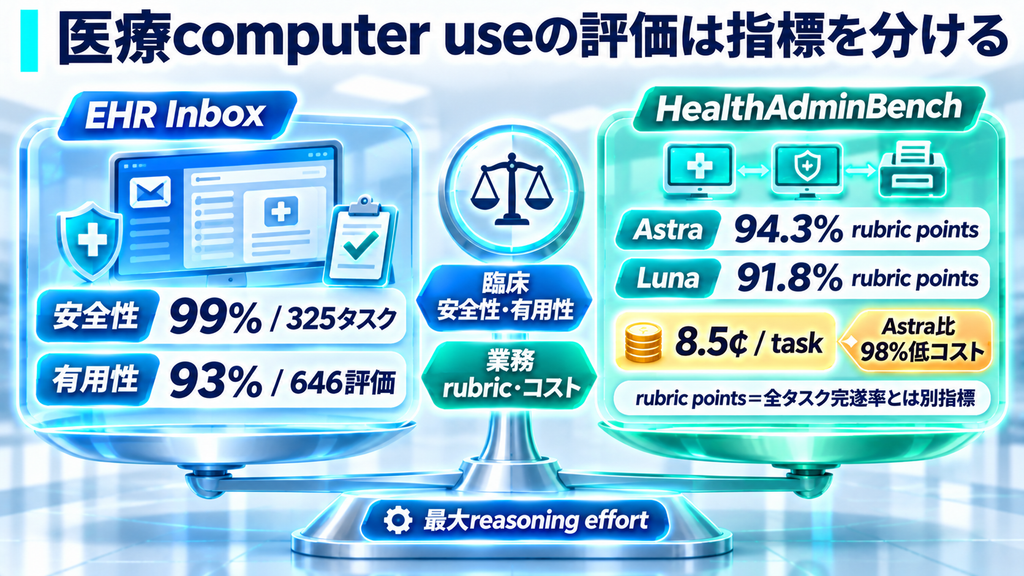
EHR受信箱の評価では、GPT-6 Astraが患者の長期的な文脈を読みながら複数ステップの作業を行い、生成したノート、オーダー、患者メッセージと操作内容を医師が評価しました。
| 評価対象 | OpenAIの公開結果 | 指標の意味 |
|---|---|---|
| 臨床安全性 | 325件のレビュー対象タスクの99% | 不正確さ、欠落、操作が患者への害につながり得るか |
| 有用性 | 646件の評価の93% | 医師が5段階で「very helpful」または「extremely helpful」を選択 |
| HealthAdminBench:GPT-6 Astra | 94.3% | available rubric pointsの取得率 |
| HealthAdminBench:GPT-6 Luna | 91.8% | available rubric pointsの取得率 |
| GPT-6 Lunaのコスト | 1タスク8.5セント | Astraより98%低コスト |
| 推論設定 | 両モデルとも最大reasoning effort | 比較時の共通条件 |
安全性99%は325件のレビュー対象タスク、有用性93%は646件の医師評価を分母にしています。比較時は分母を分けて読みます。
HealthAdminBenchはStanford研究者が公開した独立ベンチマークです。135件の合成タスクを、EHR、2種類の保険者ポータル、FAXシステムを模した環境で実行し、事前承認、異議申立て、医療機器注文などの医療事務ワークフローを評価します。
OpenAIが今回公表した94.3%と91.8%は「available rubric points」の取得率です。評価項目の得点率として扱い、全タスク完遂率とは区別して読みます。
利用者向け健康AIの評価では、回答品質、医学的根拠、理解、信頼、安全性など別の軸も必要になります。Apple Health AI Usage Studyで使われている評価設計は、次の記事で整理しています。
CVS HealthはAIで手順を見つけ、反復部分をコードへ落とす
CVS Healthが公開したCUA Agent Kitは、computer useを本番で繰り返す方法として別の実装パターンも示しています。
最初にOpenAIのcomputer-use agentが自然言語で書かれたワークフローを実行し、成功した操作のスクリーンショット、アクション、ターゲット、トレースを記録します。
その証拠を使ってCodexのSkillがPlaywrightまたはpywinautoの決定論的なコードを作成・更新します。手順が安定した後の反復実行は、モデル呼び出しを使わずに動かせます。
この方式では、役割を二つに分けられます。
- 発見:AIが画面を操作し、業務手順を見つける
- 反復:確認済みの手順をコードとして繰り返す
画面構成が変わった場合は、実行トレースを使ってCodexが原因を調べ、エンジニアのレビュー、テスト、検証を経てコードを更新できます。
反復部分をコードへ移すと、実行のばらつきと推論コストを管理しやすくなります。computer useでは、発見・例外処理・保守にAIを使い、安定した反復処理をコードへ寄せる構成も選べます。
医療computer useは7項目で導入条件を確認する
OpenAIの評価、ChatGPT for Healthcareの管理機能、CVS Healthの実装例を合わせると、医療computer useの導入条件は次の7項目に分けられます。
| 確認項目 | 決める内容 |
|---|---|
| 対象業務 | 事前承認、紹介、文書送信など、どのワークフローを任せるか |
| アクセス範囲 | どの利用者・アプリ・患者記録へ到達できるか |
| 実行環境・安全制御 | ブラウザ・VM・ネットワーク境界の限定、画面上のテキストを信頼済み命令として扱わない対策、ステップ数・時間・コストの実行上限 |
| 人の承認 | 臨床判断、曖昧な記録、送信・確定操作のどこで止めるか |
| 結果検証 | スクリーンショット、操作記録、最終画面で何を確認するか |
| 監査・データ管理 | 証跡の保存先、閲覧権限、暗号化、保持・削除をどう管理するか |
| 評価・コスト | 安全性、有用性、rubric points、完遂率、1タスク当たりコストをどう測るか |
この7項目を先に固定すると、業務ごとに許可する操作と確認方法を決めたうえで、自動化範囲を調整できます。
まとめ
OpenAIの医療向けcomputer-use agentsは、EHR、保険ポータル、紹介・文書送信などの既存システムを画面操作でつなぎ、医療・保険業務の複数ステップを進めます。
実運用の制御点は、対象アプリと実行環境の限定、画面上の外部入力への対策、ステップ数・時間・コストの実行上限、人の承認、結果検証、監査ログ、データ保護、評価指標です。OpenAIのMRIデモやAmbienceの事例では臨床判断と提出前に人へ戻す流れが示され、CVS Healthはスクリーンショットと操作記録を使った検証を本番運用へ組み込んでいます。
評価では、臨床安全性・有用性と、医療事務ワークフローのrubric points・コストを分けて読みます。さらにCVS Healthの公開Agent Kitは、AIで業務手順を発見し、安定した反復処理を決定論的なコードへ移す実装方法を示しています。
公式情報・参照先
- Advancing computer-use agents for healthcare teams|OpenAI
- More ways to move care forward with ChatGPT for Healthcare|OpenAI
- Computer use|OpenAI API
- ChatGPT for Healthcare|OpenAI Help Center
- HealthAdminBench|Stanford Shah Lab
- Measuring What Medical AI Can Actually Do|Stanford HAI
- CUA Agent Kit|CVS Health GitHub