当サイトではアフィリエイト広告を利用しています。
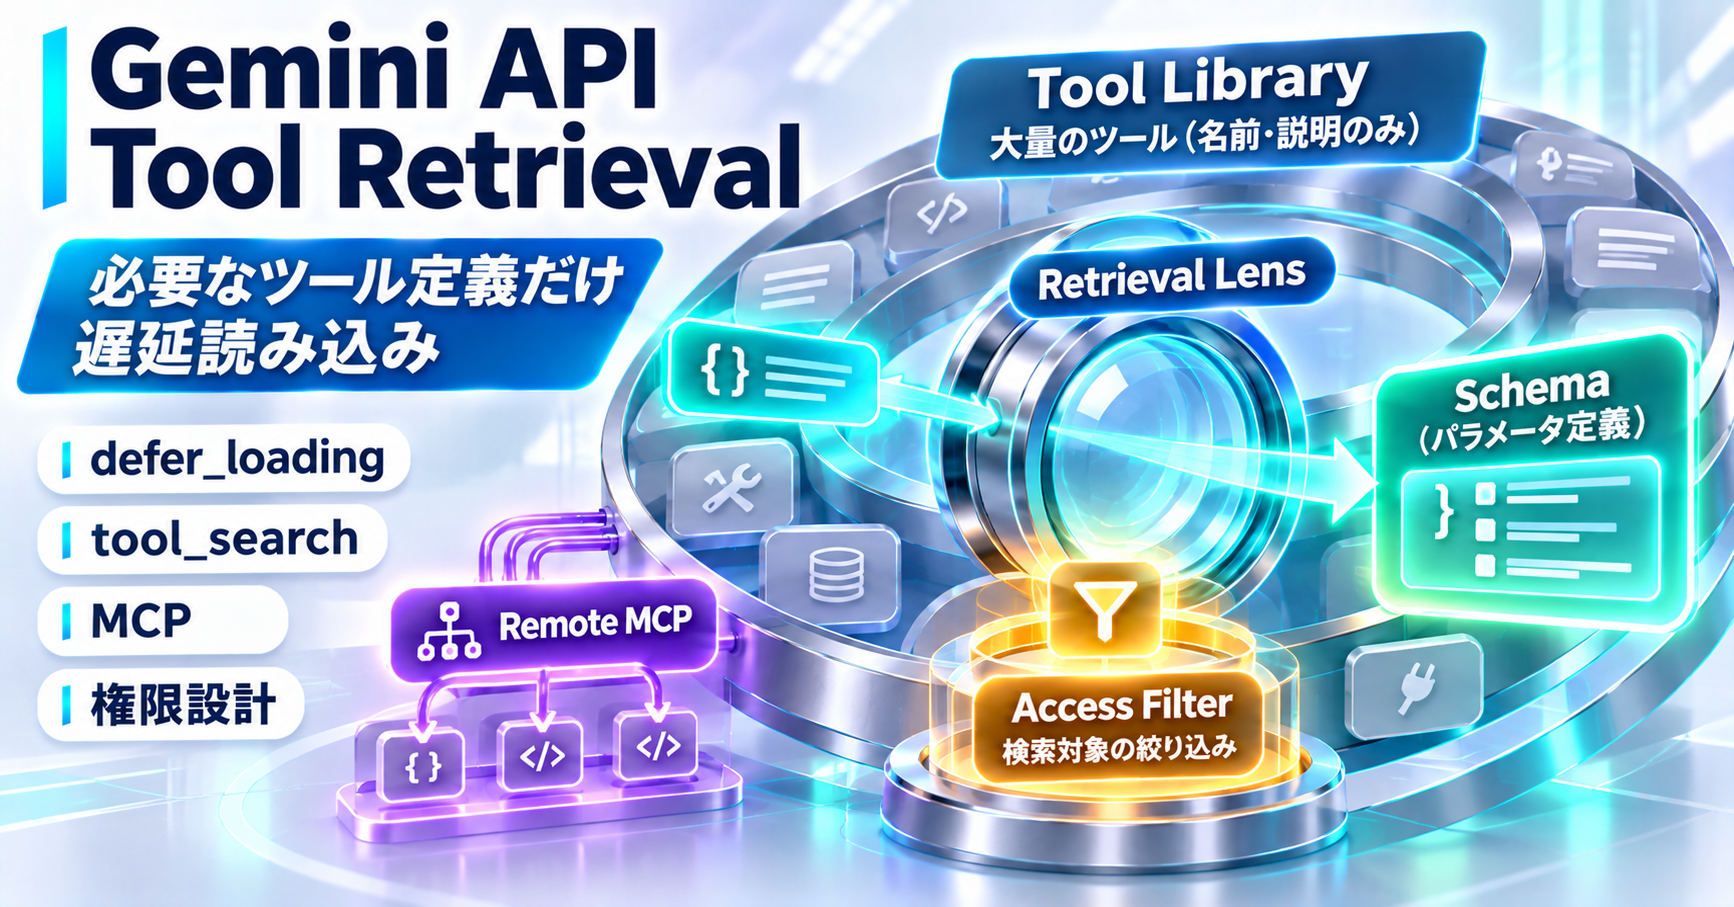
Googleは2026年11月19日、Gemini APIのInteractions APIへ「Tool Retrieval」をプレビュー追加しました。AIエージェントが数十〜数百のツールを持つとき、すべてのパラメータスキーマを毎回コンテキストへ入れる代わりに、必要なツールのスキーマだけをオンデマンドで読み込めます。
基本設定は、サーバー側Retrievalなら{"type": "tool_search"}を追加し、遅延読み込みしたいfunctionまたはmcp_serverへdefer_loading: trueを付けます。モデルには遅延対象ツールの名前と説明が見え、パラメータスキーマは検索で選ばれた時点に読み込まれます。
Tool Retrievalは、コンテキスト量、ツール選択、遅延、料金、権限設計をまとめて考える機能です。サーバー側Retrievalは大きく固定されたツール群、クライアント側Retrievalは独自レジストリやユーザー別ツール集合に向いています。Remote MCPサーバーにも遅延読み込みを適用できます。
2026年11月20日時点ではプレビュー機能で、Interactions APIだけが対象です。公式ドキュメントの対応モデルはGemini 4 Hydrogen、Gemini 4 Argon、Gemini 3.8 Flash、Gemini 3.6 Flashです。
- Tool Retrievalはツール定義を必要な時点まで遅らせる
- 3つの方式はツール集合の性質で使い分ける
- サーバー側Retrievalはtool_searchとdefer_loadingで動く
- short_descriptionで検索時の説明を短くできる
- Remote MCPではサーバー配下のツールをまとめて遅延読み込みできる
- クライアント側Retrievalは検索・ランキング・絞り込みをアプリ側で持つ
- 権限管理は「検索対象」と「実行許可」を分けて設計する
- Tool Retrievalの料金は検索回数と読み込むスキーマで変わる
- 読み込まれたツールは会話の残りでコンテキストに残る
- Interactions APIでは毎回tools配列を送る
- 導入時はツール数・検索頻度・ユーザー差分を測る
- 現在の制約と対応モデル
- まとめ
- 公式情報・参照先
Tool Retrievalはツール定義を必要な時点まで遅らせる
Function callingでは、モデルがツールを選ぶために、通常はツール名、説明、パラメータのJSON Schemaをコンテキストへ渡します。
ツール数が少ない場合は、この静的読み込みがシンプルです。ツールが増えると、長いパラメータスキーマが入力トークンを占め、モデルが候補から適切なツールを選ぶ負荷も増えます。
Tool Retrievalでは、遅延対象ツールについて初期コンテキストへ次の情報だけを残します。
- ツール名
- 説明、または
short_description - 遅延対象ツールの一覧
パラメータスキーマは、モデルがそのツールを必要と判断して検索した時点で追加されます。
たとえば注文管理、顧客管理、請求、配送、在庫、CRMなどを一つのエージェントへ接続すると、各サービスが複数の関数を持ちます。毎回使うツールは一部なので、長いツール群を「常時読み込むもの」と「必要時に探すもの」へ分ける設計ができます。
3つの方式はツール集合の性質で使い分ける
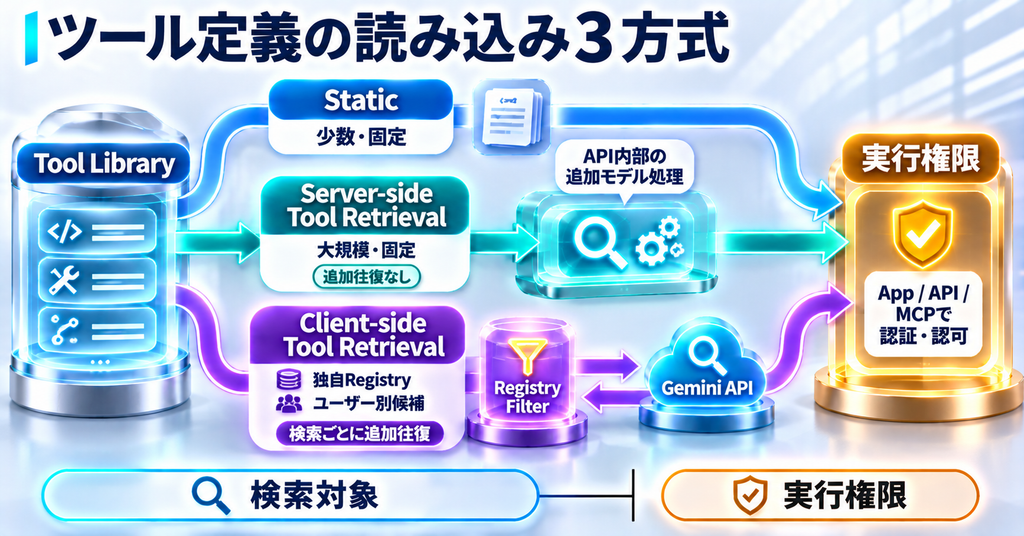
Gemini APIのTool Retrievalドキュメントは、静的読み込み、サーバー側Retrieval、クライアント側Retrievalを次のように分けています。
| 方式 | ツールの渡し方 | 検索時の処理 | 向く構成 |
|---|---|---|---|
| 静的読み込み | 全スキーマを毎回渡す | 検索処理なし | 少数で安定したツール群 |
| サーバー側Retrieval | 宣言済みツールからGeminiが必要なスキーマを読み込む | クライアント↔Gemini APIの追加往復なし。検索はAPI内部で処理 | 大規模だが固定されたツール群 |
| クライアント側Retrieval | アプリ側が検索し、該当スキーマを返す | 1検索ごとにクライアント↔Gemini APIの追加往復が1回 | 独自レジストリ、名前空間、ユーザー別ツール集合 |
公式ドキュメントでは、静的読み込みは「おおむね20未満の安定したツール」、サーバー側は「大規模だが固定されたツールライブラリ」、クライアント側は「独自レジストリ、名前空間、ユーザー別ツール集合」を目安として挙げています。
適した方式は、ツール数、会話コンテキストの長さ、検索頻度、ツール集合がユーザーごとに変わるかで決まります。
サーバー側Retrievalはtool_searchとdefer_loadingで動く
サーバー側Retrievalでは、リクエストにtool_searchを1つ追加し、遅延対象のツールへdefer_loading: trueを設定します。
最小構成の考え方は次の形です。
tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "issue_refund",
        "description": "Refund an order.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string"}
            },
            "required": ["order_id"]
        },
    },
]
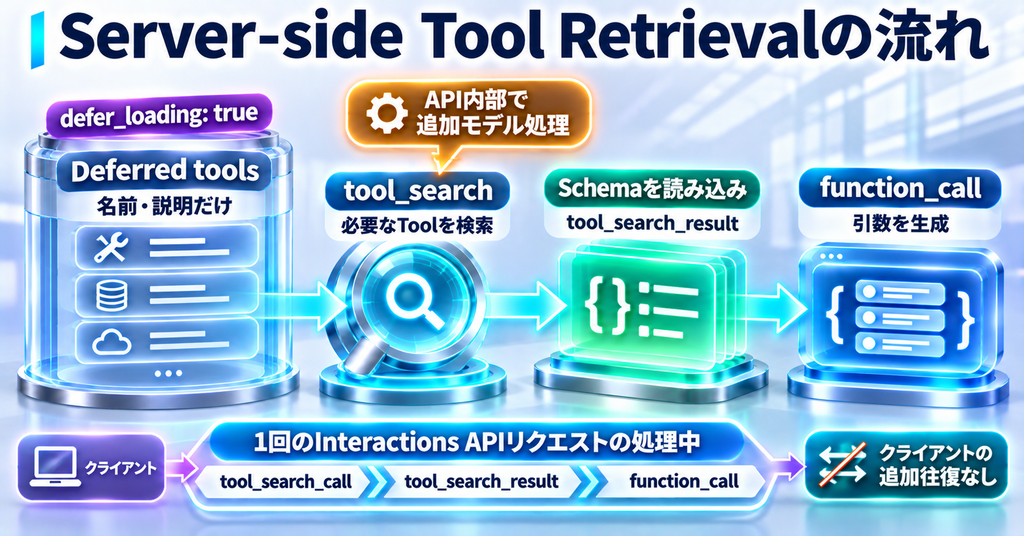
実行時は次の順序で進みます。
- モデルは遅延対象ツールの名前と説明を見る
- 必要なツールを選ぶため
tool_search_callを出す - APIが該当ツールの完全なスキーマを返す
tool_search_resultとしてInteractionに記録される- モデルが引数付きの
function_callを出す - アプリが関数を実行し、通常どおり
function_resultを返す
サーバー側Retrievalでは、クライアントからGemini APIへ送った1回のInteractions APIリクエストの処理中に、検索、スキーマ読み込み、function_callの判断まで進みます。検索のためにクライアント↔Gemini APIの追加往復は発生しません。Gemini API内部では検索ごとに追加のモデル処理が行われ、interaction.stepsにはtool_search_call、tool_search_result、function_callが残るため、どのツールが検索されたかを追えます。
サーバー側Retrievalでは検索用のインデックスを自前で構築・ホストする必要がありません。よく使うツールを常時読み込み、利用頻度の低い長いツール群だけを遅延対象にできます。
short_descriptionで検索時の説明を短くできる
defer_loading: trueを付けたFunctionには、任意でshort_descriptionを設定できます。
通常のdescriptionが長い場合でも、検索用には短い説明だけを初期コンテキストへ載せられます。たとえば「過去日付や丸め方法も指定できる通貨変換」のような詳細説明を持つ関数でも、検索時には「通貨を変換する」といった短い説明へ圧縮できます。
Googleは、利用頻度の高いツールを常時読み込みし、長いテールの専門ツールを遅延対象にする方法を推奨しています。似たツールが複数ある場合は、サービス名を関数名や短い説明の先頭へ入れて区別する方法も案内しています。
Remote MCPではサーバー配下のツールをまとめて遅延読み込みできる
Remote MCPサーバーにもdefer_loading: trueを設定できます。
{
  "type": "mcp_server",
  "name": "weather_service",
  "url": "https://gemini-api-demos.uc.r.appspot.com/mcp",
  "defer_loading": true
}
この設定では、そのMCPサーバーが公開するツール群が遅延対象になり、必要なものだけがオンデマンドで読み込まれます。1つのMCPサーバーが数十のツールを公開する構成や、複数MCPサーバーを同時接続する構成で、初期コンテキストを抑えられます。
MCP自体は、AIエージェントと外部のツール・データをつなぐ接続層です。MCPとA2Aの役割や、MCP Serverがツールを公開する仕組みは別記事で整理しています。
Tool Retrievalは、MCPで接続したツール群のスキーマを「いつモデルへ読ませるか」を管理します。
クライアント側Retrievalは検索・ランキング・絞り込みをアプリ側で持つ
独自のツールレジストリやユーザー別の利用可能ツールを持つ場合は、クライアント側Retrievalを使えます。
tool_searchへexecution: "client"を設定し、検索用の名前、説明、パラメータスキーマを定義します。モデルが検索用Functionを呼び、アプリ側がレジストリを検索して、該当する完全なFunction定義をfunction_resultで返します。
サーバー側Retrievalとの違いは次の通りです。
- 検索ロジックをアプリ側で実装できる
- ランキングや名前空間を独自に設計できる
- ツールを事前にすべて宣言する必要がない
- ユーザーが連携サービスを追加した途中から新しいツールを公開できる
- 検索結果を
function_resultとして返すため、検索1回ごとにクライアント↔Gemini APIの追加往復が1回増える
Googleはクライアント側Retrievalの用途として、独自レジストリ、embedding index、per-user permission filterを挙げています。
権限管理は「検索対象」と「実行許可」を分けて設計する
Tool Retrievalのdefer_loadingは、パラメータスキーマを初期コンテキストから外す設定です。サーバー側Retrievalでは、遅延対象でもツール名と説明はモデルに見えます。
ユーザーごとに使える機能を変える場合は、どのツールを検索対象へ入れるかを先に絞る設計が必要です。クライアント側Retrievalなら、ユーザーの契約、ロール、接続済みサービスなどに応じて、返すFunction定義をアプリ側で制御できます。
さらに、ツールが選ばれた後の実行許可は、接続先APIやアプリ側の認証・認可、必要な承認処理で管理します。
権限設計は、次の2層に分けられます。
| 層 | 決めること | 主な実装場所 |
|---|---|---|
| Retrieval範囲 | モデルが候補として探せるツール | tools配列、client-side tool_search、レジストリ |
| 実行権限 | 選ばれたツールをそのユーザーが実行できるか | アプリ、API、MCPサーバー、認証・認可 |
AIエージェントへ与える権限を、読み取り、書き込み、外部サービス操作などへ分けて設計する考え方は別記事で詳しく扱っています。
Tool Retrievalの料金は検索回数と読み込むスキーマで変わる
Tool Retrieval自体に別料金はありません。利用したモデルの通常の入力、キャッシュ、出力トークン料金が適用されます。
料金を見るときは、初期トークンが減る部分と、検索で増える部分を分けます。
| 要素 | トークンへの影響 |
|---|---|
| 遅延ツール一覧 | 名前と短い説明の分だけ初期入力に入る |
| 遅延したパラメータスキーマ | 読み込まれるまで入力へ入らない |
| サーバー側tool_search | クライアント↔Gemini APIの追加往復は増えない。検索ごとにGemini API内部の追加モデル処理が発生する |
| 読み込んだスキーマ | その後の会話コンテキストへ残り、後続ターンでも入力として数えられる |
| implicit caching | 変わらないprefix部分はキャッシュ対象になり得る |
大規模なツール群から毎回ごく一部だけ使う構成では、スキーマを遅延させる効果が大きくなります。小規模なツール群や、長い会話でほぼ毎回検索する構成では、サーバー側の追加モデル処理や、クライアント側の追加往復による負荷が大きくなる場合があります。
Googleのドキュメントも、Tool Retrievalの効果を自分のトラフィックで測定するよう案内しています。usageではtotal_input_tokens、total_tool_use_tokens、total_cached_tokensなどを確認できます。
読み込まれたツールは会話の残りでコンテキストに残る
Tool Retrievalは、必要なスキーマを読み込んだ後、そのスキーマを会話の残りで保持します。2026年11月20日時点の仕様では、一度読み込んだツールを会話途中でアンロードする機能はありません。
このため、長い会話で多数の専門ツールを次々に読み込むと、後半ではコンテキストが再び大きくなります。
Tool Retrievalはimplicit cachingと組み合わせられます。取得したスキーマは読み込まれた位置へ追加されるため、system instructions、tool list、以前のturnなどのprefixを維持しやすい設計です。
会話をどこで区切るか、どの専門ツールを常時ロードするか、長時間セッションで何種類のツールが蓄積するかも運用指標になります。
Interactions APIでは毎回tools配列を送る
previous_interaction_idを使って複数ターンをつなぐ場合も、ツール宣言は次のリクエストへ自動継承されません。
サーバー側Retrievalを使う会話では、各リクエストで次を含む完全なtools配列を送ります。
tool_search- すべての遅延ツール
- 遅延していないツール
- 遅延対象のRemote MCPサーバー
Interactionのstep履歴はサーバー側で保持できますが、ツール宣言そのものは毎回渡す設計です。
statelessで会話履歴を自分で管理する場合は、tool_search_callとtool_search_resultをsignatureを含めてそのまま再送する必要があります。
導入時はツール数・検索頻度・ユーザー差分を測る
Tool Retrievalを使うか判断するときは、次の4点を見ると設計しやすくなります。
| 確認項目 | 見る内容 |
|---|---|
| ツール数 | 常時読み込みで十分か、長いテールがあるか |
| 1タスクで使うツール数 | 大半のツールを使わないなら遅延読み込みの効果が出やすい |
| 検索頻度 | server-side searchが何回発生し、total_tool_use_tokensがどれだけ増えるか |
| ユーザーごとの差 | 同じ固定ライブラリか、ロール・接続先ごとに候補が変わるか |
少数の固定ツールなら静的読み込み、大規模で固定されたツール群ならサーバー側Retrieval、ユーザーや名前空間で候補が動くならクライアント側Retrievalが選択肢になります。
GitHubのgoogleapis/js-genaiでは2026年3月、ツール数が増えたときのコンテキスト肥大化やキャッシュ効率を課題として、defer_loadingとtool_searchを求めるFeature Requestが投稿されていました。これは利用者側の課題感を示す補助情報で、正式仕様はGoogleのTool Retrievalドキュメントを基準にします。
現在の制約と対応モデル
2026年11月20日時点では、次の制約があります。
- Tool RetrievalはInteractions APIで利用する
generateContentはTool Retrievalの対象外- 1リクエストで宣言できる
tool_searchは1つ - サーバー側とクライアント側の
tool_searchは同じリクエストで併用しない defer_loadingはサーバー側Retrievalで使う- モデルは1ターン中に複数回検索する場合がある
- 読み込んだツールは会話の残りでコンテキストに残る
公式ドキュメントが挙げる対応モデルは次の4つです。
- Gemini 4 Hydrogen
- Gemini 4 Argon
- Gemini 3.8 Flash
- Gemini 3.6 Flash
Tool Retrieval自体はプレビューです。Interactions APIは2026年6月にGAとなり、Googleは新規のGeminiモデル・エージェント開発で主要インターフェースとして案内しています。
まとめ
Gemini APIのTool Retrievalは、大量のツール定義を毎回すべてコンテキストへ入れる構成から、必要なパラメータスキーマをオンデマンドで読み込む構成へ変える機能です。
サーバー側Retrievalではtool_searchとdefer_loadingを使い、クライアントから送った1回のInteractions APIリクエストの処理中に検索からスキーマ読み込みまで進めます。検索ごとの追加モデル処理はGemini API内部で行われ、クライアント↔Gemini APIの追加往復は増えません。Remote MCPサーバーのツール群もまとめて遅延対象にできます。
クライアント側Retrievalでは、独自レジストリ、名前空間、ユーザー別ツール集合をアプリ側で検索できます。権限設計では、モデルが検索できる候補と、選択後に実行できる権限を分けて管理します。
コスト効果はツール数と検索頻度で変わります。常用ツールを前読み込みし、専門ツールを遅延させ、usageで入力・tool use・cacheの各トークンを測る運用が、Tool Retrievalを導入するときの基本になります。
公式情報・参照先
- Introducing Tool Retrieval in the Gemini API|Google
- Tool retrieval|Gemini API
- Function calling with the Gemini API|Gemini API
- Interactions API: our primary interface for Gemini models and agents|Google
- Gemini Developer API pricing|Google AI for Developers
- Feature Request: Support defer_loading and tool_search for dynamic tool discovery|googleapis/js-genai GitHub Issue #1416