当サイトではアフィリエイト広告を利用しています。
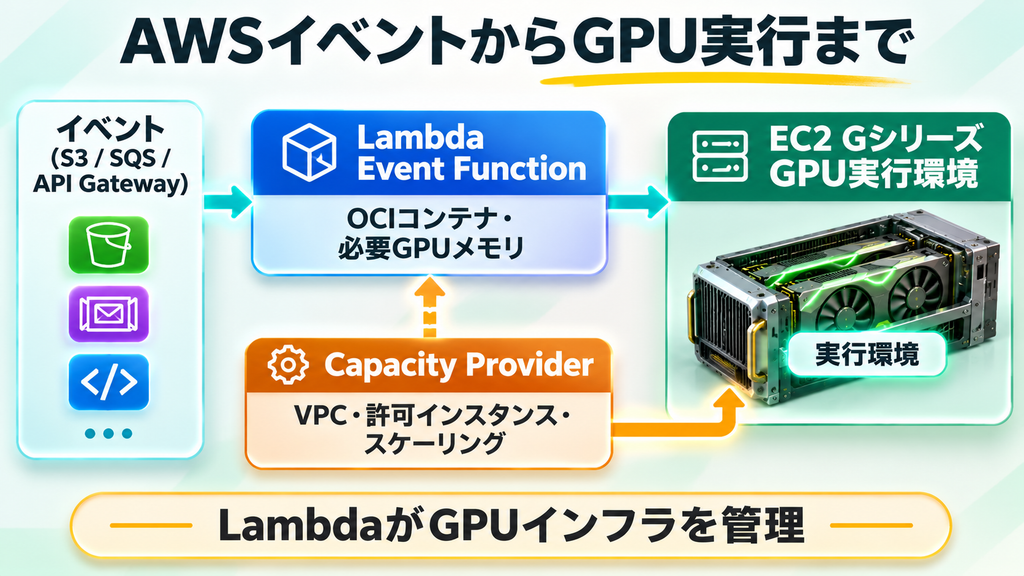
AWSは2026年11月18日、AWS Lambda Managed InstancesのEvent FunctionsでGPUを利用できる機能を一般提供しました。Amazon EC2のGシリーズを実行基盤にして、AI推論、動画・画像処理、3Dレンダリング、数値計算をLambdaのイベントから起動できます。
GPUドライバーの管理、EC2インスタンスの起動・更新、リクエストのルーティング、負荷に応じたスケーリングはLambdaが担当します。利用者はGPUの候補インスタンス、コンテナイメージ、必要なGPUメモリ、同時実行数を設定します。
運用設計の要点は、GPUメモリに合うインスタンスを選び、1つの実行環境でリクエストを並列処理し、GPU使用率と待ち時間を見ながら台数を調整することです。費用はEC2のインスタンス料金、Lambda管理料、リクエスト料金を組み合わせて計算します。
GPU対応の対象はManaged InstancesのEvent Functions
Lambda Managed Instancesは、利用者のAWSアカウント内にあるEC2インスタンス上でLambda関数を動かす実行方式です。今回のGPU対応が対象とするのは、この方式のEvent Functionsです。
Amazon S3、Amazon SQS、Amazon API Gateway、Amazon EventBridgeなど、200以上のAWSイベントソースから関数を起動できます。イベントを受け取った後の一工程へGPU計算を組み込む設計です。
| 利用場面 | GPU関数に渡す処理の例 | 周辺システムとの接続 |
|---|---|---|
| 独自モデル推論 | 文書分類、音声認識、小〜中規模言語モデル | SQSで処理要求を受け、結果を保存 |
| メディア処理 | アップロードした動画の変換、画像処理 | S3イベントから処理を開始 |
| 3D・生成メディア | フレーム、シーン、プレビューの描画 | イベントを受けてレンダリング |
| 数値計算 | 並列行列演算、シミュレーション | バッチ単位で関数を起動 |
AWSはこの機能の主要用途をカスタムモデル推論やイベント駆動のGPU処理と位置付けています。基盤モデルのマネージド利用はAmazon Bedrock、モデルの学習やライフサイクル管理はAmazon SageMaker AIが選択肢になります。
Capacity ProviderがGPUインスタンスと実行環境を結ぶ
GPUを実行する際は、Lambda Managed InstancesのCapacity Provider(キャパシティプロバイダー)に利用可能なGシリーズのインスタンスタイプを登録します。Capacity ProviderはVPCのサブネット・セキュリティグループ、インスタンス要件、スケーリング方針を持つ実行基盤の設定です。
関数側はコンテナイメージを登録し、Capacity Providerへ関連付けてGPUメモリ要件を指定します。バージョンを発行すると、Lambdaが対象EC2インスタンスと実行環境を準備します。GPU用とCPU用のインスタンスタイプは同じCapacity Providerへ混在させられないため、GPU専用のCapacity Providerを作ります。
GシリーズとGPUメモリの選び方
2026年11月18日の提供開始時点で対応するGシリーズは次の通りです。
| EC2ファミリー | GPU | 1GPUまたは仮想GPUのメモリ |
|---|---|---|
| G4dn | NVIDIA T4 | 16 GB |
| G5 | NVIDIA A10G | 24 GB |
| G6、Gr6 | NVIDIA L4 | 24 GB |
| G6e | NVIDIA L40S | 48 GB |
| G6f | NVIDIA L4の分割GPU | 3・6・12 GB(サイズによる) |
| Gr6f | NVIDIA L4の分割GPU | 12 GB |
G4dnのベアメタル型「g4dn.metal」は対象外です。G6fとGr6fは物理GPUの一部を仮想GPUとして割り当てる方式で、Lambdaはその仮想GPUを1つの実行環境へ渡します。通常のGシリーズでも、1つの実行環境に割り当てるGPUは1基です。複数GPU搭載インスタンスには、GPUごとに実行環境を配置します。
関数のAcceleratorConfig.AcceleratorMemorySizeは、必要とするGPUメモリの下限をGB単位で表します。指定可能な値は3、6、12、16、24、48です。Lambdaは設定したAllowedInstanceTypesの中から、条件を満たす新しい世代の小さなGPUを優先し、容量不足時には他の許可済みタイプへフォールバックします。
たとえば16 GBを要求した関数が、候補にG4dn・G5・G6を持つ場合、割り当てられるGPUの実メモリが要求値より大きくなることがあります。候補の中に必要メモリを満たすインスタンスが少なくとも1種類必要です。
モデルの保持方法はワーカー実装と共有推論サーバーで変わる
GPU対応のEvent Functionsはコンテナイメージ形式のみでデプロイします。LambdaはCUDA、CuPy、PyTorch、vLLM、SGLang向けのベースイメージを提供し、GPUドライバーとの互換性も管理します。
| ベースイメージ | 主な用途 | 実行時の考え方 |
|---|---|---|
base:cuda | 独自CUDA処理 | 必要なアプリやライブラリを追加 |
cupy:cuda | GPU数値計算 | CuPyを使った配列演算 |
pytorch:cuda | 独自の機械学習推論 | 実装によってはワーカーごとにモデルを読み込む |
vllm:cuda | 言語モデル推論 | 1実行環境に1つの推論サーバーを起動 |
sglang:cuda | 言語モデル推論 | 同時リクエストを1つの推論サーバーへ集約 |
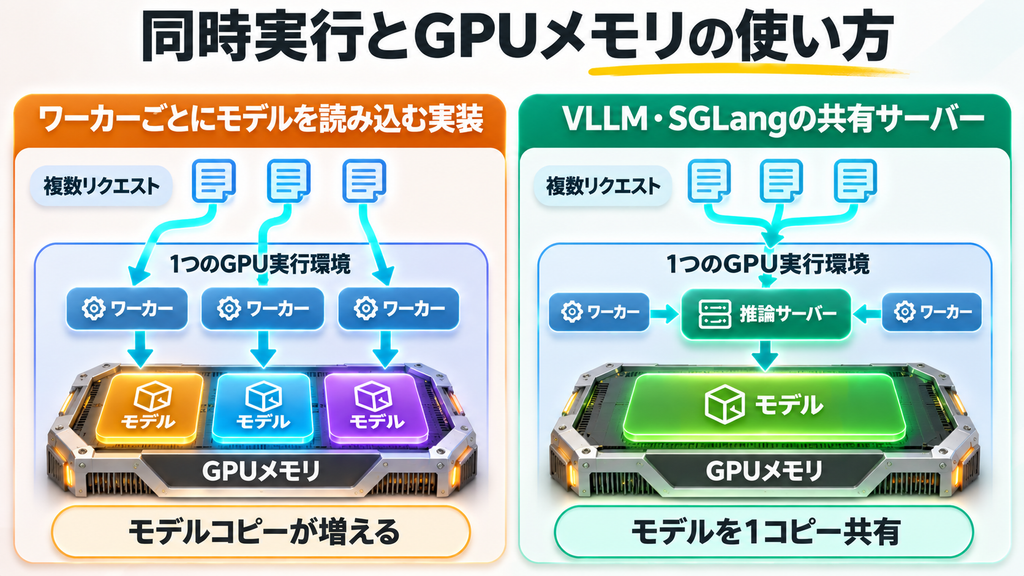
同時実行の制御にはPerExecutionEnvironmentMaxConcurrencyを使います。デフォルトは4、上限は48です。複数の呼び出しを同一実行環境で処理するため、関数の書き方がGPUメモリ使用量に直結します。
各ワーカープロセスが別々にモデルを読み込む実装では、同時実行数に応じてモデルの複製がGPUメモリを消費します。vLLM・SGLangのベースイメージは、1実行環境に起動した推論サーバーへ複数ワーカーの要求を送り、1つのモデルを共有してバッチ処理します。モデル複製の有無はアプリケーションの実装方式で決まります。pytorch:cudaでも、モデルをどう保持するかはアプリケーション側で設計します。
モデルサイズ、推論中の一時メモリ、同時実行数を測ったうえで設定します。GPUメモリの不足が発生する場合は、同時実行数を減らすか、必要なGPUメモリとインスタンスタイプを見直します。
コンテナとモデル重みの配置
GPU関数ではコンテナイメージを最大32 GB、/tmpの一時ストレージを最大32 GBまで使えます。コンテナ内の単一ファイルは最大10 GBです。関数メモリは2,048〜32,768 MBに対応します。
大きなイメージはSeekable OCI(SOCI)の遅延読み込みで起動時間を抑えられます。モデル重みはAmazon S3に保存し、S3 Connector for PyTorchやRun:ai Model Streamerなどで読み込む構成も選べます。運用では、イメージサイズ、重みの配置場所、バージョン公開時の初期化時間をひと組で検証します。
スケーリングはGPU使用率・CPU使用率・同時実行で決まる
Lambda Managed InstancesはGPU利用率、CPU利用率、同時実行の指標を監視し、負荷に応じて実行環境を増減します。GPU使用率の初期ターゲットは40%で、Capacity Providerのターゲット追跡ポリシーから変更できます。
同時実行設定を高めると1つのGPUへ多くの要求を集められますが、モデルのメモリ使用量と応答時間も確認する必要があります。GPUが空いていてメモリに余裕がある場合は同時実行数を上げる、GPUメモリが逼迫する場合は下げる、といった調整が基本です。
GPUの使用状況はAmazon CloudWatchとLambdaコンソールで確認できます。主なメトリクスはGPU使用率、GPUメモリ使用率、GPUメモリ使用量、GPU電力使用率です。実運用ではこれに関数の遅延、エラー、スロットリングを合わせて見ます。
スケールゼロはアイドル費用と復帰時間の交換になる
MinExecutionEnvironments=0を指定すると、アイドル時に実行環境をゼロまで減らせます。再びイベントが来た際はGPUインスタンスを調達して環境を起動するため、ゼロからの復帰には数分かかる場合があります。空きGPU容量が足りないと要求が失敗するケースもあります。
低頻度の非同期バッチならスケールゼロを検討できます。遅延要件の厳しいAPIでは、最低実行環境数を維持する構成や容量確保も検討対象です。許可インスタンスタイプを複数世代に広げる方法に加え、特定のインスタンスタイプとアベイラビリティーゾーンに一致するEC2 On-Demand Capacity Reservationを用意する方法もあります。
Lambda Managed Instancesの基本料金はEC2利用料+管理料9.75%+リクエスト料
2026年11月19日時点のGPU対応Lambda Managed Instancesの基本料金は、次の3要素です。
| 課金要素 | 計算基準 | 確認点 |
|---|---|---|
| EC2インスタンス料金 | 実行されたEC2インスタンスの利用料金 | リージョン・タイプ・稼働時間、Savings PlansやReserved Instances |
| Lambda管理料 | EC2オンデマンド単価の9.75% | EC2側の割引適用後の単価とは区別 |
| Lambdaリクエスト料金 | 100万リクエストあたり0.20ドル | 月間の実行回数 |
基本料金の概算式は次の通りです。
基本料金の概算 ≒ EC2インスタンス利用料 +(オンデマンド時間単価 × 9.75% × インスタンス稼働時間)+(リクエスト数 ÷ 100万 × 0.20ドル)
たとえば100万回の要求を処理した場合、上式のリクエスト料金部分は0.20ドルです。実際の月額を左右するのは、GPUインスタンスの種類と稼働時間、並列処理で実現できる処理量です。
通常のLambdaのようなリクエストごとの実行時間課金はManaged Instancesには別途加算されません。イベントソースマッピングで課金対象のEvent Poller Unitsを利用する場合など、周辺サービスの料金は別に確認します。
費用比較では、1件あたりのGPU処理時間、1台あたりの処理件数、低負荷時間、スケールゼロからの復帰、予約容量の必要性を含めて見積もります。
導入手順は「容量→コンテナ→関数→公開」の4段階
初回の構築は次の順番で進めます。
- GPU用Capacity Providerを作成:VPC、IAMのオペレーターロール、許可するGシリーズ、スケーリング条件を設定する。
- コンテナイメージを作成:LambdaのGPUベースイメージを使うか独自イメージを作り、Amazon ECRへ配置する。
- Event Functionを作成:Capacity Providerを関連付け、
AcceleratorMemorySize、関数メモリ、同時実行数、イベントソースを設定する。 - 関数バージョンを発行してテスト:GPU環境の準備とモデル初期化を確認し、実際のイベントで応答時間・GPUメモリ・失敗時の再試行を測る。
AWSの公開例ではvLLMのベースイメージから小規模な言語モデルをデプロイしています。モデルIDを環境変数で指定する例であり、モデルや重みを変更する際は新しい関数バージョンを発行します。
GPU対応の関数は、非同期呼び出しとイベントソースマッピングからの呼び出しで最大90分のタイムアウトに対応します。長時間処理を設計するときは、起動方法とタイムアウトの組み合わせを確認します。
提供リージョン・GPUクォータ・権限が実行前の確認点
GPU対応は、Lambda Managed Instancesと対象EC2 Gシリーズの両方が利用できるAWS商用リージョンで提供されています。使うリージョンごとに両サービスと希望インスタンスの利用可否を確認します。
EC2のGPUクォータは実行前の確認項目です。Running On-Demand G and VT instancesの初期上限は0 vCPUで、GPU関数を動かす前にService Quotasから引き上げを申請する必要があります。Capacity Provider側ではMaxVCpusで実行規模の上限を指定できます。
実運用では次の項目を合わせて確認します。
| 確認対象 | 運用上の決定 |
|---|---|
| リージョンとGPU容量 | LMIとGシリーズの提供、利用可能な世代、EC2クォータ |
| 権限とネットワーク | Capacity Providerのオペレーターロール、関数実行ロール、VPCのサブネット・セキュリティグループ |
| モデルとイメージ | ECRへの配置、重みを置くS3、モデル読み込みに必要なアクセス権 |
| 性能 | GPUメモリの下限、同時実行数、GPU使用率、応答時間 |
| 費用と可用性 | インスタンス稼働時間、管理料、スケールゼロ、容量予約、再試行 |
テキストモデルの開発工程で学習・評価データを整える場合は、Amazon SageMaker AI Data Preparationの合成データ、ラベル付け、人レビュー、品質評価の仕組みも参考になります。こちらはモデルを作る前のデータ準備を扱った関連記事です。
まとめ
AWS Lambda Managed InstancesのGPU対応によって、S3やSQSなどのイベントをきっかけに、カスタム推論やメディア処理をEC2 GシリーズのGPUで実行できるようになりました。LambdaがGPUドライバー、インスタンス管理、スケーリングを担い、利用者はコンテナ、モデル、GPUメモリ要件、処理の同時実行を設計します。
GPU用途共通では、GPU使用率、スケールゼロの復帰時間、インスタンス稼働費用を一緒に評価します。モデル推論では、これに加えて1実行環境でモデルをどう保持・共有するかも確認します。イベント単位の処理をGPUへ載せられる一方、コストの中心は実際に確保したEC2 GPUの稼働時間にあります。
公式情報・参照先
- AWS Lambda adds support for GPU instances on Lambda Managed Instances | AWS What’s New
- AWS Lambda now supports GPU instances for Event Functions on Lambda Managed Instances | AWS News Blog
- Run GPU-accelerated Event Functions on Lambda Managed Instances | AWS Lambda Developer Guide
- GPU base images for Lambda Managed Instances | AWS Lambda Developer Guide
- Understanding scaling and concurrency for GPU-accelerated Event Functions | AWS Lambda Developer Guide
- Getting started with GPU-accelerated Event Functions | AWS Lambda Developer Guide
- AWS Lambda Pricing | AWS
- AWS Lambda now supports scale to and from zero for Lambda Managed Instances | AWS What’s New