当サイトではアフィリエイト広告を利用しています。
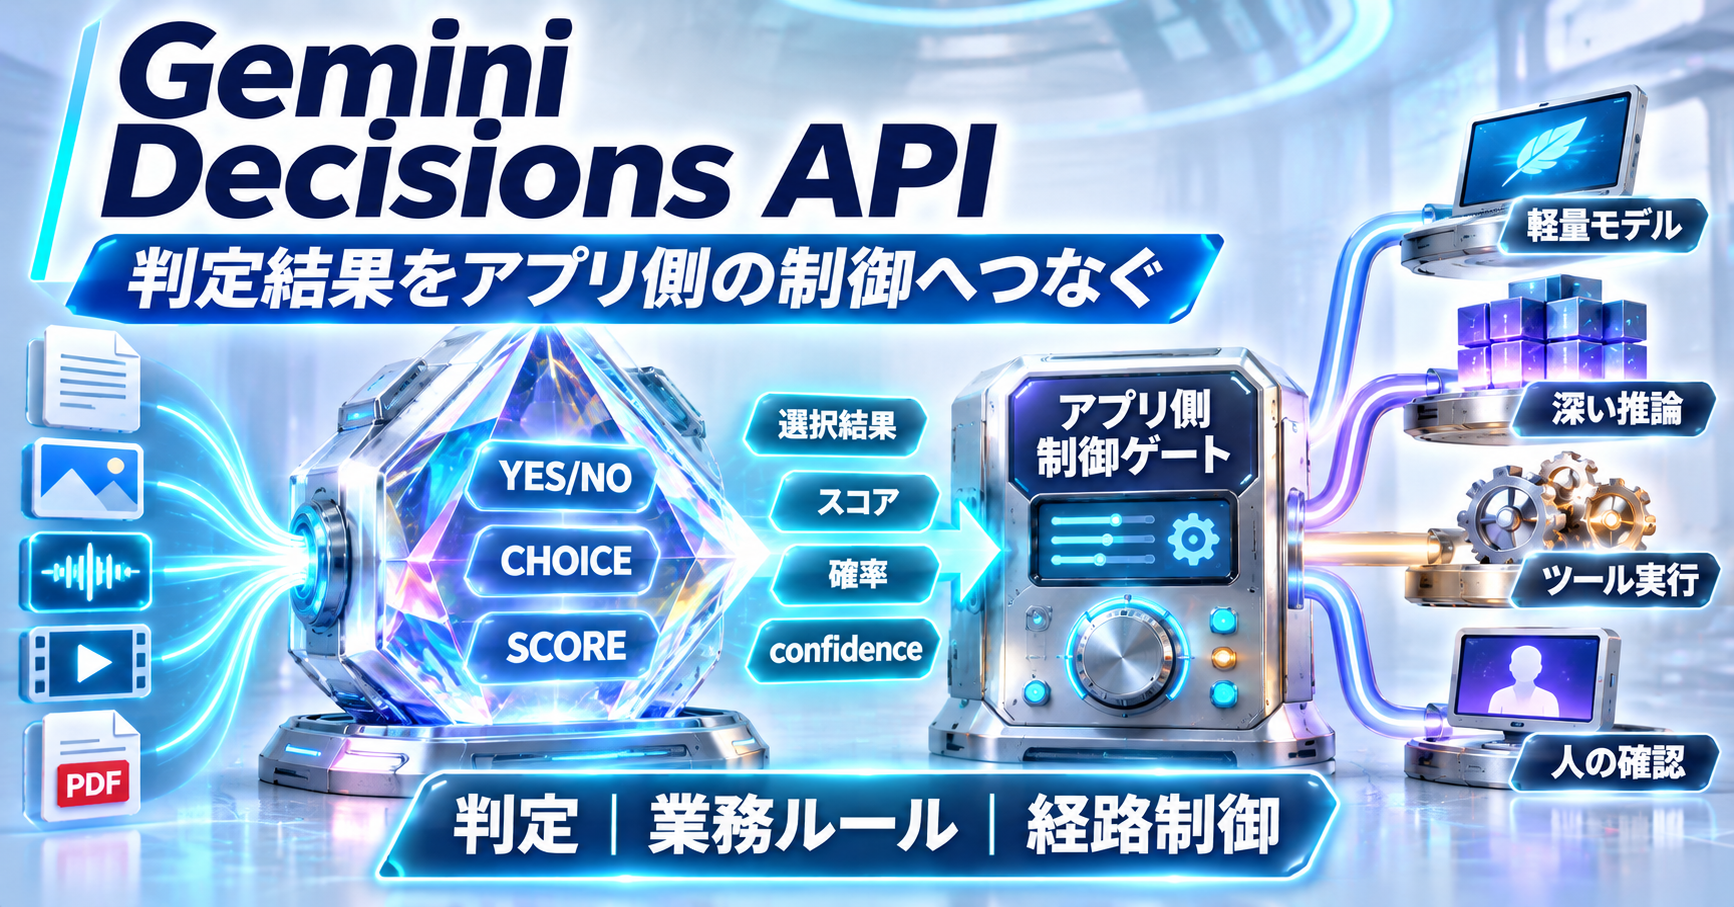
Googleは2026年11月11日、判定専用の「Gemini Decisions API」と、その処理を担う「Gemini Decision 1」を公開しました。テキスト、画像、音声、動画、PDFを共通入力にし、Yes/No、選択、段階評価といった閉じた判断を最大1,000件まで1回のリクエストへまとめられます。
このAPIの重要な点は、AIアプリの中で「文章や計画を作る処理」と「候補から選ぶ処理」を別の役割として設計できることです。ツール選択、ポリシーチェック、モデル振り分け、コンテキスト評価では、判定結果の確率と信頼度をそのままアプリ側の分岐条件へ使えます。
Gemini Decisions APIは「生成」と「判断」を別の処理へ分ける
通常の生成AIは、入力を受けて文章、説明、コード、ツール呼び出しなどを生成します。Gemini Decisions APIは、あらかじめ決めた候補や尺度に対して確率を返し、コード側がその結果を使って次の処理を選ぶためのAPIです。
Googleの公式ドキュメントでは、Decisions APIとInteractions APIの役割を次のように分けています。
| 処理 | Gemini Decisions API | Interactions API |
|---|---|---|
| 主な出力 | Yes/No確率、固定候補からの選択、固定尺度の評価 | 文章、要約、説明、構造化データ |
| 判断材料 | 候補ごとの確率と信頼度 | 生成された内容やツール呼び出し |
| 複数処理 | 同じ入力へ独立した判定をまとめて実行 | 複数ステップの推論やツール利用 |
| 向く用途 | ルーティング、ポリシーチェック、採点、選別 | 文章生成、抽出、ツール実行、複雑な推論 |
| 出力トークン | 0 | 処理内容に応じて発生 |
たとえば問い合わせ対応では、営業、請求、技術、その他といった候補をChoiceとして渡すと、最上位候補と確率を受け取れます。アプリ側は返された値をそのままルーティングへ使えます。
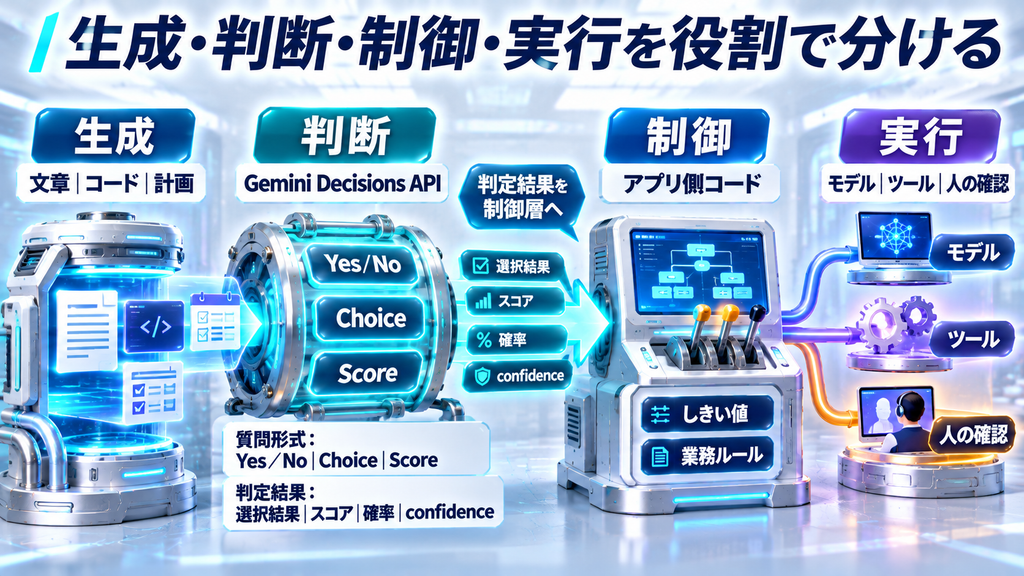
この分離によって、生成モデルは文章作成や複雑な推論へ集中し、頻繁に発生する小さな判定は専用APIへ置けます。AIアプリ全体では、生成層、判定層、制御層、実行層という役割分担を作れます。ここでは、Decisions APIが判定結果を返す判定層、アプリ側コードがconfidenceと業務ルールから経路を選ぶ制御層、選ばれたモデルやツールが処理を行う実行層を担当します。
3種類の判定はYes/No・Choice・Score
Gemini Decisions APIには、用途の異なる3種類の質問タイプがあります。
| 種類 | 役割 | 主な返り値 |
|---|---|---|
| noul | Yes/No条件を判定 | Yesの確率、confidence |
| choice | 2〜255個の候補から選択 | 選択結果、各候補の確率、confidence |
| score | 順序付き尺度で評価 | 加重スコア、各段階の確率、confidence |
noulは条件を満たす確率を返す
noulは、「この問い合わせは返金対象か」「画像に損傷があるか」のような二値判定に使います。返り値はYesである確率で、公式仕様では0.01〜0.99の範囲です。
条件が曖昧になりやすい場合は、trueとfalseが何を意味するかをcriteriaで定義できます。単純なキーワード一致より、文章や画像の意味を踏まえた判定をアプリの条件分岐へ持ち込めます。
choiceは固定候補から1つを選ぶ
choiceでは2〜255個の候補を用意し、選ばれた候補と全候補の正規化確率を受け取ります。モデルルーティング、担当部署の振り分け、次に使うツールの選択などに向きます。
Choiceは用意した候補へ必ず確率を配分します。候補外の入力を扱う設計では、「other」のような受け皿を置く、別のnoulで対象範囲を先に確認する、信頼度が低いケースを別経路へ送るといった方法を組み合わせます。
scoreは順序付きルーブリックで評価する
scoreは、「低・中・高」や0〜4段階の品質評価のように、順序を持つ基準へ入力を当てはめます。2〜255段階を設定でき、公式ドキュメントでは多くのルーブリックで2〜10段階が推奨されています。
返されるscoreは各段階の確率を使った加重平均です。品質評価、優先度、リスク、候補ランキングのように、単純な二値より細かな判断が必要な処理へ使えます。
判断専用モデルという考え方自体を比較したい場合は、CLM-8BとJevの記事で、Choice・Score系の処理を生成LLMから切り離す設計を詳しく確認できます。
1つの共有入力へ最大1,000件の独立した判定をまとめられる
1回のリクエストでは、1つのshared inputと複数のquestionsを送ります。shared inputにはテキスト、画像、音声、動画、PDFを組み合わせられます。
公式ドキュメント上のコンテキスト上限は、共有入力と全質問を合わせて26万2,144トークンです。発表記事では256Kトークンと表記されています。質問数は1〜1,000件で、noul、choice、scoreを同じリクエスト内で混在できます。
重要なのは、質問同士が独立していることです。それぞれの質問は同じshared inputを参照しますが、別の質問の回答や条件は参照しません。複数の判定を順番につなげたい場合は、アプリ側で結果を組み合わせるか、前段の結果を使って次のリクエストを作ります。
たとえば1件のサポート問い合わせへ、次の判定を同時にかけられます。
- 返金対象か
- 問い合わせカテゴリは何か
- 緊急度はどの段階か
- 人の確認が必要な内容か
- どのモデルへ送るか
共有入力はリクエストごとに1回分として課金され、各質問ではinstructionsやcriteriaなど質問固有のトークンが追加されます。同じ長い入力へ多数の独立チェックをかける処理ほど、この構造を使う意味が大きくなります。
confidenceを自動実行とフォールバックの境界に使う
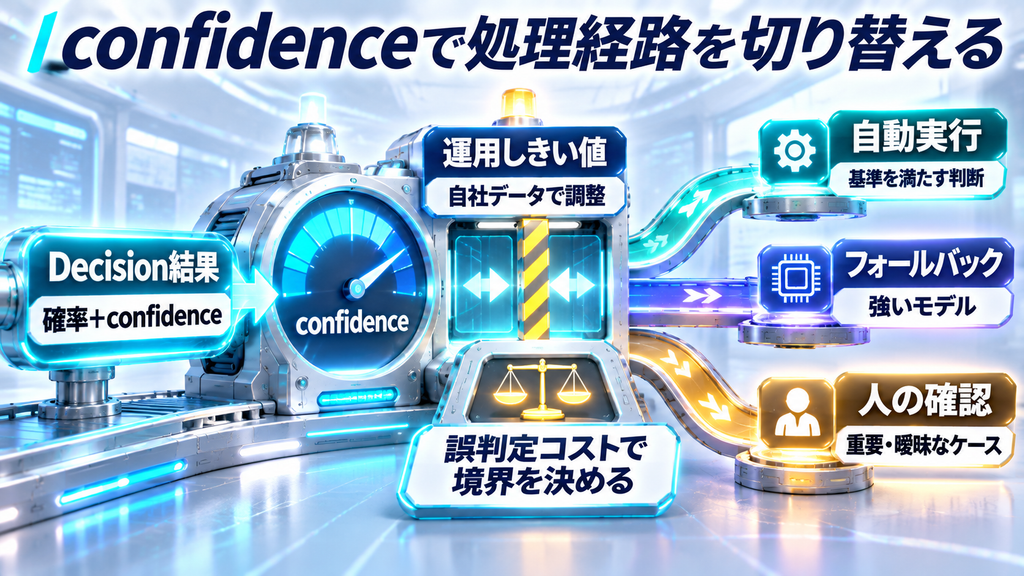
各回答にはconfidenceが付きます。公式ドキュメントでは、confidenceを「最上位の回答が正しいと見積もる確率」として扱い、アプリ側で自動実行とエスカレーションを分ける例が示されています。
たとえば部署振り分けなら、次のような運用です。
- Decisions APIが問い合わせカテゴリとconfidenceを返す
- confidenceが運用基準以上なら自動で担当部署へ送る
- 基準未満なら強いモデルまたは人の確認へ回す
- 実際の正解・誤りを記録し、しきい値を見直す
Googleは、しきい値を自社トラフィックのラベル付き例で決め、偽陽性と偽陰性のコストを比べるよう案内しています。基準は、「誤って自動実行した場合の損失」と「人へ回しすぎた場合のコスト」に合わせて設定します。
高い影響を持つ処理では、入力を未信頼として扱い、判断基準を明示し、敵対的な入力でも評価します。支払いなど重要な操作では、人の確認や第二のチェックを残すことも公式のベストプラクティスに含まれています。
料金は100万入力トークン0.10ドル、出力トークンは0
執筆時点の有料料金は、テキスト、画像、動画、音声、PDFの入力100万トークンあたり0.10ドルです。出力トークンは0で、AI Studioの無料枠では入力も無料と案内されています。
同じshared inputへ複数の質問を入れた場合、共有入力は1回だけ課金されます。質問ごとのinstructionsやcriteriaは入力トークンへ加算されるため、質問を増やした分だけ質問固有の入力トークンが増えます。
Googleが公表した共通ベンチマーク群では、Gemini Decision 1のモデル計算の中央値は50〜100ミリ秒、エンドツーエンドでは150〜250ミリ秒でした。この測定はマルチモーダル入力と最大16Kトークンのコンテキストを含む条件で、1〜100件の質問ではレイテンシがほぼ横ばいだったとしています。
同じベンチマーク群では、Gemini 3.5 Flash-LiteをInteractions APIで使う構成より約5分の1のコストだったという結果もGoogleが示しています。これはGoogleの評価条件で得られた比較値なので、実際の業務では入力長、質問数、再試行、ネットワーク条件を含めて測るのが適切です。
モデルルーティングでは判定結果をアプリ側の制御へ渡す
Gemini Decisions APIの使いどころとして分かりやすいのがモデルルーティングです。
すべての入力を同じモデルへ送る構成から、まずDecision 1が「軽い処理で十分か」「深い推論が必要か」「人へ回すべきか」を評価し、その結果を次のモデル選択へ使えます。
Google自身もGemini Notebookの動的モデルルーティングでGemini Decision 1を使っており、日常的な問い合わせでは最大40%のレイテンシ低下を実現しつつ、複雑な質問には深い推論を残したと説明しています。Google SearchのMCPツールでは、安全層の判定にも使われています。
実装では、次のように役割を分けられます。
- 生成モデル:文章、コード、計画、複雑な推論を作る
- Decisions API:候補を選ぶ、採点する、ポリシーを確認する
- アプリ側コード:confidenceと業務ルールから次の経路を決める
- 実行層:選ばれたツールやモデルを実行する
- 人:重要操作や曖昧なケースを確認する
Gemini 4 CarbonとArgonの記事では、仕事の難度や推論量に応じてモデルを振り分ける設計を整理しています。Decisions APIの判定結果をアプリ側のモデル選択へつなぐ設計を考えるときの次の読み物になります。
現行版ではv1betaとGemini Decision 1を使う
- Gemini Developer APIのv1betaでGemini Decision 1を使用
- Google Gen AI SDKは3.2以降
- questionのinstructionsはテキストのみ
- 画像・音声・動画・PDFはshared inputへ配置
- 会話履歴、thought、tool-callブロックはテキストへ直列化して入力
- YouTube URLと直接のgs:// URIは対象外
- context caching、Batch API、Flex、Priority inferenceは現行版の対象外
context cachingは現行版の対象外なので、別リクエストへ繰り返し送る入力は毎回フルに計上されます。同じ入力へ独立した判定を多数かける用途では、1リクエストへまとめられる範囲を活かす設計が料金面でも重要になります。
Googleの公式CookbookにもDecisions APIのクイックスタートが追加されており、Python、JavaScript、RESTで試せます。最初は本番データの代表例を使って、質問の書き方、confidenceの分布、誤判定時のフォールバックまで一緒に評価すると運用条件を決めやすくなります。
まとめ
Gemini Decisions APIは、AIアプリの中で頻繁に発生する「選ぶ・採点する・条件を確認する」を、自由文生成から切り分けるための専用APIです。
1つのマルチモーダル入力へ最大1,000件の独立した質問をまとめ、noul、choice、scoreの3形式で確率とconfidenceを受け取れます。共有入力を1回分として扱える料金構造と、出力トークン0という設計は、同じ入力へ多数の判定をかける処理と相性があります。
実務では、Decisions APIが返す判定結果を受け取り、アプリ側コードがconfidenceと業務ルールから自動実行、強いモデル、人の確認を切り替える制御層を作ることが重要です。生成、判定、制御、実行の役割を分けることで、モデル性能と運用ルールの両方を使ったAIアプリ設計へつなげられます。