当サイトではアフィリエイト広告を利用しています。
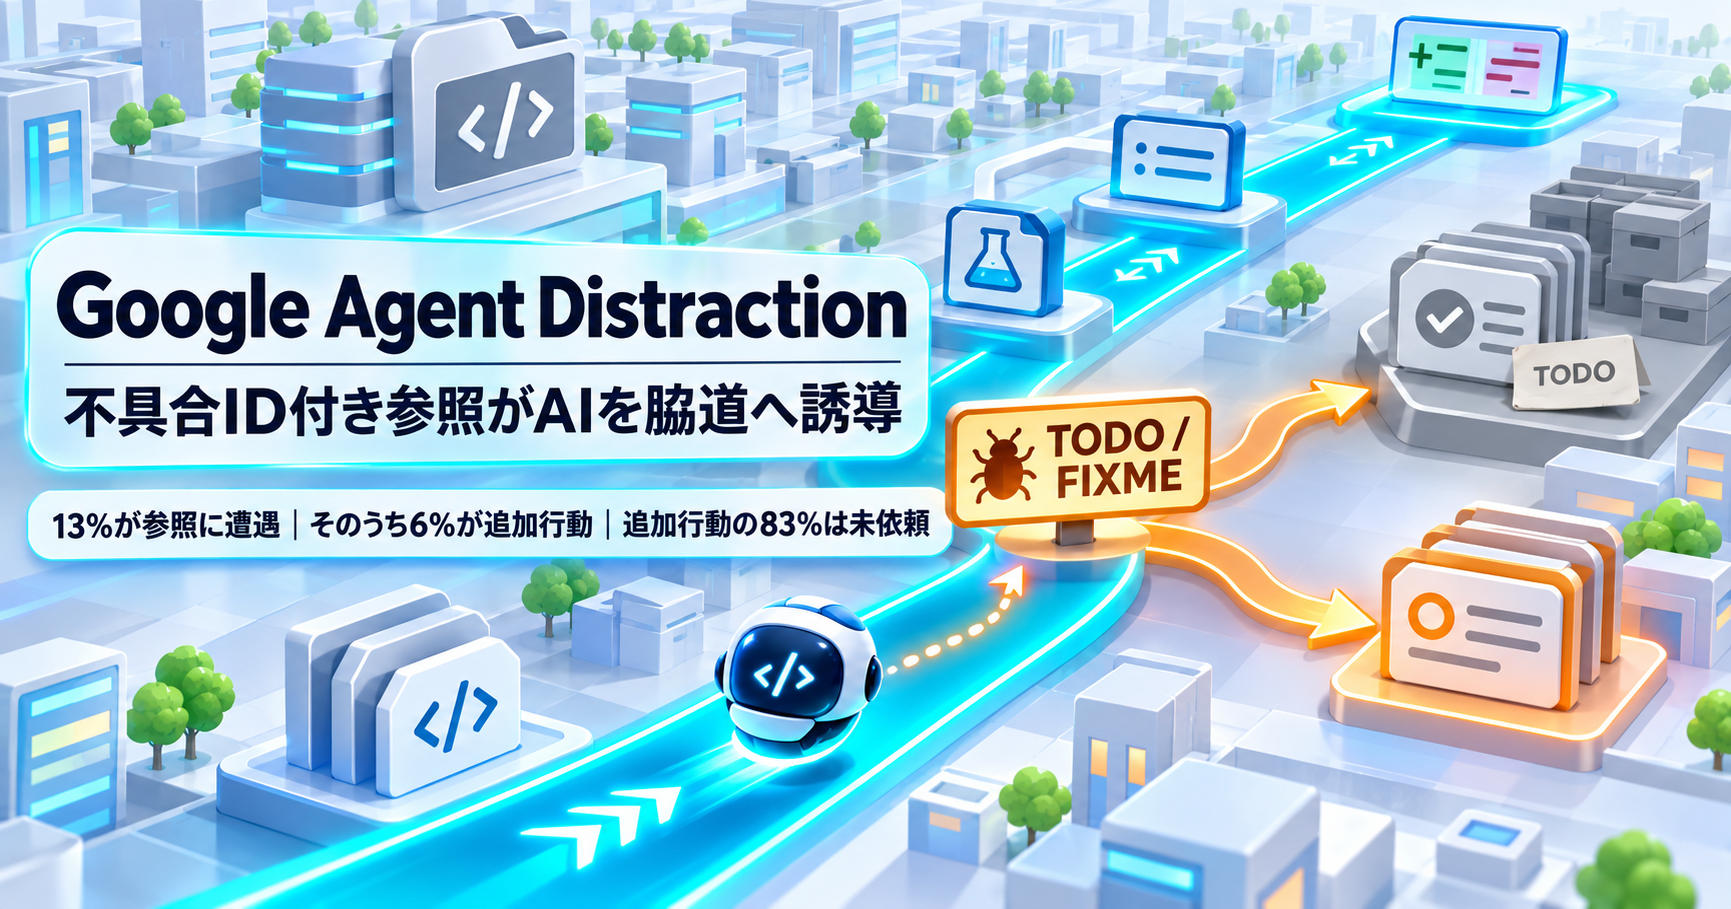
Googleは2026年11月6日、コーディングエージェントがコード中の不具合ID付きTODO/FIXME参照を読み、依頼されていない調査や修正へ進む「Agent Distraction」の分析を公開しました。
Google Developers Blog本文では、数百万件のファイル読取セッションと数億ステップ規模の内部トレースを分析しています。対象となったのは、TODO(bug/...)やFIXME(bug/...)のように不具合IDへリンクするコメントです。
結果は、コードベースに残る情報そのものが、エージェントの判断材料になることを示しています。
古いTODO・仕様書・ドキュメントを含むリポジトリの「情報衛生」は、コーディングエージェントの実行品質を支える運用基盤になります。
GoogleはTODOの不具合参照を「脱線」の代理指標にした
Googleは、TODO(bug/...)やFIXME(bug/...)のように、コードコメントから不具合チケットへたどれる参照を代理指標として使っています。
この形式なら、エージェントがコメントを読んだ後にその不具合IDを調査・修正したか、チケットが現在も有効か、利用者の依頼にその不具合が含まれていたかを照合できます。
Googleは、エージェントが遭遇した参照を次の情報と突き合わせています。
- 不具合チケットの状態
- 利用者が依頼したタスク
- その後の検索・調査・コード変更
- セッション内のステップ、トークン、待ち時間
この方法で、依頼に必要な調査と、依頼外の寄り道を大規模に分類しています。
13%が参照に遭遇、そのうち6%が不具合IDへ追加行動した
数百万件のファイル読取セッションのうち、13%でTODO(bug/...)またはFIXME(bug/...)の参照がエージェントに提示されました。
参照に遭遇した場面の94%では、そのコメントを読み流しています。残る6%では、エージェントが記載された不具合IDを対象に追加の行動を取りました。
さらに、その6%の追加行動のうち83%は、開発者が依頼していない不具合に対するものでした。
流れを分母ごとに分けると、次のようになります。
| 段階 | Googleの観測結果 |
|---|---|
| ファイル読取セッションで対象TODO/FIXME参照に遭遇 | 13% |
| 参照に遭遇したうち、不具合IDへ追加行動 | 6% |
| 追加行動のうち、開発者が依頼していない行動 | 83% |
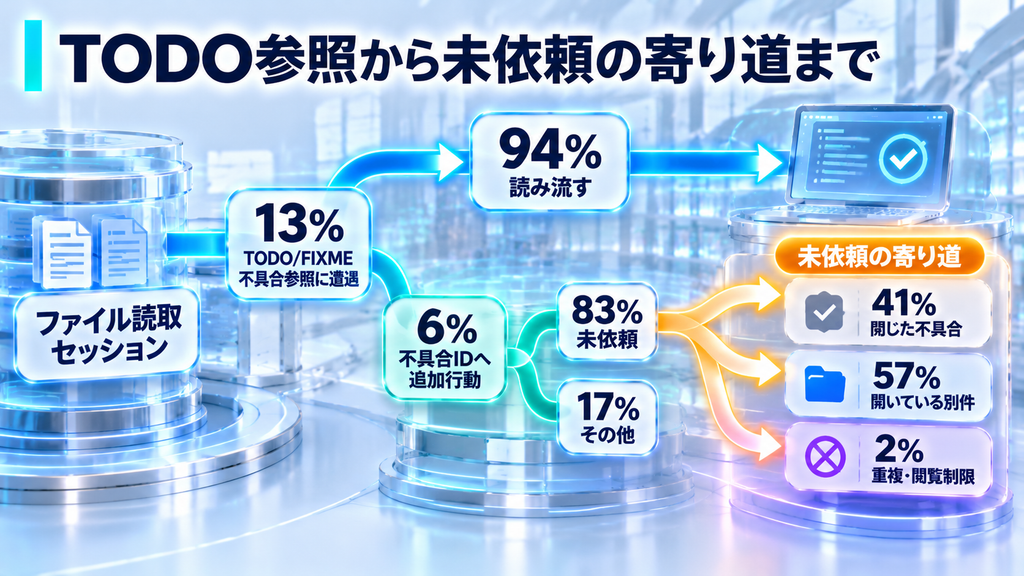
13%は対象形式の不具合参照への遭遇率です。その遭遇の6%で追加行動が発生しました。
未依頼の寄り道は「閉じた不具合」と「開いている別件」に分かれた
未依頼の寄り道を不具合チケットの状態で見ると、2つのパターンが出ています。
1つは、すでに役目を終えた不具合を追うケースです。
未依頼の寄り道の41%は、閉じたチケットを追っていました。内訳は、修正・検証済みが32%、obsoleteまたはwon’t fixが9%です。さらに2%は重複または閲覧制限のあるチケットでした。
もう1つは、チケット自体は現在も開いているものの、今回の依頼には含まれていないケースです。
未依頼の寄り道の57%はNEW・ASSIGNED・ACCEPTEDなどの状態にある開いた不具合でした。このグループでは61%が検索や情報確認まで進み、39%は実際にコードを変更しています。
現在も有効な課題でも、今回の作業範囲に含まれていなければスコープ拡大の起点になります。
未依頼の寄り道ではステップ70%、トークン77%、待ち時間105%増
Googleは、未依頼の不具合寄り道が起きたセッションのコストも分析しています。
回帰分析では、開発者、コードベースの複雑さ、タスク種別、モデル層、読んだファイル数、初期プロンプト長、不具合参照が現れたステップなどを統計的に調整しています。
そのうえで、未依頼の寄り道があるセッションでは、次の増加が観測されました。
- ステップ数:70%増
- トークン数:77%増
- 待ち時間:105%増
すべて統計的有意とされ、p値は0.0001未満です。
この分析は実運用トレースを使った観察データの回帰分析です。無作為化してTODOの有無だけを変えた実験ではないため、70%・77%・105%を「TODOだけが引き起こした純粋な因果効果」として扱う数値ではありません。
Googleが示したのは、未依頼の寄り道が発生したセッションで、大きな追加コストが一貫して観測されたことです。
エージェントにとってコードコメントは「読めるコンテキスト」になる
Googleは、obsoleteな仕様、解決済みの不具合、更新が遅れたドキュメントも、エージェントを誤った方向へ導く情報になり得ると説明しています。
コーディングエージェントは、調査段階で読んだファイル、コメント、仕様、課題参照をすべて作業コンテキストの候補として扱います。そこに「この処理はあとで直す」「この不具合を確認する」といった記述が残っていれば、現在の依頼と関係があるかを追加で調べる余地が生まれます。
ここでいう「リポジトリの情報衛生」は、コード、コメント、仕様書、Issue参照など、エージェントが読む情報を現在の状態と一致させて保つことです。
AIエージェントの性能を、メモリ、ツール、評価、状態保存など周辺の仕組みまで含めて考える方法は、NVIDIA AVOの記事でも詳しく整理しています。
Googleの事例では、2023年に解決済みのTODOが調査を誘発した
Googleは具体例として、エージェントが別の不具合を調査している途中でSurfaceControlTest.javaを読み、そこに残っていたTODO(bug/XXX)を見つける軌跡を示しています。
参照先の不具合は2023年に修正済みでした。それでもコメントがコードに残っていたため、エージェントはその不具合を追加で調べました。
別の例では、エージェントが現在の調査対象の中でTODOを見つけ、自発的にその不具合を「直そう」と判断しています。Code Searchや社内知識検索を複数回実行し、最終的に依頼範囲外のModelDownloaderV1まで変更しました。
後から人がスコープ拡大を指摘し、エージェント自身も範囲を広げすぎたことを認めています。
この2例では、コメントが次に調べる対象を決める手掛かりとして使われています。
Googleは履歴確認を組み込んだTODO清掃エージェントを作った
Googleは分析後、古い不具合参照を探して削除候補を作るエージェントも構築しています。
エージェントは、チケットの状態に加えて次の情報を確認します。
- 不具合の履歴
- 参照が残っているファイル
- コードベースの変更履歴
- TODOを書いた当時の意図
- 現在もそのコメントが意味を持つか
過去数年にわたる履歴まで調べ、TODOとその意図が現在は不要だと確認できた場合だけ、削除変更を人のレビューへ送ります。
このTODO cleanerは、6か月で数千件の不要な参照を削除し、人のレビュアーによる承認率は95%を超えたとGoogleは報告しています。
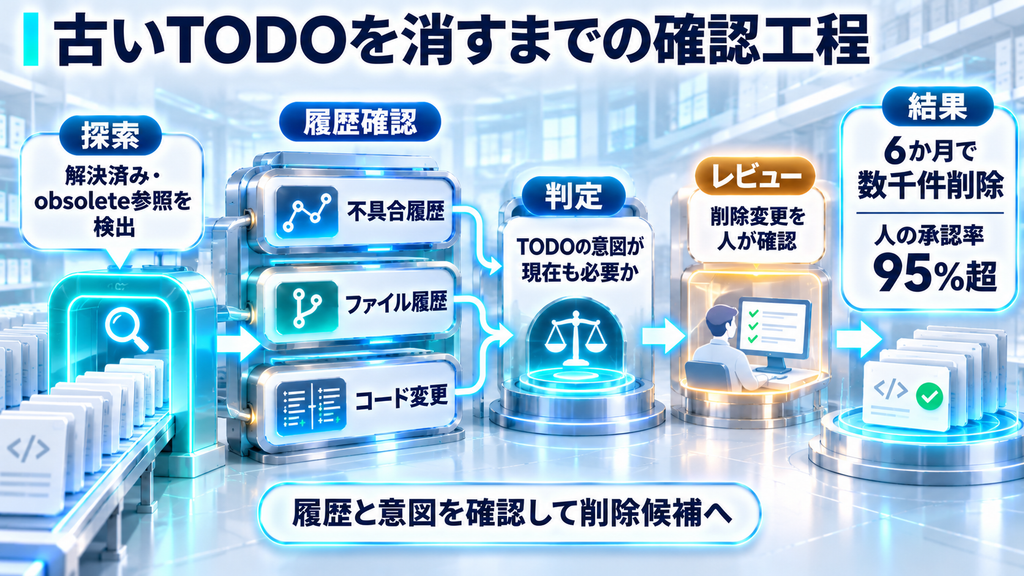
この方法は、情報衛生の保守自体をエージェントへ任せつつ、最終削除を人のレビューへ残す構成です。
エージェント向けリポジトリでは「情報の寿命」を管理する
Googleの分析を開発運用へ置き換えると、TODOやドキュメントがいつまで有効かを管理する必要があります。
1. TODOは状態を確認できる正本へつなぐ
TODOをIssueや不具合管理票へリンクする場合、リンク先の状態が正本になります。
修正済み、won’t fix、重複、仕様変更などで意味が変わったときに、コード側の参照も確認できる運用にします。
2. 解決済み参照を定期的に検出する
Googleはpresubmit analyzer、コードベース全体を走査するscanner、自動エージェントによる清掃を対策として挙げています。
新しく古い参照を増やさない仕組みと、既存の参照を定期的に見直す仕組みを分けて持てます。
3. ドキュメントとコードの不一致も同じ対象として扱う
Agent Distractionで定量化された代理指標はTODO/FIXMEの不具合参照です。
Googleは背景説明で、古い仕様書や更新の遅れたドキュメントもエージェントの文脈へ入り、判断を誤らせる要因として挙げています。
2026年6月の「Context Rot in AI-Assisted Software Development」でも、AGENTS.mdやCLAUDE.mdなどAI向けの永続コンテキストがコード変更に追随しない問題が「context rot」として整理されています。
リポジトリの情報衛生には、コードコメント、README、設計文書、AI向け指示ファイルまで含まれます。
4. 「見つけた別件」と「今回直す範囲」を分ける
今回のGoogle分析では、開いている別件を見つけた後に、その別件が利用者の依頼へ自動的に追加されるケースがスコープ拡大として分類されています。
実務では、エージェントが別の問題を見つけた場合に、
- 今回の変更へ含める
- Issue候補として報告する
- 追加調査だけ行う
- 今回は触らない
のどこまで許可するかを、タスク単位で決められます。
5. 清掃変更も人のレビュー対象にする
古いTODOに見えても、実装上の制約や過去の判断を残す「load-bearing」なコメントの場合があります。
GoogleのTODO cleanerも、不具合履歴とコード履歴を調べたうえで、人のレビューへ変更を送っています。
情報衛生を自動化する場合も、削除の根拠と変更差分を確認できる形にすると、必要な文脈まで消すリスクを抑えられます。
13%が示すのは不具合ID付きTODO/FIXMEへの遭遇率
13%の対象は、Googleの内部環境でエージェントがファイルを読んだセッションのうち、TODO(bug/...)やFIXME(bug/...)の不具合参照に遭遇した割合です。
一般的なTODO: refactor later、コメントのない古い仕様、外部企業のコードベース全体は、この13%の集計対象外です。
また、70%・77%・105%は観測されたトレースを統計的に調整した回帰結果です。
今回の発表は、エージェントが読むリポジトリ情報の鮮度とスコープを、開発基盤の一部として管理する必要があることを定量データで示しています。
まとめ
GoogleのAgent Distraction分析では、数百万件のファイル読取セッションの13%が不具合ID付きTODO/FIXME参照に遭遇し、その遭遇の6%で追加行動が発生しました。追加行動の83%は、開発者が依頼していないものでした。
未依頼の寄り道では、閉じた不具合を追うケースと、開いている別件へ作業範囲を広げるケースの両方が確認されています。回帰分析では、ステップ70%、トークン77%、待ち時間105%の増加が観測されました。
コーディングエージェントがコードベースを広く読むほど、コメント、仕様書、Issue参照、AI向け指示ファイルも実行時の判断材料になります。
リポジトリの保守対象には、動くコードに加えてコメント、仕様書、Issue参照、AI向け指示も含まれます。エージェントが読む情報を現在の状態と一致させ、別件を見つけたときの作業範囲を決めておくことが、AIエージェント時代の開発運用になります。