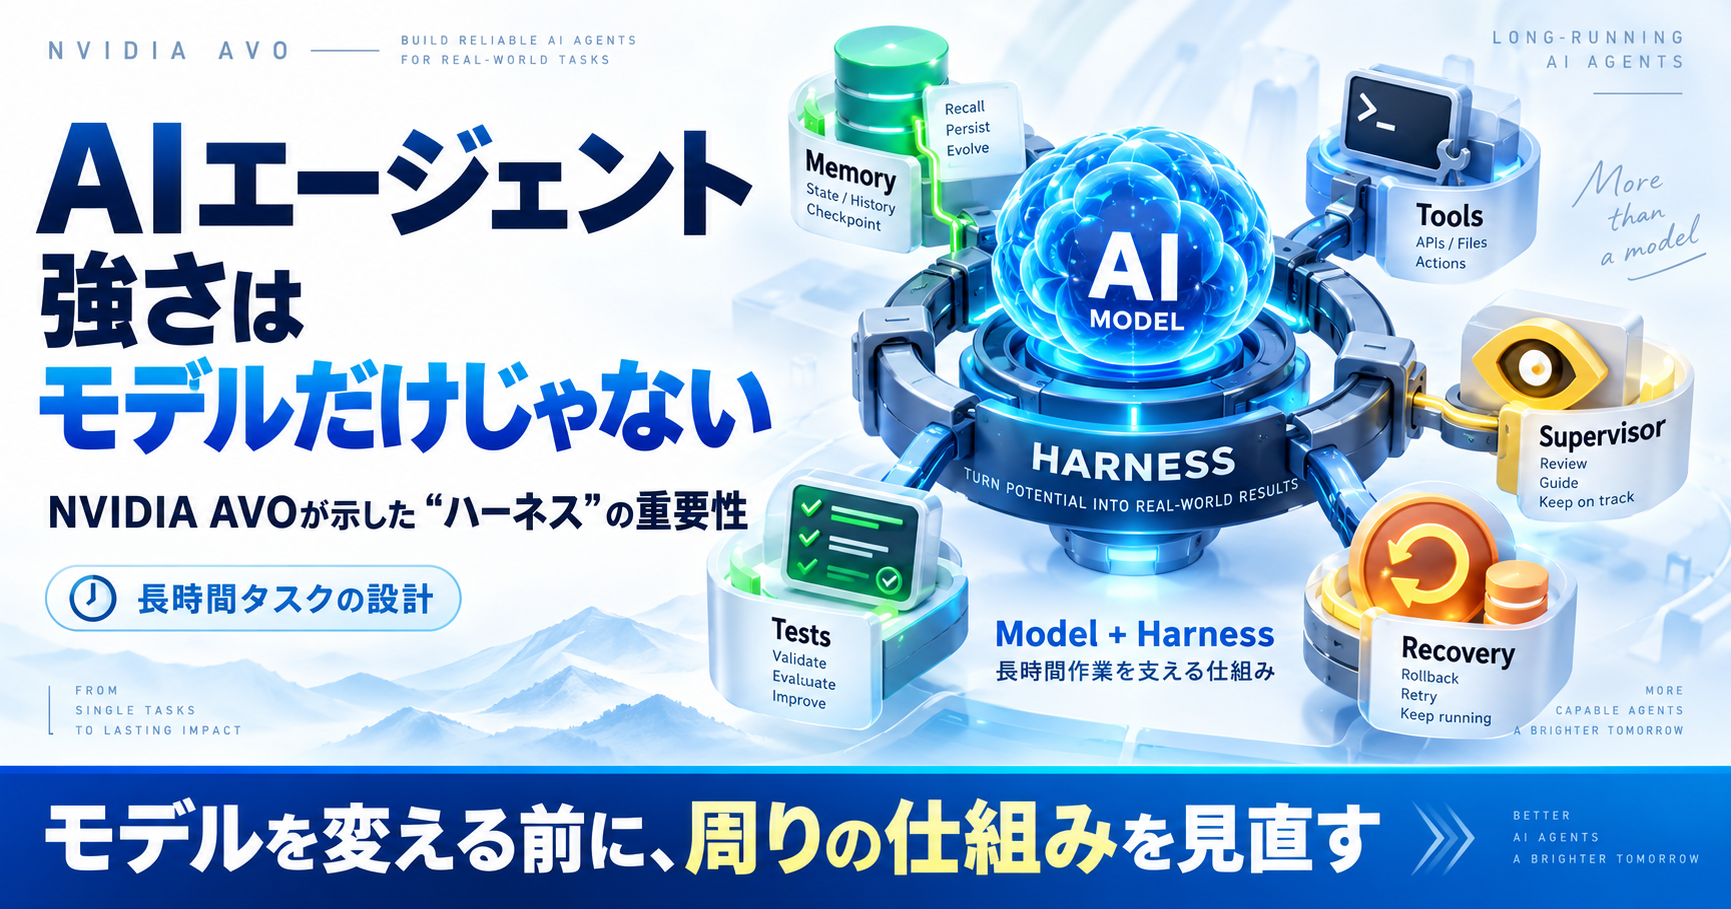
AIエージェントを使っていると、「もっと性能の高いモデルへ変えれば、長い仕事も安定するのでは」と考えたくなります。
ただ、長時間の作業ではモデルだけを強くしても、途中で同じ失敗を繰り返したり、前に試したことを忘れたり、テストせずに進んだりすると成果は安定しません。
NVIDIAが公開したAVO(Agentic Variation Operators)は、この問題をかなり分かりやすく示した研究です。
AVOでは、AIモデルの周囲にあるメモリ、ツール、評価、状態保存、監督、失敗からの回復まで含めて1つのエージェントシステムとして設計します。この周辺の仕組みは、一般に「ハーネス」と呼ばれます。
NVIDIAはClaude Opus 5を使ったARC-AGI-3の公開セットで、モデル単体のベースライン30%に対し、AVOシステム全体では100.00 RHAEを達成したと説明しています。対象は公開25環境・183レベルで、ARC-AGI-3全体の非公開セットまで100%という意味ではありません。
この記事ではAVOそのものの導入方法ではなく、長時間AIエージェントを安定させるために何を周囲へ用意すればよいのかを、Codexでの開発運用にも置き換えながら見ていきます。
NVIDIA AVOとは
AVOは、NVIDIAが研究している長時間AIエージェントのアーキテクチャです。
もともとはGPUカーネルの最適化のように、1回コードを書いて終わりではない仕事を自律的に続けるために作られました。
こうした仕事では、AIは次のような流れを何度も回します。
過去の結果を確認
↓
仮説を立てる
↓
コードを変更
↓
実行・評価
↓
失敗原因を確認
↓
次の修正を考える
AVOの論文では、従来の「LLMが候補を1つ生成する」方式から一歩進み、何を調べるか、何を変更するか、いつ評価するかまでエージェント自身が判断します。
エージェントには、過去の解決策とスコア、専門知識、評価関数が与えられます。うまくいかなかった案は修正し、正しさを確認でき、これまでの最高結果と同等以上になったものだけを新しい状態として保存します。
NVIDIAのGPUカーネル最適化では、7日間の自律実行で500を超える探索方向を試し、40の改善版を積み上げました。評価対象の構成では、cuDNNを最大3.5%、FlashAttention-4を最大10.5%上回っています。
ここで注目したいのはスコアそのものより、7日間の作業を続けるために何が必要だったかです。
「ハーネス」はAIモデルの周囲にある仕組み
AIエージェントのハーネスは、モデルが仕事を続けるための周辺システムです。
NVIDIAの説明を開発作業へ置き換えると、次のように考えられます。
| 要素 | 役割 | Codexでの例 |
|---|---|---|
| 指示・知識 | 何を守り、どこを読むか | AGENTS.md、設計書、仕様書 |
| 状態保存 | 何を試し、どこまで進んだか残す | Git、実装計画、作業ログ |
| ツール | 観測・変更・実行を行う | ファイル操作、Terminal、MCP、ブラウザ |
| フィードバック | 結果が正しいか判定する | テスト、Lint、Build、実画面確認 |
| 監督・回復 | 停滞や失敗ループから抜ける | サブエージェントレビュー、再計画、ロールバック |
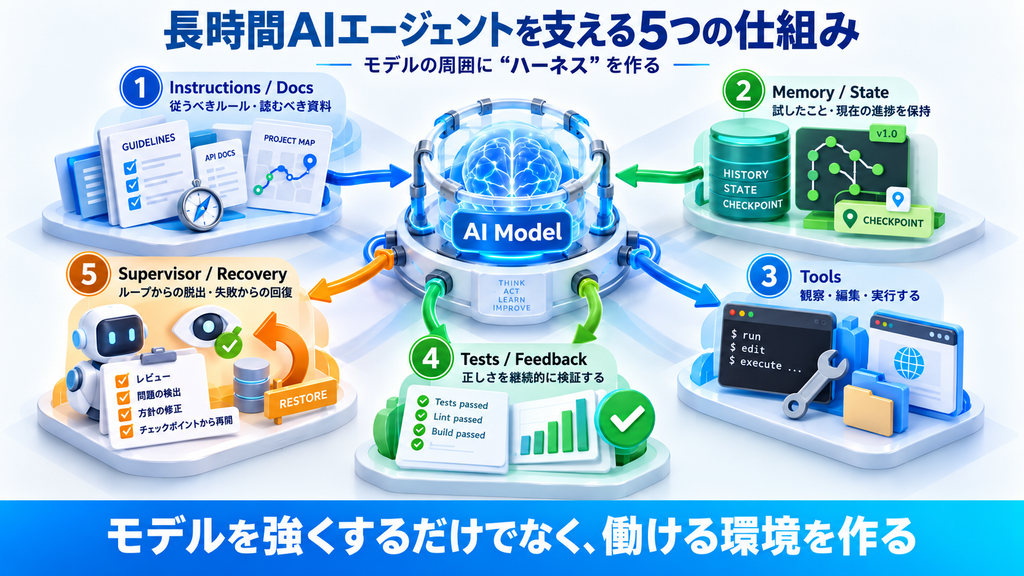
同じモデルを使っていても、この部分が整っているかどうかで長い作業の進み方は大きく変わります。
モデルが強ければ、1回の判断やコード生成は良くなります。しかし長時間タスクでは、前の結果を引き継ぎ、失敗を観測し、正しい状態だけを残し、必要なら方向転換する仕組みが必要です。
AVOが示したのは「モデルだけの性能」ではない
2026年8月にNVIDIAは、同じAVOアーキテクチャをARC-AGI-3へ適用した結果を公開しました。
Claude Opus 5を使い、公開25環境・183レベルをすべて完了し、100.00 RHAEを達成しています。NVIDIAの説明では、Claude Opus 5のモデルベースラインは30%でした。
この数字だけを見ると、「ハーネスを付ければ30%が100%になる」と受け取りたくなりますが、そこまで単純ではありません。
ARC-AGI-3で使ったAVOには、永続メモリ、独自の実行ループ、監督、観測方法などが含まれています。別システムのVISTAと比較して約12%少ない環境アクションで同じ公開183レベルを完了していますが、NVIDIA自身も同条件の比較実験ではないと明記しています。
重要なのは、数字の差を1つの機能へ帰属することではありません。
長時間タスクの能力は、モデル単体ではなくシステム全体で決まるという点です。
1. AGENTS.mdは「全部を書く場所」ではなく入口にする
長い作業では、AIが必要な情報へ迷わずたどり着けることが重要です。
OpenAIもCodexを使ったハーネス設計について、巨大なAGENTS.mdへすべてを詰め込む方法はうまくいかなかったと説明しています。
情報を詰め込みすぎると、
- 本当に重要な指示が埋もれる
- タスクに不要な情報までコンテキストを使う
- 古いルールが残りやすい
- AIがどこを見るべきか判断しにくくなる
という問題が出ます。
そこでOpenAIでは、AGENTS.mdを短い「地図」として使い、詳しい設計や運用知識はdocs配下などへ分けています。
私も最近は、AGENTS.mdへ何でも詰め込むのではなく、「この作業ならこのファイルを読む」という入口を作る方向へ整理しています。
AVOでいうdomain-specific knowledge baseを、Codexが必要なときにたどれる形へしておくイメージです。
2. 長時間作業では「状態を残す」ことが効く
AVOは改善したコードをGit commitとして保存し、そのときのスコアも残します。
これによって、どの状態が良かったのか、何を試したのかを後から参照できます。
Codexでも同じで、長い作業をチャットの記憶だけへ依存すると、途中でコンテキストが変わったときに経緯を失いやすくなります。
私の開発では、ChatGPTとCodexの受け渡しにtalkフォルダを使い、設計、レビュー結果、実装完了報告などをMarkdownで残しています。
会話が切り替わっても、ファイルを読み直せばどこまで進んだかを戻せます。
これはAVOのpersistent memoryと同じ実装ではありませんが、重要な状態をエージェントの外へ残すという考え方は共通しています。
3. テストはAIへの「答え合わせ」になる
AVOでは、コードを書くだけでは改善として採用しません。
GPUカーネルなら正しさと性能を評価し、条件を満たしたものだけを次の状態として残します。
Codex開発でも、
実装した
↓
動きそう
↓
完了
ではなく、
実装
↓
型チェック
↓
Lint
↓
単体・統合テスト
↓
Build
↓
必要なら実画面確認
というフィードバックループを作った方が安定します。
モデルへ「正しいコードを書いて」と頼むだけではなく、何をもって正しいと判定するかを環境側へ用意することが重要です。
OpenAIもCodexの開発環境について、信頼できるテスト設定と明確なドキュメントがある環境でエージェントが働きやすいと説明しています。
4. 同じエージェントが詰まったら別の視点を入れる
AVOには、探索が停滞したり、改善しない修正を繰り返したときに方向を変えるself-supervisionがあります。
長いAI作業で厄介なのは、間違えることだけではありません。
同じ仮説のまま、
修正
↓
失敗
↓
少し変えて再修正
↓
また失敗
を続けることがあります。
この状態で同じエージェントへ「もう一度考えて」と繰り返しても、似た方向へ戻ることがあります。
私のCodex運用では、メインエージェントが実装した後に、サブエージェントを独立したレビュー担当として使っています。

実装した側とは別の視点から差分を見ることで、テスト不足や異常系の抜けを見つけられました。
AVOのsupervisorとCodexのサブエージェントレビューは同じ仕組みではありません。ただ、進まなくなったときに別の視点を入れて方向を修正するという考え方は近いです。
5. ツールを持たせるだけでなく、観測できるようにする
AIエージェントへTerminalやMCPをつなげば、できることは増えます。
ただし、ツールの数が多いだけでは長時間作業は安定しません。
AVOが強く依存しているのは、変更した結果をその場で測定できることです。コンパイラ、テスト、プロファイラ、ベンチマークから結果が戻り、その情報を次の判断へ使います。
Codexでも、ログ、テスト結果、ブラウザ表示、Git差分などを自分で確認できる方が、途中で人がすべて説明する必要が減ります。
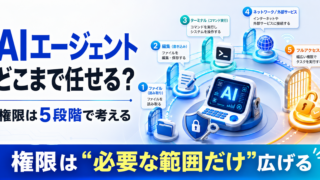
これはAIへ権限を無制限に与えるという意味ではありません。操作できる範囲は必要な場所へ絞りながら、担当する仕事の結果を自分で確認できる環境を作ることが重要です。
AIエージェントの権限設計はこちらの記事で詳しく整理しています。
高性能モデルへ変える前に見直したい5項目
AIエージェントがうまく働かないとき、モデル変更の前に次を確認すると原因を切り分けやすくなります。
- 指示:何を守ればよいか、必要な資料へたどり着けるか
- 状態:前に試したこと、決めたこと、進捗が残っているか
- ツール:必要なファイル、コマンド、外部情報へアクセスできるか
- 評価:成功・失敗をテストや数値で判定できるか
- 回復:詰まったときに再計画、レビュー、ロールバックできるか
この5つが曖昧なままモデルだけを強くすると、1回ごとの回答は良くなっても、長い工程では同じ問題が残ることがあります。
反対に、ハーネスが整っていれば、普段使いのモデルでも任せられる工程が増えます。
モデルとハーネスはどちらか一方ではない
AVOの結果を見て「モデル性能よりハーネスの方が重要」と言い切るのも違います。
AVO自体がClaude Opus 5のような高性能モデルを使っています。難しい推論やコード生成では、モデルの能力が土台になります。
そのうえで、長時間のエージェント作業では、
- 高性能モデル
- 適切なコンテキスト
- 状態保存
- 実行ツール
- 機械的な評価
- 監督と回復
が組み合わさって初めて性能を引き出せます。
モデルを選ぶことと、モデルが働きやすい環境を作ることは別の仕事です。
AVOが面白いのは、その周辺部分が単なる補助ではなく、エージェントの能力そのものへ大きく影響することを具体的に示した点だと思います。
まとめ
NVIDIA AVOは、長時間AIエージェントをモデル単体ではなく、メモリ、ツール、評価、状態保存、監督、回復まで含めて設計する研究です。
ARC-AGI-3の公開セットではClaude Opus 5を使ったAVOが100.00 RHAEを達成しましたが、重要なのは100%という数字だけではありません。
長い仕事を安定して続けるには、
- 必要な情報へたどり着ける
- 前の状態を残せる
- 自分でツールを使える
- 結果を機械的に評価できる
- 詰まったときに方向転換できる
という環境が必要です。
Codexでも、AGENTS.md、設計書、Git、テスト、サブエージェントレビューなどを組み合わせれば、この考え方の一部を普段の開発へ取り入れられます。
新しいモデルが出るたびに切り替えるだけでなく、今使っているモデルが力を出せるハーネスになっているかを見ることも、AIエージェント時代の開発では重要になりそうです。
公式情報・参照先
- NVIDIA AVO Reaches 100% on ARC-AGI-3|NVIDIA Technical Blog
- AVO: Agentic Variation Operators for Autonomous Evolutionary Search|arXiv
- ハーネスエンジニアリング:エージェントファーストの世界におけるCodexの活用|OpenAI
- Codexが登場|OpenAI
今日の注目アイテム
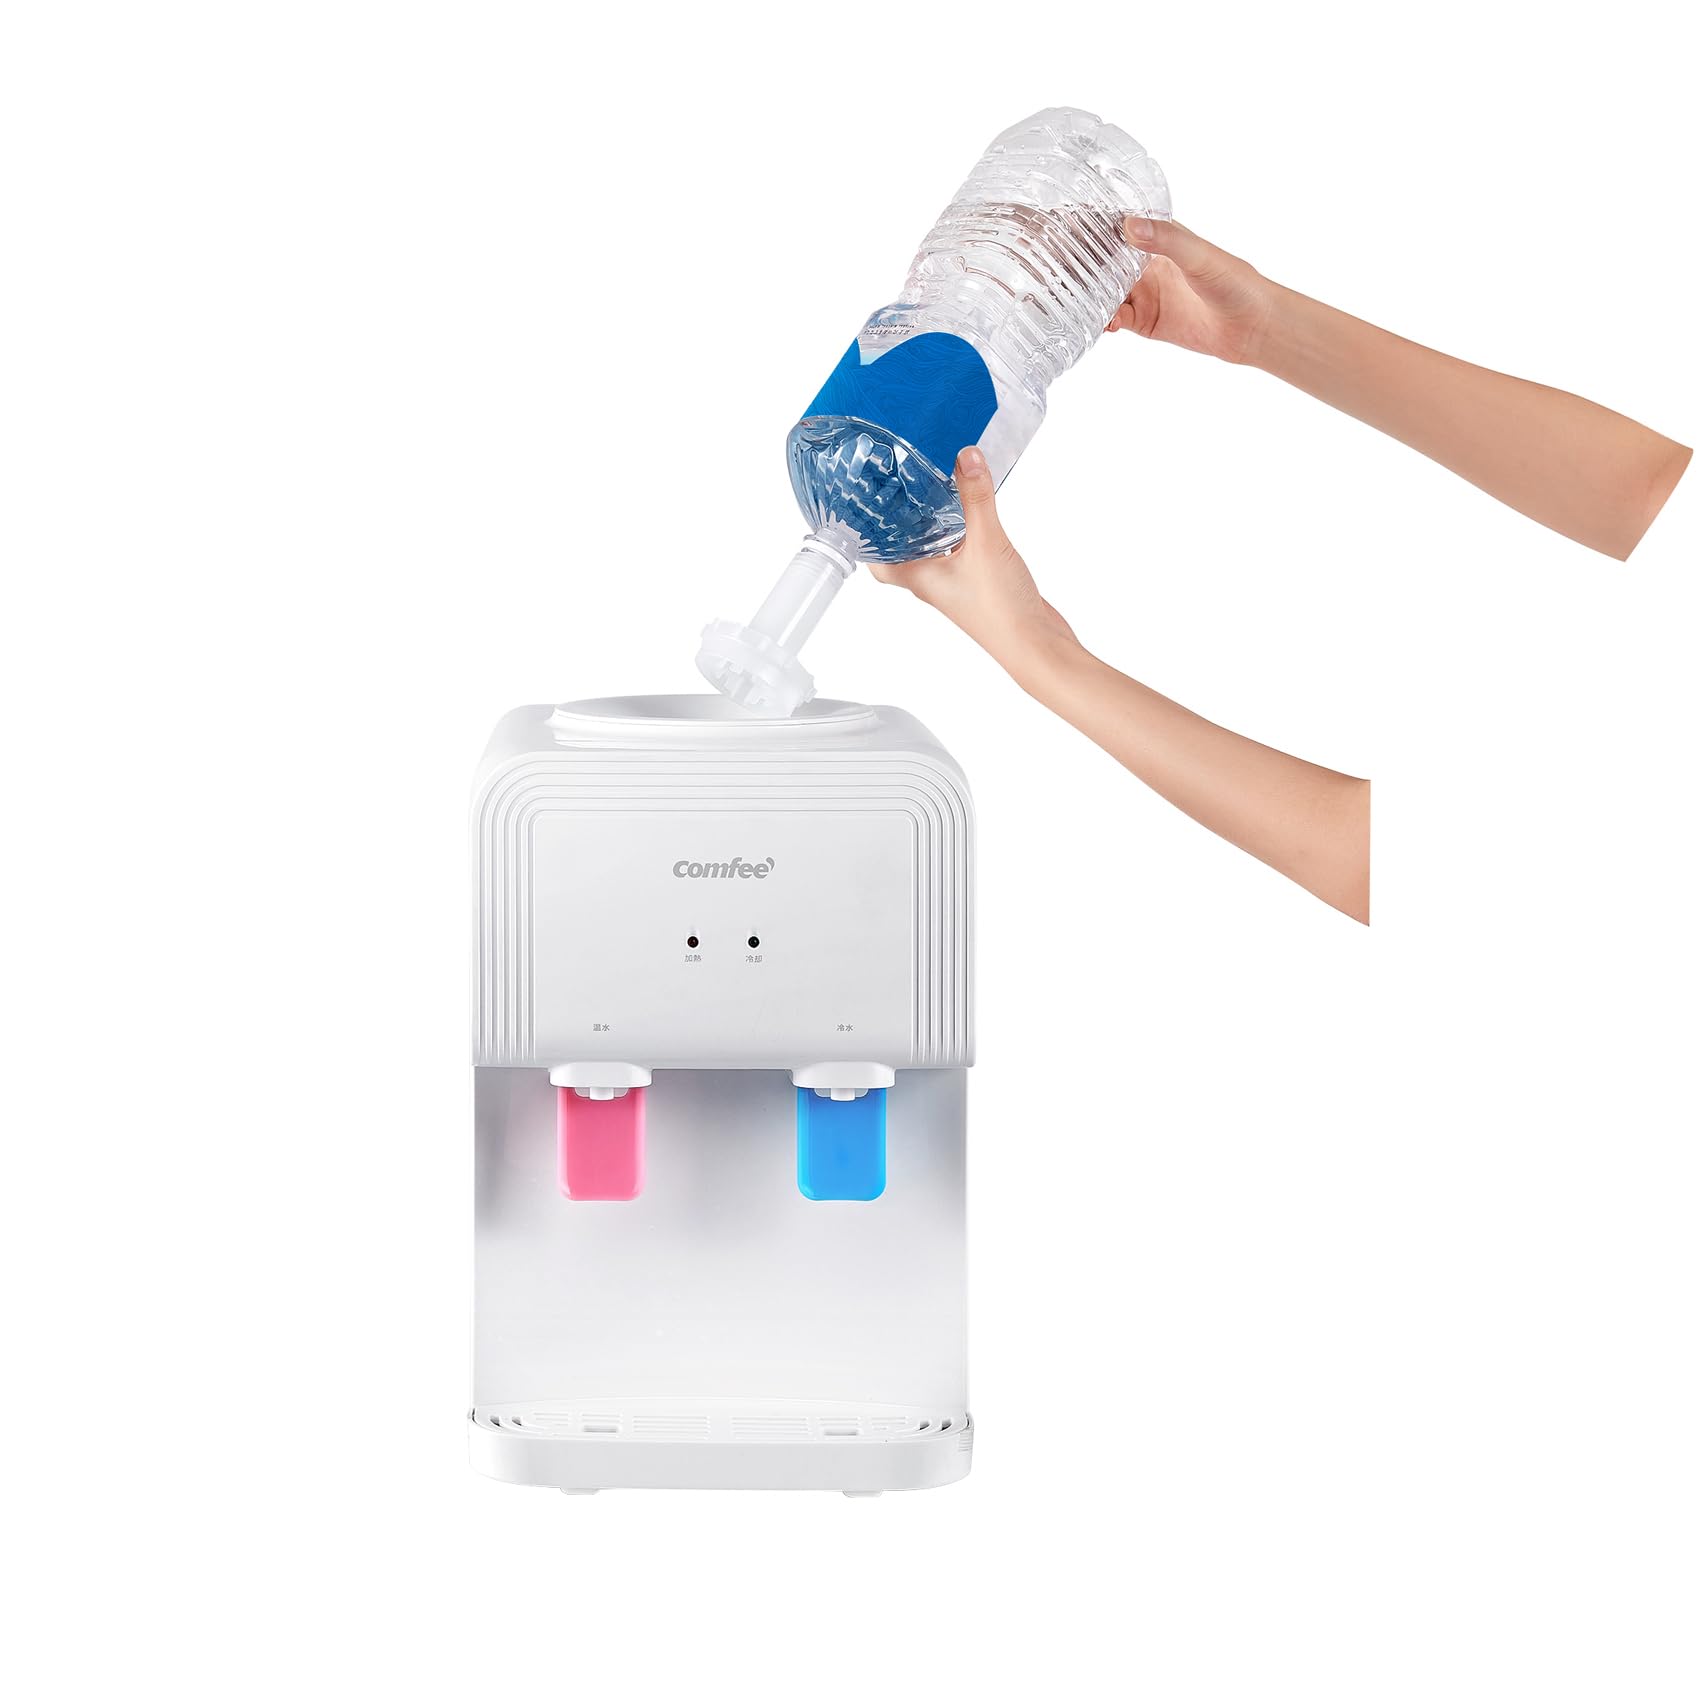

市販の2Lペットボトルに対応した、COMFEE’の卓上ウォーターサーバーです。 温水と冷水の両方に対応し、口径φ25とφ28の2種類のボトル用キャップが付属しています。
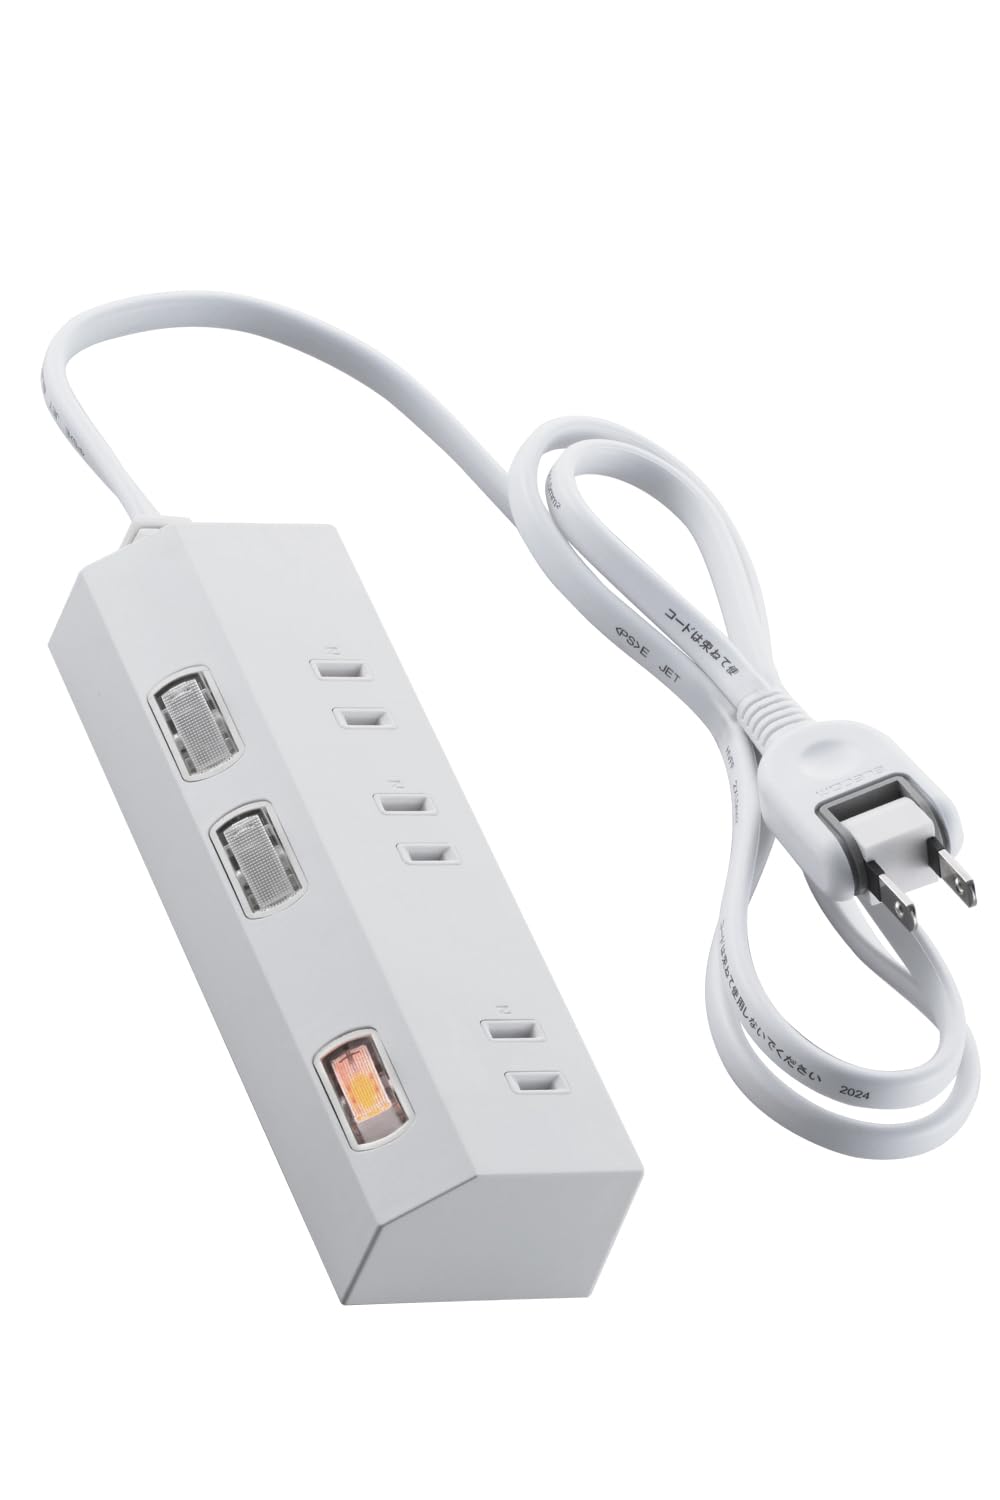

差込口ごとに電源を切り替えられる、エレコムの個別スイッチ付き3口電源タップです。 雷ガードとホコリ防止シャッターを搭載し、ACコード長は1mです。

差込口を10個備えた、エレコムの雷ガード付き電源タップです。 ほこりシャッターと固定・吊下可能な回転パーツを搭載し、コード長は2mです。
※アフィリエイトリンクを含みます。