当サイトではアフィリエイト広告を利用しています。
NVIDIA、Rebellions、SK Telecomは、韓国のソブリンAI基盤を構築するための協業を発表しました。米国時間2026年11月8日にNVIDIAが発表し、11月9日にはソウルのNVIDIA AI Dayで3社がGPU・NPU統合システムの開発・検証に向けたMOUを締結しています。
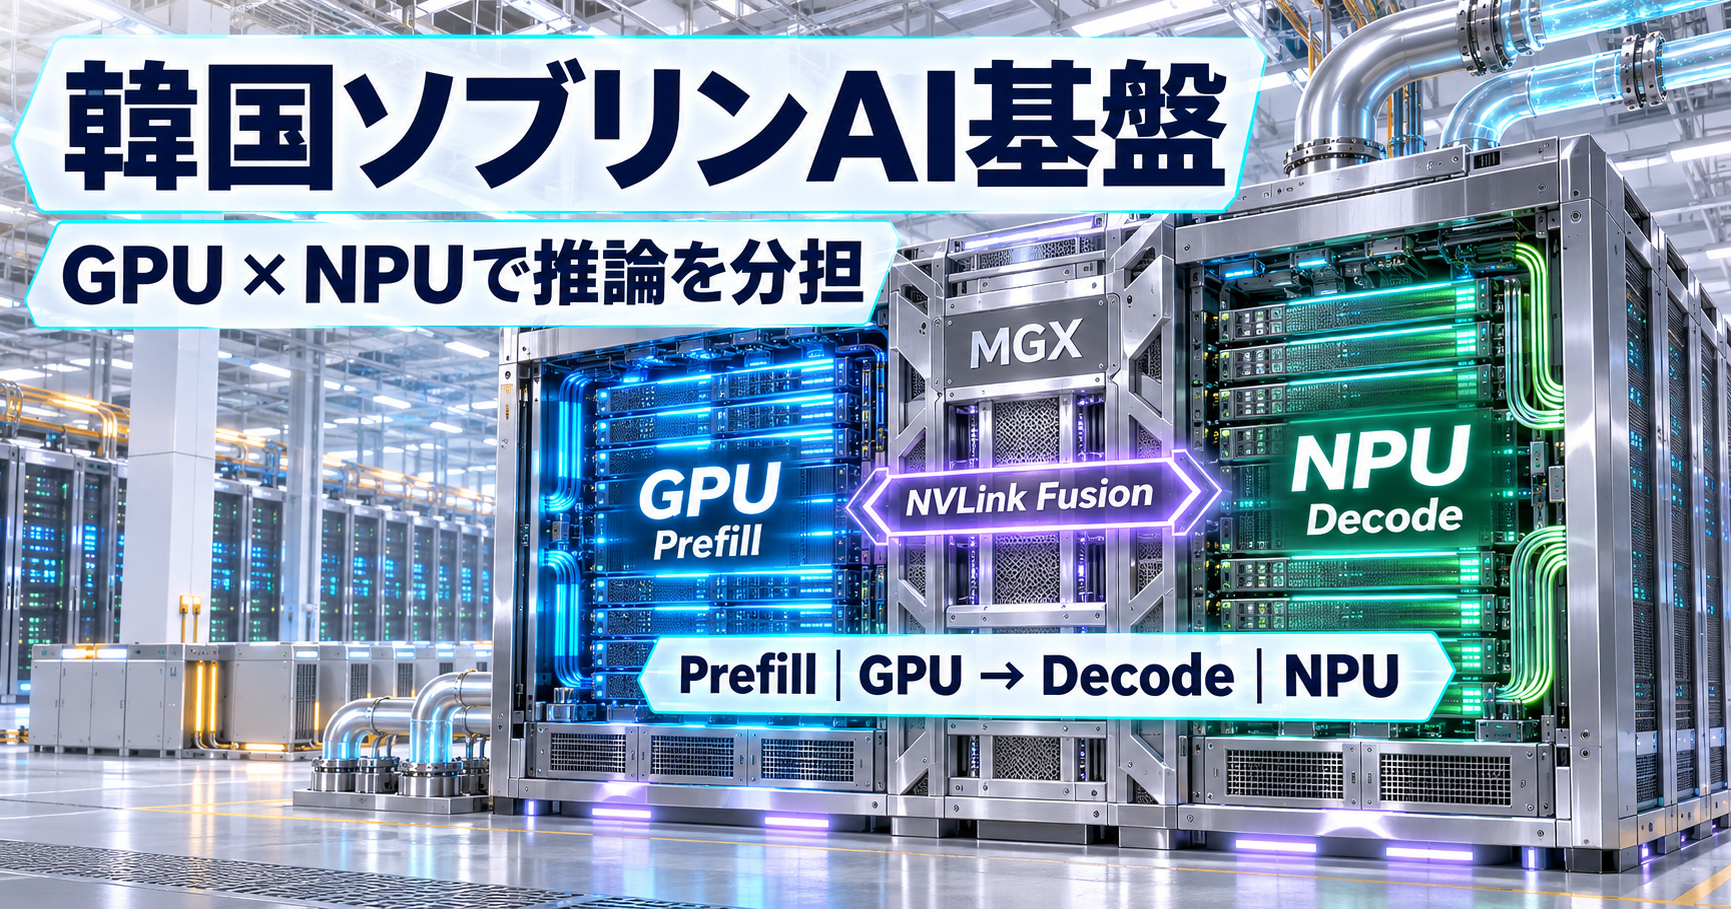
今回の計画では、入力を処理するPrefill(プリフィル)をNVIDIA GPU、回答をトークン単位で生成するDecode(デコード)をRebellionsのNPUへ分担させます。
その周囲をNVIDIA NVLink FusionとMGXラックアーキテクチャで支え、SK TelecomがAIデータセンター、独自モデル、一般向けサービスへつなぐ構成です。Rebellionsの次世代R200システムは、2028年に配備可能となる見込みが示されています。
この記事では、GPUとNPUを分ける理由、NVLink FusionとMGXの役割、SK Telecomが担うデータセンター層、そして2028年までに何が実装・検証される計画なのかを確認します。
3社の役割はチップ・ラック・データセンター・サービスへ分かれる
今回の協業は、AI推論を動かす計算基盤から、その上のモデルとサービスまでをつなぐ構成です。
| 主体 | 主な役割 |
|---|---|
| NVIDIA | GPU、NVLink Fusion、NVLinkスケールアップネットワーク、MGXラックアーキテクチャ |
| Rebellions | 韓国設計の次世代R200 NPU、NPU側の推論システム開発 |
| SK Telecom | AIデータセンター運用、独自基盤モデル、一般向けAIサービス |
| 韓国科学技術情報通信部 | 協業を政策面から支援 |
Rebellionsは、NVLink Fusionを使ってR200 NPUをNVIDIAのインフラプラットフォームへ接続し、MGXを使ったラックスケールシステムを開発する計画です。
SK Telecomは、そのシステムを自社AIデータセンターへ導入し、独自モデル「A.X K2」や「AI for All」関連サービスを含むAIサービスへ接続する計画を示しています。
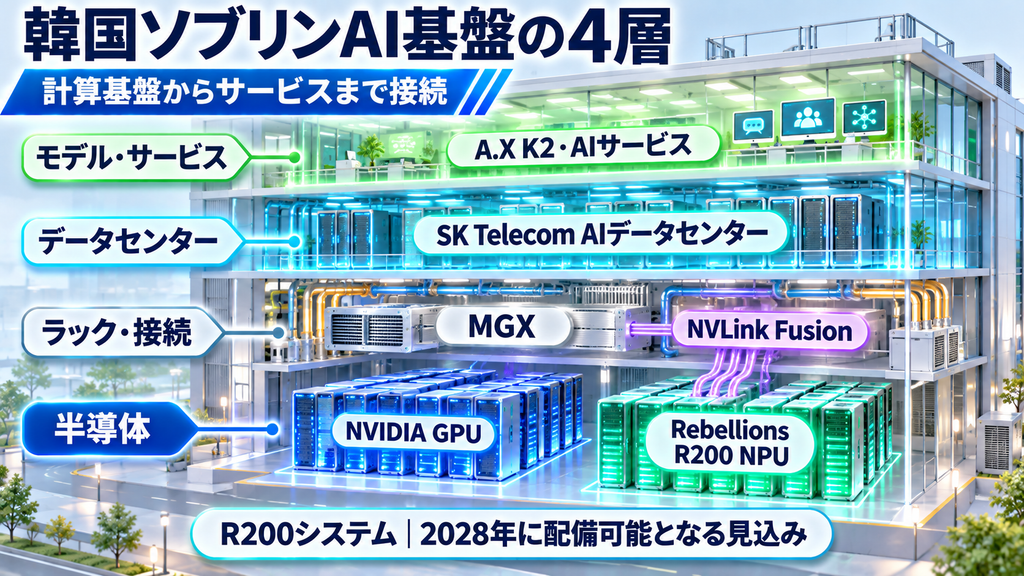
今回の「ソブリンAI」は、韓国設計のNPU、韓国のモデル・サービス、SK Telecomのデータセンター運用と、NVIDIAのグローバルな計算基盤技術を組み合わせる設計です。
分離推論ではPrefillをGPU、DecodeをNPUへ割り当てる
大規模言語モデルの推論は、大きくPrefillとDecodeの2段階に分かれます。
Prefillは、入力されたプロンプトをまとめて処理し、最初の出力へ進むための内部状態を作る段階です。長い入力を並列に計算するため、計算性能への要求が大きくなります。
Decodeは、その状態を使いながら回答を1トークンずつ生成する段階です。トークン生成のたびにモデルの重みやKVキャッシュへアクセスするため、メモリ帯域とデータ移動の効率が重要になります。
3社が計画している分離推論は、この特性差に合わせて処理を割り当てます。
| 推論段階 | 計画する担当 | 主な特性 |
|---|---|---|
| Prefill | NVIDIA GPU | 入力をまとめて処理する計算負荷が大きい |
| Decode | Rebellions R200 NPU | トークンを逐次生成し、メモリ帯域の効率が重要 |
NVIDIAのDisaggregated Servingの説明でも、Prefillは計算負荷が大きく、Decodeはメモリ帯域の影響を受けやすい処理として分けられています。
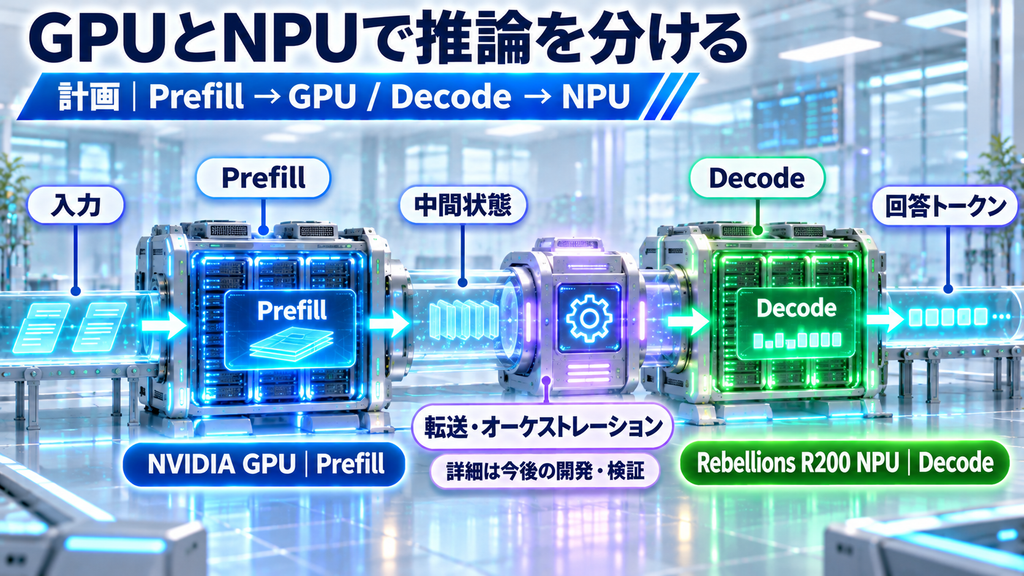
この方式では、それぞれの段階に合うアクセラレータを割り当てることで、推論スループットと電力効率の向上を目指します。
公開済みの協業発表では、GPUからNPUへ渡すKVキャッシュの転送方式、スケジューラ、対応モデルごとの配置方法など、実装の詳細は示されていません。3社はGPU・NPU統合システムを開発・検証する段階にあります。
Rebellions R200はDecode側の推論アクセラレータとして開発中
RebellionsのR200は、低遅延かつ電力効率の高い推論を狙う次世代NPUです。
NVIDIAの発表では、数兆パラメータ規模のMixture-of-Experts(MoE、複数の専門ネットワークから必要な部分を選んで使う方式)を含むフロンティアモデルを想定した推論アクセラレータとして説明されています。
Rebellionsは以前から、LLMサービング基盤でPrefillとDecodeを分ける構成や、複数ノードへの分散、MoEルーティングを扱う仕組みを開発してきました。
今回の協業では、R200をDecode側へ割り当て、NVIDIA GPUと異なる処理段階を担当させる計画です。
NVLink FusionはR200をラックスケール基盤へ組み込む接続技術
NVLink Fusionは、NVIDIAのNVLinkスケールアップ技術やラック設計を、外部企業のカスタムXPUやCPUへ広げるための仕組みです。
RebellionsはNVLink Fusionを採用し、複数のR200 NPUをNVIDIA NVLinkスケールアップネットワークへ接続し、ラック単位の高帯域・低遅延なシステムへ組み込む計画です。
NVLink Fusionの採用企業は、NVLink、MGXラックアーキテクチャ、NVIDIAのインフラエコシステムを利用できます。カスタムAIチップをデータセンターへ大量導入する際に必要な、ラック設計、電力、冷却、部品調達までを既存基盤へ合わせやすくする狙いがあります。
MGXはGPUとNPUでラック・電力・冷却を共通化する
MGXは、GPUやカスタムXPUを搭載するラックスケールシステムのためのモジュール型アーキテクチャです。
今回の協業では、GPUシステムとR200 NPUシステムが次のデータセンター設計要素を共有できる基盤としてMGXが使われます。
- ラックの設置面積
- 電力供給
- 冷却
- ネットワークやシステム管理の周辺設計
- ODMや部品サプライヤーを含む供給網
これは、AIチップの準備が完了する前からデータセンター側の設計を進めるうえでも意味があります。
R200のプロセッサ・システム開発と並行して、SK Telecomはラック、電力、冷却などの施設側をMGX基準で計画できます。将来GPUとNPUの構成比が変わる場合も、共通化した物理基盤を使える設計です。
AIデータセンターでは、アクセラレータの性能と同時に電力供給の柔軟性も運用条件になります。大規模計算拠点の電力需要をどう調整するかは、OpenAI Grid Protectorsの記事で詳しく扱っています。
SK Telecomはインフラの上にモデルとサービスを接続する
SK Telecomは、GPU・NPUシステムを置くAIデータセンター運用に加え、独自の基盤モデルと一般向けサービスを持っています。今回の協業では、MGXベースのシステムを自社AIデータセンターへ導入し、その上でA.X K2などの独自モデルと「AI for All」関連サービスを動かす構想です。
この構成では、ソブリンAIを次の4層で捉えられます。
- 半導体:NVIDIA GPUと韓国設計のRebellions NPU
- システム:NVLink FusionとMGXによるラックスケール基盤
- 運用:SK TelecomのAIデータセンター
- モデル・サービス:独自基盤モデルと韓国内向けAIサービス
韓国内でモデルを継続的に推論し、サービスとして提供する計算基盤まで設計対象になっています。
現在は開発・検証段階、R200は2028年に配備可能となる見込み
2026年11月時点で確認できるのは、3社がGPU・NPU統合システムの開発・検証に向けて協業し、RebellionsがR200を開発中であることです。
R200システムは2028年に配備可能となる見込みです。
今後確認する項目は次の通りです。
- GPU PrefillからNPU Decodeへ渡すデータ転送方式
- 対応するモデルと量子化・精度条件
- PrefillとDecodeのリソース比率
- 推論スループット、応答時間、消費電力
- GPU単独・NPU単独との比較
- SK TelecomのAIデータセンターでの導入規模
- A.X K2や公共向けサービスでの実運用結果
現段階の発表は、分離推論とラック構成の設計方針と配備計画を示したものです。性能向上率や電力削減率は、今後の検証結果を見て判断する必要があります。
異種アクセラレータ基盤では5つの境界を見る
GPUとNPUを組み合わせる基盤では、チップ性能と処理境界の両方が評価対象になります。
1. どの処理をどのアクセラレータへ割り当てるか
PrefillとDecodeでは計算特性が異なります。最適なGPU・NPUの台数比は、モデルやリクエスト長によって変わります。
2. 中間状態をどう移動するか
分離推論では、Prefillで作ったKVキャッシュなどをDecode側へ渡します。転送帯域と遅延は、分離による利点を左右します。
3. ラックの電力と冷却をどう共通化するか
ラック、電力、冷却、管理を共通化することで、異種アクセラレータを導入するときのデータセンター側の再設計範囲を抑えられます。
4. ソフトウェアが異種ハードウェアをどう制御するか
リクエストの振り分け、障害時の切り替え、モデル配置、キャッシュ転送を誰が管理するかが運用上の重要点です。
5. 将来計画と実測値を分ける
今回のGPU・NPU分離推論は開発・検証計画です。導入判断では、2028年へ向けて公開される実測性能と運用実績を確認する必要があります。
まとめ
NVIDIA、Rebellions、SK Telecomの協業は、韓国のソブリンAIを計算基盤から構築する計画です。
中心にあるのは、PrefillをNVIDIA GPU、DecodeをRebellions R200 NPUへ分担する分離推論です。NVLink FusionでR200をNVIDIAのラックスケール基盤へ組み込み、MGXでラック・電力・冷却などのデータセンター設計を共通化します。
その上でSK TelecomがAIデータセンター、独自モデル、一般向けサービスを接続します。
2026年11月時点では開発・検証計画で、R200システムは2028年に配備可能となる見込みです。今後の評価では、GPUとNPUの役割分担そのものに加えて、KVキャッシュ転送、ソフトウェア制御、電力効率、実測スループットまで確認することで、異種アクセラレータ基盤の実用性を判断できます。
公式情報・参照先
- NVIDIA、Rebellions、SK Telecom、NVIDIA NVLink Fusion によるソブリン AI インフラの推進に向けた協業を発表|NVIDIA Japan
- NVIDIA, Rebellions and SK Telecom Announce Collaboration to Advance Sovereign AI Infrastructure With NVIDIA NVLink Fusion|NVIDIA Newsroom
- SKT-엔비디아-리벨리온, 한국형 소버린 AI 인프라 구축 협력|SK Telecom Newsroom
- NVIDIA NVLink Fusion
- What Is Disaggregated Serving?|NVIDIA
- Disaggregated Serving|NVIDIA Dynamo Documentation
- LLM Serving with NPU: Re-engineered, Built for Scale and Efficiency|Rebellions