当サイトではアフィリエイト広告を利用しています。
DeepSeekは2026年11月13日、DeepSeek Appで使ってきた検索、ファイル入力、URL読取、安全チェック、音声機能などを開発者向けAPIへ広げました。
中心となるdeepseek-flashでは、Messages、Responses、Chat Completionsの各APIからWeb検索、深い検索、ファイル入力、URL読取、安全チェックを利用できます。Search、Fetch、OCR、音声認識(ASR)、音声合成(TTS)は単独APIとしても提供されます。
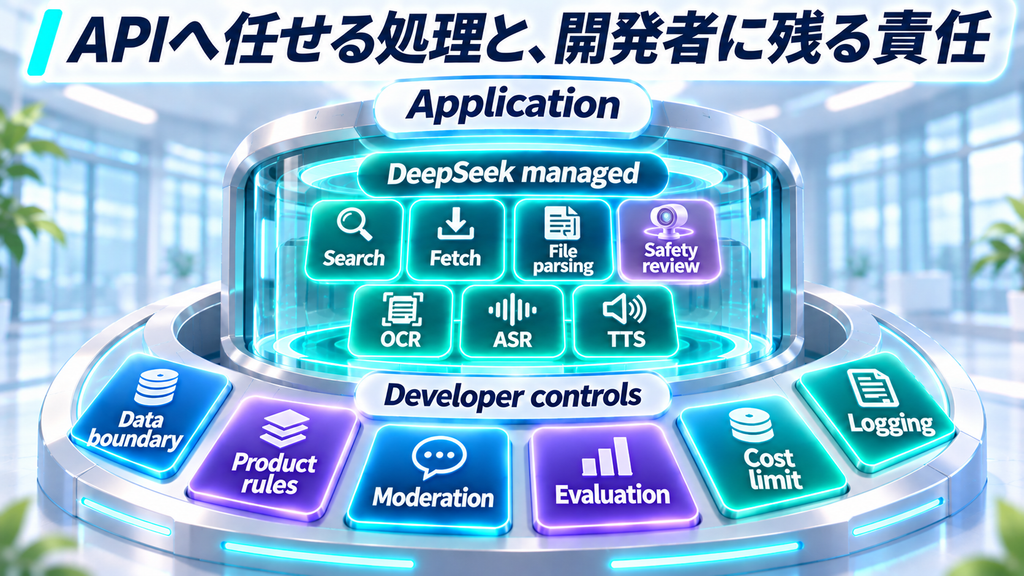
この更新の意味は、モデル呼び出しに外部検索や文書解析を一つずつ接続する構成から、ツール呼び出しと文脈組み立てをDeepSeek側へ任せられるアプリ基盤へ広がったことです。開発者側には、どの機能を使うか、どのデータを渡すか、安全制御、法令・表示対応、料金管理といった製品設計が残ります。
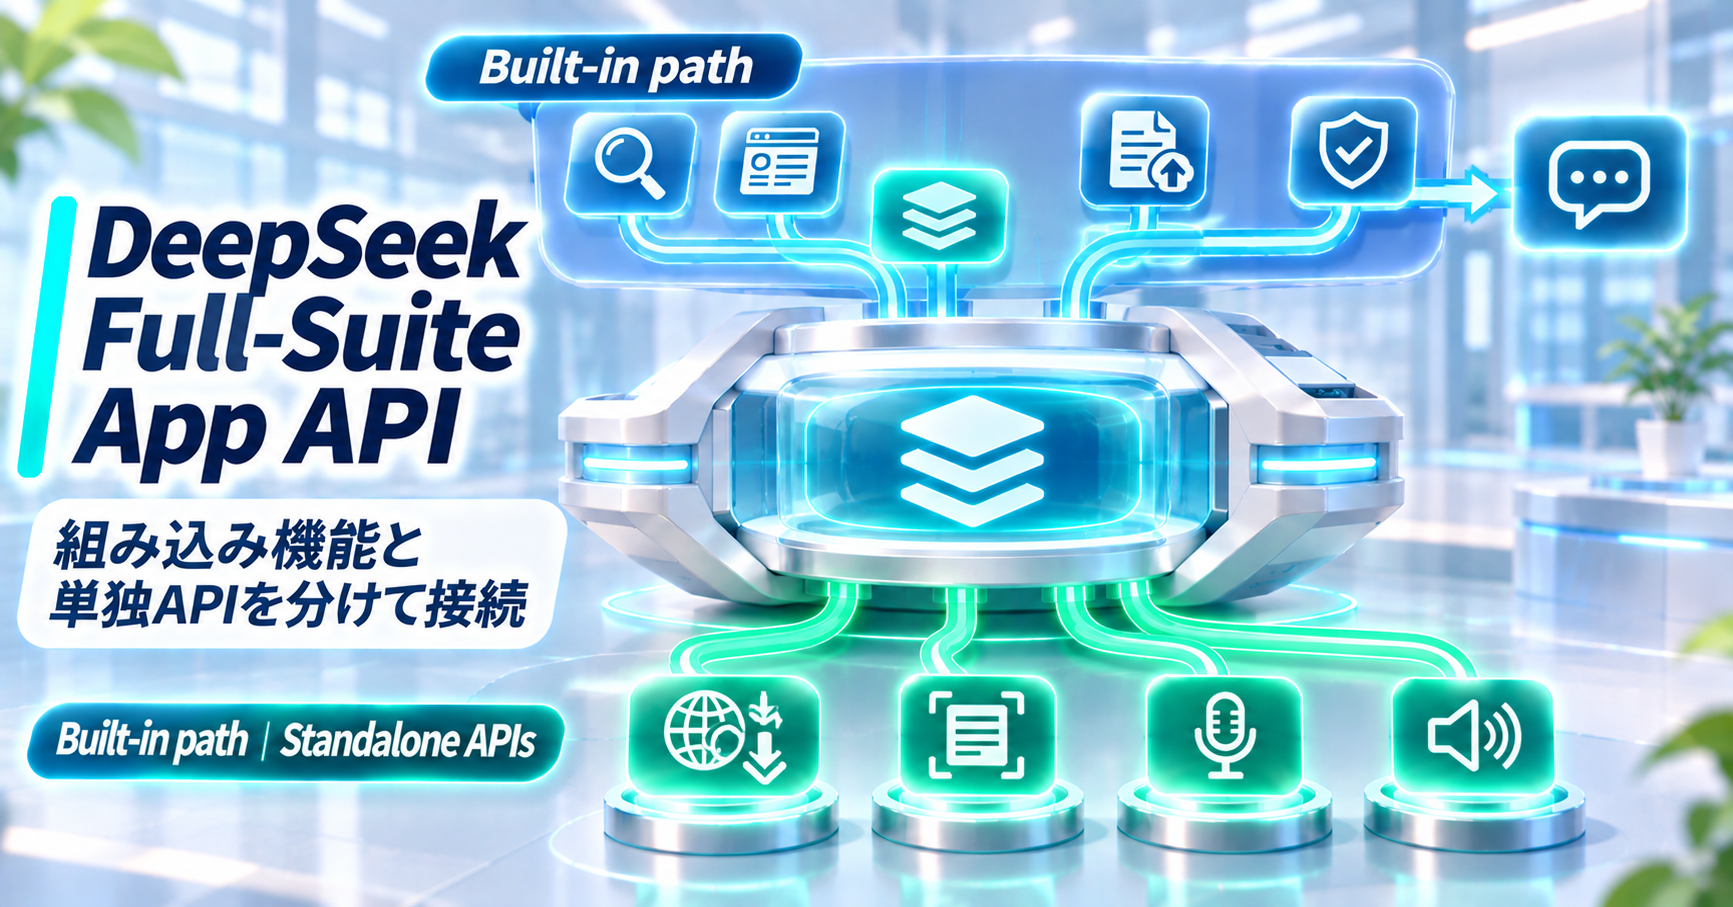
Full-Suite App APIは「組み込み機能」と「単独API」に分かれる
今回の公開では、同じ検索・文書・音声系の機能でも、モデル呼び出しへ組み込むものと、独立した処理として呼ぶものがあります。
| 機能 | 使い方 | 主な役割 |
|---|---|---|
| Web Search | deepseek_web_searchをモデル呼び出しで有効化 | モデルが必要に応じてWeb・画像を検索し、引用付きで回答 |
| Deep Thinking Search | thinking有効+deepseek_web_search | 複数段階で検索・ページ読取を進めながら推論 |
| URL Reading | deepseek_read_urlを有効化 | ユーザーが送ったURLを読み、回答文脈へ追加 |
| File Input | Files APIへアップロード後、file_idを会話へ渡す | PDF・Office文書・画像などを回答文脈へ追加 |
| Model Content Safety | safety_checkを有効化 | 入力・出力をレビューし、リスク時に拒否を返す |
| Search / Fetch | 単独API | 検索結果やWeb本文をアプリ側で直接扱う |
| OCR | 単独API | 文書・画像からページ単位で文字を抽出 |
| ASR | 単独API | 音声ファイルを文字起こし |
| TTS | 単独API | テキストを音声へ変換 |
組み込み機能は、会話の中でモデル自身に検索やURL読取を使わせたい場合に向きます。単独APIは、検索結果、OCR結果、音声処理の出力をアプリ側で直接制御したい場合に使えます。
Web検索はツール実行と文脈組み立てをサーバー側で処理する
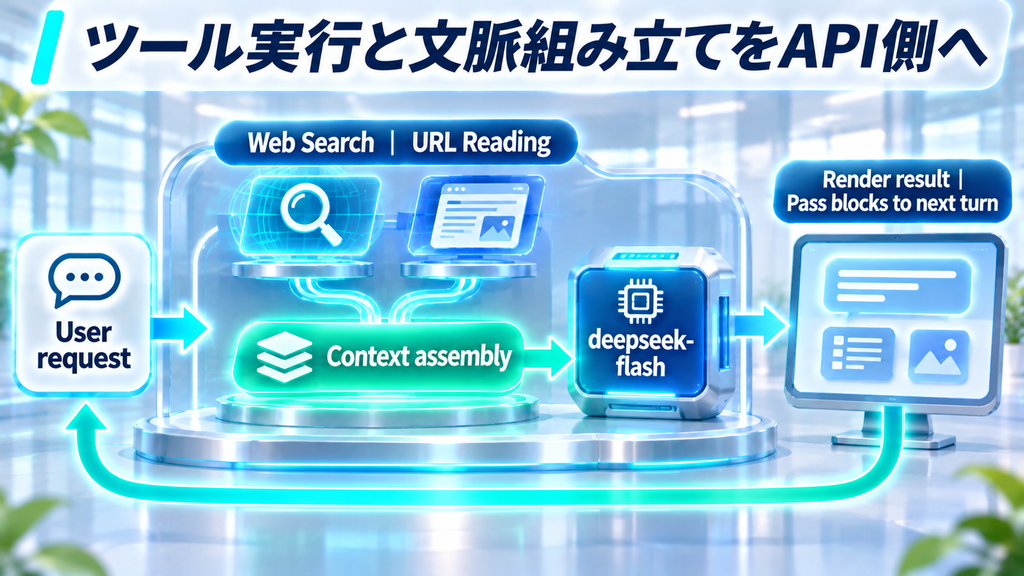
DeepSeekのWeb Toolsでは、検索やページ取得をDeepSeek側のサーバーツールが実行し、その結果をモデル向けの回答文脈へ組み立てます。
deepseek_web_searchは、thinkingの設定によって動き方が変わります。
- thinking無効:必要に応じてWeb検索や画像検索を行い、引用付きで回答する
- thinking有効:複数の推論ステップをまたいで検索し、ページを開き、本文内検索も使う
deepseek_read_url:ユーザーのメッセージ内URLを取得して回答文脈へ入れる
サービス側が検索・取得・文脈組み立てを処理し、クライアントは返されたツールブロックを表示し、次の会話ターンでそのまま戻します。
この構成では、検索ツールのオーケストレーションを自前実装から外せます。検索対象の制御、結果の見せ方、アプリ独自の検証ルールは製品側で設計します。
Web検索を独立した検索レイヤーとして持たせたい場合は、KeenableのSearch/FetchをMCPやAPIで使う構成もあります。検索機能を独立部品として扱う考え方はこちらの記事で整理しています。
ファイル入力とOCRは「モデルに読ませる」か「文字だけ取り出す」かで分ける
ファイル系には、会話へ直接つなぐFile Inputと、文字認識だけを行うOCRがあります。
File Inputでは、PDF、Word、PowerPoint、画像などをFiles APIへアップロードし、解析後に返るfile_idをdeepseek-flashの会話へ渡します。
文書解析は2種類です。
| 解析方法 | モデルへ渡る内容 | 向く文書 |
|---|---|---|
text_recognition | 文字のみ | 契約書、論文、スキャン文書など |
rich_layout_recognition | 文字+抽出された図表・画像 | グラフ付きレポート、スライド、図解マニュアル |
rich_layout_recognitionでは、検出した図表を元の位置関係に合わせてモデルへ渡します。図表も入力トークンを使うため、本文だけで足りる文書ではtext_recognitionを選ぶ方が処理範囲を絞れます。
一方、OCR APIは文書や画像をページ単位で文字認識し、結果を直接返します。OCRへ送ったファイルはFiles APIへ保存されず、チャットモデルにも自動では渡りません。
つまり、文書について質問したいならFile Input、文字抽出結果をアプリ側で使いたいならOCRという役割分担です。
音声はASRとTTSを独立APIとして組み込める
音声機能は、音声認識と音声合成を別のAPIとして呼び出します。
ASR(Speech to Text)は音声ファイルを一度に送り、完成した文字起こしを返す方式です。日本語を含む複数言語に対応しています。執筆時点ではストリーミング音声認識には対応していません。
TTS(Text to Speech)は通常のHTTPリクエストに加え、WebSocketでテキストを分割送信しながら音声フレームを受け取る方式を使えます。モデルの回答を生成途中から読み上げるようなUIにも組み込めます。
DeepSeekは、必要な音声処理をASRとTTSの単独APIとして組み合わせられる形にしています。
公開アプリでは開発者側が製品の安全設計を担う
DeepSeekは、一般公開するアプリではモデル安全チェックを有効にするよう案内しています。
safety_checkを高いレベルで有効にすると、モデルの入力と出力をレビューし、リスクを検知した場合は拒否として返します。
安全チェックは基本的なリスク制御を担い、製品側のコンテンツ安全レビューはサービス提供者が担当します。DeepSeekのドキュメントでは、適用されるモデル登録やAI生成物の表示などの義務へ対応するよう求めています。
ストリーミング応答では、回答の一部を表示した後に最終的な安全レビューで拒否になる場合があります。その場合、クライアント側で既に表示した回答を取り下げ、拒否表示へ切り替える処理も必要です。
次の部分は開発者側が担当します。
- 自社サービスで許可する用途の定義
- モデレーション方針
- 入力する顧客データ・機密情報の管理
- 拒否時のUIとエラーハンドリング
- 適用される登録・表示・法令対応
- ログ、監査、インシデント対応
料金は「モデル+ツール+メディア処理」の合計で見る
Full-Suite App APIでは、モデルのトークン料金に加えて、使ったツールやメディア処理の料金が発生します。
執筆時点で確認できる代表的な単価は次の通りです。
| 項目 | 料金 |
|---|---|
| Search | 成功1,000リクエストあたり0.75ドル |
| Fetch | 成功1,000リクエストあたり0.75ドル |
| OCR | 1,000ページあたり0.225ドル |
| ASR | 音声1時間あたり0.116ドル、期間限定価格0.058ドル |
| TTS | 1万文字あたり0.45ドル、期間限定価格0.225ドル |
Web Toolsから実行された検索・Fetchも、それぞれのツール料金として数えられます。加えて、deepseek-flashの入力・出力トークン料金が発生します。
File Inputでは文書解析時の料金と、会話で文書内容を文脈へ入れたときの入力トークン料金を分けて考えます。
そのため、アプリの原価は、モデル呼び出し単価に検索回数、取得ページ数、文書ページ数、音声時間、読み上げ文字数を加えて見積もる必要があります。
料金は変更されるため、実装時はDeepSeekのModels & Pricingと各ツールの料金ページを確認します。
アプリ設計ではDeepSeekへ任せる範囲と自社で持つ範囲を決める
今回のAPI公開で変わるのは、アプリの共通部品をどこまでDeepSeek側へ寄せられるかです。
| DeepSeek側へ任せられる処理 | 開発者側で設計する処理 |
|---|---|
| Web検索・ページ取得の実行 | どの場面で検索を許可するか |
| 検索結果とURL内容の文脈組み立て | 回答品質の評価・検証 |
| ファイルの解析 | どのファイル・データを送るか |
| 入出力の基本的な安全レビュー | 製品としてのモデレーション・法令対応 |
| OCR・ASR・TTSの処理基盤 | UI、業務ロジック、保存方針 |
| API側のツール実行 | コスト上限、ログ、監査、障害時の処理 |
共通的な検索・ファイル・音声の接続コードを減らしやすくなり、サービスとして何を許可し、どこまで結果を信用し、どのデータを渡すかは開発者が決めます。
さらに長時間エージェントのセッション管理、サンドボックス、MCP、復旧などまで実行基盤へまとめたい場合は、OpenAI Agents APIのような別の抽象化もあります。モデル周辺の実行基盤をどこまでサービス側へ任せるかはこちらの記事で整理しています。
オープンソースのchat-demoで実装境界を確認できる
DeepSeekは今回のAPIを使ったchat-demoもGitHubで公開しています。
このデモは静的なWebアプリで、検索、URL読取、ファイル添付、安全レビュー、音声入力、読み上げ、会話履歴のインポートなどを確認できます。リポジトリではデモ用途であることも明記されています。
実装を見ると、APIキーや会話履歴をブラウザ側へ持つ構成、DeepSeek APIへ直接リクエストする構成、音声をASR/TTSへ分けて送る構成を確認できます。
今回公開された機能がどのAPIへ分かれているかを確認する参考実装として使えます。
まとめ
DeepSeek Full-Suite App APIでは、deepseek-flashの会話からWeb検索、深い検索、ファイル入力、URL読取、安全チェックを利用でき、Search、Fetch、OCR、ASR、TTSは単独APIとしても使えます。
特に大きい変化は、検索やURL読取のツール実行と文脈組み立てをDeepSeek側へ任せられることです。開発者は、検索結果を毎回プロンプトへ組み直す共通処理を減らせます。
ファイルをモデルに読ませるかOCRだけ使うか、検索を組み込みにするか単独APIにするか、公開アプリの安全制御をどう設計するかは開発者側の判断です。
実務での中心は、検索・文書・音声の共通基盤をAPI側へ寄せながら、製品固有のデータ境界、安全責任、評価、コスト管理を自社側に残すことです。
公式情報・参照先
- The full DeepSeek App experience, now via API|DeepSeek
- Build a Chatbot|DeepSeek API Docs
- Web Tools|DeepSeek API Docs
- File Parsing|DeepSeek API Docs
- Model Content Safety|DeepSeek API Docs
- Models & Pricing|DeepSeek API Docs
- Search & Fetch|DeepSeek API Docs
- OCR|DeepSeek API Docs
- Speech to Text|DeepSeek API Docs
- Text to Speech|DeepSeek API Docs
- deepseek-ai/chat-demo|GitHub