当サイトではアフィリエイト広告を利用しています。
Hugging Faceは2026年11月16日、Inference Providersの言語モデル向け推論ルーティングを、自社のカスタムルーターからOpenRouterへ切り替えました。
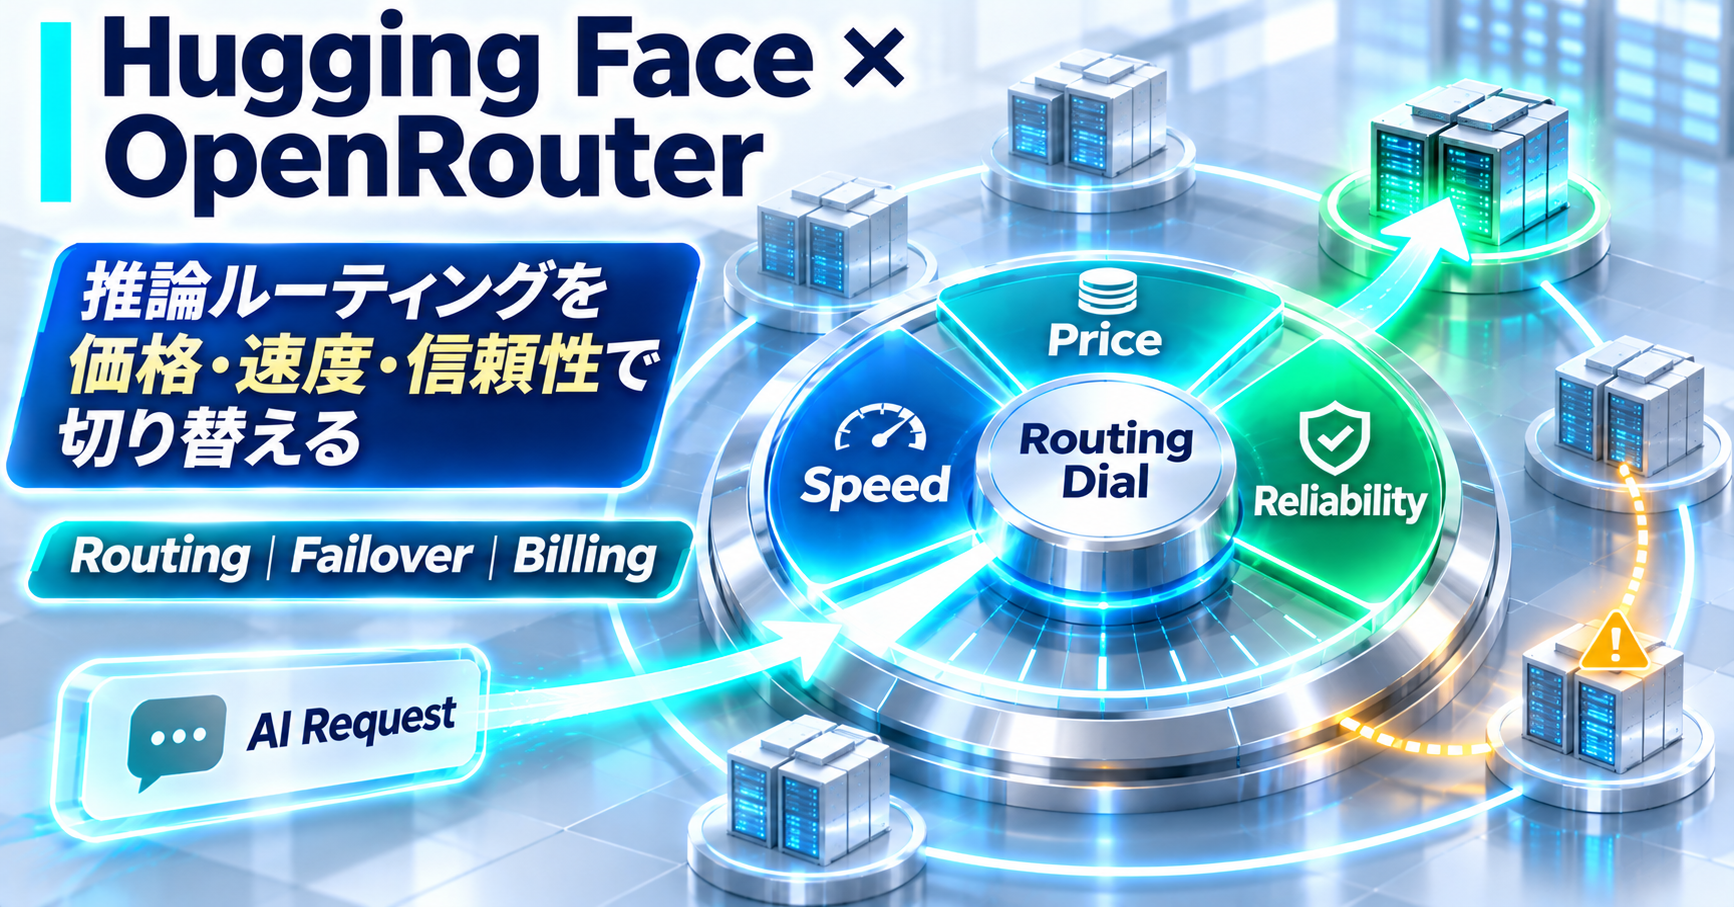
今回の変更対象は、同じモデルをどの推論プロバイダーで実行するかを決める層です。標準設定では、OpenRouterが価格・速度・信頼性の実測値を使ってプロバイダーを選び、最初の候補が失敗した場合は同じ呼び出しの中で別の候補へ再試行します。
利用者は従来のHugging Faceトークンと基本的な呼び出し方を維持できます。その一方で、言語モデルでは独自のプロバイダーAPIキーをHugging Face Inference Providersへ持ち込む方式が終了し、請求はHugging Faceアカウントまたは組織へ集約されました。
この変更を見る軸は、モデル選択、プロバイダー選択、障害時の切り替え、請求・認証の4つです。
OpenRouter移行で「同じモデルをどこで動かすか」が動的になった
Hugging Face Inference Providersは、複数の推論事業者を同じインターフェースから利用できる仕組みです。今回の移行後、言語モデルのリクエストではOpenRouterが背後のプロバイダー選択を担当します。
Hugging Faceの説明では、移行前は1回のリクエストに1つのプロバイダーを選び、そのプロバイダーが失敗するとエラーを返していました。移行後は、利用可能な複数候補から経路を選び、失敗時には次の候補へ再試行します。
| 項目 | 移行前 | OpenRouter移行後 |
|---|---|---|
| 言語モデルのルーター | Hugging Faceのカスタムルーター | OpenRouter |
| プロバイダー選択 | 1つを選択 | 価格・速度・信頼性から選択 |
| 最初の候補が失敗 | エラーを返す | 別プロバイダーへ再試行 |
| 認証 | Hugging Faceトークン | Hugging Faceトークン |
| 請求 | Hugging Face経由または独自キー | 言語モデルはHugging Faceへ集約 |
| 画像・動画・音声生成 | Hugging Face Inference Providers | 従来経路を継続 |
アプリ側ではモデル名とHugging Faceトークンを使う基本形を維持しながら、背後の推論先をルーター側で切り替えられます。OpenRouter統合はOpenAIのChat Completions/Responses APIとAnthropicのMessages APIに対応し、チャットモデルの背後にあるプロバイダーが変わっても共通の呼び出し形式を使えます。障害回避のためのプロバイダー選択ロジックを、各アプリへ個別実装する範囲も小さくなります。
プロバイダー・ルーティングとモデル・ルーティングは別の層
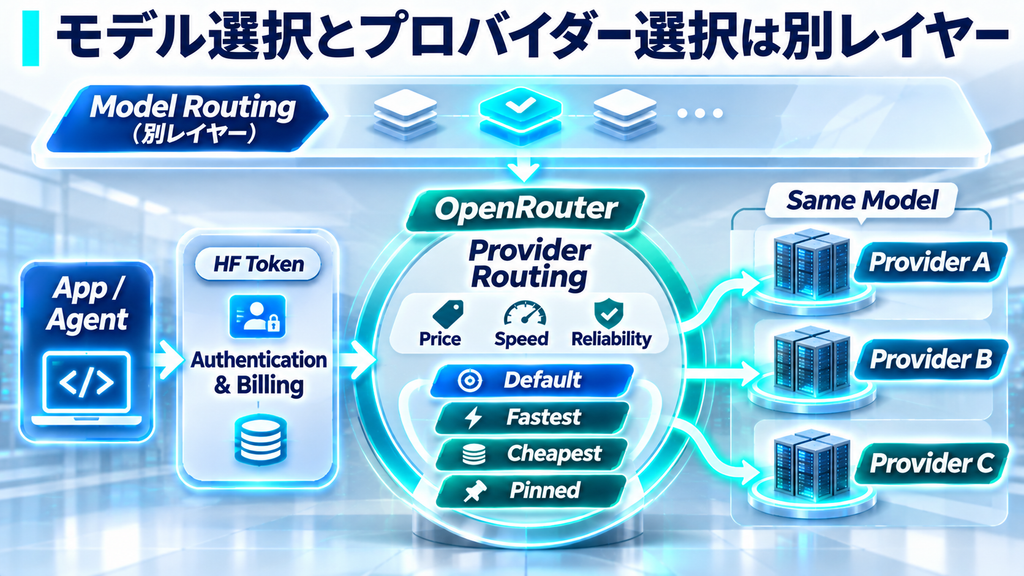
今回のOpenRouter移行で中心になるのはプロバイダー・ルーティングです。
たとえば、同じ「zai-org/GLM-5.3」を複数の推論事業者が提供している場合、標準設定ではOpenRouterがその中から実行先を選びます。Hugging FaceはモデルIDのサフィックスで方針を指定できるようにしています。
| モデルIDの例 | 実行先の決め方 |
|---|---|
zai-org/GLM-5.3 | 価格・速度・信頼性の組み合わせ |
zai-org/GLM-5.3:fastest | スループットを優先 |
zai-org/GLM-5.3:cheapest | 価格を優先 |
zai-org/GLM-5.3:novita | Novitaへ固定 |
ここではモデルはGLM-5.3のままで、どの事業者の推論基盤へ送るかを変えています。
モデル・ルーティングは、仕事の難度や用途に応じてモデル自体を切り替える設計です。Gemini 4 Hydrogen、Argon、Carbonをタスクごとに切り替える例は、こちらの記事で確認できます。
この2層を分けると、運用条件を決めやすくなります。モデル品質を変えたい場合はモデル選択、同じモデルの可用性・速度・価格を調整したい場合はプロバイダー選択を扱います。
標準ルーティングは価格・速度・信頼性を組み合わせる
OpenRouterの現在の標準ルーターは、各プロバイダーについて、実際の価格、最初のトークンが返るまでの時間、スループット、エラー率、容量不足などを継続的に測り、1回のリクエストで使う候補を決めます。
Hugging Faceのルーティング文書では、主に次の3要素が示されています。
- 実効価格:キャッシュヒット率や実際の入出力トークン構成を含む支払い額
- 速度:スループットとTime to First Token(TTFT)
- 信頼性:失敗、容量不足、壊れたツール呼び出しなどの発生状況
OpenRouterは2026年10月、新旧ルーターを3時間単位で切り替えるswitchback実験を1週間実施しました。2,400万超のリクエストと1,030億入力トークンを新旧ルーターへ均等に分けた結果として、次の値を公表しています。
| 指標 | 新ルーターの結果 |
|---|---|
| TTFT中央値 | 16.9%短縮 |
| スループット中央値 | 16.3%向上 |
| 429容量エラーに当たった割合 | 46%減少 |
| 再試行が必要だった割合 | 34%減少 |
| 1,000リクエストあたりのコスト | 6.0%増加 |
測定主体と対象はOpenRouter側の移行前実験で、代表的なオープンモデル群を使った結果です。
新ルーターは価格・速度・信頼性を組み合わせて経路を選択します。実験ではTTFTとスループットが改善し、再試行が必要だった割合も低下しました。1,000リクエストあたりのコストは6.0%増加しました。
フェイルオーバーは同じ呼び出しの中で次のプロバイダーへ進む
OpenRouter移行で実運用への影響が大きいのがフェイルオーバーです。
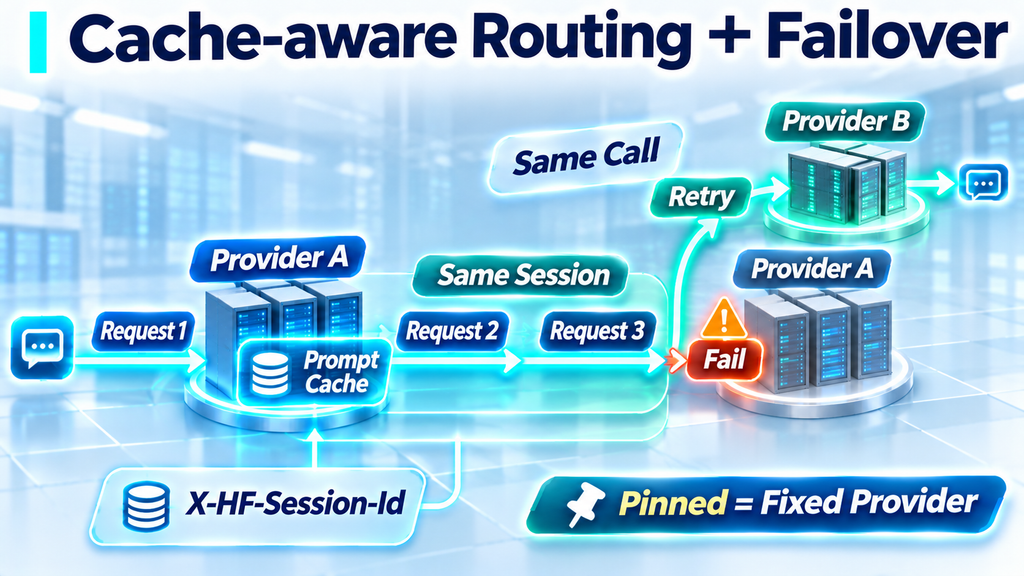
標準ルーティングでは、選ばれたプロバイダーが失敗した場合、同じモデルを提供する次の候補へ再試行します。利用者側から見ると、プロバイダー単位の429や障害を、ルーターが一段吸収する構成です。
固定指定したプロバイダーは扱いが異なります。:novitaのように特定プロバイダーへ固定した場合、その候補は別プロバイダーへ自動置換されません。固定は経路を制御できる代わりに、利用できるフェイルオーバー候補を減らします。
会話ではプロンプトキャッシュも考慮されます。最初のリクエストで選ばれたプロバイダーにキャッシュがある間は、同じ会話をそのプロバイダーへ寄せる設計です。Hugging Faceは、会話単位で安定したUUIDをX-HF-Session-Idヘッダーへ送る方法を案内しています。
言語モデルの請求はHugging Faceへ集約された
移行後の言語モデルでは、Hugging Face Inference Providersへ個別プロバイダーのAPIキーを持ち込む方式が使えなくなりました。
リクエストはHugging Faceの認証・請求経路を通り、実際に使われたプロバイダーの料金がHugging Faceアカウントまたは組織へ請求されます。Hugging Faceはプロバイダー料金へ追加のマークアップを載せないと案内しています。
この変更は、請求管理を一つに集約できる反面、独自キー運用をしていた環境では確認が必要です。
- プロバイダーとの直接契約で使っていたAPIキー
- プロバイダー側で設定していた支出上限
- プロバイダー固有の監視・請求ダッシュボード
- 組織単位で許可する推論事業者
- データ処理条件や契約条件に合わせた経路固定
Hugging Face側では、利用明細を実際に使ったプロバイダー別に確認できます。組織のInference Providers設定で特定プロバイダーを無効にすると、その組織へ請求されるリクエストでは対象プロバイダーへ送られません。
可用性を優先するか、価格や実行先を固定するかで設定を分ける
OpenRouter移行後は、目的ごとにルーティング方針を選べます。
| 運用目的 | 設定の考え方 | 主に確認する指標 |
|---|---|---|
| 可用性を優先 | 標準ルーティング | エラー率、再試行、完了時間 |
| 応答速度を優先 | :fastest | TTFT、スループット |
| コストを優先 | :cheapest | 入出力単価、総額 |
| 契約・データ条件で固定 | :provider | 対象事業者の条件、可用性 |
| 特定事業者を除外 | HF設定で無効化 | 候補数、代替経路 |
標準ルーティングでは候補数を広く取れるため、単一プロバイダー障害への耐性を持たせやすくなります。特定プロバイダーへ固定すると、実行先を明確にできる一方、ルーターが使える代替経路は減ります。
本番運用では、契約・データ処理条件などに基づいて利用可能なプロバイダー集合を先に決め、その範囲内で価格・速度・信頼性を最適化する構成が管理しやすくなります。
画像・動画・音声生成は従来のInference Providers経路を継続
今回の移行対象は言語モデルです。
Hugging Faceは、画像・動画・音声生成について従来のInference Providers経路を継続すると説明しています。画像・動画プロバイダーの独自APIキーも引き続き利用できます。
OpenAI互換のrouter.huggingface.co/v1で案内されているルーティングはチャット系ワークロードが中心です。画像生成、埋め込み、音声など他のタスクでは、Hugging FaceのInference Clientと各タスクの対応プロバイダーを確認します。
この境界を押さえると、既存システムの変更対象を切り分けられます。言語モデルでは認証・請求・経路設定を確認し、画像・動画・音声は従来経路として分けて管理します。
移行後に確認する5項目
既存のHugging Face Inference Providers利用環境では、次の5点を確認すると影響範囲を把握できます。
- 言語モデルで独自プロバイダーAPIキーを使っていたか
- 特定プロバイダーへ固定する契約・データ条件があるか
- 自動フェイルオーバーを使うか、固定経路を優先するか
- 会話単位のキャッシュを使うためにセッションIDを維持できるか
- プロバイダー別の利用額・速度・エラー率を運用指標として追うか
Hugging FaceのモデルページにはProvidersとMetricsの表示が追加され、プロバイダーごとの価格、速度、直近24時間の稼働率や、モデル単位の主要指標を確認できます。
ルーターへ経路選択を集約しても、どのプロバイダーを許可するか、コストと速度をどこで折り合せるかは利用側の設計として残ります。
まとめ
Hugging Face Inference ProvidersのOpenRouter移行で、言語モデルの推論先は価格・速度・信頼性を基に動的に選び、失敗時に別プロバイダーへ再試行する構成へ変わりました。
モデルIDに:fastest、:cheapest、特定プロバイダー名を付ければ、速度・価格・実行先を明示的に選べます。組織設定では使わないプロバイダーを除外できます。
運用上の大きな変更は、言語モデルの独自プロバイダーAPIキーが使えなくなり、請求がHugging Faceへ集約されたことです。画像・動画・音声生成は従来のInference Providers経路を継続します。
マルチプロバイダー推論では、モデル選択とプロバイダー選択を分け、許可する実行先、フェイルオーバー、速度、コスト、請求をルーティング層の設定として管理する形が具体化しています。
公式情報・参照先
- Hugging Face and OpenRouter join forces to make open-weight models easy to run|Hugging Face
- Routing and Providers|Hugging Face
- Inference Providers|Hugging Face
- Providers|Hugging Face
- Hub API|Hugging Face
- OpenRouter Now Powers Inference on Hugging Face|OpenRouter
- How we rebuilt provider routing for better, faster inference|OpenRouter