当サイトではアフィリエイト広告を利用しています。
Google Researchは2026年11月13日、Antigravityのマルチエージェント機能「/teamwork」を使った研究・システム開発の成果を公開しました。数学、化学、システムソフトウェア、機械学習エンジニアリングまで対象は広く、人間の研究者・専門家とGemini 4系モデル、複数のAIエージェントを組み合わせています。
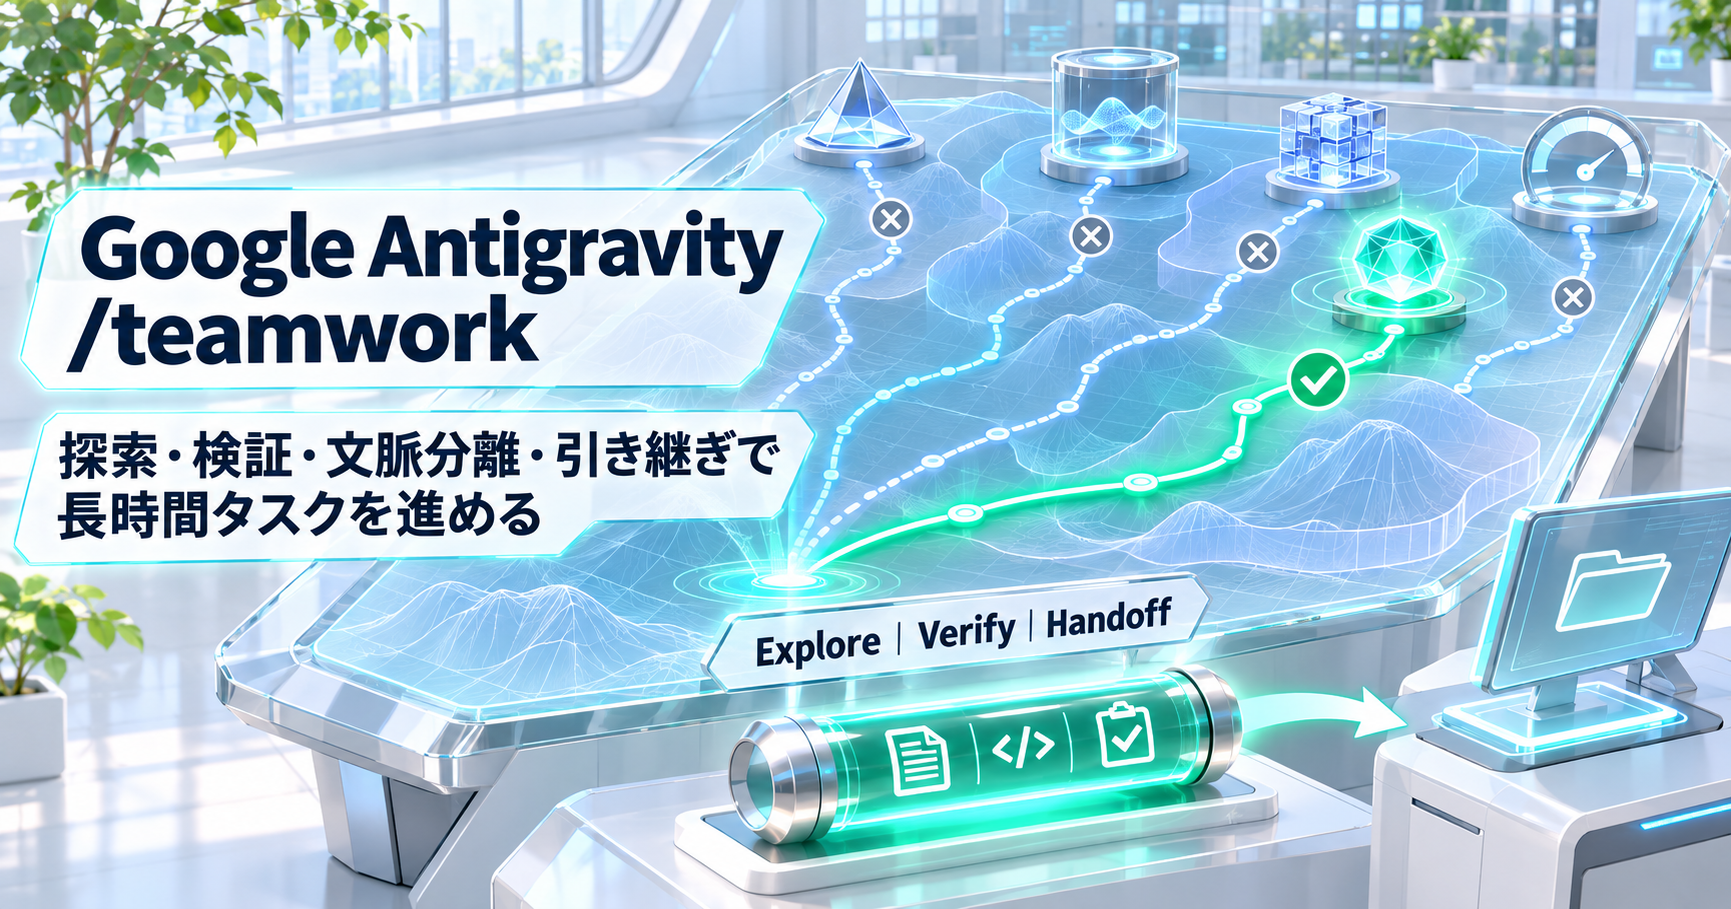
/teamworkの設計で中心になるのは、探索を並列化し、候補を独立した検証器へ通し、長時間タスクでは文脈を分けて新しい担当へ引き継ぐことです。長い仕事を一つの会話へ蓄積する構成から、役割・検証・成果物の受け渡しを明示する構成へ変わっています。
Googleが公開した研究成果と現在のAntigravityドキュメントから、/teamworkの長時間タスク設計は、並列探索、独立検証、文脈分離、成果物の引き継ぎという4つの要素で捉えられます。仕事の分解や担当割り当ては、この4要素を動かすための実装上の仕組みです。
/teamworkは長時間・複数マイルストーンの仕事向けに設計されている
現在のAntigravityドキュメントでは、/teamworkは大規模なソフトウェア開発、複雑なシミュレーション、深い研究など、複数のマイルストーンをまたいで数時間から数日続く仕事向けの機能として説明されています。
利用時は、最初にスコープ、目的、要件、独立した検証方法、完了条件、作業ディレクトリを確認するスコーピング工程があります。利用者が承認すると、SentinelとProject Orchestratorが中心となってマイルストーンへ分解し、必要な担当へ仕事を渡します。
Antigravityには複数のマルチエージェント実行方法があります。現在のドキュメント上の主な使い分けは次の通りです。
| 実行方法 | 向く仕事 | 典型的な時間軸 |
|---|---|---|
| Subagents | 調査、テスト、ブラウザ確認などの独立した小さな副作業 | 秒〜分 |
| /boost | 難しいバグ、アルゴリズム最適化、密結合の修正 | 秒〜時間 |
| /swarm | ファイルや調査軸を独立して分けやすい広い仕事 | 分〜時間 |
| /teamwork | 複数マイルストーンの開発、シミュレーション、形式証明、深い研究 | 時間〜日 |
/teamworkは、マイルストーンごとに担当と検証を置き、長い仕事を成果物ベースでつなぎます。
並列探索と専用の検証器をセットにする
Google Researchは、長時間の研究やシステム開発で一つの候補だけを追うと、初期の仮説や実装ミスが後工程へ残りやすい点を問題として挙げています。
/teamworkでは複数の候補を並列に探索し、その候補を専用の「falsifier(反証・検証役)」へ渡します。検証方法は対象によって変わります。
- 数学・形式証明:Lean 4の証明チェッカー
- ソフトウェア:変更していない既存テストスイート
- システム開発:実行シミュレーター
- 情報確認:Web検索
- ハードウェア・性能最適化:ハードウェアカウンターや実機ベンチマーク
候補の採否は、生成担当の外側に置いた検証器で判定します。何を正解とするかを外側へ置くことで、探索を増やしても採用条件を固定できます。
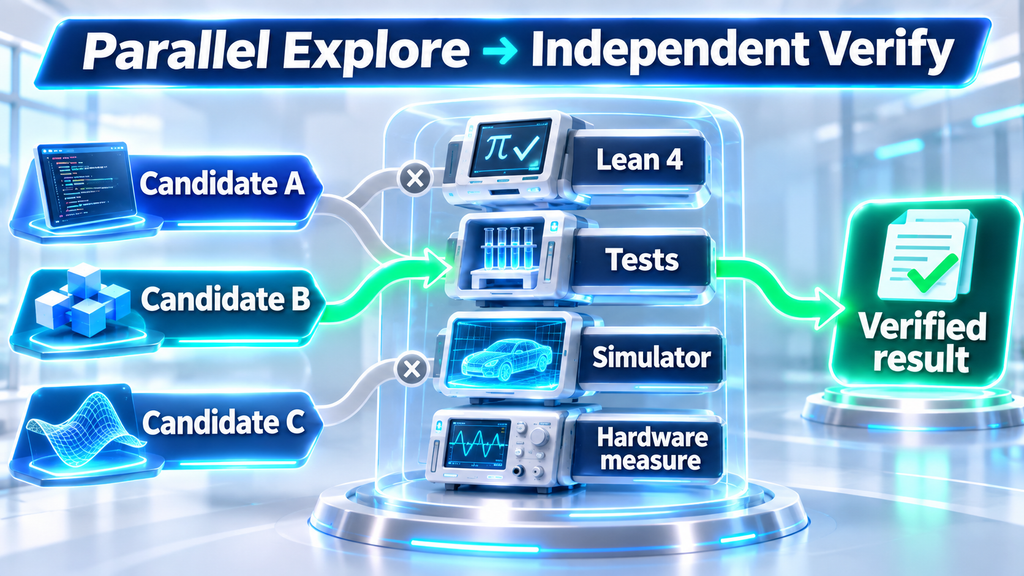
数学では「証明が通るか」、ソフトウェアでは「既存テストを壊していないか」、性能改善では「実測で速いか」というように、仕事ごとに検証器を変えます。候補の採否に使う検証器と合否条件が成果の信頼性を左右します。
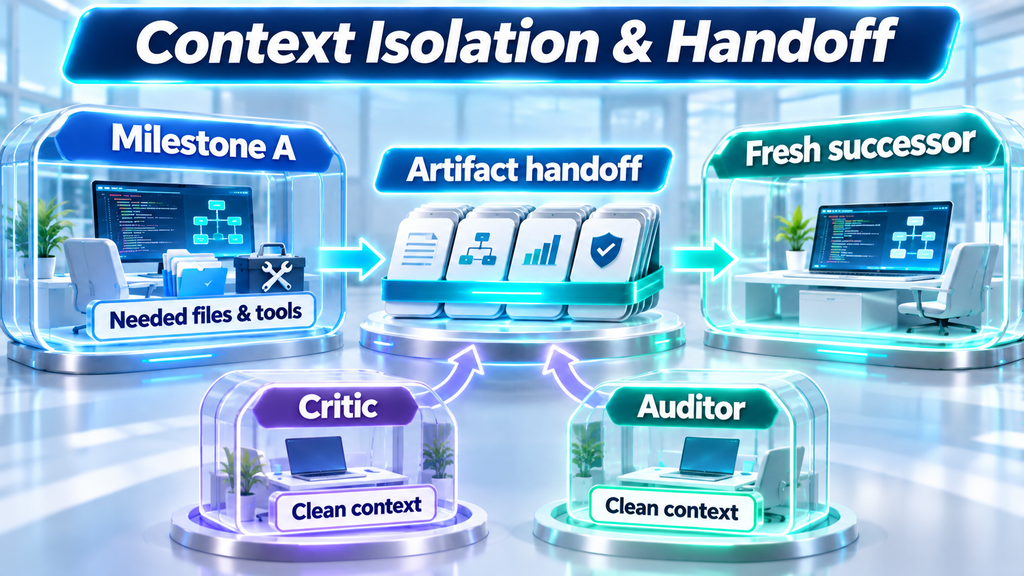
文脈を分離し、成果物で次の担当へ引き継ぐ
Google Researchが挙げるもう一つの課題は、数日続く仕事で会話履歴が増え続けると、必要な情報へ注意を向けにくくなることです。
/teamworkでは、専門エージェントごとに必要なファイルとツールを限定します。Project Orchestratorはマイルストーン間で新しい後継担当へ仕事を渡し、必要な成果物と検証結果を引き継ぎます。
現在のAntigravityドキュメントでは、次の成果物を使って状態をつなぎます。
- Request artifact:目的、制約、受け入れ条件
- Project plan artifact:マイルストーン、依存関係、進行中の作業
- Progress artifact:完了した作業と現在の進捗
- 検証ログ:実行コマンド、レビューコメント、テスト結果
この方式では、長時間タスクの状態をレビュー可能な作業記録として残し、後継エージェントが必要な成果物と検証結果を受け取ります。
Kiro Crew Botsでも、長時間稼働する担当と複数Worker、継続メモリ、作業記録を分ける設計が使われています。長時間エージェントで「担当」「並列作業」「記録」をどう持たせるかを比較したい場合は、こちらの記事で確認できます。
Critic・Challenger・Auditorを生成担当から分ける
/teamworkの現在のドキュメントでは、実装担当と検証担当が明確に分かれています。
| 役割 | 主な仕事 |
|---|---|
| Sentinel | 承認済みの依頼を記録し、全体の進行と最終確認を管理 |
| Project Orchestrator | マイルストーン分解、並列作業の調整、担当割り当て、後継への引き継ぎ |
| Explorers | 読み取り専用で調査し、候補を評価 |
| Workers | 実装、リファクタリング、テスト作成 |
| Critic | 正しさ、論理、インターフェース、コード品質を独立レビュー |
| Challenger | エッジケース、失敗経路、最悪入力などで積極的に壊しにいく |
| Auditor | 実行ログとテスト証拠を確認し、検証が実際に行われたかを監査 |
| Success Auditor | 最終成果をエンドツーエンドで確認 |
生成担当とレビュー担当を分けると、同じ前提を共有したまま全員が同じ誤りへ進むリスクを下げられます。Google Researchも、批評役や監査役を元の生成過程から切り離した「clean context」で動かす設計を説明しています。
検証条件、担当、実行証拠、完了条件を先に決め、マイルストーンごとに通過条件を置くことが、このレビュー構造の特徴です。
Teamworkは仕事に合わせてパターンと人数を変える
AntigravityのTeamworkでは、仕事に応じて「pattern」を選び、必要な役割と人数を実行中に調整します。
2026年8月のAntigravityブログでは、主なパターンとして次が紹介されていました。
- Iterative coding:密結合した問題を実装・テスト・修正の反復で進める
- Distributed coding:分割可能な開発を複数担当へ広げ、Criticが確認する
- Long Proof:多数の証明戦略を競わせ、反証役と検証を通して絞り込む
- Self-verification:数学的推論を深く進め、各段階で自己検証する
- Document review:論文や技術文書を複数視点でレビューする
現在のドキュメントでは、General、Iterative coding、Document Review、Math / Proofなどの実行経路が案内されています。2026年8月のブログではLong Proofがパターンとして紹介され、現在はMath / Proofが実行経路として案内されています。両者の名称上の関係は公開情報から確認できていません。
パターンはエージェントの説明とオーケストレーションを分離した仕様として扱われ、必要な人数も実行中に変化します。複雑な仕事では、問題の形に合わせて探索幅と検証深度を調整します。
Courtade–Kumar予想では人・Gemini・Leanが役割を分けた
11月13日の発表で象徴的なのが、2013年から未解決だった情報理論のCourtade–Kumar予想です。
Google、香港中文大学、南カリフォルニア大学、カーネギーメロン大学の研究者は、研究事例で/teamworkのLong Proofパターンを使い、一般形の証明へ到達したと報告しています。ここでいうLong Proofは、2026年8月のブログで紹介された名称です。
研究工程では役割が分かれていました。
- Geminiが、香港中文大学チームの既存研究を一般化した予想に反例を見つける
- 人間の研究チームが、新しい候補関数と14変数の最適化問題への還元、重要な解析的下限を提示する
- Gemini 4 Argonなどが、パラメータ空間を分割して解析的な境界と区間演算による証明書を構築する
- 研究チームが証明全体をLean 4で形式化する
Googleによると、最終的なLean 4形式化は約5,000万行のコードになりました。
この事例は、人が問題設定と数学的な鍵を提示し、AIが大規模探索を進め、形式検証で証明の論理を確認する共同研究です。
Leanが確認する範囲と、人が元の問題との対応や研究上の意味を確認する範囲については、PSIのAaronson–Ambainis予想の記事で詳しく整理しています。
ソフトウェアではテストと実測が「検証器」になる
ソフトウェアやシステム開発でも/teamworkが使われ、検証器はテストスイート、実機、プロファイラ、ハードウェアカウンターへ置き換わります。
Google Researchは、ZirconマイクロカーネルのC++からRustへの移植で、依存関係がコンパイルできた段階だけ次へ進め、各モジュールを元の変更していないテストスイートへ接続するrewrite patternを使ったと説明しています。libgav1のRust移植でも、広い適合性テストでビット単位の一致を確認し、プロファイラを使って性能改善を反復しました。
TPUカーネル最適化では、実機評価に7〜32分かかるため、4つの並列エージェントが約23秒で動く代理評価器を作り、定期的な実機評価との順位相関を確認しながら探索しています。
分野が変わっても構造は共通です。
候補を作る → 独立した評価で落とす → 通過した結果だけを次へ渡す
研究エージェントで、目標・計算予算・評価条件を人が先に固定し、AIが仮説・実装・実験を反復する別の設計はSalesforce SFR-AutoR&Dの記事で確認できます。
外部利用できる/teamworkと研究用パターンの範囲を分けて見る
2026年11月15日時点のAntigravityドキュメントでは、/teamworkはAntigravity AppとCLIの有料プランで利用できる機能として案内されています。
Google Researchは11月13日の発表で、外部の科学者・開発者がGemini 4モデルと/teamwork、/boost、Deep ReviewをAntigravityから利用できると説明しました。学術研究者1万人へ、最上位利用枠を6か月無料で提供する応募プログラムも案内しています。このプログラムは応募制で、参加は適格性、受け入れ容量、選考の条件があります。
現在の外部提供範囲には/teamwork、/boost、Deep Reviewが含まれます。Google Researchは、formal proof patternと追加の専門ワークフローを今後Antigravityへ追加するとしています。Long Proofは研究事例で使われた名称、Math / Proofは現在案内されている実行経路、formal proof patternは今後追加予定のパターンです。3者の相互関係は公開情報から確認できていません。
8月のブログではコマンド名が「/teamwork-preview」と記載されていましたが、現在のドキュメントでは「/teamwork」として案内されています。古い記事や画面を参照するときは、この名称差を意識すると現在の手順と対応づけられます。
長時間マルチエージェントを設計するときの7つの確認点
/teamworkの設計を一般的な長時間エージェント運用へ置き換えると、最初に決める項目は7つあります。
- 目的と完了条件:何を達成したら終了か
- 分割単位:並列に進められる仕事と依存する仕事をどう分けるか
- 検証器:各マイルストーンを何で合否判定するか
- 担当ごとの情報範囲:必要なファイル・ツール・データをどこまで渡すか
- 引き継ぎ成果物:次の担当へ何を残すか
- 独立レビュー:生成担当と別の文脈で誰が壊しにいくか
- 最終監査:全体が要求を満たしたことを何で確認するか
長時間タスクでは、仕事の境界、検証条件、引き継ぐ成果物が主要な管理対象です。
探索を広げるほど候補は増えます。各段階に独立した検証器を置き、成果物で状態を引き継ぐことで、探索量を増やしながら採用基準を維持できます。
まとめ
Google Antigravityの/teamworkは、複数のAIエージェントを使って長時間の研究・開発を進めるためのオーケストレーション機能です。
設計の核は、並列探索、専用の検証器、担当ごとの文脈分離、成果物による引き継ぎという4要素です。Critic・Challenger・Auditorは、このうち独立検証を実装する役割として配置されます。数学ではLean 4、ソフトウェアでは既存テストや実機ベンチマークのように、仕事に合う検証器を外側へ置きます。
Courtade–Kumar予想の共同研究では、人間の研究者が問題設定と重要な数学的構成を担い、Geminiが大規模探索と解析を進め、研究チームが証明全体をLean 4で形式化しました。
長時間マルチエージェントを実務へ使うときは、目的、分割単位、検証器、情報範囲、引き継ぎ成果物、独立レビュー、最終監査を先に決めると、/teamworkが示す設計を別の業務にも応用できます。