当サイトではアフィリエイト広告を利用しています。
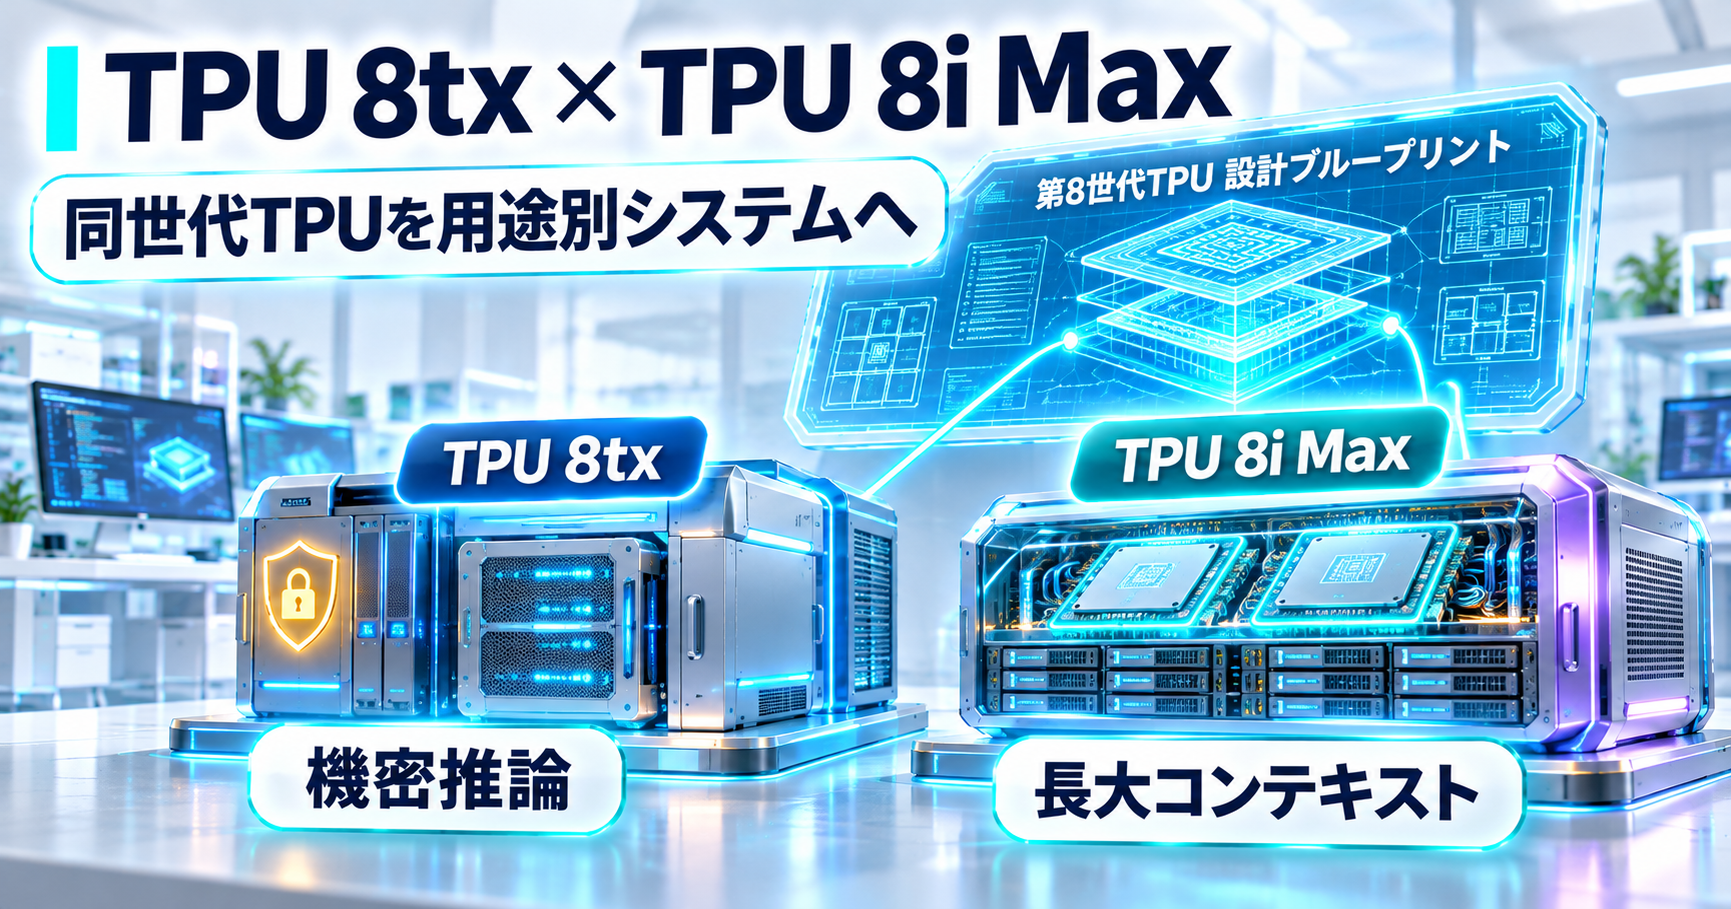
Googleは2026年11月9日(米国時間)、第8世代TPUへ「TPU 8tx」と「TPU 8i Max」を追加しました。
今回追加された2つは、同じ世代のTPUを用途に合わせて組み替えた新しいシステム構成です。TPU 8txはTPU 8tと同じシリコンを使いながら、CPUホスト、ネットワーク、ハードウェアレベルの機密計算を組み合わせます。TPU 8i Maxは、低遅延推論向けのTPU 8iを2基まとめて1パッケージにし、計算性能、SRAM、HBM帯域をそれぞれTPU 8iの2倍にしています。
この発表を見ると、AIアクセラレータの設計対象がチップ単体から、ホストCPU、ネットワーク、メモリ、パッケージ、セキュリティまで含むシステム全体へ広がっていることが分かります。
TPU 8txと8i Maxで第8世代は4つのシステムになった
Googleの第8世代TPUは、4つのシステムで用途を分担します。
| システム | 主な用途 | 設計上の重点 |
|---|---|---|
| TPU 8t | 大規模な事前学習 | 大規模スケールと高い学習効率 |
| TPU 8i | 低遅延の推論・Reasoning | メモリ供給と低遅延ネットワーク |
| TPU 8tx | 機密推論・小規模学習 | 処理中データの保護と低遅延 |
| TPU 8i Max | 長大コンテキスト・高密度推論 | 計算・SRAM・HBM帯域とラック密度 |
第8世代TPUは、学習、低遅延推論、機密計算、長大コンテキストというボトルネックごとにシステムを分ける設計になっています。
GoogleはAI Hypercomputerを、シリコン、パッケージ、メモリ、ネットワーク、ホストCPU、セキュリティを組み合わせるモジュール型システムとして説明しています。用途ごとにシステム全体を調整します。
Googleは「チップの周囲」を組み替えて用途へ合わせる
新しい半導体を設計して量産するには長い開発期間が必要です。GoogleはTPUをモジュール型の部品として設計し、チップの周囲にある構成を変更することで、より短い期間で新しい要件へ対応する考え方を示しています。
システム側で変更できる主な要素は次の通りです。
- チップのパッケージ方法
- ホストCPU
- 高速ネットワーク
- HBMやSRAMを含むメモリ構成
- ストレージとの接続
- ハードウェアレベルのセキュリティ
- ラック内の搭載密度
TPU 8txとTPU 8i Maxは、この設計思想を分かりやすく示す2つの例です。
TPU 8txはTPU 8tのシリコンを使いながら、機密データを扱う推論へ必要なホストとセキュリティ、低遅延ネットワークを組み合わせます。TPU 8i MaxはTPU 8iを2基まとめ、長大コンテキストで必要になる計算量とメモリ供給能力を同時に増やします。
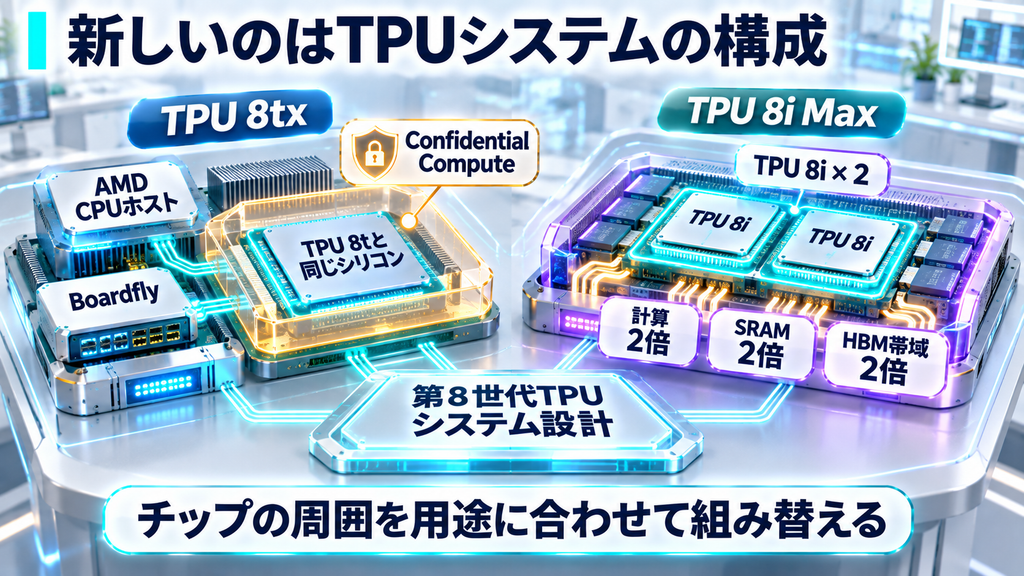
この構成では、既存世代のシリコンを使いながら周辺システムを変え、AIインフラを用途へ合わせて更新できます。
TPU 8txはTPU 8tのシリコンへ機密計算と低遅延ネットワークを組み合わせる
TPU 8txは、安全で機密性の高い推論を主用途とするシステムです。Googleは規制産業や政府機関、機密データと独自モデルを扱う企業を想定しています。
TPU 8txの中心構成は次の通りです。
| 構成 | TPU 8txでの役割 |
|---|---|
| TPUシリコン | TPU 8tと同じシリコン |
| CPUホスト | AMDの第5世代EPYC CPUホスト |
| ネットワーク | 低遅延のBoardflyネットワーク |
| セキュリティ | ハードウェアレベルのConfidential Compute |
| 主な処理 | 機密推論、プライベートな追加学習、小規模トレーニング |
通常の暗号化では、保存時と通信時のデータを保護できます。機密推論では、処理中のデータやモデルの重みをメモリ上でも保護することが重要になります。
TPU 8txは、この処理中データの保護をハードウェアレイヤーへ組み込みます。Googleは、TPU 8tと比べてレイテンシを最大2倍低減しつつ、性能低下をほぼゼロに抑えると説明しています。
さらに、学習向けの計算性能と低遅延ネットワークを同じシステムへ組み合わせることで、機密データを別クラスターへ移さずに次の処理を行える構成です。
- プライベートデータを使ったファインチューニング
- 大規模モデルから小規模モデルへの蒸留
- 強化学習によるエージェント調整
- 機密データを使う推論
TPU 8i Maxは2基のTPU 8iを1パッケージにまとめてメモリ供給を増やす
TPU 8i Maxが対象にするのは、長大コンテキストで起きるメモリ帯域のボトルネックです。
多数のAIエージェントが大きなコードベース全体を読み続けたり、長時間の動画を同時に扱ったりすると、演算器へ必要なデータを供給する速度が処理性能を左右します。
GoogleはTPU 8i Maxで、2基のTPU 8iを1つのパッケージへまとめました。TPU 8iと比べて次の3項目をそれぞれ2倍にしています。
- 計算性能
- SRAM
- HBM帯域
TPU 8iはもともと低遅延推論とReasoning向けに、メモリ供給とチップ間通信を重視したシステムです。8i Maxはその設計を2チップ構成へ拡張し、大規模なコンテキストを扱うときの計算とメモリ供給を同時に増やします。
同じラック占有面積に2倍のシリコンを搭載するため、Googleはラックあたりの計算密度も高められると説明しています。
8txと8i Maxは同じ「高性能化」でも解く問題が違う
2つの新システムを比べると、強化対象がはっきり分かれています。
| 要件 | TPU 8tx | TPU 8i Max |
|---|---|---|
| 主な課題 | 機密データを使う推論 | 長大コンテキストのメモリ供給 |
| 基盤 | TPU 8tと同じシリコン | TPU 8iを2基 |
| 主な追加要素 | AMD CPUホスト、Confidential Compute、Boardfly | 2チップパッケージ、高いSRAM・HBM帯域 |
| 重視する指標 | データ保護、レイテンシ | 計算密度、メモリ帯域 |
| 想定用途 | 規制産業、政府、独自モデル、機密エージェント | 大規模コード、長時間動画、巨大コンテキスト |
AI基盤の設計では、ピーク演算性能と、実際のワークロードで何が詰まるかを合わせて確認します。
機密データを扱うならセキュリティ境界、長大コンテキストならメモリ帯域、リアルタイム推論なら通信遅延、大規模学習ならスケール効率が重要になります。
第8世代TPUはワークロードのボトルネックで選ぶ
Googleは第8世代の4システムを、AIライフサイクルの異なる段階へ割り当てています。
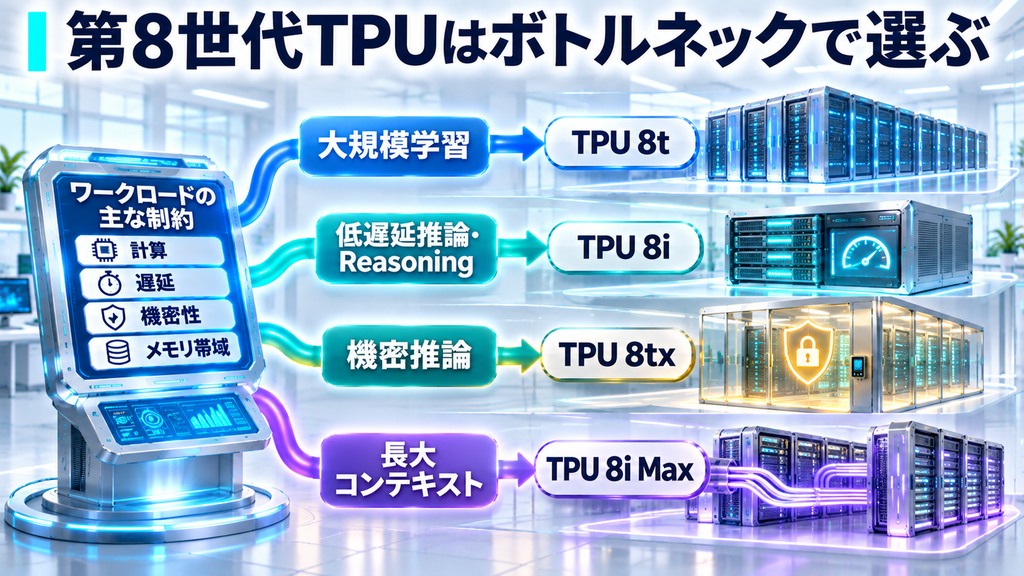
選び方を実務向けに整理すると、次のようになります。
大規模な事前学習
大規模モデルを大量のチップで学習する場合はTPU 8tが中心です。スケールアップ時の計算効率と、大規模Superpodでの運用を重視します。
低遅延推論・Reasoning
対話型エージェントや推論処理で応答遅延を抑えたい場合はTPU 8iが中心です。Boardflyネットワークや大きなオンチップSRAMで、ReasoningやMoEの推論を支えます。
機密推論・プライベート調整
処理中の機密データやモデルの重みまで保護したい場合はTPU 8txが候補になります。規制環境や独自モデルを扱う企業では、計算性能と同時にデータ保護の仕組みを評価します。
長大コンテキスト・高密度推論
コードベース全体、長時間動画、巨大なKVキャッシュなどを扱う場合はTPU 8i Maxが候補になります。メモリ帯域とラック密度が設計の中心です。
処理工程ごとに異なるアクセラレータを割り当てる設計は、NVIDIA GPUとRebellions NPUでPrefill/Decodeを分担する韓国ソブリンAI基盤の記事でも扱っています。異種アクセラレータを組み合わせる場合の考え方はこちらで確認できます。
システム選定では5つの要件を確認する
TPU 8txと8i Maxの発表から、AIインフラ選定では次の5項目を分けて確認できます。
1. ワークロードの主なボトルネック
学習時の計算量、推論時のレイテンシ、メモリ帯域、データ保護のどれが制約になるかを確認します。
2. データの機密性
処理中データやモデルの重みまで保護する必要がある場合は、Confidential Computeのようなハードウェアレベルの保護が選定条件になります。
3. コンテキストとメモリ量
長大コンテキストや巨大なKVキャッシュでは、HBM容量と帯域、SRAM、ホスト側メモリまで含めたデータ供給経路を確認します。
4. ネットワークと通信遅延
エージェント型の処理や分散推論では、チップ単体の性能に加えて、チップ間・ホスト間通信の遅延が応答時間へ影響します。
5. ラック密度と運用効率
データセンターでは、同じ床面積にどれだけ計算資源を置けるか、電力・冷却を含めて運用できるかも重要です。
これらを先に整理すると、自分のワークロードで詰まる場所に合うシステムを選ぶ設計へ進めます。
まとめ
TPU 8txとTPU 8i Maxは、第8世代TPUの用途別システム構成です。
TPU 8txはTPU 8tと同じシリコンへ、AMD CPUホスト、Boardflyネットワーク、Confidential Computeを組み合わせ、機密推論とプライベートなモデル調整へ対応します。
TPU 8i Maxは2基のTPU 8iを1パッケージにまとめ、計算性能、SRAM、HBM帯域をそれぞれ2倍にして、長大コンテキストと高密度推論へ対応します。
第8世代TPU全体を見ると、Googleは学習、低遅延推論、機密計算、長大コンテキストというボトルネックごとにシステムを分ける設計を採用しています。AIインフラを選ぶときは、チップ世代やピーク性能に加えて、ホスト、ネットワーク、メモリ、セキュリティ、ラック構成まで含めて評価する必要があります。