当サイトではアフィリエイト広告を利用しています。
Anthropicは2026年11月6日、Engineering記事「The components of agent memory」を公開し、Claudeのエージェント記憶をどのように構成し、維持するかを複数の評価結果とともに説明しました。
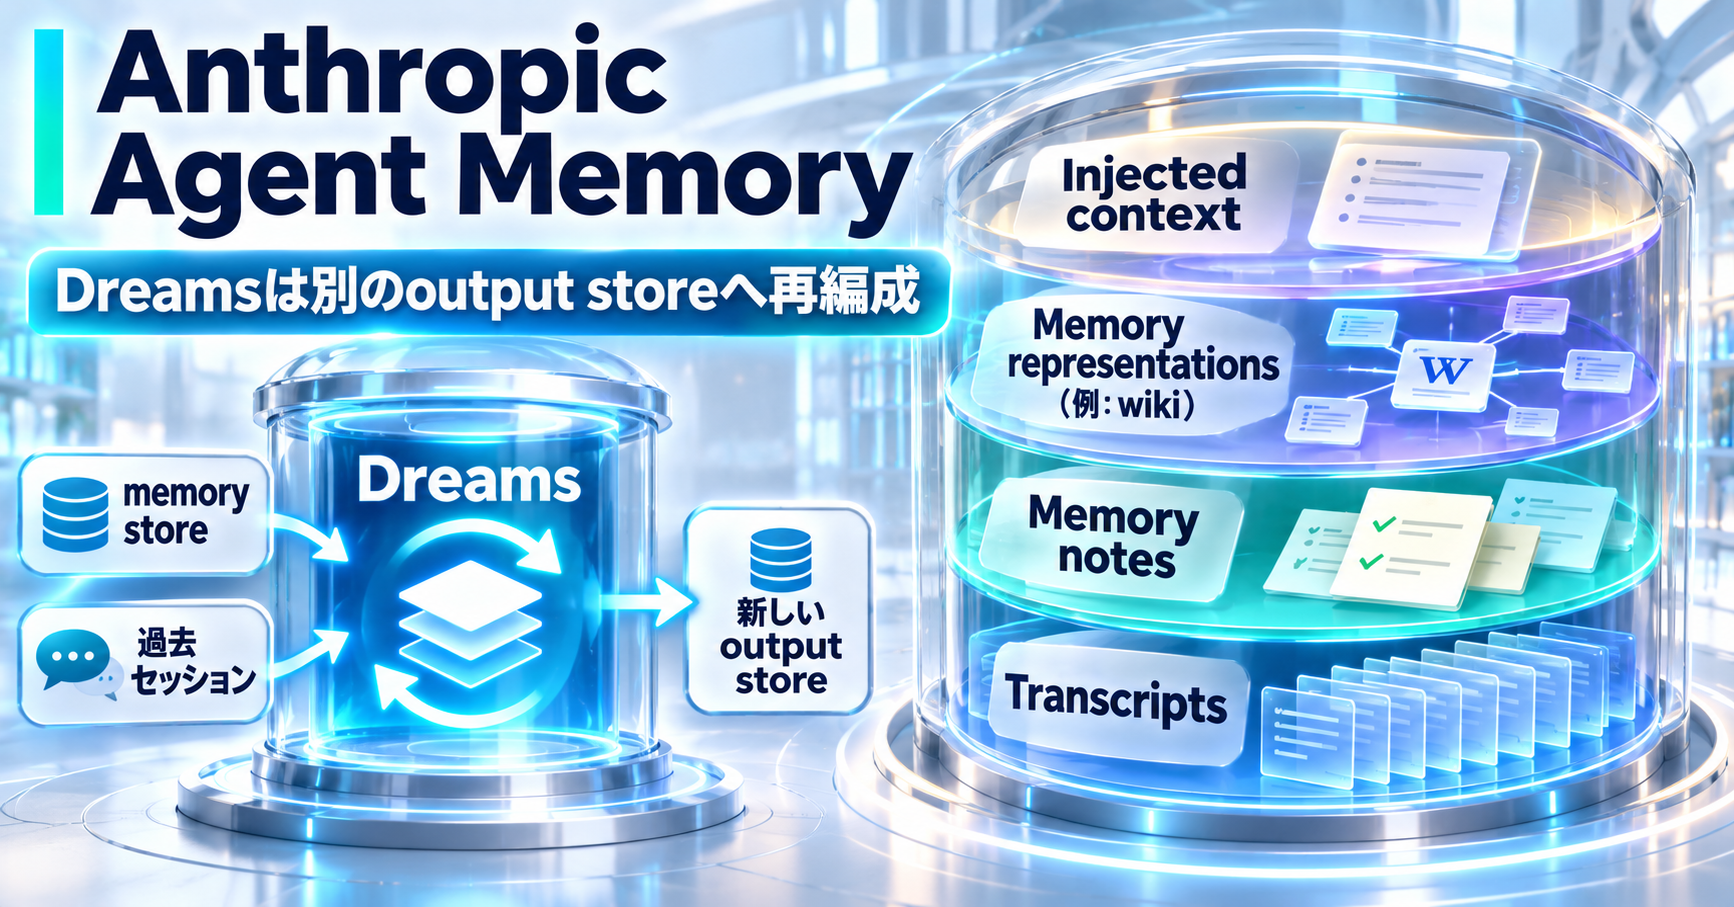
ここでいうAgent Memoryは、Claudeが利用者とのやり取りや担当タスクから得た知識を、次のセッションでも読み返せる外部文脈として保持する仕組みです。Anthropicは、検索可能なログ、Claudeが書くメモ、wikiのような知識表現、セッション開始時に読み込む重要文脈を階層として扱っています。
Anthropicは、保存した記憶を後から見直し、誤りの修正や重複の統合、新しい表現への再構成を行う考え方を「dreaming」として説明しています。現在のClaude Managed AgentsのDreamsは、その考え方をmemory storeと過去セッションを入力にする非同期処理として実装し、新しいoutput storeを生成します。
長期エージェントの記憶設計では、何を残すか、どの層へ置くか、いつ検索するか、いつ再編成するかが性能とコストの両方に効いてきます。
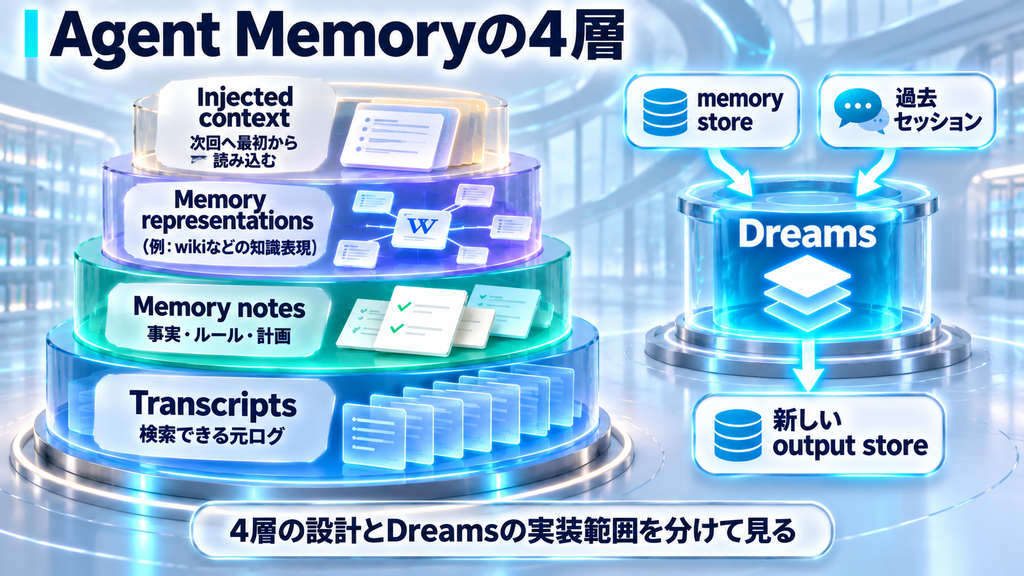
AnthropicのAgent Memoryは4つの層で構成される
Anthropicが説明するエージェント記憶は、役割の異なる情報を複数の層へ分けています。
| 層 | 主な役割 | 使われ方 |
|---|---|---|
| Transcripts | 過去セッションの記録 | 元の出来事や発言を検索する |
| Memory notes | 重要だと判断した事実・ルール・計画 | 次回以降へ持ち越す |
| Memory representations | wikiなど、複数の記憶を結ぶ表現 | 関係をたどり、広い知識を探索する |
| Injected context | 毎回のセッション開始時に読み込む重要情報 | 検索前から必要な前提を渡す |
AnthropicはAgent Memoryを、Claudeが経験から得てセッションをまたいで保持し、後から読めるコンテキストとして定義しています。モデルの重み更新、1つの会話内で知識を使うin-context learning、古い会話を要約してコンテキスト窓を空けるcompactionは、それぞれ別の仕組みです。
元のログは検索対象として残し、重要な判断をメモへ上げ、複数資料を横断する知識はwikiへまとめ、常に必要な少量の情報を最上位へ置けます。
保存する情報の選別が長期記憶の質を左右する
Anthropicは、Claudeがポケモンを長時間プレイする実験で、モデルごとの記憶の残し方を比較しています。
約1万ステップ時点の各1回の実行では、Claude Sonnet 3.7が413個のメモリファイルを225フォルダへ保存し、文字数は約97万8,000文字でした。対してClaude Fable 5は10ファイル、約4万3,000文字に絞り、現在の目標、ルートごとの計画、ゲーム中に検証したルールなどを中心に残していました。
この実行では、Sonnet 3.7が1つのバッジを獲得した時点で、Fable 5は4つのバッジまで進んでいます。Anthropicは、Fable 5が後のセッションでも再利用する戦略・計画・検証済みルールを優先して保存した点に注目しています。現在位置や所持金のような変動情報は、画面からその都度取得できます。
この比較は各モデル1回の実行で、保存量だけを独立に変えた実験ではありません。長期タスクでClaudeが何を重要と判断して残すか、その違いを示す事例として掲載されています。
dreamingは保存済みメモを元ログと照合して修正する
作業中に書いたメモは、その時点の判断を反映します。判断が誤っていたり、環境が変わって情報が古くなったりすると、次のセッションがそのメモを前提に行動します。
dreamingは、保存済みメモと元のセッショントランスクリプトを後から照合し、記憶を修正・統合する処理です。
ポケモンの評価では、ClaudeがMt. Moon近くのPokéCenterの位置を誤って記憶し、山を通過済みだと判断して同じルートへ戻る問題が起きました。dreamingを実行すると、Claudeは元のトランスクリプトから位置関係を確認し、保存済みメモを書き直しました。
修正後の実行では1,935アクションでCerulean Cityへ到達しています。公開グラフの3,000アクション範囲では、誤ったメモを残した実行とメモリなしの実行は到達できませんでした。
ここで重要なのは、元ログを検索可能な形で残していることです。メモを短くまとめても、後から原記録へ戻れるため、dreamingが保存済みの判断を再検証できます。
検索は原文へ、wikiは知識の関係へつなぐ
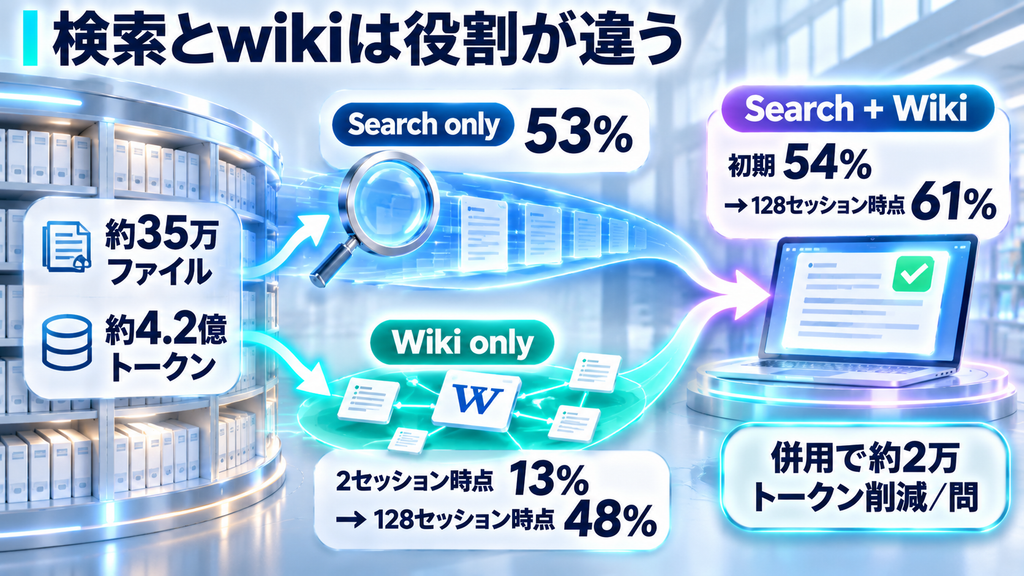
Anthropicは、買収したStainlessの社内文書約35万ファイル、約4億2,000万トークンを使い、Opus 5がwikiを段階的に構築する評価も行っています。
評価では25問を用意し、wikiだけ、検索だけ、検索とwikiの併用を比較しました。
| 条件 | 評価結果 |
|---|---|
| wikiのみ・2セッション時点 | 13% |
| wikiのみ・128セッション時点 | 48% |
| 検索のみ | 53% |
| 検索+wiki・初期 | 54% |
| 検索+wiki・128セッション時点 | 61% |
wikiは、128セッションにわたって追加・修正・重複統合を続けることで、単独でも13%から48%まで伸びました。検索と組み合わせた条件は54%から61%へ上がり、1問あたり約2万トークンの節約も報告されています。
評価から見える役割分担は明確です。検索は原文へ直接到達する経路で、wikiは複数の記憶を関係づけ、どこを見ればよいかを案内する知識地図として機能します。
別の合併文書を使った24問の評価では、複数文書を横断し、判断や計算が必要な項目で、wikiを参照した条件が87%、検索だけが73%でした。単一文書の検索で答えられる別タスクでは、wikiによる明確な改善は確認されていません。
さらに、あるタスクでは元文書115KBに対してwikiが203KBまで膨らみ、元資料の1.77倍になりました。wikiは生成内容によって元資料より大きくなるため、目的に合わせて構造と粒度を保守する必要があります。
毎回読み込む記憶は「索引」として小さく保つ
記憶階層の最上位にあるInjected contextは、セッション開始時からClaudeへ渡す情報です。ここへ置いた内容は検索を待たずに使えますが、その分だけ毎回コンテキストを消費します。
Anthropicは同じ設計原則の例として、Claude Codeのauto memoryを挙げています。
Claude Codeでは、MEMORY.mdの先頭200行または25KBのうち先に到達した範囲だけを毎回読み込みます。詳細は別のトピックファイルへ移し、MEMORY.mdは「何を知っていて、どこにあるか」を示す索引として維持します。
長期エージェントの記憶は、常時読み込む層と必要時に検索する層を分けることで、コンテキスト消費を抑えながら継続性を持たせられます。
Kiro Crew Botsも、Botごとの専用メモリを持ち、継続する担当単位で判断基準を引き継ぐ設計です。長時間稼働エージェントを「担当・メモリ・Worker・権限」の単位でどう運用するかは、次の記事で詳しく整理しています。
DreamsはClaude Managed Agents向けResearch Preview
Claude Managed AgentsのDreamsは、2026年5月6日からResearch Previewとして提供されています。11月6日のEngineering記事では、その仕組みをエージェント記憶全体の設計として位置づけ、ポケモン、Stainless文書、法務文書など複数の評価結果をまとめています。
現在のDreamsは、既存のmemory storeと過去のセッションを入力にする非同期ジョブです。公式ドキュメントでは1回のdreamに1〜100セッションを指定でき、重複の統合、古い情報の更新、新しい知見の抽出を行います。
標準動作では入力memory storeをそのまま残し、再編成した新しいoutput storeを生成します。出力を確認して、今後のセッションで使うか、破棄するかを選べます。
利用条件は次の通りです。
- Claude Managed Agentsの機能
- Claude APIでResearch Preview
- 利用にはアクセス申請が必要
dreaming-2026-04-21など指定のbeta headerを使用- 実行コストは選択モデルの通常APIトークン料金に基づく
- コストは入力セッション数と長さにおおむね比例
- Managed Agentsの該当データ処理はZDRとHIPAAの対象外
memory store自体はManaged AgentsのBeta機能で、セッションをまたぐテキスト文書を保持します。書き込み可能なstoreでは、後続セッションが保存内容を読むため、信頼できない入力を扱う場合はread-onlyの使い分けや保存内容のレビューも運用設計に含まれます。
長期エージェントの記憶設計は5つの判断に分けられる
Anthropicの評価と現在の仕様を、長期エージェントの設計へ置き換えると、記憶管理は次の5つに分けられます。
1. 元ログを検索できる状態で残す
短いメモは作業を速くしますが、後から判断を検証するには元の記録が必要です。dreamingの修正も、保存済みメモをトランスクリプトへ戻って確認することで成立しています。
2. 変動情報と再利用する知識を分ける
毎回画面やデータベースから取得できる現在値は、保存すると古くなりやすい情報です。計画、検証済みルール、利用者の継続的な好みなど、次のセッションでも意味を持つ情報をメモへ残す設計が中心になります。
3. wikiは複数情報を横断する仕事へ使う
wikiの効果はタスクによって変わります。複数文書の関係をたどり、判断や計算をする仕事では効果が大きく、単一文書の検索で完結する仕事では検索だけでも十分な場合があります。
4. 常時読み込み層を小さくする
すべての記憶を毎回プロンプトへ入れると、その分だけコンテキストを使います。常時必要な情報は索引や短いルールへ絞り、詳細は検索対象へ回す構造が必要です。
5. 記憶のメンテナンス周期を決める
dreamingは計算資源を使います。Anthropicも、アクセス頻度や情報の変化しやすさに応じて、どの記憶をどの頻度で見直すかが今後の設計課題だと説明しています。
公開評価から見える現在の限界
公開された数値は、Anthropicが設定した複数の評価環境から得られた結果です。ポケモンのメモリ比較は各モデル1回の実行、Stainless評価は25問、法務評価は特定の文書集合と採点基準で構成されています。
記憶表現の維持には追加の計算が必要で、wiki自体が大きくなったり、誤りやhallucinationを蓄積したりする可能性もAnthropicが課題として挙げています。
また、作業中にメモを書く方法は重要な情報をすぐ残せる一方、主タスクから注意を使います。dreamingは後からまとめて再編成できますが、その出力は処理が終わるまで次の作業で使えません。
現在の設計課題は、どの情報を作業中に保存し、どの情報を後から再編成し、どの層を常時読み込むかまで含めた運用です。
まとめ
AnthropicのAgent Memoryは、ログ、メモ、wiki、常時読み込み文脈を階層として扱い、dreamingで後から修正・統合する設計です。
評価では、少量でも再利用価値の高い記憶を残すモデルが長期タスクで有効に使えた例、検索とwikiを組み合わせることで大規模文書の質問応答が改善した例、誤ったメモを元ログから修正した例が示されました。
長期エージェントを設計するときは、保存、検索、表現、常時読み込み、再編成を別の役割として持たせることが重要です。
記憶が増えるほど、保存容量より「古い情報をどう直すか」「必要な情報へどう到達するか」「毎回何を読み込むか」というメンテナンス設計の比重が大きくなります。