当サイトではアフィリエイト広告を利用しています。
今日のAIニュース5選
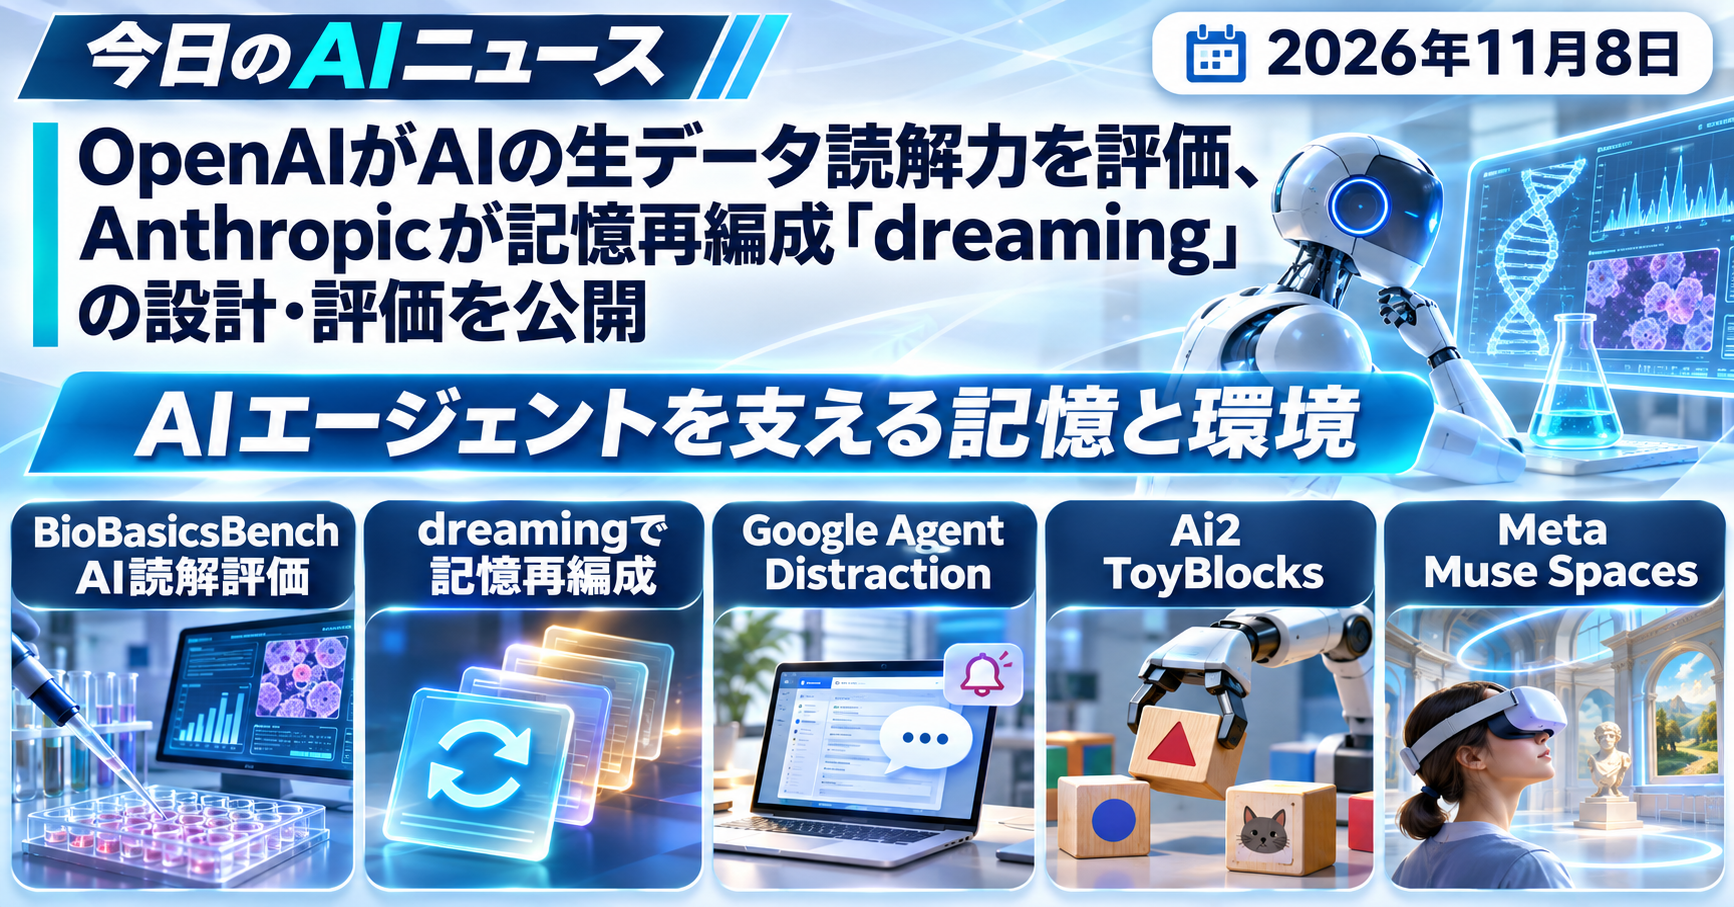
11月6日は、AIエージェントの性能を「何を正しく読めるか」「何を覚えておけるか」「環境の情報にどう影響されるか」という運用側から見直す発表が重なりました。OpenAIは日常のウェットラボで扱う生データ100課題を集めたBioBasicsBenchを公開し、AnthropicはClaudeのエージェント記憶をセッション間で再編成する「dreaming」の設計と評価結果を詳しく説明しています。
Googleはコード中に残った古いTODOがコーディングエージェントを予定外の作業へ誘導する実態を定量化しました。さらにAi2はロボット学習を制御環境で検証するToyBlocks、MetaはMuseの中に利用者専用の体験を作るSpacesを公開しています。今回は、AIが長い仕事や現実のデータへ近づくほど重要になる、記憶・文脈・評価環境の変化を5件から見ていきます。
1. OpenAI、AIの実験生データ読解・判断能力を測る「BioBasicsBench」を公開
OpenAIは11月6日、AIエージェントが日常のウェットラボ作業をどこまで扱えるかを測る「BioBasicsBench」を公開しました。このベンチマークは、酵素設計を手がけるLigoと共同開発したものです。対象は100課題で、ゲル画像、コロニープレート、顕微鏡画像、シーケンスデータ、装置から出力された表、実験動画など、研究者が実際に扱う形の生データを入力に使います。
BioBasicsBenchは、AIエージェントのデータ読解、実験上の誤りの検出、証拠から結論を出せる範囲の判断まで評価します。課題はタンパク質実験、イメージングとフローサイトメトリー、定量・アッセイ、核酸実験、分子クローニングの5領域に分かれています。論文用に選別された図表よりも、失敗、曖昧な画像、食い違う観察結果が残る日常の実験データへ評価対象を近づけた点が特徴です。
OpenAIは7モデル、37のモデル・推論設定を各課題5回ずつ評価し、合計18,500件の結果を集計しました。より多くの推論計算を使うxhigh設定では、GPT-6 Astraの平均獲得率が66.7%、GPT-6.1 Solが62.0%、GPT-5.6 Solが43.8%でした。66.7%は、100課題に設定された採点基準に対する平均獲得率です。
具体例では、Astraが抗生物質のラベルと実験条件の不一致を見つけて対照実験を無効と判断したケースや、顕微鏡のz-stack画像から対象物が消えたように見える現象を撮影位置の違いとして捉えたケースが紹介されています。科学向けAIの評価軸が、論文知識の再現から、現場の不完全な証拠を読んで次の実験判断へつなげる能力へ広がっています。
2. Anthropic、エージェント記憶を再編成する「dreaming」の設計・評価を公開
Anthropicは11月6日、Claudeのエージェント記憶をどのように設計しているかをまとめたEngineering記事「The components of agent memory」を公開しました。ここでいう記憶は、Claudeが利用者とのやり取りや担当タスクから得た知識を、次のセッションでも読み返せる外部文脈として保存する仕組みです。
Anthropicは記憶を階層として説明しています。下には検索可能な会話・作業ログがあり、その上にClaudeが書くメモ、複数の記憶を結びつけるwikiのような表現、次のセッションへ最初から読み込む重要情報が重なります。この階層をアイドル時間に見直し、誤ったメモを直したり、重複をまとめたり、新しいwikiを作ったりする処理が「dreaming」です。
長期記憶では、作業中に重要だと判断した情報も、後の状況によって価値が変わります。Anthropicのゲーム評価では、誤った地図情報をメモしたClaudeが進行に詰まり、その後のdreamingで元のログを見直して記憶を修正すると先へ進めました。dreamingは、残されたログとメモを使って次回に役立つ外部記憶を再構成する処理です。
大規模文書でも効果を測っています。Anthropicが買収したStainlessの約35万ファイル、約4億2,000万トークンを対象に、Opus 5が128セッションかけてwikiを構築しました。wikiだけで25問へ答えた評価は2セッション時の13%から128セッション時の48%へ上昇し、検索とwikiの併用は54%から61%へ上昇しました。検索だけの場合は53%で、併用時には1問あたり約2万トークンも節約できたと報告しています。
長時間動くエージェントでは、記憶の選別と再編成が性能へ直結します。何を残し、何をまとめ、どの情報を最初から読み込み、必要な情報をいつ検索するかが設計の中心です。Anthropicの公開内容は、エージェント記憶を「長い会話履歴」から、継続的に更新する知識構造として扱う設計を具体化しています。
3. Google、古いTODOがコーディングエージェントを脱線させる実態を分析
Googleは11月6日、コーディングエージェントがコード中の古いTODOやFIXMEに引きずられる現象を「Agent Distraction」として公開しました。Googleは数百万のファイル読み取りセッションと、数億ステップ規模のエージェント実行トレースを使い、TODO(bug/…)やFIXME(bug/…)に書かれたバグ番号と実際のバグ状態を照合しています。
分析では、ファイルを読むセッションの13%でエージェントがこうしたバグ参照へ遭遇しました。遭遇後の94%ではそのまま無視しましたが、6%では対象バグに向けた追加行動を取り、そのうち83%は利用者が依頼していない行動でした。未依頼の寄り道の41%はすでに修正済み・廃止などの閉じたチケットを追い、57%はまだ開いている別のバグへ作業範囲を広げています。
コストも数値化されています。開発者、コードベースの複雑さ、タスク種別、モデル層、読み込んだファイル数などを統制した回帰分析では、未依頼のバグ寄り道が発生したセッションは、ステップ数が70%、使用トークンが77%、待ち時間が105%増えました。古いコメントが単なる技術的負債から、AIエージェントの実行コストと判断を直接変える入力へ変わっていることが見えます。
Googleは対策として、修正済み・廃止済みのバグ参照をコードベース全体から探し、履歴まで確認して不要と判断できたTODOだけを削除候補にするエージェントを作りました。過去6か月で数千件の古い参照を削除し、人のレビュアーによる変更承認率は95%を超えたとしています。
コーディングエージェントを大規模に使う環境では、プロンプトやモデル選定と同じくらい、リポジトリ内のコメント、古い仕様、放置された課題参照を現在の状態へ保つことが重要になります。AIがコードベース全体を読むほど、忘れられた情報も作業指示として再浮上します。
4. Ai2、ロボット学習用シミュレーション「ToyBlocks」を公開
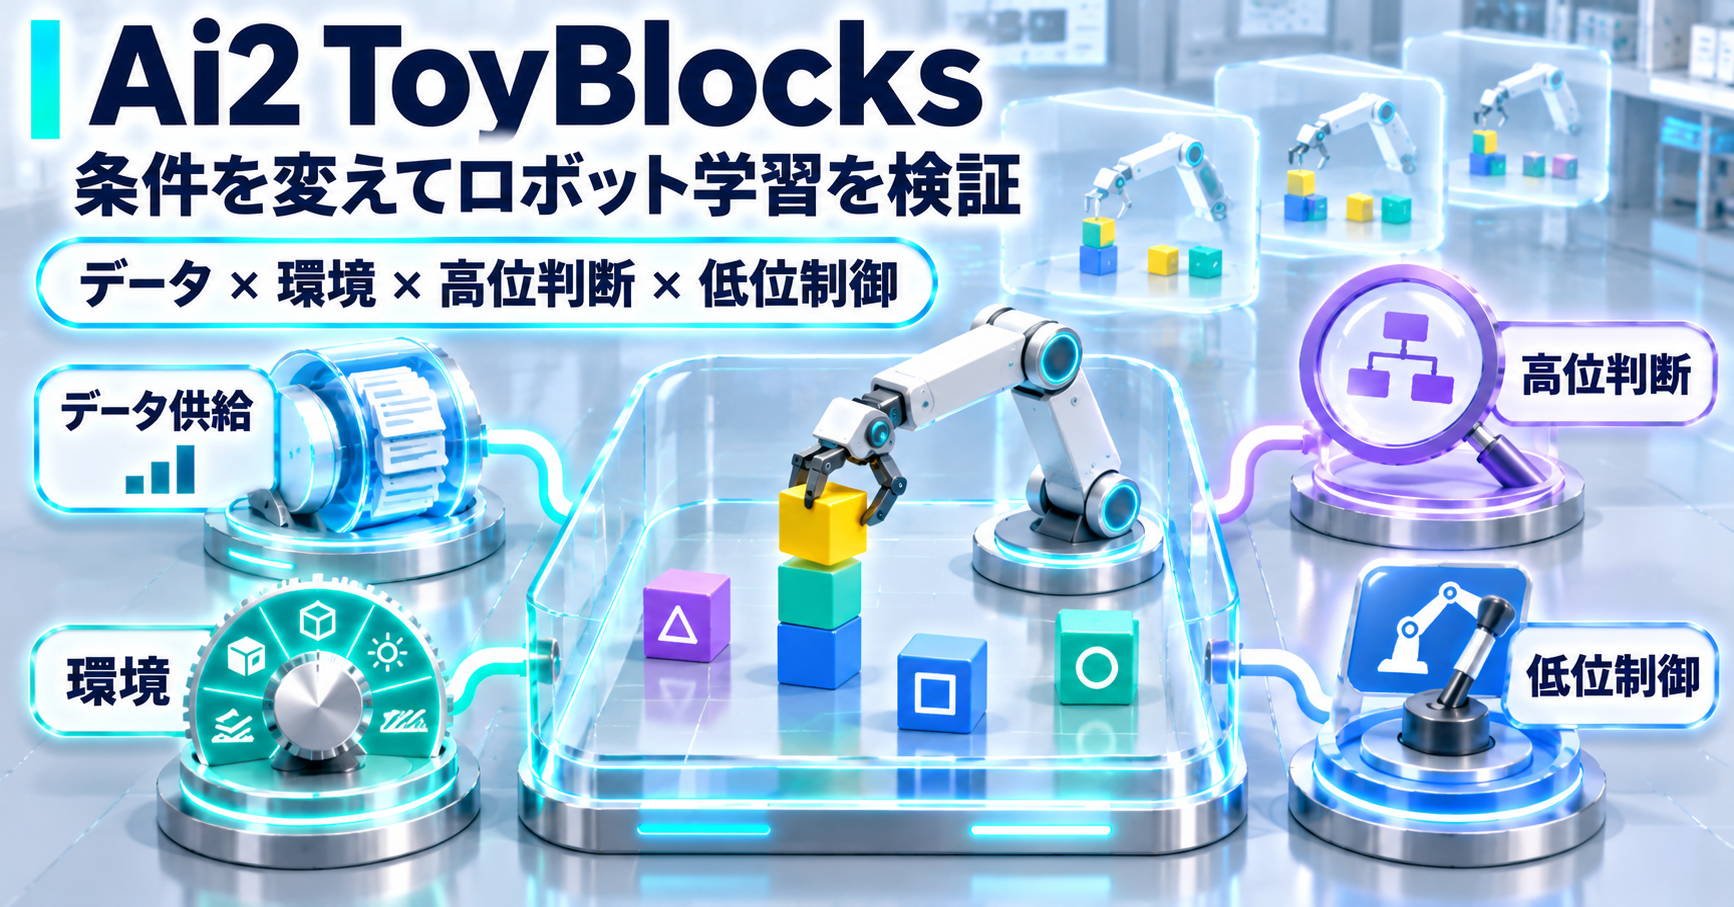
Ai2は11月6日、ロボット学習を制御されたシミュレーション環境で研究する「FoundationWorlds」構想と、その第1弾「ToyBlocks」を公開しました。ToyBlocksは、テーブル上のブロックとロボットアームを使い、押す、裏返す、積む、探す、並べるといった操作を繰り返し学習・評価できるオープンな研究環境です。コード、データ、モデル、ドキュメントも公開されています。
FoundationWorldsが狙うのは、ロボットが成功・失敗した理由を追える実験環境です。現実のロボットデモは対象物や作業条件が限られ、訓練データのどの要素が性能へ効いたのかを切り分けにくいことがあります。ToyBlocksでは課題と学習デモを自動生成し、押す練習を増やす、裏返す練習を減らす、訓練に含めなかった課題で評価する、といった条件変更を繰り返せます。
ブロックの各面には文字や画像を置け、裏面を確認してから分類するような、見えていない情報を確かめる推論も評価対象になります。ブロックの大きさやテーブルの高さを変えるdomain randomizationも使い、形状条件が変わったときの汎化を調べられます。
短い動作スキルの生成には、NVIDIA Isaac Lab上で強化学習とモーションプランニングを利用します。シミュレータが持つブロックの正確な位置や姿勢を使って大量のデモを自動生成し、その後はセンサー観測から動くモデルの訓練にも使えます。Ai2は1枚のGPU上で数百のプランを並列実行し、最大で実時間の24倍の速度でデータ生成できると説明しています。
ToyBlocksでは、データ量、技能の組み合わせ、高レベル推論と低レベル制御の役割を、条件を変えながら反復実験できます。対象をブロック操作へ絞ることで、訓練条件と失敗原因を追いながら比較できる研究基盤になっています。
5. Meta、Museにカスタム体験を作る「Spaces」を追加
Metaは11月6日、Museアプリ内に利用者専用の体験を作れる新機能「Spaces」を提供開始しました。作りたいものを文章でMuseへ伝えると、休日のギフト管理、毎日の単語ゲーム、DIY計画、学校予定、音楽追跡、旅行計画などに合わせた専用の画面を生成します。
作ったSpaceはMuseのサイドバーやメインタブへ置けます。平日は週間プランナーを前面に出し、週末は別のSpaceへ切り替えるように表示時期を設定することもできます。最初に作った後も、「項目を追加する」「見た目を変える」「動作を変える」と自然言語で指示しながら更新できます。
Spaceは、接続したアプリの情報を使ってバックグラウンドで更新され続けます。Metaは、新しいコンサート日程、価格変化、貯蓄の進捗などがバックグラウンドで反映される例を挙げています。利用者はSpaceの中で項目を完了扱いにしたり、メモを書いたり、内容を編集したりできます。
Spacesは11月6日からMuseが提供されている地域で利用可能です。Metaは今後、Spacesを他の人と共有する方法も検討しており、Muse Wonderから得た知見で訓練した専用モデルもMuseへ段階的に展開しています。
生成AIアプリの画面は、チャット欄を開いて毎回依頼する形から、目的別の常設画面をAI自身が組み立てる形へ広がっています。Spacesは、個人向けAIを「会話相手」から、日々更新される自分専用の小さなアプリ群へ近づける機能です。
まとめ
今回の5件は、AIエージェントの実用性を決める要素がモデル本体の性能から周辺環境へ広がっていることを示しています。BioBasicsBenchは曖昧さを含む実験生データを読むAIの能力、Anthropicはセッション間の記憶構造、Googleはコードベースに残る古い文脈を評価対象にしました。AIが長く働くほど、入力データと記憶の品質が結果へ強く効いてきます。
Ai2のToyBlocksは訓練条件を変えてロボットの失敗原因を追える研究基盤を整え、MetaのSpacesは利用者が自分用のAI画面を作って継続利用する製品体験を始めました。11月6日の発表は、科学、開発、ロボット、個人向けアプリという別々の領域で、AIを「一度答えるモデル」から「環境を読み、覚え、継続して動く仕組み」へ変えるための具体的な設計を見せています。
今日の注目アイテム
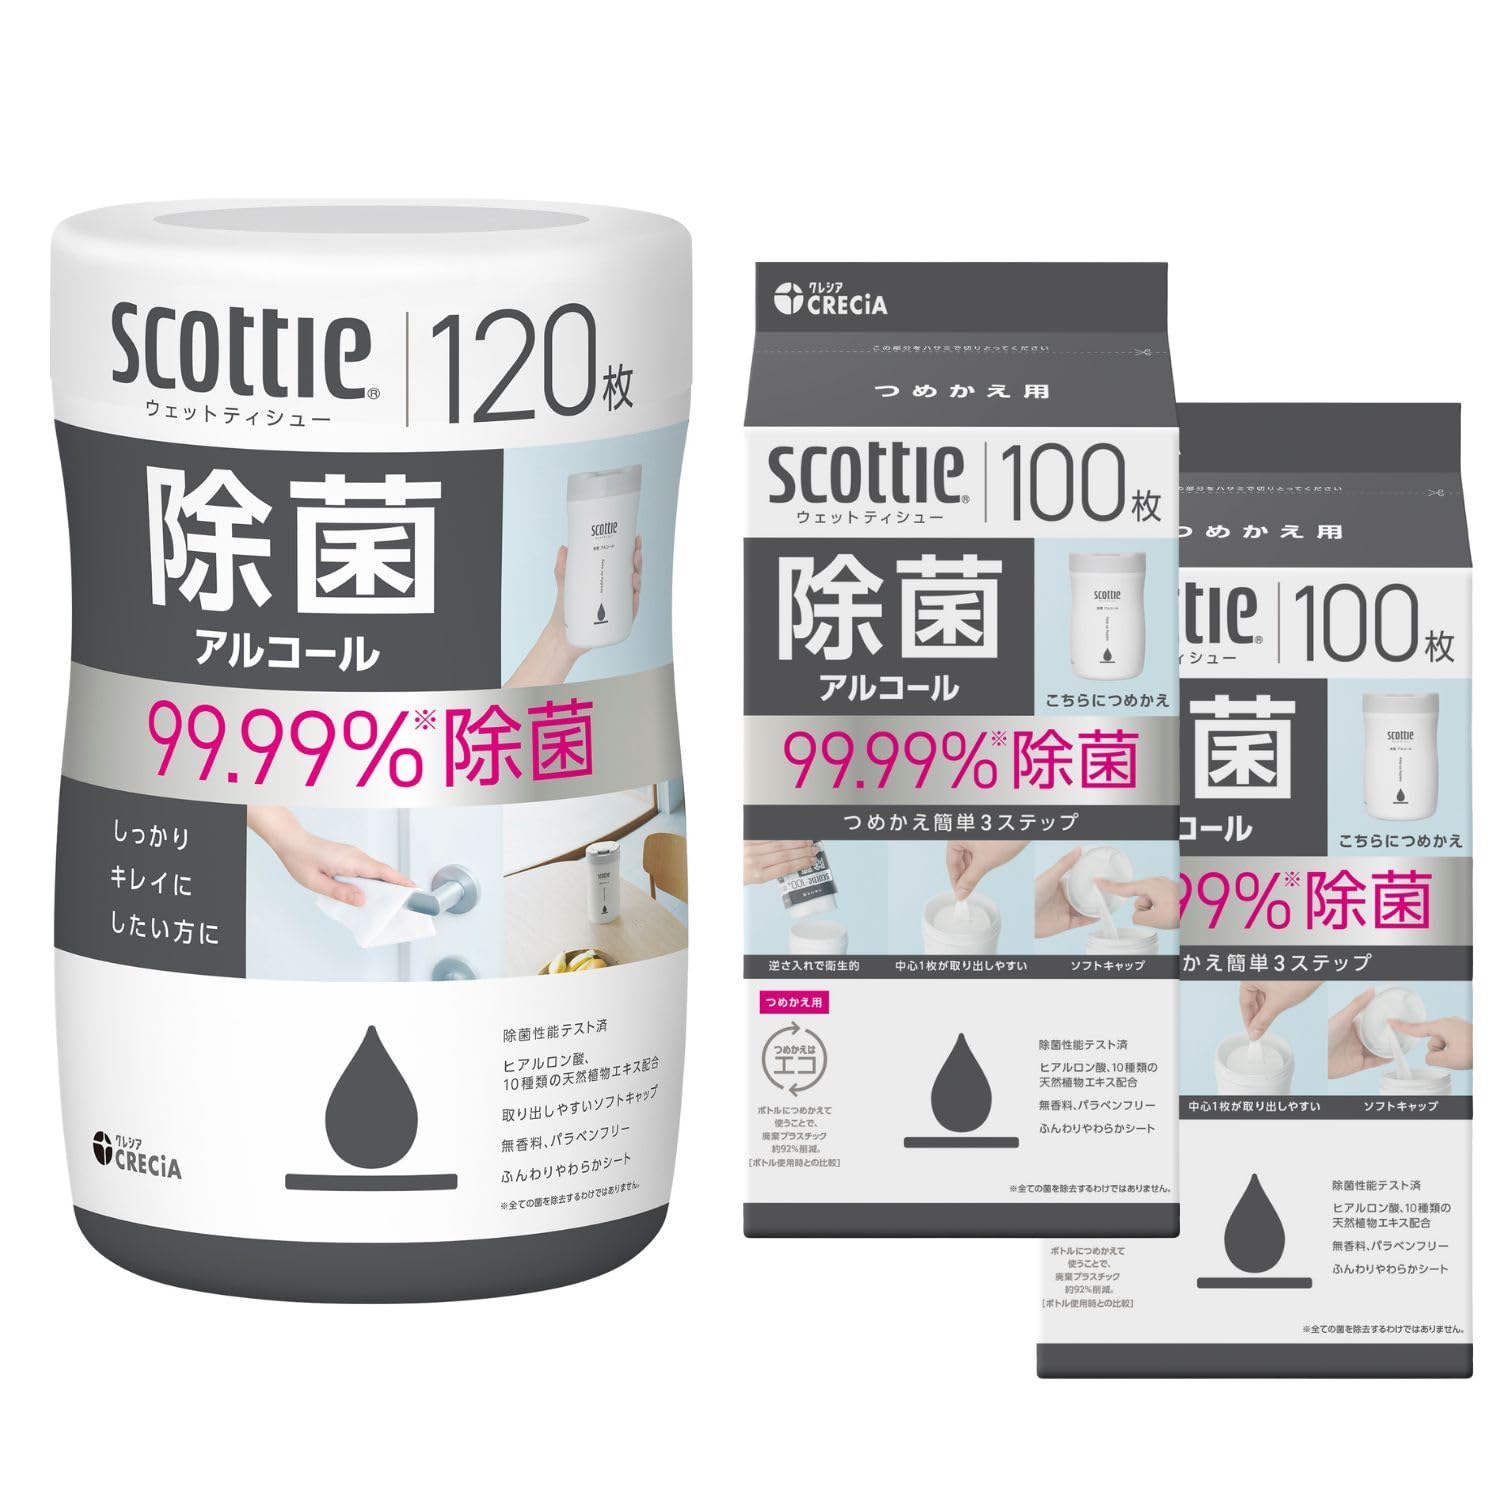

スコッティのアルコール除菌ウェットティッシュで、本体は120枚入りです。 詰替用は100枚入りが2個付属するセット品です。
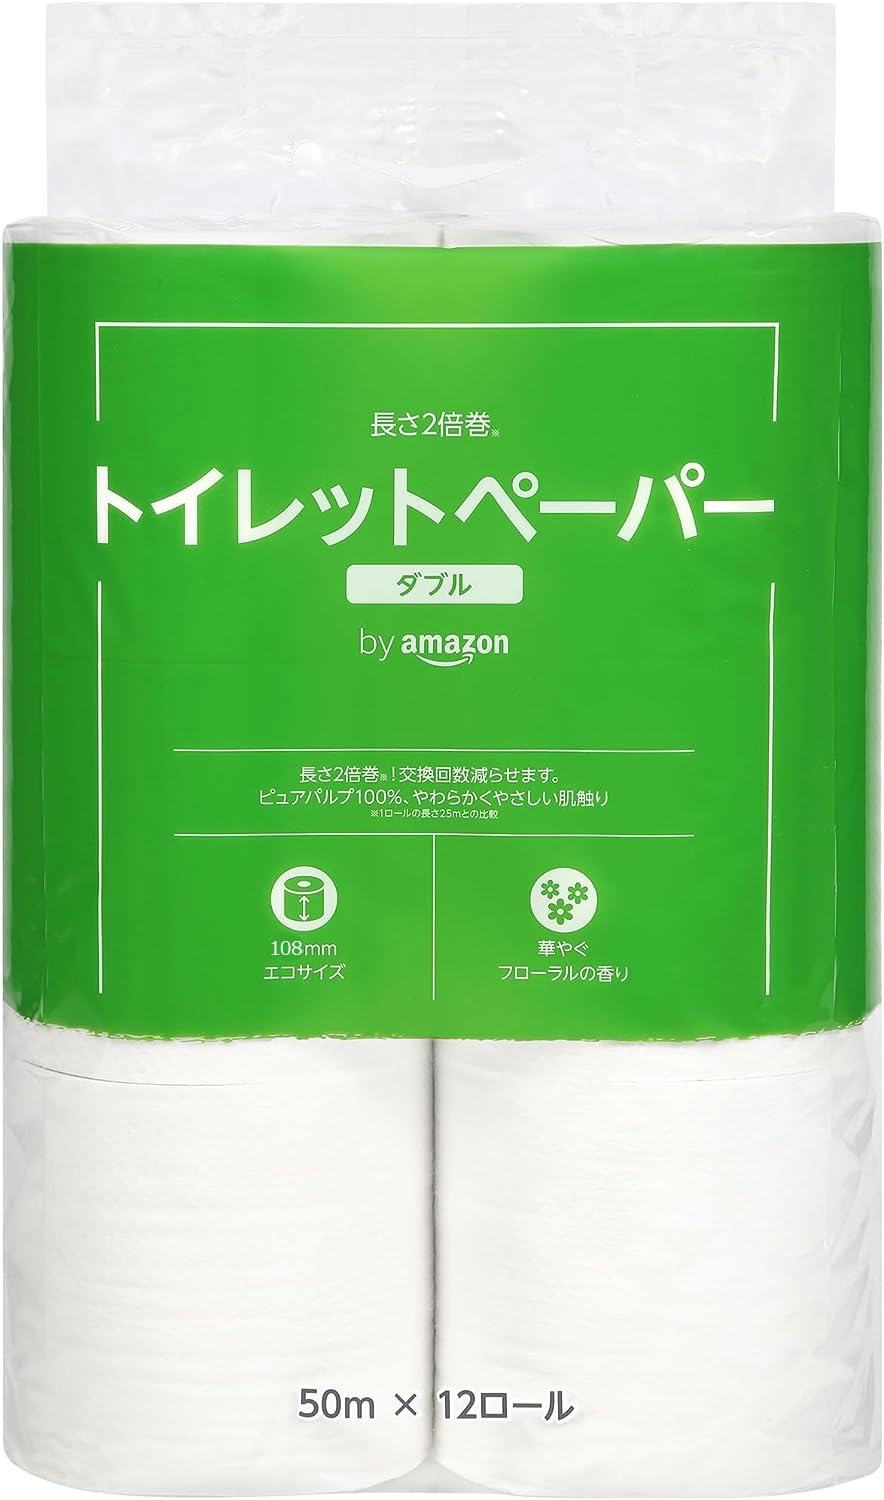

by Amazonのトイレットペーパーは、50m巻が12ロール入ったダブル仕様です。 12ロールで24ロール分とされ、フローラルの香りが付いています。
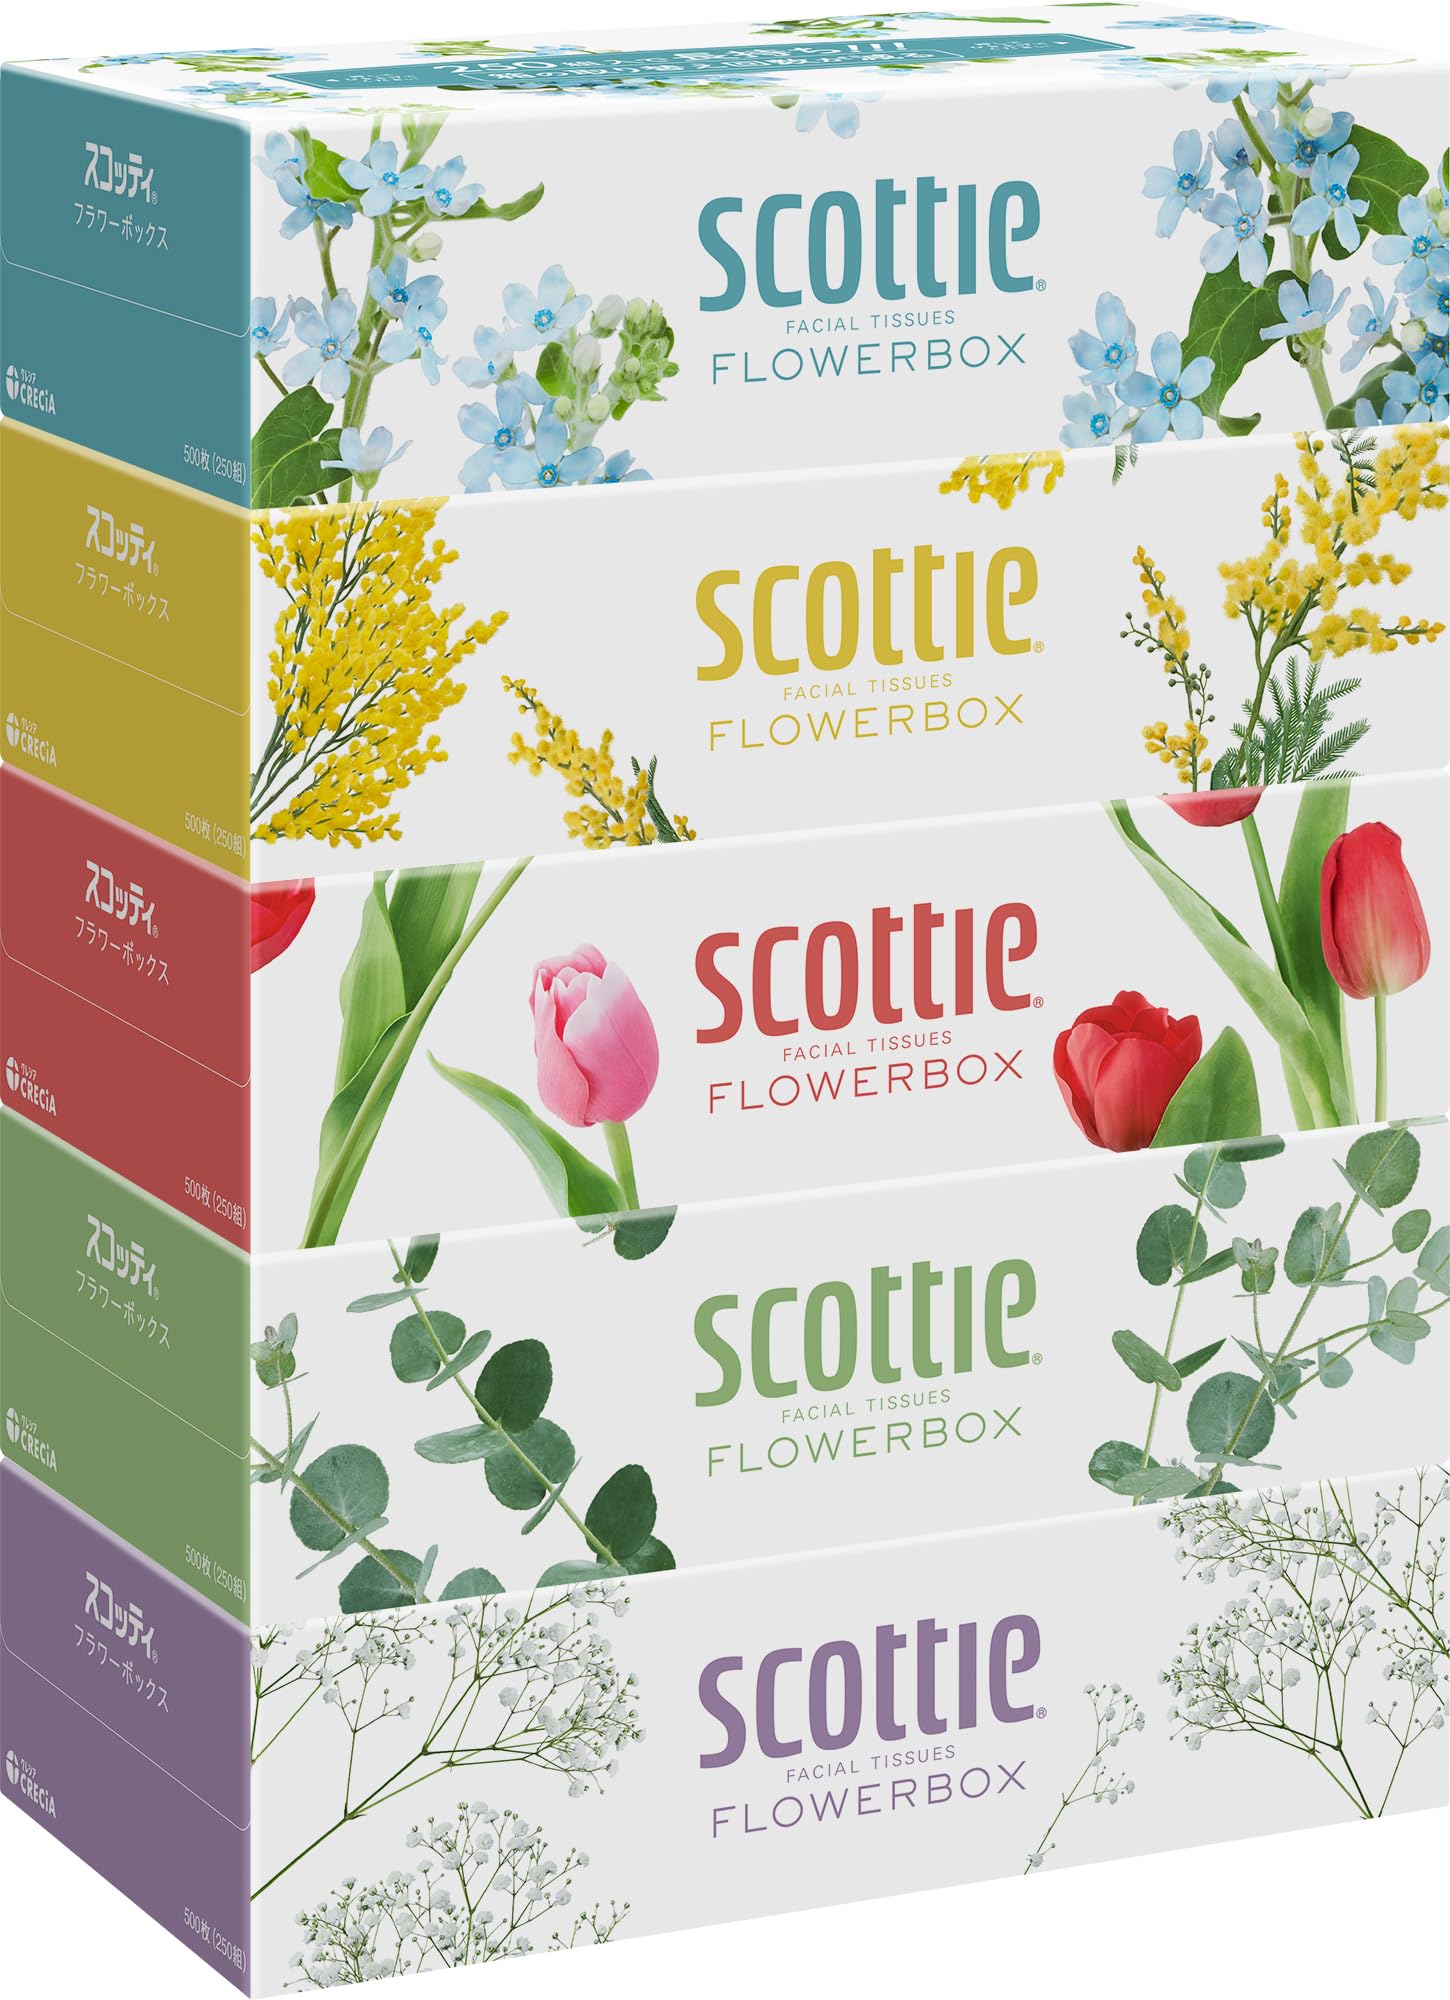

スコッティのフラワーボックスは、1箱あたり500枚(250組)のボックスティッシュ5箱セットです。 日用品として使いやすいボックスティッシュを、まとめて用意できます。