当サイトではアフィリエイト広告を利用しています。
2026年11月2日、NVIDIAは分散AIワークロードの障害原因を分析する「NVIDIA Attribution」をオープンソースとして公開しました。
分散学習や大規模推論では、1台のGPUやネットワークで起きた障害が、別ノードのNCCLエラー、スケジューラ状態の変化、大量の後続ログとして広がります。最後に表示された例外は「処理が止まった場所」を示していても、「障害を始めた原因」とは限りません。
NVIDIA Attributionが行うのは、ワークロード単位でログ、メトリクス、テレメトリ、スケジューラ状態を結び付け、症状の連鎖から上流の原因と証拠を一つの診断へまとめることです。
この記事では、NVIDIA Attributionがどの情報を集め、どの順番で原因を絞り、何を診断結果として返すのかを解説します。あわせて、Standaloneのオープンソース版とNVIDIA Recovery向け統合設定を混同しないための境界も整理します。
NVIDIA Attributionは分散AI障害の「症状の連鎖」を一つの診断へまとめる
NVIDIA Attributionは、失敗したGPUワークロードから出る大量の症状を横断して相関させる障害分析システムです。
公式GitHubでは、10,000 GPU規模のマルチランクワークロードでは、アプリケーションログ、ホストsyslog、スケジューラDB、GPUドライバのdmesg、Fabric Managerログ、メトリクスなどに数百〜数万行の記録が出る場合があると説明しています。
そこでAttributionは、ノード単位のエラーを別々に読むのではなく、一つのワークロードがいつ、どのノードを使い、その時間帯に何が起きたかという範囲を先に決めます。
その範囲で見つかったXID、NCCLエラー、スケジューラ遷移、DCGM系メトリクスなどを構造化し、ルールで相関させます。
最終的に返す主な情報は次の通りです。
- ワークロードの結果を示す
terminal_state - 障害領域を示す
sub_domain - 原因に関連するノード
- 根本症状
- 下流で観測された症状
- どのログやメトリクスから判断したかという証拠の来歴
障害対応で重要なのは、「エラーが出たノード」と「原因を持つノード」が同じとは限らないことです。
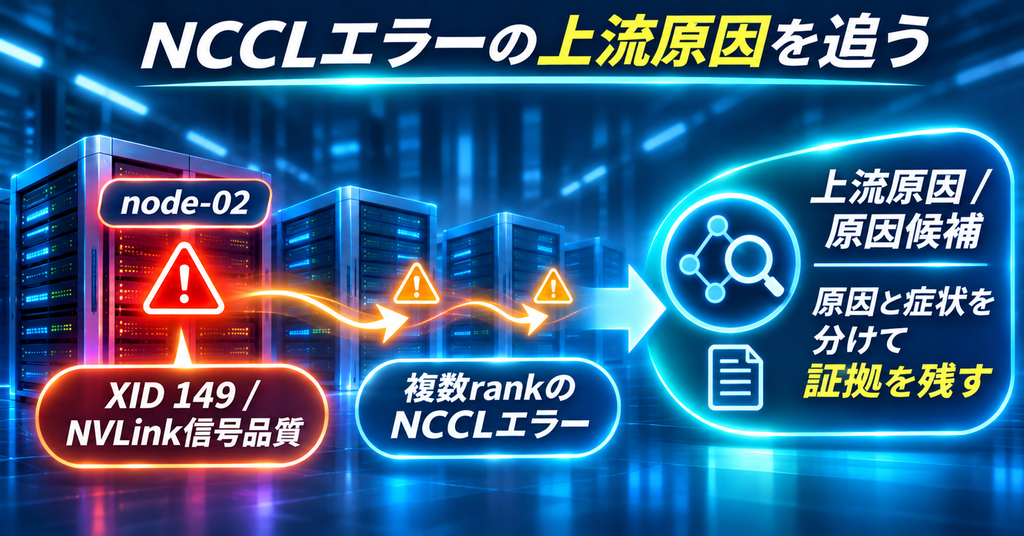
典型例は「複数rankのNCCLエラー、原因は別ノードのNVLink」
NVIDIAの技術ブログでは、3ノードのマルチランク学習を使った合成例が示されています。
アプリケーションログには複数のNCCLエラーが出ています。一方、node-02のsyslogにはXID 149があり、そのエラーワードからNVLinkのsignal integrity issueが読み取れます。
表面だけを見ると、複数ノードで通信障害が起きたように見えます。
Attributionは、この証拠を同じワークロードの時間軸で相関し、node-02のNVLink信号品質問題を根本原因として残します。ほかのrankで出たNCCLエラーは捨てず、原因から派生した「supporting symptoms」「interesting evidence」として証拠の連鎖へ残します。
つまり、見るべきものは最後の例外だけではありません。
NCCLエラーがどこで観測されたかに加え、その前後でGPU、NVLink、スケジューラ、別ノードに何が起きていたかを見ることが、分散障害の切り分けでは重要になります。
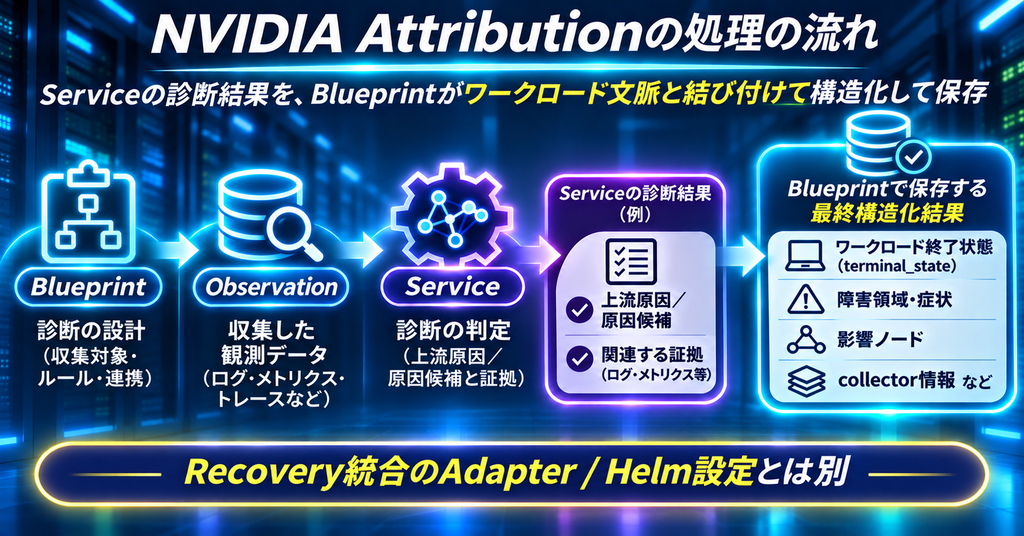
診断は4段階で進む
NVIDIAの技術ブログでは、Attributionの流れを4段階で説明しています。
1. ワークロードの範囲を決める
Blueprintがスケジューラの識別子、または実行時間と割り当てノードから一つのワークロード試行を特定します。
ここで「どのジョブ」「どのノード」「いつからいつまで」を決めることで、別ジョブのログや無関係なノードイベントを混ぜにくくします。
2. 観測データを集める
ログ・メトリクスのコネクタが、ワークロード範囲に対応するObservationを作ります。
対象になり得る情報には、
- アプリケーションログ
- syslog
- GPUドライバやFabric Managerのメッセージ
- スケジューラ履歴
- ノードメトリクス
- ネットワークメトリクス
があります。
3. イベントを抽出して相関する
Service側のAttribution engineが、XID、NCCL障害、スケジューラ遷移、メトリクス条件などをイベントとして抽出します。
その後、決定論的なルールがイベント同士の時間関係や組み合わせを評価します。
ここで、原因候補として強い症状と、下流へ波及した症状を分けます。
4. 構造化した診断を返す
BlueprintはServiceの判定に、ワークロードの終了状態、障害領域、症状、影響ノード、collectorのカバレッジやエラー情報を組み合わせて結果を保存します。
人が大量のログを読み直す代わりに、後段の運用システムは構造化された結果を受け取れます。
ServiceとBlueprintは役割が違う
StandaloneのNVIDIA Attributionは、主に2つのデプロイ可能なコンポーネントで構成されます。
| コンポーネント | 主な役割 |
|---|---|
| Attribution Service | 正規化済みの観測データを受け取り、ルールエンジンで1ワークロード1診断を返すRESTサービス |
| Attribution Blueprint | ワークロードを発見し、実行範囲を解決し、ログ・メトリクスを集め、Serviceを呼び、結果を保存するPython参照オーケストレータ |
重要なのは、Service自身がSlurmへ問い合わせたり、Lokiからログを読んだり、Prometheusを直接スクレイプしたりする構成ではないことです。
クラスタ固有の接続はBlueprint側が担当します。
公式リポジトリのBlueprintには、執筆時点で次のコネクタが用意されています。
- Execution context:Slurm、Kueue、静的入力
- ログ・メトリクス:Loki、ローカルファイル、Kubernetes Podログ、PromQL
- 出力:stdout、SQLite
この分離によって、複数クラスタの近くにBlueprintを置き、中央のAttribution Serviceを共有する構成も取れます。
「最初の原因」をどう決めるのか
Attributionは、単純に最古のタイムスタンプを「原因」とする仕組みではありません。
ルールエンジンにはExtraction、Filtering、Refinementなどの段階があり、具体的な症状とイベントの関係を評価します。
NVIDIAのXID 149例では、
- 各ノードのNCCLエラーをイベント化する
- node-02のXID 149をデコードする
- NVLink signal integrity issueという症状へ変換する
- 最終ルールでXID側を強い原因候補として残す
- NCCLエラーを下流症状として保持する
- hardware failureとして構造化する
という流れです。
ここでいう「根本原因」は、ルールと証拠が支持する上流の原因です。
証拠が足りない場合、Attributionは無理に断定しません。複数原因が同程度に当てはまれば ambiguous、十分な証拠がなければ unattributed を返せます。
この挙動は、障害分析で誤った確信を作らないために重要です。
NVIDIA Attributionが「やらないこと」も重要
Attributionの役割は原因の証拠を整理するところまでです。
公式リポジトリでは、次の境界が明記されています。
ハードウェアを自動で診断コマンド実行しない
Attributionはログ相関エンジンです。
障害ノードへ診断コマンドを実行したり、ハードウェアを能動的にprobeしたりする仕組みではありません。
ノード交換や復帰を自動決定しない
結果にhardwareと出ても、それだけで「交換する」「本番へ戻す」という判断までは行いません。
症状の連鎖と証拠を提示し、最終判断は運用者や後段システムへ残します。
監視基盤を置き換えない
LokiやPrometheusなどが持つログ・メトリクスを消すものではありません。
既存のテレメトリを入力として使い、ワークロード障害の文脈へまとめます。
この境界を理解すると、Attributionは「万能なGPU診断ツール」ではなく、既存監視と障害復旧の間に置く原因分析レイヤーだと捉えられます。
Standalone OSSとNVIDIA Recovery向け統合設定は分けて考える
今回オープンソース公開されたAttributionを単独で試す場合は、公式GitHubの dsx-ai-factory/attribution を基準にします。
リポジトリのQuickstartは、Attribution ServiceとBlueprintのWeb UIをDockerで立ち上げ、同梱されたサンプル証拠をBlueprintからServiceへ渡す構成です。
一方、NVIDIA Recoveryは分散学習の復旧ループを扱う別プロジェクトです。
Recoveryでは、
- Detect
- Attribute
- 障害ノードの隔離
- ワークロードの再開・停止
という復旧側の処理を持ち、Attributionはより深い原因診断を追加するオプションの統合先として使われます。
NVIDIA Recoveryの公式ドキュメントには、Attribution Adapter、provider Deployment、Helm values、Recovery側のURL設定などが記載されています。
これらはRecoveryへAttributionを組み込むための個別統合設定です。
Standalone OSSのService+Blueprintを試すときに、Recovery向けのHelm設定やAdapter構成をそのまま前提にする必要はありません。
導入前に確認したい対応範囲
公式GitHubではNVIDIA Attributionを「open source・pre-1.0」としています。
執筆時点の主な前提は次の通りです。
| 項目 | 執筆時点の記載 |
|---|---|
| Service側Python | 3.14.6以上、3.15未満 |
| Blueprint側Python | 3.11以上 |
| Slurm | 25.11以上、SLUIDが必要 |
| Kueue | v0.6以上+JobSet v0.5以上 |
| KAI Scheduler | Service APIの値はあるがAttribution実装は未対応 |
| GPUアーキテクチャ | A100、H100、L40S、B200、GB200、GB300 |
| ライセンス | Apache License 2.0 |
GB200・GB300はルールカバレッジが成熟途中とされています。
また、GitHub Issuesでは、RKE2 / SUSE Linux Enterprise環境で短いhostnameとFQDN、RFC 3339タイムスタンプの組み合わせによりsyslog行が落ちるP1 issueなども公開されています。
pre-1.0段階では、READMEの対応表だけで導入判断を終えず、使うスケジューラ、ログ形式、ホスト名、テレメトリの取得経路を実環境で検証した方が安全です。
決定論的ルールを使う理由
Attributionの特徴の一つは、根本原因の判定を決定論的ルールで行うことです。
大規模障害解析では、同じ証拠から毎回違う説明が出ると運用手順へ組み込みにくくなります。
ルールベースなら、
- どの証拠で判定したか追える
- 同じ入力で再現しやすい
- 既知の障害パターンをテストできる
- クラスタ固有の症状を追加できる
- ルール変更をコードレビューできる
という利点があります。
公式リポジトリには宣言的ルールとPythonルールがあり、ルール内にテストケースを持たせる仕組みもあります。
新しい障害パターンを見つけた場合、extractorやrefinerを追加し、同じExecutionContext、Observation、結果形式へ流せます。
大規模運用では「1件の障害」よりパターンを集約できる
NVIDIAは、自社AIインフラでAttributionを数年間使い、毎週数百万件のワークロード、数十万GPU規模を分析していると説明しています。
これはNVIDIA自身が公表している運用規模で、第三者検証値ではありません。
公開された事例では、大規模RDMAクラスタでRDMAポートエラー、connection reset、スケジューラのNot Respondingを相関し、特定のhost-portとswitch-portの組み合わせへ症状を集中させています。
その証拠をもとに、運用側がファブリック修復とホスト側の輻輳調整を実施し、そのクラスタではワークロード中断間隔が約3倍に改善したとNVIDIAは説明しています。
ここでAttributionが行ったのは、修復そのものではありません。
大量の個別障害を、同じ原因候補へ集約し、運用者が対処できる範囲まで証拠を絞ったことが役割です。
分散AI障害を切り分けるときに持ち帰れる4つの考え方
Attributionをそのまま導入しない環境でも、障害分析の設計は参考になります。
1. ワークロード単位で時間とノードを先に絞る
クラスタ全体のログを検索する前に、対象ジョブの実行時間と割り当てノードを確定します。
2. アプリケーションログだけで原因を決めない
NCCLやPyTorchのエラーに加え、XID、Fabric Manager、スケジューラ状態、ノード・ネットワークメトリクスを同じ時間軸で見ます。
3. 根本原因と下流症状を分けて残す
「原因だけ残してほかを消す」のではなく、どの症状がどの証拠から出たかを保存します。
4. 証拠不足を診断結果として扱う
原因を1つに決められないとき、ambiguousやunattributedを正常な結果として扱います。
この4点が揃うと、障害対応は「最後に出たエラーを検索する作業」から「症状の連鎖を再現できる証拠へ変える作業」へ変わります。
まとめ
NVIDIA Attributionは、分散AIワークロードのログ、メトリクス、テレメトリ、スケジューラ状態をワークロード単位で相関し、根本原因、影響ノード、下流症状、証拠の来歴を一つの診断へまとめるオープンソースシステムです。
重要なのは、最後に表示されたNCCLエラーをそのまま原因としないことです。
処理が止まった場所と、症状の連鎖を始めた原因を分けて追う。
ServiceとBlueprintを分け、クラスタ固有の情報収集と共通の診断ロジックを切り離す設計も、大規模運用で使いやすいポイントです。
一方、Attributionは監視・能動診断・修復を全部行う製品ではありません。Standalone OSSとして使う構成と、NVIDIA Recoveryへ組み込む個別設定も別です。
分散GPU環境の障害解析では、エラー件数を減らすことより、再現可能な証拠の連鎖から、対処すべき上流原因へ絞り込めるかが重要になります。
公式情報・参照先
- Diagnose Distributed AI Workload Failures with NVIDIA Attribution|NVIDIA Technical Blog
- NVIDIA Attribution|GitHub
- NVIDIA Attribution overview|GitHub
- How Attribution Works|GitHub
- Attribution Blueprint Configuration Reference|GitHub
- NVIDIA Attribution REST API walkthrough|GitHub
- NVIDIA Attribution|NVIDIA Recovery documentation
- Keep Distributed Training Running with Automated Workload Recovery|NVIDIA Technical Blog
- GitHub Issues|NVIDIA Attribution