当サイトではアフィリエイト広告を利用しています。
今日のAIニュース5選
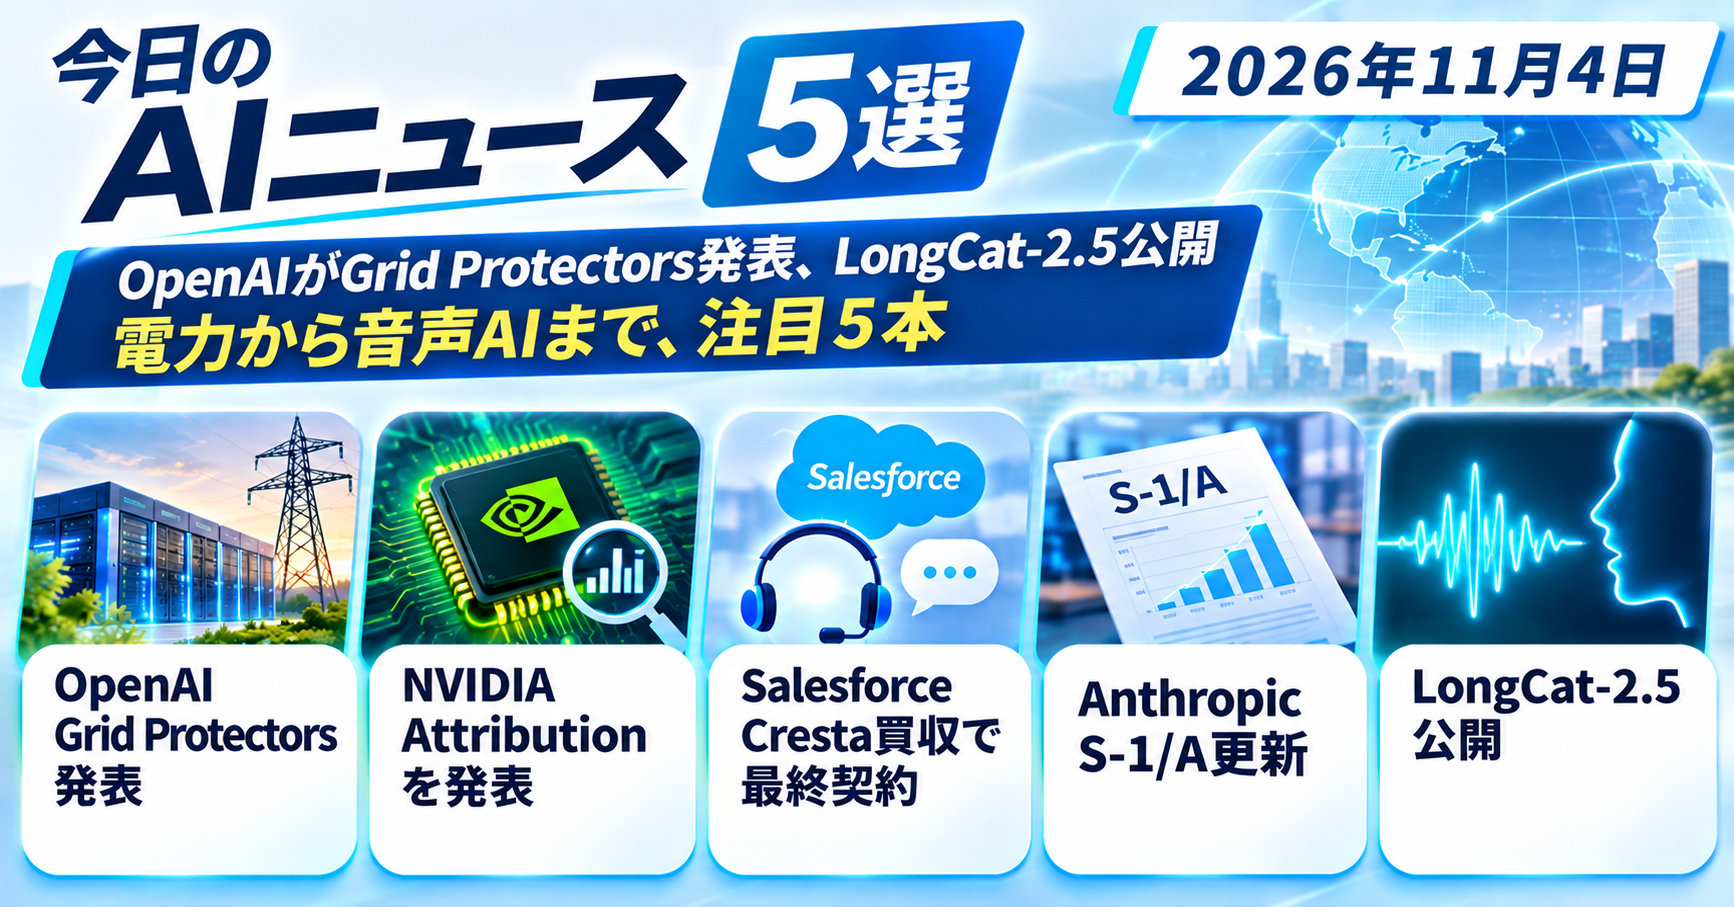
OpenAIは11月2日、将来の計算拠点が電力網の逼迫時に需要を下げる「Grid Protectors Program」を発表しました。同じ日にAnthropicのIPO関連書類では、計算資源・インフラを中心とする約8,954億ドルの契約コミットメントも開示されています。
今日の5本では、AIを動かす電力と計算資源に加え、分散AIの障害診断、音声エージェント企業の買収契約、長時間エージェント向け新モデルまで見ていきます。
1. OpenAI、Grid Protectorsで将来の計算拠点の電力需要を調整へ
11月2日、OpenAIは「Grid Protectors Program」を発表しました。将来建設する計算拠点について、電力網の負荷が高まったときに使用電力を下げられるよう、電力会社、規制当局、政策担当者と地域ごとの取り決めを作る構想です。AI用データセンターの増加で電力需要が大きくなるなか、供給設備を増やすだけでなく、大口需要側がピーク時に消費を調整する仕組みを施設運用へ組み込もうとしています。
プログラムでは、必要に応じて施設の電力使用を減らすほか、地域の設備条件に合わせて敷地内の発電・蓄電設備やバッテリー、電力制御も活用する方針です。どれだけ需要を下げるか、どの程度の時間続けるかは地域ごとの契約で決めます。OpenAIは、計算拠点に必要な送電線や変電設備、電気料金などの費用を自社側で負担する考えも明示しています。
具体例として挙げられたのが、ジョージア州Effingham Countyで計画中の拠点です。Georgia Powerとの合意には最大1,000MWの柔軟な需要応答が含まれ、電力網が逼迫した際に施設側の需要を引き下げる設計です。OpenAIはこの規模を平均約70万世帯の電力需要に相当すると説明しています。拠点自体はまだ開発中で、同社はここをGrid Protectorsの試行例にする考えです。
AIインフラの議論では発電所や送電網の増強が目立ちますが、今回の発表は計算拠点そのものを調整可能な大口需要として扱います。実際の効果は地域の契約、施設設計、電力網の状況で変わります。今後、各拠点で具体的な削減量や運用条件が公開されれば、AI計算資源と地域の電力負担をどう両立させるかを比較する材料になります。
2. NVIDIA Attribution公開、分散AI障害の根本原因を追跡
11月2日、NVIDIAは分散AIワークロードの障害原因を分析する「NVIDIA Attribution」をオープンソースで公開しました。大規模な学習や推論では、1台のGPUやネットワークの不具合が別ノードの通信エラーやスケジューラ状態の変化として連鎖し、最後に表示された例外だけでは発端を特定しにくい場合があります。Attributionは、ワークロード単位でログ、メトリクス、テレメトリ、スケジューラ状態を集め、根本原因、影響ノード、症状、証拠の流れを構造化して返します。
処理は、対象ワークロードの特定、観測情報の収集、イベント抽出と相関、構造化した診断結果の返却という4段階です。判定には決定論的なルールを使うため、同じ証拠から同じ診断を再現しやすく、環境に合わせてルールを調整できます。REST APIを提供するAttribution Serviceと、スケジューラや監視基盤へ接続するPythonのAttribution Blueprintで構成され、SlurmやKueue、KubernetesのPodログ、Loki、PromQLなどへ接続できます。
NVIDIAが示した例では、複数ノードにNCCL通信エラーが出た状況で、特定ノードのNVLink信号品質問題を原因として識別し、ほかの通信エラーは後続症状として残します。同社によると、この仕組みはNVIDIAのAI基盤で以前から使われ、毎週数百万件のワークロードを数十万GPU規模で分析しています。これはNVIDIA自身が示した運用規模です。
運用担当者にとって重要なのは、「どこで処理が止まったか」と「何が最初の原因だったか」を分けて追える点です。診断結果には収集できた証拠の範囲も含まれるため、監視データの不足も確認できます。GPUクラスタが大きくなるほど障害時のログ量も増えるため、原因候補と証拠をワークロード単位でまとめる仕組みは、復旧判断や設備修理の優先順位を付ける材料になります。
3. Salesforce、音声AIのCresta買収で最終契約
11月2日、SalesforceはCrestaを買収する最終契約を締結したと発表しました。Crestaは顧客対応向けの音声エージェントを中心に、通話を最初から最後まで処理するAI、有人担当者へのリアルタイム支援、会話内容の分析を同じ基盤で提供しています。SalesforceはCrestaの音声技術をService Cloudと組み合わせ、会話内容を顧客履歴や業務上の結果へつなげる構想を示しました。
音声エージェントは、テキストのチャットボットよりも応答の間合い、割り込み、聞き取り、リアルタイム処理が重要になります。Crestaは複雑で件数の多い顧客電話を対象にし、AIだけで解決する通話と、人が対応する通話の双方を支援してきました。Salesforce側はCRMにある顧客情報や業務フローを持つため、統合後は「会話を理解するAI」と「顧客情報を使って処理を進める仕組み」を同じサービス領域で扱う狙いです。
現段階は最終契約の締結で、取引完了は規制当局の承認など通常の条件を満たしたうえで2028会計年度第1四半期を予定しています。Salesforceの発表では買収価格を公表していません。取引完了後も、Crestaは顧客が現在利用している主要なコンタクトセンターや電話基盤への対応を継続する予定です。
企業が音声AIを導入するときは、モデルの会話能力に加えて、顧客データ、既存の電話基盤、担当者への引き継ぎ、品質管理を一つの運用として設計する必要があります。今回の契約は、音声エージェントを単独製品として置くより、CRMと顧客対応基盤の中へ組み込む方向をSalesforceが強める動きとして読めます。
4. Anthropic、S-1/Aで約8,954億ドルの計算資源契約を開示
11月2日、Anthropicは米SECへIPO関連の登録届出書「Form S-1」の修正版S-1/Aを提出しました。今回の修正版では2026年9月30日までの9か月業績などが更新され、売上高は332.42億ドルでした。前年同期の25.45億ドルから1,206%増えています。同じ9か月の計算・インフラ費用は188.08億ドルで、売上高の57%に相当します。営業損失は12.60億ドルで、前年同期の52.24億ドルから縮小しました。
計算資源の将来負担も大きなポイントです。Anthropicは2026年9月30日時点およびその後に締結した購入コミットメントやリース契約の合計を約8,954億ドルと記載し、ほぼすべてが計算資源・インフラ関連だと説明しています。このうち約4,475億ドルは2030年末までに発生する見込みで、残りの大半は2031〜2045年、約698億ドルは2026年9月30日後の12か月以内に支払期限を迎える予定です。
約8,954億ドルという数字は、すでに費用計上した金額ではありません。将来にわたる購入契約やリースを含む契約コミットメントです。一方、2026年1〜9月に実際に計上した計算・インフラ費用は188.08億ドルで、前年同期から329%増えました。売上高が急増する一方で、モデル開発や顧客需要を支える計算能力の確保にも大きな資金が必要な構造が数字に表れています。
IPO手続き自体も継続中です。修正版ではNasdaqへの上場申請とティッカー「ANT」が記載されていますが、売り出す株数と想定価格帯は空欄のままです。今回の書類から読めるのは、IPO価格よりも、急成長する売上と計算資源への長期契約を同時に抱える事業構造です。AI企業の規模を比べる際は、モデル性能だけでなく、売上、実際の計算費用、将来の契約義務を分けて見る必要があります。
5. LongCat-2.5公開、視覚理解と長時間エージェントを強化
11月2日、美団のLongCatチームは「LongCat-2.5」を正式公開しました。総パラメータ数は1.6兆で、1トークン当たり約480億パラメータを活性化する構成です。LongCat-2.0を基盤に、画像を扱うネイティブなマルチモーダル能力と、長時間にわたるエージェント型コーディングを強化しました。複雑なコードベースの開発やプロジェクト全体の構築に加え、視覚を使うコーディング、クリエイティブデザイン、3D関連の作業も対象にしています。
強化の中心は、長い作業を最後まで続けるための学習です。長系列学習へ長時間の軌跡データを増やし、大規模な長時間強化学習を組み合わせています。さらに、実際のエージェントが失敗した軌跡を、再現して成否を検証できる学習課題へ変換し、弱点に合わせてデータを追加する方法を説明しています。単発のコード生成より、複数の手順やツール利用が続く開発作業を重視した設計です。
視覚情報は多段階の離散トークンとして表現し、テキストと同じ主幹モデルで処理します。モデル内部で画像と文章を統一したトークン列として扱うことで、画面や画像を見ながらコードや操作を進める用途につなげています。LongCatのAPI変更履歴では、LongCat-2.5は11月2日から利用可能とされ、Claude Code、Codex、Hermesなど複数のエージェント実行環境への対応も案内されています。
LongCat-2.5で注目したいのは、1.6兆という総パラメータ数そのものより、長い作業履歴、失敗事例、視覚入力をエージェント学習へ組み込んだ点です。開発元は複数ベンチマークの結果も公開していますが、今回の記事では順位より学習設計と提供状況を中心に見ました。エージェントを実務へ使う場合、短い質問への正答率だけでなく、長い工程を崩さず進められるかが評価軸になってきています。
まとめ
今日の5本からは、AIを使うコストと運用の重心が見えてきます。OpenAIは計算拠点を電力網に合わせて動かす仕組みを打ち出し、Anthropicは売上成長と同時に長期の計算資源契約を抱える事業構造を開示しました。モデルを動かす電力と計算能力が、技術戦略そのものになっています。
一方、NVIDIA Attributionは大規模GPU環境の障害原因を追う道具を公開し、SalesforceはCrestaの音声エージェントをCRMへ結び付ける契約を進めています。LongCat-2.5は、視覚と長時間の作業履歴を取り込んだエージェント設計を前面に出しました。AIを比較するときはモデル単体の性能だけでなく、電力、運用、顧客データとの接続、計算資源、長い工程を支える学習設計まで見ると、実際の導入条件を具体的に判断できます。
今日の注目アイテム
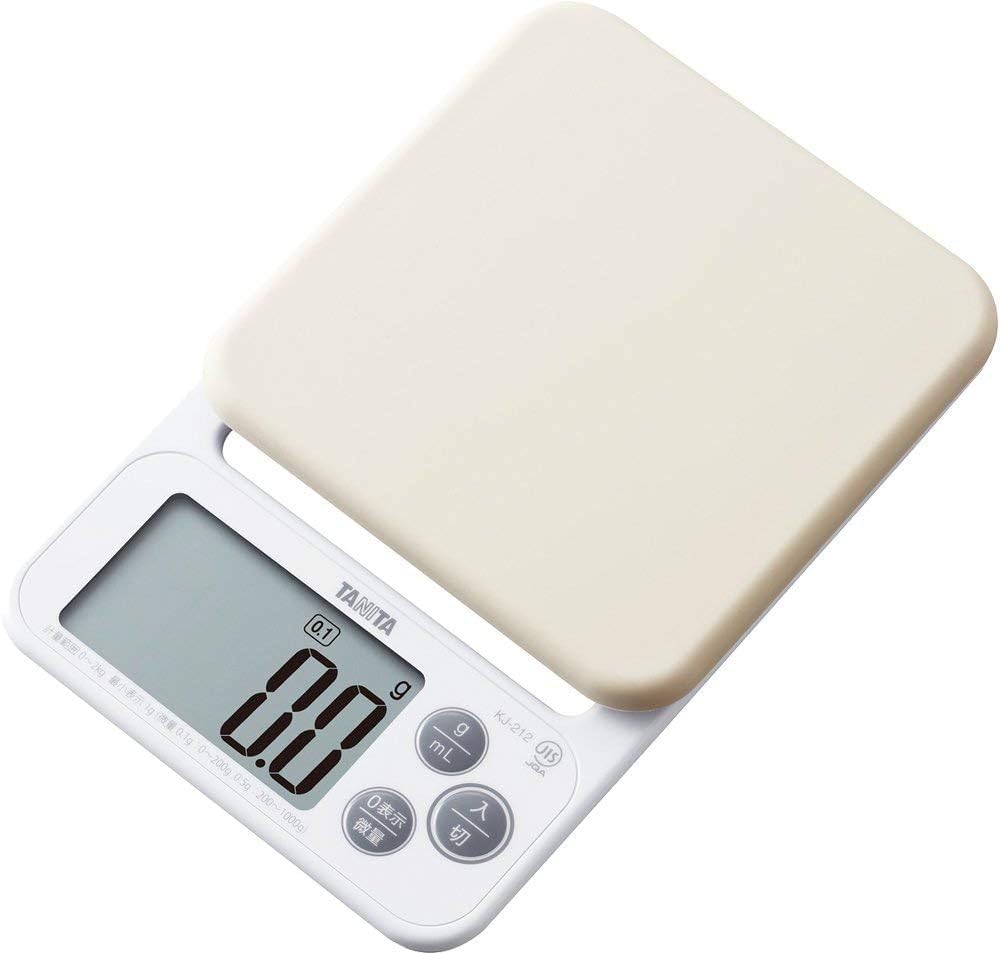

タニタのクッキングスケールで、0.1gから2kgまで計量できます。シリコンカバーとフック穴を備えた、ホワイトのデジタルはかりです。
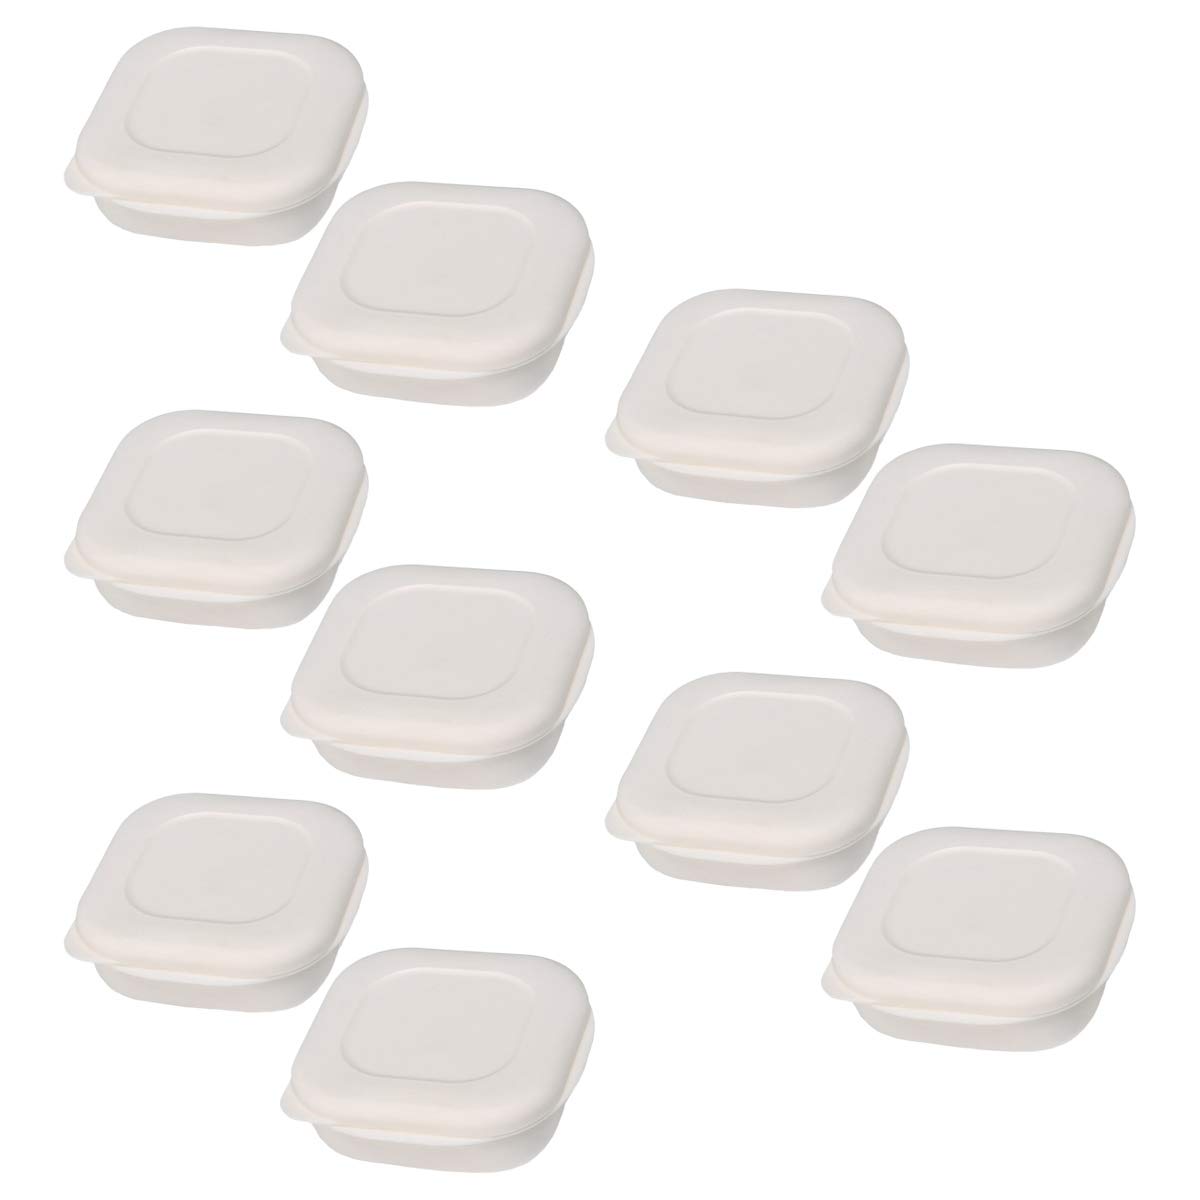

マーナの「極 冷凍ごはん容器2個入り」は、ホワイトのK748Wで5個セットとして掲載されています。 保存容器・キャニスターに分類されているキッチン用品です。
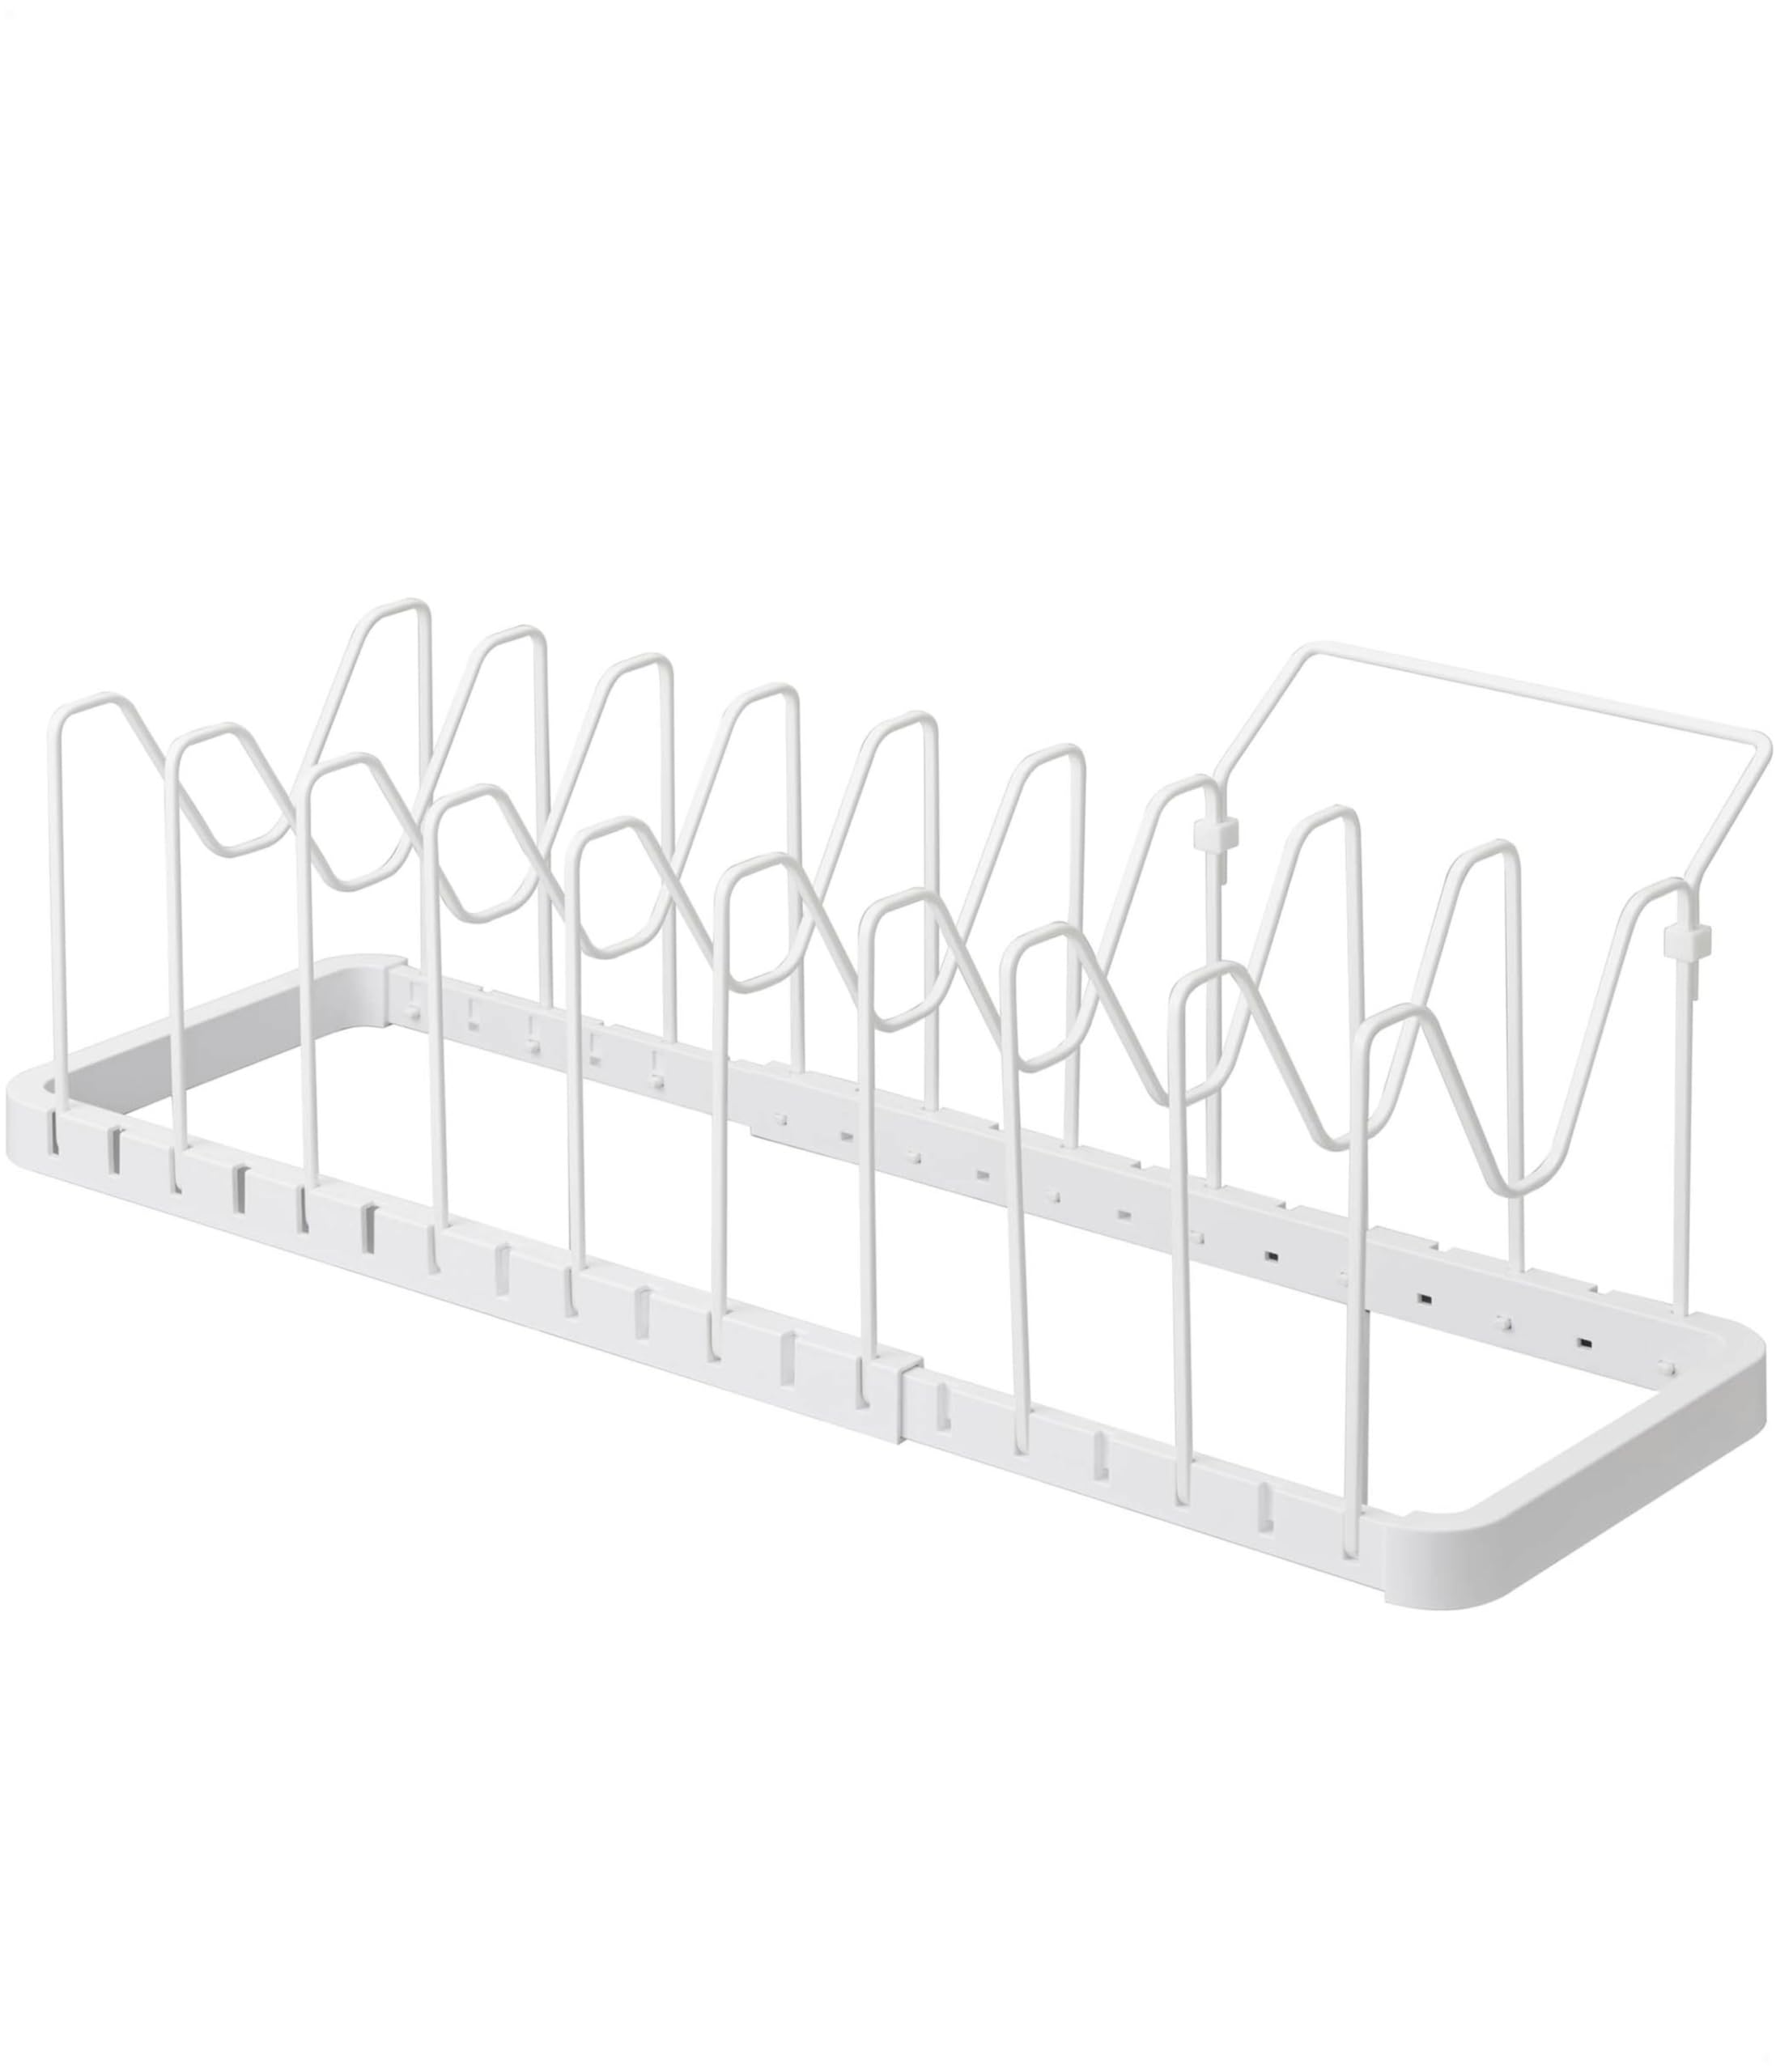

山崎実業のtowerシリーズに掲載されている、ホワイトのシンク下用伸縮鍋蓋・フライパンスタンドです。 サイズは約幅45〜82×奥行20×高さ17.5cmで、シンク下収納に分類されています。