当サイトではアフィリエイト広告を利用しています。
今日のAIニュース5選
AIに任せる仕事が増えるほど、「速く判断できること」と「判断を任せてよいこと」は別の問題になってきます。
Microsoftは、文章を生成せず、分類や振り分けの結果を返す「Microsoft-Decision-1」を公開しました。Cloudflareも、テキストだけでなく画像・音声・動画をまとめて判定する「Clef-omni」を追加し、軽量モデルの価格と速度を見直しています。
研究分野では、AIモデルの重みを変えず、外部に保存したルールを更新して未知のゲームを解く「Memento 3」が発表されました。一方、UC Berkeleyなどの研究チームは、ChatGPTの支援を受けた後にツールを取り上げると、問題を解き続ける力が低下したという実験結果を公表しています。
さらに米国では、上院議員らがAIデータセンターの電力設備や税優遇を調査し、企業と地域住民の費用負担をめぐる論点を示しました。
今日はこの5本から、専用モデルの高速化、経験を学ぶエージェント、人間の学習、そして計算基盤の社会的コストまで、AIを実際に使い続けるうえで考えるべきことを整理します。
1. Microsoft「Decision-1」公開 文章を作らず、選択肢の判断を高速化
Microsoftは10月9日、分類や評価に特化した「Microsoft-Decision-1」を発表し、Microsoft Foundryで利用できるようにしました。
一般的な大規模言語モデルは、回答を文章として少しずつ生成します。しかし業務システムには、長い文章が必要ない処理も大量にあります。問い合わせを担当部署へ振り分ける、危険な操作か確認する、作業をどのエージェントに任せるか選ぶ、といった判断です。
Decision-1では、入力された文章やJSONと、あらかじめ決めた質問・選択肢を渡します。すると、各選択肢の確率や段階的な評価を構造化された数値として返します。自由な文章や長い判断理由を生成するモデルではありません。
基盤にはQwen3.5-9Bを使用しています。Microsoftは、学習時に見せていない問題を含む36種類、約15万問の評価で、比較対象の中で高い正確さを示したと説明しています。応答の遅延も同社測定ではGPT-6 Solより約35倍小さいとしています。ただし、これはMicrosoftが用意した判断タスク上の比較であり、一般的な文章生成の速度や総合性能を比べたものではありません。
料金は入力100万トークンあたり0.042ドルで、出力トークンの料金は無料と案内されています。確率や選択結果を返す仕組みなので、通常の文章生成APIとは費用構造も異なります。
Microsoft Foundryでデプロイして利用でき、将来的にはOpenRouterでの提供も案内されています。実際の運用では、モデルが示す確率の精度を自社データで確認し、一定以下の確信度なら人間へ確認を回す設計が必要です。
すべての仕事に高性能な生成モデルを呼び出すのではなく、「判断だけ」を専門モデルへ任せる選択肢が、企業向けのクラウド基盤にも加わりました。
2. Cloudflare「Clef-omni」公開 画像・音声・動画を一度に判定
Cloudflareは10月9日、判断専用モデル群「Clef」に、マルチモーダル対応の「Clef-omni」を追加しました。
Clef-omniが扱えるのは、テキスト、画像、音声、動画の4種類です。たとえば家電の点検なら、製品ラベルの写真、動作音の録音、ファンの動画を一つのリクエストへまとめ、「ラベルが読めるか」「異音がするか」「ファンが動いているか」を同時に判定できます。
従来なら画像認識、音声の文字起こし、映像の解析を別々のモデルにつなぐ構成になりがちでした。Clef-omniは複数の入力形式を直接受け取り、必要な判断を一度に返すことを狙っています。基盤にはQwen3-Omni-30B-A3B-Instructを使い、自由な文章を出力する部分を省いて判定へ特化させています。
Cloudflareの計測では、テキストだけの判定は中央値で約130ミリ秒、画像は約150ミリ秒、音声付きの21秒の動画を使った判定は約1.5秒でした。いずれも同社が示した測定条件の値で、実際のファイルサイズや環境で変わります。
あわせて、軽量モデル「Clef-flash」の入力料金を100万トークンあたり0.09ドルから0.038ドルへ引き下げました。ただし、ホスト版Clef-flashのコンテキスト長は64Kから24Kへ縮小しています。低価格化だけを見て、長文の処理条件を見落とさないことが重要です。
Clef-omni自身は入力100万トークンあたり0.15ドルで提供され、モデルウェイトも公開されています。元のClefについては推論基盤の改善で処理を最大約2倍高速化したと説明しています。
MicrosoftのDecision-1がテキストや構造化データの判断を中心にするのに対し、Clef-omniは映像や音まで含めた現場の判定へ対象を広げています。生成しないAIも、用途別に細かく進化しています。
3. 「Memento 3」研究公開 モデルを再学習せず、ルールを更新して未知のゲームを解く
University College Londonなどの研究者らは10月8日、AIエージェントが経験から環境のルールを学ぶ研究「Memento 3」を論文として公開しました。
一般に、AIの能力を高めると聞くと、モデルの重みを再学習する方法を想像しがちです。しかしMemento 3では、基になる言語モデルを固定したまま、エージェントが外部に持つ「ルールブック」を書き換えて学習を進めます。
たとえば、初めて遊ぶゲームでは、どの操作で物体が動くか、何が障害物か、どうすれば得点になるかを最初から知りません。エージェントは操作して結果を観察し、「この操作をすると次に何が起きるか」という仮説を自然言語のルールとして記録します。
さらにそのルールを実行可能なコードへ変換し、予測と実際の動作を比べます。予想が外れればルールを修正し、新しいコードで再び試す。この循環を繰り返すことで、基盤モデルそのものを更新せず、経験から使える世界モデルを作ります。
研究チームの報告では、ARC-AGI-3の公開された25ゲームですべてのステージをクリアし、相対的な人間の操作効率を表すRHAEは平均100.0でした。操作回数は人間の基準値の44%に相当します。またAtari Pongの事例では、学習した制御コードだけを使い、評価中に言語モデルを再び呼び出さずに3試合を21対0で勝利したとしています。
ただし、これらは論文で報告された公開課題と特定のゲームでの結果です。あらゆる初見の仕事で人間を超えた、あるいはAIが汎用的に自己改良できることを示すものではありません。
エージェントの長時間作業では、同じ失敗を繰り返さないように知識を残すことが重要になります。Memento 3は、モデルを入れ替える以外にも、経験を検証可能なルールやコードとして蓄積する方法を示しています。
4. UC Berkeley、ChatGPT利用後の学習行動を実験 支援を外すと成績と粘り強さが低下
UC Berkeleyは10月9日、ChatGPTなどのAI支援が、利用者の問題解決や粘り強さへ与える影響を調べた研究を紹介しました。更新された査読付き論文は、同週のConference on Language Modelingで発表されています。
研究チームはオンラインで1,222人を対象とした3つのランダム化比較実験を実施しました。最初の2つでは分数計算の問題、3つ目ではSAT形式の読解問題を使い、AIを使える参加者と使えない参加者を比較しています。
最初の実験では354人が15問の分数問題に取り組みました。AIを使えるグループは当初、正しく答える割合が高かったものの、12問を終えたところでAIを使えなくすると、正答率が低下しました。解答をあきらめたり問題を飛ばしたりする傾向も強まりました。
別の667人の計算実験、201人の読解実験でも、AI支援を取り除いた後に同様の傾向が確認されたとしています。実験では、AIが利用可能な間の正答率だけを見ると、支援による効果を高く評価してしまうことが分かります。
ただし、この研究が示しているのは、短時間AIを使った直後に支援を外した場面での行動です。AIを使うと知能が永久に低下する、仕事でのAI利用がすべて悪い、と結論付けたものではありません。対象の課題と参加者も限定されています。
研究者は、答えを即座に得ることだけでなく、自分で考え抜く過程を残す使い方が重要だと指摘しています。教育や学習では、AIに答えを出してもらう用途と、途中のヒントをもらいながら自分で考える用途を分けることが、今後さらに問われそうです。
5. 米上院議員ら、AIデータセンターの費用負担を調査 電力設備と税優遇が論点に
米国のエリザベス・ウォーレン上院議員ら3人は10月9日、AIデータセンターが地域の電力料金や財政へ与える影響を調べた報告書「Power and Profits」を公表しました。
調査は、Amazon、Google、Meta、Microsoftなど計7社のデータセンター関連企業へ送った質問状と、その後の聞き取りなどを基にしています。議員側は、データセンターに対応する設備の費用が一般家庭や地域へ転嫁される可能性や、企業が税優遇を求め続けていることを問題視しています。
争点の一つは「電力の費用を誰が負担するか」です。企業側は自社施設だけのために設ける設備の費用を負担する考えを示す一方、周辺地域も利用する送電設備や電力網全体の更新費用については、ほかの利用者と分担する立場を取っています。
議員側は、データセンターがなければ必要にならなかった設備まで一般家庭が負担するのは公平ではないと主張しています。一方、共有インフラの更新費用をどこまで特定企業へ割り当てるべきかは、地域の電力制度や投資の恩恵も踏まえて判断が分かれる問題です。
報告書は、土地や電力会社との契約で秘密保持契約が使われ、住民が計画を知る機会が限られることや、税優遇の見返りとして生まれる恒久的な雇用の数が十分に示されていないことも指摘しました。
ここで注意したいのは、これらが3人の議員による調査と評価だという点です。報告書が示した問題を、すべての企業や施設で費用転嫁が確定した事実として扱うことはできません。
AIモデルが高速化しても、利用量が増えればデータセンター、電力、冷却設備への需要は続きます。AIをどれほど安く使えるかだけでなく、社会全体でその基盤をどう支えるかという問題も、技術競争と切り離せなくなっています。
まとめ
MicrosoftとCloudflareは、長い文章を生成せず、必要な判断をすばやく返す専用モデルを前へ進めました。一方、Memento 3は、モデルの重みを変えなくても経験をルールとして保存し、次の行動へ活用できることを示しています。
使う人の側では、UC Berkeleyの実験が、AIの支援を受けている間の成果と、支援なしで自分の力を発揮することを分けて考える必要性を示しました。米国のデータセンター調査からは、AIを動かす物理的な設備の費用を誰が負担するかという課題が見えてきます。
AIへ多くを任せられるようになるからこそ、どの判断を専門モデルへ渡すか、人が何を学び続けるか、どこまでの負担を社会で分かち合うかを考える必要があります。速さや性能だけでは測れない部分まで、AI活用の設計が広がっています。
今日の注目アイテム
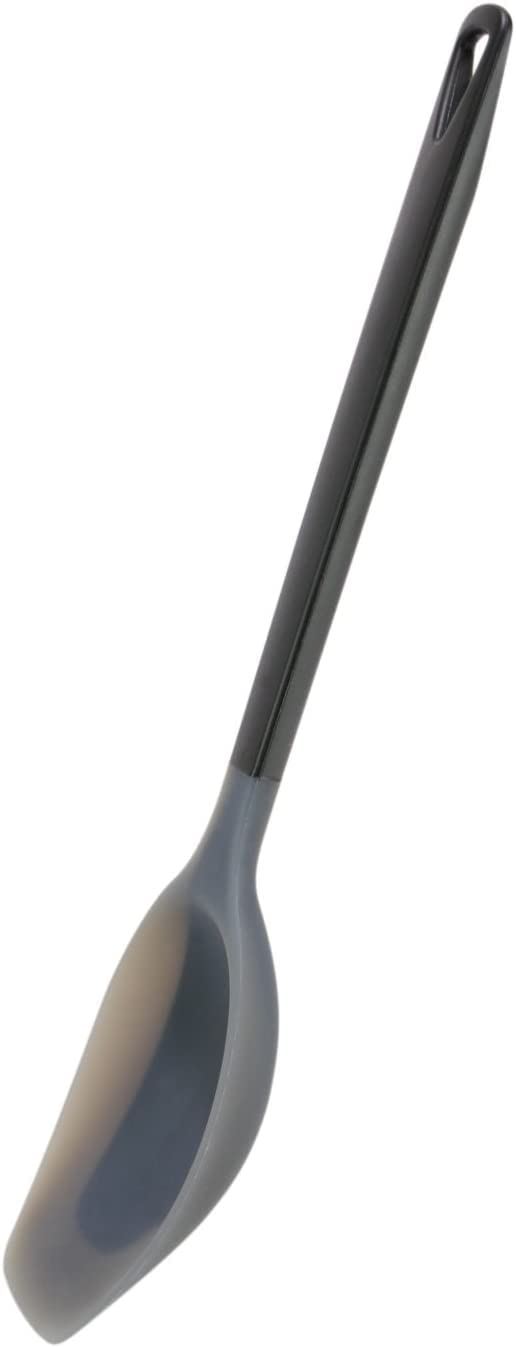

マーナのトライアングリップ シリコーン調理スプーンは、ブラックカラーの商品です。 へら・スパチュラに分類されるキッチン用品として掲載されています。

山崎実業のtowerシリーズに掲載されている、ホワイトのシンク下用伸縮鍋蓋・フライパンスタンドです。 サイズは約幅45〜82×奥行20×高さ17.5cmで、シンク下収納に分類されています。

マーナの「極 冷凍ごはん容器2個入り」は、ホワイトのK748Wで5個セットとして掲載されています。 保存容器・キャニスターに分類されているキッチン用品です。
公式情報・参照先
- Microsoft:Introducing Microsoft-Decision-1, our model for fast decision-making
- Microsoft Learn:Deploy and use Microsoft-Decision-1 in Microsoft Foundry
- Cloudflare:Introducing Clef-omni with full multimodality, plus a faster Clef and a cheaper Clef-flash
- Hugging Face Papers:Memento 3: Model-Based Recursive Self-Improvement through Reflective Rulebooks
- UC Berkeley:Using AI for just 10 minutes erodes your ability to persist at hard things
- Senator Elizabeth Warren:AI Data Center Companies Reveal They Are Not Paying Their Full Costs