当サイトではアフィリエイト広告を利用しています。
Googleは2026年9月22日、Gemini 3.8 Flash TTSとGemini 3.8 Flash-Lite TTSを一般提供しました。
今回のTTSは、用意された声から選んで文章を読み上げるだけではありません。自然言語で新しい声を設計する「Voice Design」、本人の音声サンプルから声の特徴を再現する「Voice Replication」、演技・速度・アクセントなどの細かな指示まで扱えます。
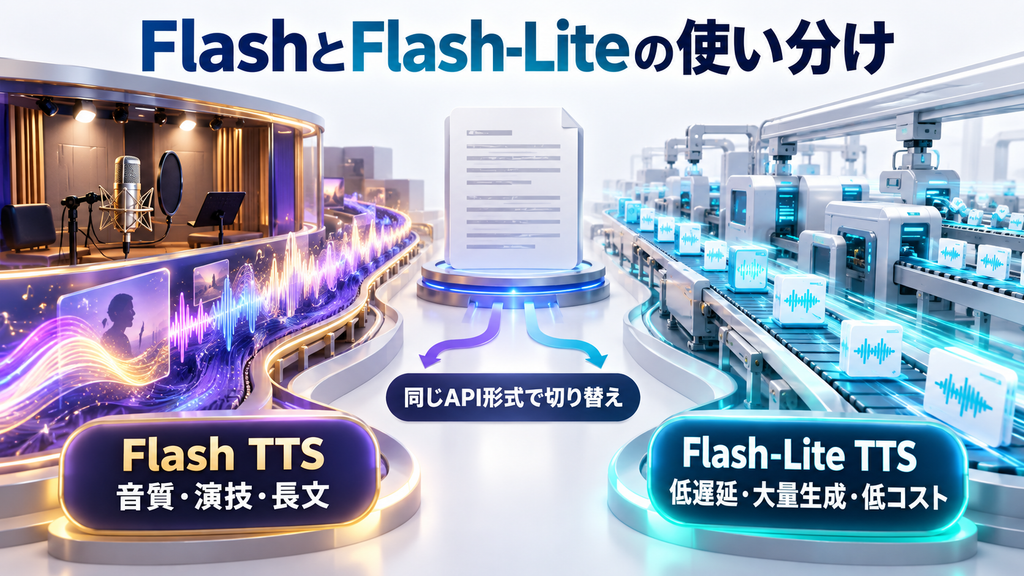
結論から言うと、音質や演技の細かさを優先するならFlash、低遅延・大量生成・コストを優先するならFlash-Liteという役割分担です。
日本語にも対応しており、ナレーション、動画、ポッドキャスト、ゲーム、音声エージェントなどが主な利用先になります。一方、声の複製では本人の同意録音が必要で、料金は2027年1月1日から現在の優遇価格より上がる予定です。
この記事では、Gemini 3.8 Flash TTS / Flash-Lite TTSの違い、Voice DesignとVoice Replication、日本語対応、料金、商用利用時に確認したい条件を整理します。
- Gemini 3.8 Flash TTSとFlash-Lite TTSの違い
- 通常のGemini 3.8 Liveとは役割が違う
- 声は「既成音声・設計・複製」の3つから選べる
- Voice Designは文章から再利用できる声を作る
- Voice Replicationは10〜30秒の参照音声と本人の同意録音が必要
- 日本語に対応|実利用ではFlashとFlash-Liteで差も出る
- 料金は2026年末まで優遇価格、2027年から上がる
- 商用利用では声・コンテンツの権利確認が必要
- 業務利用では無料枠と有料枠のデータ取り扱いが異なる
- 生成音声にはSynthIDが入る
- FlashとFlash-Liteは用途で選ぶ
- まとめ
- 公式情報・参照先
Gemini 3.8 Flash TTSとFlash-Lite TTSの違い
Gemini 3.8 TTSには、用途の異なる2つのモデルがあります。
| 項目 | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS |
|---|---|---|
| モデルID | gemini-3.8-flash-tts | gemini-3.8-flash-lite-tts |
| 主な役割 | 音質、演技、方言、長文の安定性を重視 | 高スループット、低遅延、低コストを重視 |
| 向く用途 | ナレーション、オーディオブック、演技を伴う会話、難しい発音 | 大量の読み上げ、日常的な音声生成、音声エージェントのカスケード |
| 対応言語 | 130言語超 | 100言語超 |
| Voice Design | 対応 | 対応 |
| Voice Replication | 対応 | 対応 |
| 2026年末までの標準出力料金 | 100万音声トークンあたり9ドル | 100万音声トークンあたり6ドル |
Flashは、音声の忠実度、ニュアンスのある演技、地域ごとのアクセントや方言、長いナレーションでの安定性を重視したモデルです。
Flash-Liteは、同じAPI形式を使いながら、処理速度とコストを優先しています。モデル名を切り替えるだけで両方を試せるため、実際の台本を同じ条件で生成して選ぶ使い方もできます。
通常のGemini 3.8 Liveとは役割が違う
Gemini 3.8 Flash TTSは、リアルタイム会話用のGemini 3.8 Liveとは別の用途です。
TTSは、用意した文章を意図した声・演技で音声化することが中心です。台本を正確に読み上げながら、話し方や演技を細かく制御したい制作物に向いています。
一方、Gemini 3.8 Liveは、人と会話しながら入力を理解し、その場で返答するリアルタイム対話が中心です。
- 動画ナレーションを作る → TTS
- ポッドキャストの台本を音声化する → TTS
- ゲームのキャラクターボイスを作る → TTS
- 人とリアルタイムで会話する音声AIを作る → Live API
という用途ごとの使い分けができます。
Gemini 3.8 Liveについては、非同期ツール実行やExtended Thinkingも含めて別の記事で整理しています。
声は「既成音声・設計・複製」の3つから選べる
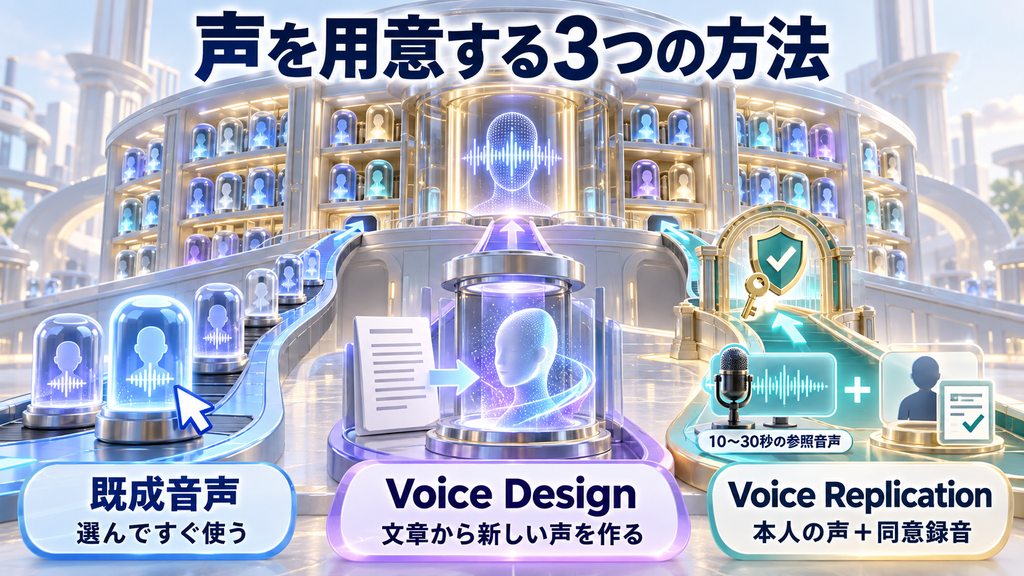
Gemini 3.8 TTSでは、声の用意方法を大きく3つに分けられます。
既成の音声を使う
用意されている音声から選び、台本や演技指示を渡す方法です。
最初から新しい声を作る必要がなく、読み上げや試作をすぐ始めたい場合に向いています。
Voice Designで新しい声を作る
Voice Designでは、自然言語で声の人物像や特徴を説明すると、新しい音声ペルソナを生成できます。
たとえば、年齢感、声質、アクセント、話し方の基本的な雰囲気などを文章で指定し、作成した声をvoice_...形式のIDとして保存できます。
Voice Replicationで実在する人の声を再現する
Voice Replicationでは、短い参照音声から、その話者の声の特徴を再現します。
こちらは単なる音声アップロードでは使えません。同じ成人話者による参照音声と、本人が所定の同意文を読み上げた同意音声の2つが必要です。
Voice Designは文章から再利用できる声を作る
Voice Designは、実在する人の録音を用意せず、テキストから新しい声を作る機能です。
年齢、声の温かさ、アクセント、話し方などを自然言語で説明し、生成された声を試聴してから保存できます。
保存した声にはvoice_...形式のIDが付与され、別の読み上げリクエストでも再利用できます。
これは、
- 動画シリーズで同じナレーターを使う
- ゲームや音声作品でキャラクターの声を固定する
- サービス専用のブランドボイスを作る
といった用途と相性があります。
現在の仕様では、Voice Designと後述するVoice Replicationを合わせて、1プロジェクトにつき保存できるステートフル音声は200個、保存期間は1年です。
そのため、長期間同じ声を使い続けるサービスでは、1年の有効期間も運用条件に含めておく必要があります。
Voice Replicationは10〜30秒の参照音声と本人の同意録音が必要
Voice Replicationは、実在する話者の音声特徴を短いサンプルから複製する機能です。
Gemini 3.8 Flash TTSとFlash-Lite TTSの両方が、現在の公式ドキュメントではVoice Replicationに対応しています。
作成時には、同じ成人話者による次の2つの録音が必要です。
- 参照音声:10〜30秒のクリアで自然な音声
- 同意音声:同じ本人がGoogle指定の同意文を読み上げた音声
日本語の同意文も公式ドキュメントに用意されています。
参照音声と同意音声は、本人確認を通しやすくするため、同じマイク・同じ録音環境で収録することが推奨されています。
保存方法は2種類ある
Voice Replicationには、2つの保存方式があります。
| 保存方式 | 識別子 | 保存期間 | 主な特徴 |
|---|---|---|---|
| ステートフル | voice_... | 1年 | Google側のプロジェクトへ保存して繰り返し利用 |
| ステートレス | voicekey_... | 7日 | 暗号化されたキーを利用側で管理し、サーバー側へ長期保存しない |
ステートフル音声は、Voice DesignとVoice Replicationを合わせて1プロジェクト200個までです。
一方、ステートレスでは長期間のサーバー保存を避けられますが、キーの有効期間は7日なので、用途によって選ぶ必要があります。
日本語に対応|実利用ではFlashとFlash-Liteで差も出る
Gemini 3.8 Flash TTS、Flash-Lite TTSともに日本語へ対応しています。
Flashは130言語超、Flash-Liteは100言語超に対応し、どちらの公式対応言語一覧にも日本語が含まれています。
Googleは、発音、アクセント、演技、長文での安定性を改善点として挙げていますが、実際の品質は台本、選ぶ声、演技指示、固有名詞などによって変わります。
公開直後の日本語での個人検証でも、傾向は一様ではありません。
ある検証では、日本語58本を生成し、既成音声では高い読み取り精度を確認した一方、人名の読みではFlashの方がFlash-Liteより安定したと報告されています。初回音声が返るまでの時間は、その環境ではFlash-Liteの方が短いという結果でした。
Voice Replicationについても、本人が「ほぼ自分」と感じたという検証がある一方、別の比較では他サービスの方が元の声に近いと評価されています。
このため、日本語への対応可否と、自分の声・台本でどこまで自然に聞こえるかは別の確認項目です。 特に音声複製は、参照音声の録り方や話者との相性も含めて実際に試す必要があります。
文字起こし側のGemini 3.5 Transcribeについては、こちらの記事で日本語対応や料金を整理しています。
料金は2026年末まで優遇価格、2027年から上がる
2026年9月29日時点のGemini Developer APIでは、Flash TTSとFlash-Lite TTSに2026年12月31日までの価格と、2027年1月1日以降の価格が設定されています。
標準料金は次のとおりです。
| モデル | 料金区分 | 2026年12月31日まで | 2027年1月1日から |
|---|---|---|---|
| Flash TTS | テキスト入力 / 100万token | 0.50ドル | 1.00ドル |
| Flash TTS | 音声出力 / 100万token | 9.00ドル | 18.00ドル |
| Flash TTS | 10秒の音声出力換算 | 0.00225ドル | 0.0045ドル |
| Flash-Lite TTS | テキスト入力 / 100万token | 0.50ドル | 1.00ドル |
| Flash-Lite TTS | 音声出力 / 100万token | 6.00ドル | 12.00ドル |
| Flash-Lite TTS | 10秒の音声出力換算 | 0.0015ドル | 0.003ドル |
音声トークンは、公式料金表では1秒あたり25tokenとして換算されています。
実際の請求額は、入力テキストやAPIの使い方によっても変わります。個人検証では、公式換算より実際の音声token消費が多かったという報告もあるため、大量生成する場合は少量で試し、請求履歴から実際のtoken消費と費用を確認してから規模を広げると見積もりとの差を把握できます。
商用利用では声・コンテンツの権利確認が必要
Gemini APIの現行規約では、Googleは生成されたコンテンツの所有権を主張しないとしています。
生成した音声についても、規約と適用法を守ったうえで利用することになります。少なくとも、Gemini 3.8 TTSの生成物を「商用利用だから一律に禁止する」という規定は、現在のGemini API追加利用規約では確認できません。
一方で、生成した音声をどのように使うか、その音声に必要な権利を持っているかは利用者側で確認する必要があります。
特にVoice Replicationでは、
- 自分自身の声
- 利用する権利を持っている声
- 本人の同意を得た声
を使うことが前提です。
著名人や第三者の声を無断で複製してよい機能ではありません。Google側にも同意確認が組み込まれていますが、利用地域の法律、契約、出演者・声優などとの権利関係は別途確認が必要です。
業務利用では無料枠と有料枠のデータ取り扱いが異なる
Google AI StudioやGemini APIの無料枠では、入力したコンテンツと生成結果がGoogleの製品・サービスや機械学習技術の改善に使われます。また、品質改善のために人間のレビュアーがAPIの入出力を確認・処理する場合があります。
Googleは無料サービスへ、プライベート情報、機密情報、個人情報を送信しないよう案内しています。
Cloud請求先アカウントを有効にした有料サービスでは、プロンプトと回答をGoogleの製品改善には利用しないと明記されています。
仕事の未公開台本、顧客情報を含む音声、社内資料などを扱う場合は、音声品質だけでなく無料枠と有料枠のデータ取り扱いの違いも判断条件になります。
生成音声にはSynthIDが入る
Googleは、Gemini Audioモデルから生成されるすべての音声出力にSynthIDを付与すると説明しています。
SynthIDは、AI生成コンテンツへ人には知覚しにくい電子透かしを埋め込む仕組みです。
Gemini 3.8 TTSでは、Voice Replicationの同意確認だけでなく、生成された音声にもAI生成であることを検出するための仕組みが入っています。
音声複製や自然な読み上げの品質が高くなるほど、誰の声を使ったか、本人の同意をどう記録するか、AI生成音声としてどう扱うかまで管理対象になります。
FlashとFlash-Liteは用途で選ぶ
選択基準は、音質・演技を優先するか、速度・量・コストを優先するかです。
Flash TTSが向く用途
- ナレーションやオーディオブック
- キャラクターの演技を細かく作りたい
- 難しい固有名詞や発音を重視する
- 地域のアクセントや方言を使いたい
- 長い音声で声質や雰囲気を安定させたい
Flash-Lite TTSが向く用途
- 大量の動画や記事を音声化する
- 音声生成コストを抑えたい
- 応答開始までの時間を短くしたい
- 音声エージェントの読み上げ部分へ組み込みたい
- 高トラフィックなサービスで大量生成する
品質が重要な部分だけFlash、量が多い日常的な生成はFlash-Liteという分け方もできます。API形式が共通なので、同じ台本で生成結果とコストを比較して選べます。
まとめ
Gemini 3.8 Flash TTS / Flash-Lite TTSを選ぶときは、まず音質・演技を優先するか、速度・量・コストを優先するかでモデルを決めます。前者ならFlash、後者ならFlash-Liteが基準です。
次に、声の作り方を選びます。既成音声ですぐ始める、Voice Designで新しい声を作る、Voice Replicationで本人同意のある声を再現する、という3つの方法があります。
最後に運用条件を確認します。2027年1月1日からの料金改定、ステートフル/ステートレス音声の保存期間、無料枠と有料枠のデータ取り扱い、声やコンテンツの権利、SynthIDの付与まで確認すれば、用途に合う構成を決められます。
モデル選び、声の作り方、運用条件の3段階で判断すると、品質だけでなくコストや権利面まで含めて選べます。
公式情報・参照先
- Google「Gemini 3.8 text-to-speech says hello」
- Google AI for Developers「Gemini API リリースノート」
- Google AI for Developers「テキスト読み上げ(TTS)」
- Google AI for Developers「Gemini 3.8 Flash TTS」
- Google AI for Developers「Gemini 3.8 Flash-Lite TTS」
- Google AI for Developers「音声デザイン」
- Google AI for Developers「音声の複製」
- Google AI for Developers「Gemini Developer API pricing」
- Google AI for Developers「Gemini API 追加利用規約」
- Google DeepMind「Gemini Audio」
- Takuyaの生成AIラーニングラボ「Gemini 3.8 Flash TTSを日本語で58本作って検証」
- META-MARK「Gemini 3.8 Flash TTSを実測:1分約2.6円で声は本人か」
- Zenn「Gemini 3.8 Flash TTSの声クローンをFish Audioと聴き比べた」