OpenAIは2026年9月10日、AIエージェントを長時間動かすための「Agents API」を公開ベータとして提供開始しました。
特徴は、モデルを呼び出すだけのAPIではなく、Codexで使われているエージェントのハーネスをOpenAI管理のサービスとして利用できることです。
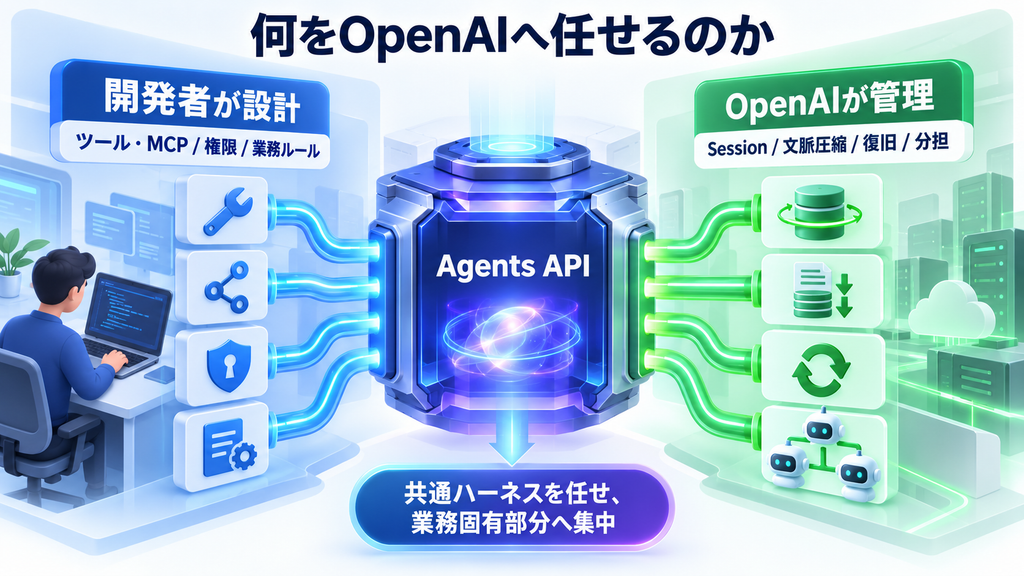
セッションの継続、コンテキスト圧縮、復旧、ツール利用、MCP接続、サブエージェントへの分担など、長時間動くAIエージェントで必要になる基盤をOpenAI側へ任せられます。一方、どのツールを与えるか、どの実行環境を使うか、どこまでネットワークへ接続させるかは開発者側で設計します。
この記事では、Agents APIで何が自前実装から減るのか、Codexとの関係、OpenAI-hosted sandboxと自前環境の違い、MCP・マルチエージェント、料金、データ保持で確認したい点まで整理します。
- Agents APIは「Codexの実行基盤」をAPI化したもの
- Agents APIの中心は「継続できるSession」
- コンテキスト圧縮と復旧を自前で持たなくてよくなる
- MCP・Web検索・カスタム関数を同じエージェントへ接続できる
- サブエージェントへの分担も管理ハーネスに含まれる
- 実行環境はOpenAI管理だけに固定されない
- OpenAI-hosted sandboxはネット接続の範囲を設定する
- Agents APIの利用料そのものは追加されない
- Agents SDKとの違いは「誰がハーネスを運用するか」
- Self-hostedでもAgents APIのデータ保持条件は別に残る
- Agents APIで自前実装が不要になるもの・残るもの
- まとめ
- 公式情報・参照先
Agents APIは「Codexの実行基盤」をAPI化したもの
AIエージェントを作るときは、モデルへプロンプトを送るだけでは足りません。
長い仕事を任せるほど、
- 会話や作業状態をどこに保存するか
- コンテキスト上限へ近づいたらどう圧縮するか
- 実行途中で失敗したらどう復旧するか
- ファイルやコマンドをどこで実行するか
- 多数のツールから必要なものをどう選ぶか
- 複数のサブエージェントへどう分担するか
- 作業途中の進捗や人の確認をどう扱うか
といった「モデルの外側」の仕組みが必要になります。
Agents APIでは、この部分にCodexと同系統の管理ハーネスを使います。
OpenAIが管理する主な範囲は、セッション、オーケストレーション、コンテキスト圧縮、復旧です。開発者はモデル、指示、ツール、MCP Server、実行環境などを指定してエージェントを構成します。
| 項目 | Agents APIでの役割 |
|---|---|
| モデル・指示 | 開発者が選ぶ |
| ツール・MCP | 開発者が設定する |
| セッション管理 | OpenAIが管理 |
| コンテキスト圧縮 | OpenAIが管理 |
| オーケストレーション | OpenAIが管理 |
| 復旧・継続 | OpenAIが管理 |
| 実行環境 | OpenAI管理・自前・提携環境から選ぶ |
| 権限・ネットワーク方針 | 開発者が設計する |
つまり、AIエージェントの業務ロジックまでOpenAIへ丸投げする仕組みではありません。長時間エージェントを動かすための共通基盤をサービスとして使い、自分のアプリ固有のツール・データ・ルールへ集中するためのAPIです。
Agents APIの中心は「継続できるSession」
Agents APIでは、Sessionがエージェント実行の中心になります。
Sessionは1回の質問と回答で終わるものではなく、同じエージェントがタスクを続け、途中経過を残しながら次の入力を受け取れる永続的な単位です。
基本的な流れは、
- Sessionを作成する
- タスクを渡す
- ストリーミングやWebhookで進捗を受け取る
- 必要なら途中で追加指示を送る
- 同じSessionを再利用して仕事を続ける
となります。
長時間の調査、障害対応、コード修正、文書レビューなどでは、毎回ゼロから会話履歴を組み直すより、作業状態を持ったSessionを継続できる方が扱いやすくなります。
OpenAIの公式例でも、インシデント調査、Slack Bot、データ分析、GitHub Issue調査、文書レビューなどが挙げられています。Codex由来のハーネスですが、用途はコーディングだけに限定されていません。
コンテキスト圧縮と復旧を自前で持たなくてよくなる
長時間エージェントでは、会話やツール実行結果が増え続けます。
そのまま全部を次のモデル入力へ積むと、コンテキスト上限に達したり、入力トークンが増えてコストや処理時間が膨らんだりします。
Agents APIは、Sessionがコンテキスト上限へ近づくと過去の内容を自動的に圧縮し、作業継続に必要な情報を残す仕組みを持っています。
さらに、セッション管理と復旧もOpenAI側が担当します。
これは「AIが必ず正しく復旧する」という意味ではありません。アプリ固有の業務状態や外部サービス側のトランザクションまで自動的に元へ戻るわけでもありません。
ただ、エージェントの実行基盤として、長時間セッションを維持し、コンテキストを管理し、途中から仕事を再開するための共通処理を自前で一から作る範囲が減るのが大きな変化です。
MCP・Web検索・カスタム関数を同じエージェントへ接続できる
Agents APIでは、エージェントへ複数種類のツールを持たせられます。
OpenAIが案内している主な接続方法には、
- MCP Server
- カスタム関数
- Web検索などの組み込みツール
- SkillsやPlugins
- サンドボックス内のコマンド・ファイル操作
があります。
多数のツールを最初からすべてコンテキストへ読み込むと、それだけでトークンを消費します。そのためAgents APIでは、必要なツール定義を必要なときに読み込むTool searchも利用できます。
また、Programmatic Tool Callingでは、複数のツール呼び出しを並列実行したり、結果をコードで絞り込んでから必要な情報だけをモデルへ戻したりできます。
AIエージェントでツール数が増えたときに、「全部の仕様を毎回モデルへ渡す」構成から離れられるのがポイントです。
サブエージェントへの分担も管理ハーネスに含まれる
Agents APIにはマルチエージェント機能があります。
メインのエージェントが複雑な仕事を独立した小さな作業へ分け、複数のサブエージェントへ並列に任せ、最後に結果をまとめられます。
各サブエージェントは別のコンテキストを持つため、調査Aの情報で調査Bの文脈を圧迫するといった問題を減らせます。
同時実行数は設定でき、ドキュメントでは有効化した場合のデフォルトが6体と案内されています。コーディネーター本体はこの数に含まれません。
一方、サブエージェントは親エージェントのMCP設定やWeb検索設定、実行環境のファイルを共有します。何を共有させるかという権限設計は引き続き重要です。
実行環境はOpenAI管理だけに固定されない
Agents APIでは、ハーネスをOpenAIへ任せても、エージェントがコードやファイルを扱う実行環境まで必ずOpenAI上へ置く必要はありません。
大きく3つの選択肢があります。
OpenAI-hosted sandbox
OpenAIが用意するLinux環境です。
Python、Node.js、コマンドラインツールを使え、入力ファイルや追加パッケージ、Skills、Pluginsを設定できます。コードを実行したり、ファイルを編集したり、成果物を作ったりする用途をすぐ始めたい場合に向いています。
Self-hosted sandbox
自社インフラなどに実行環境を置き、Agents APIから接続する構成です。
独自のコンテナイメージ、計算資源、社内ネットワーク、既存のファイル基盤を使いたい場合はこちらが合います。
提携サンドボックス
OpenAIはBlaxel、Cloudflare、Daytona、DigitalOcean、E2B、Modal、Oracle、Runloop、Vercelなどとの連携を案内しています。
VPC内で動かしたい、特定のCPU・GPU・メモリ構成を選びたいといった用途に合わせて実行環境を分けられます。
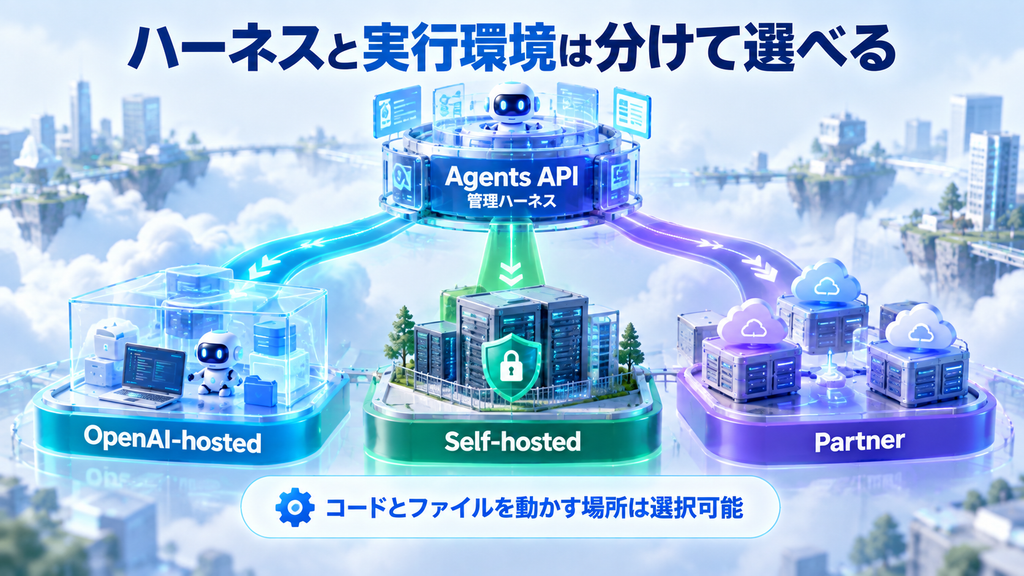
この構造では、ハーネスを誰が管理するかとコードやファイルをどこで実行するかを分離できます。
OpenAI-hosted sandboxはネット接続の範囲を設定する
OpenAI-hosted sandboxを使う場合、ネットワーク設定は確認しておきたい項目です。
現在のドキュメントでは、外向き通信はデフォルトで有効です。
必要に応じて、
enabled:外部通信を許可disabled:外部通信を遮断restricted:指定したホストだけ許可
から選べます。
機密ファイルを処理するエージェントで「サンドボックスだから外部通信もしない」と思い込むと、意図した設計とずれる可能性があります。
サンドボックスは実行環境を隔離する仕組みであり、ネットワークへの接続可否は別に設定する必要があります。
Agents APIの利用料そのものは追加されない
Agents APIは公開ベータとして、全開発者へ提供されています。
OpenAIはAgents API自体に追加料金は設定せず、実際に使ったモデルのトークンとツール、OpenAI-hosted sandboxを使う場合はコンテナ料金を支払う方式と説明しています。
料金を分けると次のようになります。
| 項目 | 課金 |
|---|---|
| Agents APIの利用 | 追加料金なし |
| モデル | 選択したモデルのAPI料金 |
| Web検索などのOpenAIツール | 各ツールの標準料金 |
| OpenAI-hosted sandbox | 標準のコンテナ料金 |
| Self-hosted環境 | 自社・利用先のインフラ費用 |
そのため、「Agents APIを使えばCodex相当のエージェントが定額で使える」という意味ではありません。
長時間セッションや複数サブエージェントを使えば、モデル呼び出しやツール実行も増えます。実運用ではAPI本体の料金より、どのモデルを何回動かすか、何個のサンドボックスやサブエージェントを使うかがコストへ効いてきます。
Agents SDKとの違いは「誰がハーネスを運用するか」
OpenAIには以前からAgents SDKがあります。
Agents SDKも、ツール利用、サンドボックス、メモリ、長時間タスクなどを扱えるエージェント開発基盤です。
Agents APIとの大きな違いは、管理ハーネスの運用主体です。
Agents SDKでは、SDKを自分のアプリケーションへ組み込み、実行方法やインフラ構成を自分で設計します。柔軟性を取りやすい一方、アプリ側で運用する範囲も大きくなります。
Agents APIでは、CodexハーネスそのものをOpenAI管理のAPIとして使い、セッション、オーケストレーション、圧縮、復旧をOpenAIへ任せます。
どちらかが一方的に上位という関係ではありません。
- ハーネスの運用まで任せ、長時間エージェントを早く立ち上げたい → Agents API
- 実行ループやアプリ構成を細かく制御したい → Agents SDK
という違いで見ると選択しやすくなります。
Self-hostedでもAgents APIのデータ保持条件は別に残る
自前のサンドボックスを使う場合でも、Agents APIのすべてが自社環境だけで完結するわけではありません。
Agents APIはOpenAI側でSessionの状態を保持します。現在のドキュメントでは、データレジデンシーは米国のみで、Zero Data Retention(ZDR)には対応していません。
Self-hosted sandboxを選んでも、Agents API自体がZDR対象になるわけではないと明記されています。
機密性の高い業務へ導入するときは、
- 実行ファイルをどこに置くか
- MCPや外部ツールへ何を送るか
- OpenAI側のSessionへ何が残るか
- サンドボックスのネットワークをどう制限するか
- 認証情報をどこで管理するか
を分けて確認する必要があります。
「実行環境が自前だから、すべてのデータが自社内だけに残る」とは限らない点は重要です。
Agents APIで自前実装が不要になるもの・残るもの
Agents APIを使っても、AIエージェント開発そのものが不要になるわけではありません。
OpenAIへ任せやすくなるのは、汎用的な実行基盤です。
OpenAIへ任せやすい部分
- 長時間Sessionの管理
- コンテキスト圧縮
- エージェントのオーケストレーション
- 実行途中からの復旧
- OpenAI-hosted sandboxの用意
- サブエージェントの並列実行
- 進捗イベントやWebhookの基盤
開発者側に残る部分
- 何をAIへ任せるか
- 業務用ツール・MCPの設計
- データやAPIのアクセス権
- ネットワーク制御
- 人の承認を入れる場所
- エージェントの評価・監視
- コスト上限
- 業務上の失敗時にどう戻すか
この境界を見ておくと、Agents APIを「AIエージェントを自動で完成させるAPI」と誤解せずに使えます。
まとめ
OpenAI Agents APIは、Codexで使われている管理ハーネスを開発者向けにAPI化したサービスです。
モデル呼び出しだけでなく、Session、コンテキスト圧縮、復旧、ツール利用、MCP、サブエージェントといった長時間エージェントの基盤をまとめて扱えます。
特に大きいのは、ハーネスをOpenAIへ任せながら、実行環境はOpenAI-hosted、自前環境、提携サービスから選べる点です。
一方、ツール権限、ネットワーク、業務上の承認、評価、データ保持まで自動的に安全になるわけではありません。
AIエージェント開発では、モデル性能だけでなく、長時間仕事を続けるための実行基盤を誰が管理するかも設計項目になっています。Agents APIは、その共通部分を自前実装から外す選択肢です。