AIエージェントへ仕事を任せたい一方で、社内資料やコード、契約書などをクラウドへ送りたくない場面があります。
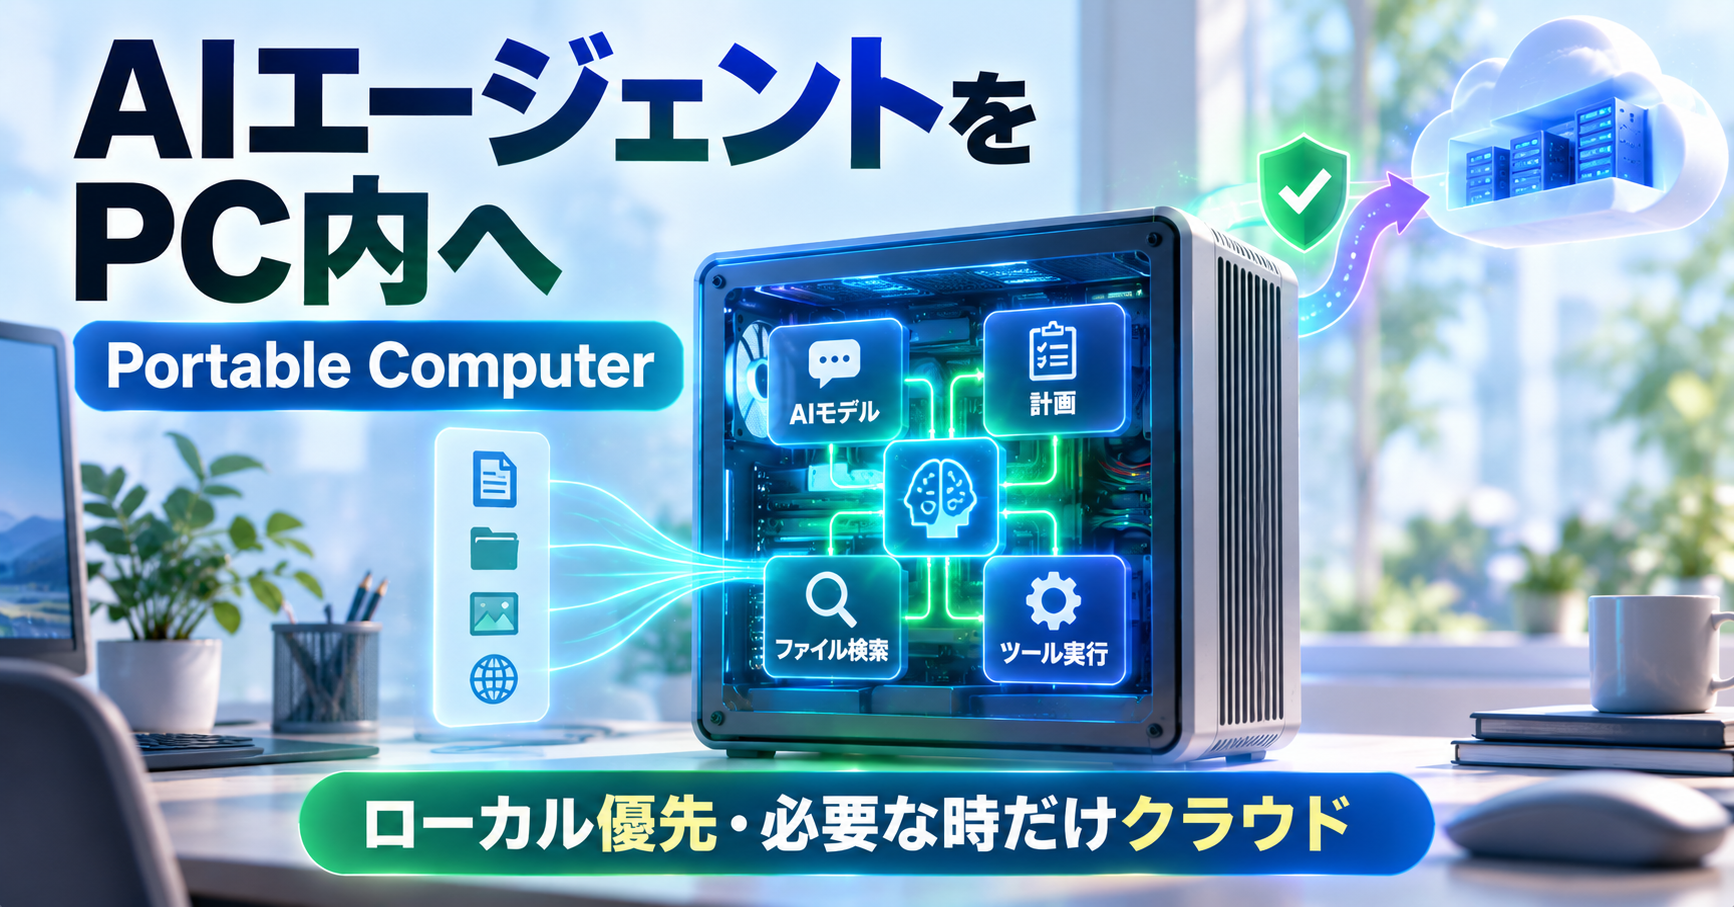
Perplexityが2026年8月25日に公開した「Portable Computer」は、こうした用途を想定したローカルファーストのAIエージェントです。
モデルだけをPC内で動かすのではなく、タスクを分解するオーケストレーター、計画、ツール選択、スケジューラー、ローカル検索まで端末側で動かし、必要な処理だけをユーザーの許可後にクラウドへ送ります。
2026年9月11日時点では、NVIDIA DGX Sparkに加えて、Linux環境のNVIDIA RTX GPUでも24GB以上のVRAMを条件に利用範囲が広がっています。Windows対応はまだ提供前で、NVIDIAは「coming soon」と案内しています。
この記事では、Portable Computerが普通のローカルLLMと何が違うのか、何が端末内に残るのか、クラウドへ出る条件、必要なPC・GPU、Windows対応状況までまとめます。
- Portable Computerは「Perplexity Computerをローカルで動かす」仕組み
- ローカルで完結する処理はクラウドへ送られない
- Web検索や強いモデルが必要なときだけクラウドへ切り替える
- Gmail・Slack・GitHubなどのコネクターも使える
- 使われるローカルモデルは27Bクラス
- DGX Sparkでは128GBのユニファイドメモリを使う
- 一般のNVIDIA RTX PCにも広がっている
- Windows版はまだ「coming soon」
- Perplexity Pro・Max利用者が対象
- OllamaのようなローカルLLM実行環境とは役割が違う
- 「完全ローカル」と「ローカルファースト」は区別したい
- ローカルAIエージェントで確認したい4つの境界
- まとめ
- 公式情報・参照先
Portable Computerは「Perplexity Computerをローカルで動かす」仕組み
Portable Computerは、ノートPCなどの製品名ではありません。
PerplexityのAIエージェント「Computer」を、自分のローカルマシンで動かすためのソフトウェアとモデルの構成です。
通常のPerplexity Computerは、調査、コード作成、ファイル生成、ブラウザ操作、接続サービスの操作などを複数ステップで実行するデジタルワーカーです。
Portable Computerでは、その実行基盤の多くを端末側へ移しています。
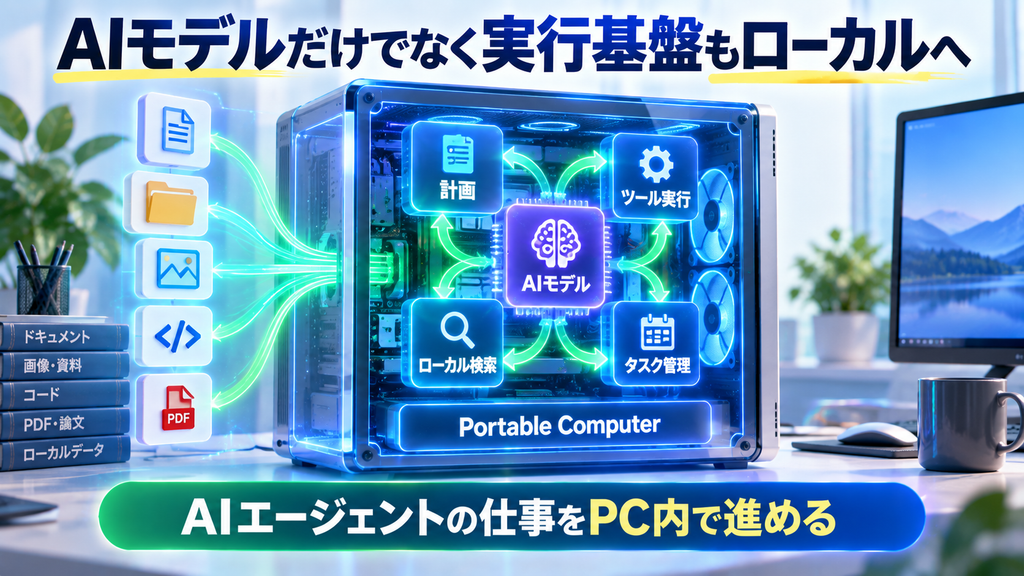
ローカルで動く主な要素は、
- AIモデル
- オーケストレーター
- プランナー
- ツールルーター
- スケジューラー
- 継続タスク用のキュー
- ローカル検索インデックス
- 会話とタスクの実行履歴
です。
つまり「ローカルLLMへ質問する」だけではなく、AIがファイルを読み、作業を計画し、ツールを使い、複数ステップの仕事を進めるところまでローカルで行うのが大きな違いです。
ローカルで完結する処理はクラウドへ送られない
Portable Computerは、端末内で完結できる作業をローカルで処理します。
たとえば、
- ローカル文書の検索・要約
- コードベースの調査
- 複数ファイルの比較
- PC内のデータを使った資料作成
- ファイル操作
- ローカル音声入力
といった作業です。
Perplexityは、モデル、エージェントのハーネス、会話、実行経路を端末側へ置く設計だと説明しています。
ローカルモデルで処理した分はPerplexity側の推論クレジットを消費しません。大量の文書やコードを繰り返し処理したい場合は、クラウドAPIを使う方式とはコスト構造が変わります。
一方、Portable Computerを使えば「一切ネットにつながらない」という意味ではありません。
Web検索や強いモデルが必要なときだけクラウドへ切り替える
ローカルモデルだけでは完結できない仕事では、Portable Computerからクラウド側へ処理をエスカレーションできます。
代表的なのは次のような場面です。
- 最新のWeb情報が必要
- Perplexity Searchを使う
- ブラウザ操作が必要
- 接続アプリへ情報を送る
- ローカルモデルより強い推論モデルが必要
Portable Computerは、必要な処理を自動的に見つけても、そのまま機密情報をクラウドへ送る設計ではありません。
端末からクラウドサービスへ内容を送る必要がある場合は、ユーザーへ許可を求めます。
強いクラウドモデルへ助言を求める場合は、送信候補の文脈へPII(個人識別情報)検出をかけ、端末外へ出る内容を確認できる設計です。クラウド側の助言モデルは承認された文脈だけを受け取り、ローカルのファイルやツールへ直接アクセスしません。
たとえば、PC内にある契約書を読み込んで内容を整理する部分はローカルで処理し、最新の市場データだけをWebから取得する、といった使い方ができます。
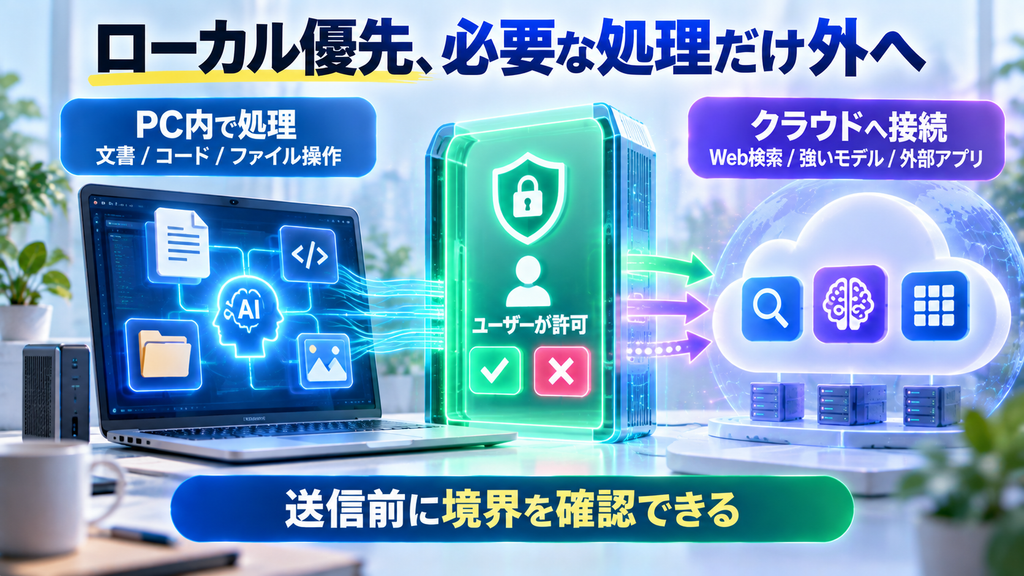
この「ローカルかクラウドかを最初に固定する」のではなく、仕事のステップごとに切り替える考え方がPortable Computerの中心です。
Gmail・Slack・GitHubなどのコネクターも使える
Portable Computerはローカルファイルだけを扱うツールではありません。
Perplexityの発表では、Google Drive、Gmail、Slack、GitHubなどのアプリコネクターと組み合わせられます。
たとえば、
- ローカルのバグ報告を読む
- GitHubのIssueを確認する
- 優先順位を決める
- Slackへ担当候補を送る
といった複数サービスにまたがる処理を組めます。
ただし、外部サービスへ内容を送る処理は「ローカル処理」ではありません。
Portable Computerでは、機密ファイルを端末内で扱う部分と、外部サービスへ接続する部分を分けて考える必要があります。
「コネクターを使える=データがすべてローカルに残る」ではない点は確認しておきたいところです。
使われるローカルモデルは27Bクラス
2026年9月11日時点で、Portable Computerでは主に次のローカルモデルが案内されています。
- Qwen 3.8 27B
- PPLX 27B
PPLX 27Bは、Qwen 3.8 27BをベースにPerplexityがPortable Computer向けに追加学習したモデルです。
さらに、NVIDIA Nemotron 3.5 Lightningの30Bモデルもモデル選択へ追加予定です。
ここで重要なのは、モデル単体の性能だけではありません。
Perplexityは、ローカルモデルに合わせてエージェント側のハーネスも設計しています。強いクラウドモデル向けの巨大なツール群をそのまま小型モデルへ渡すのではなく、必要な機能を絞り、必要なスキルを都度読み込む考え方です。
ローカルAIでは「何Bのモデルか」だけでなく、モデルが迷わず仕事を進められる実行環境をセットで作ることが重要になっています。
DGX Sparkでは128GBのユニファイドメモリを使う
Portable Computerは最初、NVIDIA DGX Spark向けに提供されました。
DGX Sparkの主な仕様は次の通りです。
| 項目 | DGX Spark |
|---|---|
| CPU | 20コア Arm |
| GPU | NVIDIA Blackwell |
| システムメモリ | 128GB LPDDR5xユニファイドメモリ |
| メモリ帯域 | 273GB/s |
| ストレージ | NVMe SSD |
| OS | NVIDIA DGX OS |
27Bクラスのモデルに加えて、エージェントの実行基盤やローカル検索を同時に動かすため、一般的な軽量チャットボットより要求されるハードウェアは高めです。
DGX Sparkは最大200Bパラメータ級のモデルを扱えるAI開発向けデスクトップとして設計されていますが、Portable Computer自体が200Bモデルを使うという意味ではありません。
一般のNVIDIA RTX PCにも広がっている
8月25日の初回発表ではDGX Sparkが中心でしたが、その後条件が広がりました。
NVIDIAは2026年9月3日の更新で、Portable Computerについて、Linux環境で24GB以上のVRAMを持つNVIDIA RTX GPUに対応したと案内しています。
そのため、9月11日時点では「DGX Sparkを買わないと試せない」とは言えません。
ただし、24GB以上のVRAMが条件なので、すべてのGeForce RTX PCが対象になるわけでもありません。
Portable Computerを既存PCで使いたい場合は、少なくとも次の3点を確認する必要があります。
- NVIDIA RTX GPUか
- VRAMが24GB以上あるか
- 現在はLinux環境を用意できるか
具体的なGPUごとの動作保証や性能差は、今後の対応表・実測情報を確認した方が確実です。
Windows版はまだ「coming soon」
2026年9月11日時点では、Windows対応はまだ正式提供前です。
Perplexityの初回発表でもWindows対応予定とされ、9月3日のNVIDIA発表でもWindows support coming soonと案内されています。
つまり、Windows PCに24GB以上のRTX GPUが入っていても、現時点では「Windows版Portable Computerをそのまま導入できる」とは書けません。
Windows対応を待っている場合は、
- PerplexityのPortable Computer発表ページ
- NVIDIAのLocal AI関連発表
- 対応GPU・OS要件
を再確認してから導入するのが確実です。
Perplexity Pro・Max利用者が対象
Perplexityの発表では、Portable ComputerはProとMaxのサブスクライバー向けに提供されています。
ローカル処理そのものは推論クレジットを消費しませんが、Portable Computerの利用権までサブスクリプション不要になるわけではありません。
また、クラウドへエスカレーションする処理や接続サービス側には別条件が関係するため、「PCを用意すれば完全無料で使い放題」という意味でもありません。
料金・利用上限は変わりやすいため、導入時には現在のPerplexityプラン条件を確認する必要があります。
OllamaのようなローカルLLM実行環境とは役割が違う
ローカルAIという言葉から、OllamaやLM Studioのような仕組みを思い浮かべる人もいると思います。
これらは主に、PC上でモデルを読み込み、ローカル推論を行うための実行環境です。
Portable Computerはそこから一段上の仕事を扱います。
モデルを動かすだけでなく、
- 仕事をタスクへ分解する
- 使うツールを選ぶ
- ファイルを検索する
- 複数ステップを継続する
- 必要ならクラウドへ処理を依頼する
- 作業結果をファイルや外部サービスへ反映する
ところまで含めたローカルAIエージェントの実行環境です。
そのため、単に「自分のPCでチャットしたい」だけならPortable Computerである必要はありません。
機密データを扱いながら、複数ファイルやツールをまたぐ長い仕事をAIへ任せたい場合に違いが出ます。
「完全ローカル」と「ローカルファースト」は区別したい
Portable Computerについては「完全ローカルAI」と紹介されることもあります。
実際、モデル、計画、会話、ローカルファイル処理など主要なエージェント基盤は端末内で動きます。
ただし、Web検索、外部アプリ、クラウドの強いモデルを使う場合は外部通信が発生します。
そのため実際の運用を考えるなら、何でもオフラインで完結するAIというより、ローカルを既定にして必要な処理だけ外へ出す「ローカルファースト」と捉える方が正確です。
完全にオフラインで使いたい場合はWeb検索やコネクターを使わず、ローカル処理だけに限定する必要があります。
ローカルAIエージェントで確認したい4つの境界
Portable Computerに限らず、今後ローカルAIエージェントを選ぶときは次の4点を見ると判断しやすくなります。
モデルはどこで動くか
モデル本体が端末内にあるのか、クラウドAPIを呼んでいるのかを確認します。
会話・実行履歴はどこに残るか
質問だけでなく、AIエージェントがどのツールを使ったかという履歴も確認対象です。
外部通信が起きる条件は何か
Web検索、アプリ連携、強いモデルへの切り替え時に何が送られるかを確認します。
外へ出す前にユーザーが止められるか
外部送信を自動で行うのか、送信前に確認ゲートがあるのかは、機密データを扱うときに大きな違いになります。
Portable Computerは、この最後の「外へ出す前にユーザーが許可する」という境界を明示している点が特徴です。
まとめ
Perplexity Portable Computerは、ローカルLLMを動かすだけのアプリではありません。
モデル、オーケストレーター、プランナー、ツール実行、検索インデックスまで端末側へ置き、AIエージェントの仕事そのものをローカルで進める仕組みです。
端末内で完結できる処理はローカルで行い、Web検索や強いクラウドモデルが必要になった場合だけ、ユーザーの許可を挟んで外部へつなぎます。
2026年9月11日時点では、DGX Sparkに加え、Linux環境のNVIDIA RTX GPUで24GB以上のVRAMを持つPCにも対応。Windows版はまだ提供前です。
ローカルAIが広がる中で見るべきなのは、「モデルをPCで動かせるか」だけではありません。計画・ツール実行・履歴・外部通信まで、どこをローカルへ置けるかが次の比較軸になってきています。