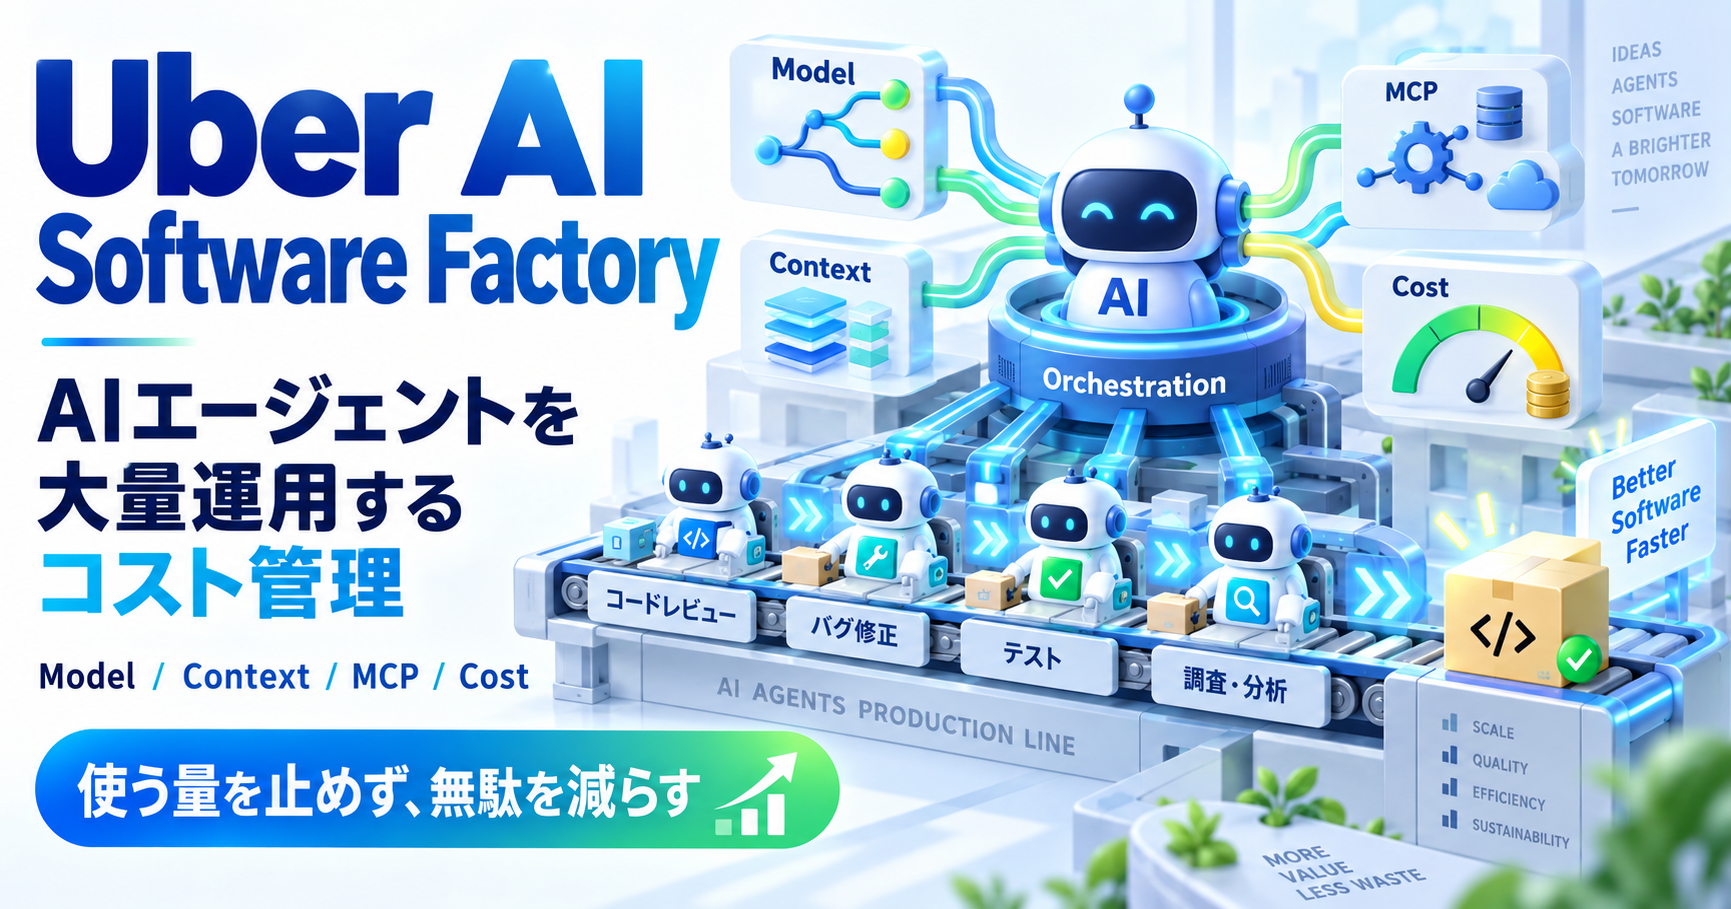
AIコーディングでは、高性能モデルを使えば使うほど成果が良くなるとは限りません。
難しい設計や原因調査には強いモデルが必要でも、決まった手順のレビュー、検索、修正、定型的なサブタスクまで同じ高性能モデルで回せば、利用量が増えたときにコストも一気に膨らみます。
Uberが2026年8月27日に公開したSoftware Factoryの運用は、この問題をかなり具体的に示しています。
Uberでは、ローカルまたはクラウドのAIエージェントに帰属するPull Requestが70%を超え、3,600以上のAgent Skillが作られ、1日3万回を超えるSkill実行が行われています。一方で、2026年2月から8月にかけて週次アクティブ利用者は7倍、エージェント要求数は9.4倍へ増えたものの、AI全体の支出は4月以降おおむね安定したと説明しています。
同じモデルを固定して比較した期間では、1,000モデルリクエストあたりのコストはピークから約34%低下し、1セッションあたりのコストも6月のピークから52%低下しました。
ここで重要なのは、単に「安いモデルへ切り替えた」わけではないことです。
Uberは、モデル選択、コンテキスト量、MCPツール、Prompt Cache、検索に使うターン数、コストの見える化を別々の要素として測り、無駄が出ている場所を順番に減らしています。
この記事では、UberのAI Software Factoryがどんな考え方でAIエージェントのコストを管理しているのかを見ながら、個人や小規模開発でも取り入れやすい部分まで整理します。
- UberのAI Software Factoryは1つのAI製品ではない
- UberはAIコストを6つの要素へ分解している
- 1. モデルは「一番強いもの」ではなく仕事ごとに選ぶ
- 2. 主エージェントとサブエージェントでモデルを分ける
- 3. コンテキストが大きいほど良いとは限らない
- 4. Prompt Cacheは実際の作業間隔に合わせる
- 5. MCPはツールを増やすほどコンテキストを消費する
- 6. ツール呼び出しの途中経過を全部モデルへ返さない
- 7. 情報不足のエージェントは「安く失敗」しない
- 8. コスト上限より「今いくら使っているか」を見せる
- 個人・小規模開発でも取り入れやすい5つの考え方
- Dynamic Model Routingは今後の取り組み
- まとめ
- 公式情報・参照先
UberのAI Software Factoryは1つのAI製品ではない
UberのSoftware Factoryは、特定のAIモデルやコーディングツールの名前ではありません。
コードレビュー、CI失敗の自動修復、E2EのPull Request作成、オンコールアラートの振り分け、バグ調査、コード保守など、ソフトウェア開発ライフサイクルの各工程へAIエージェントを組み込み、共通の基盤で動かす運用全体を指しています。
AIエージェントが増えると、単にモデルAPIを呼ぶだけでは管理できない問題が出ます。
- どの仕事へどのモデルを使うか
- エージェントがどの社内情報を参照するか
- どのツールへアクセスできるか
- 1回の作業で何トークン使ったか
- 何回モデルを呼び出したか
- 成果に対してコストが見合っているか
Uberは、こうした部分をSoftware Factoryの基盤側で管理しています。
AIエージェントを「チャット画面で使う便利なAI」ではなく、複数の仕事を継続して処理する実行基盤として扱っている点が特徴です。
UberはAIコストを6つの要素へ分解している
Uberが公開した考え方では、AIエージェントの総コストを次の6要素へ分解します。
利用者数
× 1人あたりのセッション数
× 1セッションあたりのターン数
× 1ターンあたりのモデルリクエスト数
× 1リクエストあたりのトークン数
× 1トークンあたりの価格
= 総コスト
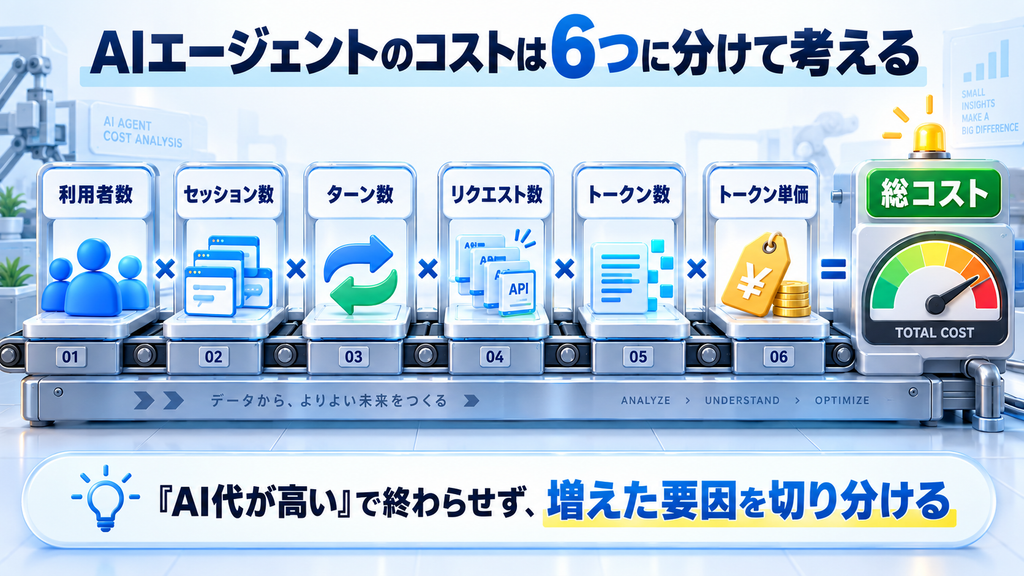
この考え方なら、「今月のAI代が高い」で終わりません。
例えば支出が増えた場合でも、
- 利用者が増えたのか
- 1つの仕事で会話が長くなったのか
- サブエージェントを呼びすぎているのか
- MCPのツール定義でコンテキストが膨らんでいるのか
- 高価なモデルを不要な仕事へ使っているのか
を切り分けられます。
Uberは利用者数や利用頻度そのものは伸ばしたい一方、AIが裏側で余計に行う処理を主な最適化対象にしています。
「AI利用を制限して予算を守る」のではなく、同じ成果へ到達するまでの余計なモデル呼び出しやトークンを減らす設計です。
1. モデルは「一番強いもの」ではなく仕事ごとに選ぶ
AIエージェントのコストを下げる最初の手段はモデル選択です。
ただし、Uberは公開ベンチマークの順位だけでモデルを選んでいません。
各Managed Agentについて、そのエージェントが実際に処理する仕事から専用ベンチマークを作る方法を採っています。
例えば全Pull RequestをレビューするuReviewでは、既知のバグが含まれる実際のPull Requestを使い、
- Precision
- Recall
- F1
- 1レビューあたりのコスト
- レイテンシ
- タイムアウト
- ノイズ
などを比較しています。
モデルを変更した結果、F1を上げながら1レビューあたりのコストを大きく下げられた例も公開されています。
Uberが見ているのは、単純なモデル単価ではなく、1つの仕事を正しく完了するためのコストと品質の組み合わせです。
高性能でも高価すぎるモデル、安くても失敗が多く再実行が必要なモデルは、どちらも最適とは限りません。
2. 主エージェントとサブエージェントでモデルを分ける
対話型のAIエージェントでは、主エージェントが複数のサブエージェントへ仕事を分ける構成が増えています。
Uberは、このサブエージェントの既定モデルを大きなコスト削減ポイントとして挙げています。
主エージェントには、
- 問題を理解する
- タスクを分解する
- 難しい判断をする
- サブエージェントの結果を評価する
といった役割があります。
一方、サブエージェントには、入力とゴールが明確な仕事を渡せます。
主エージェント
難しい判断・分解・評価
↓
サブエージェント
検索・確認・限定的な修正・レビュー
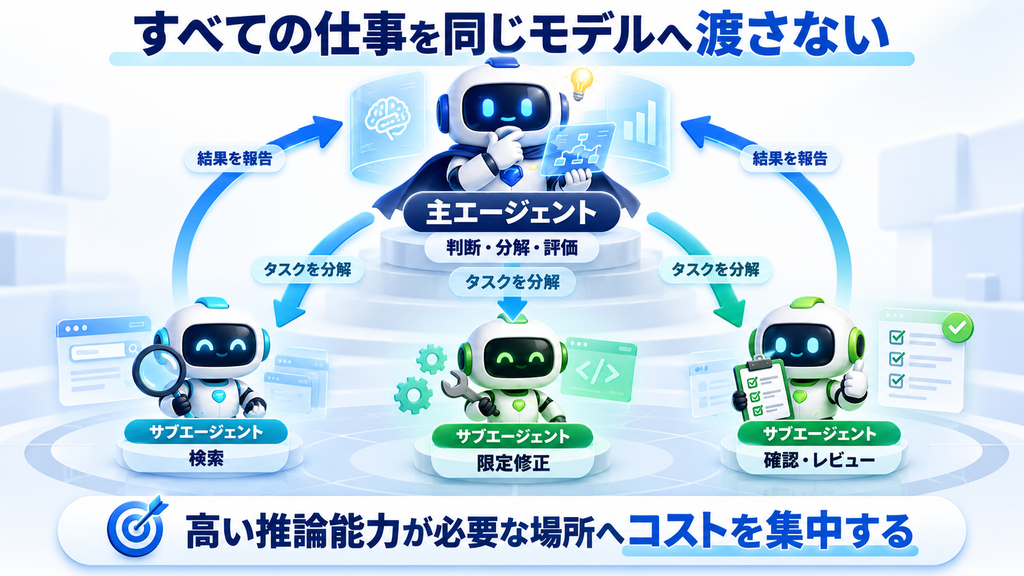
Uberでは、サブエージェントをより低コストなモデルへ既定で割り当て、必要な場合だけ人が変更できるようにしています。
これは「弱いモデルで十分」という固定判断ではありません。
仕事を十分に限定できれば、その仕事に必要な能力も限定できるという考え方です。
AI開発で高性能モデルを使う場合でも、すべての工程を同じモデルへ任せるのではなく、設計・判断・レビューなど高い推論能力が必要な場所へ絞ることで、全体のコストを調整できます。
GitHubのHydraFusionも、Single・Cascade・Critiqueを使い分けて、必要なところだけ追加のモデル能力を使う方向へ進んでいます。
3. コンテキストが大きいほど良いとは限らない
最近のAIモデルは、非常に大きなコンテキストウィンドウを使えます。
ただ、利用可能な上限まで情報を持たせ続ければ、その分だけ毎回の入力トークンも増えます。
Uberでは、100万トークン級のコンテキストを扱えるモデルでも、対話型ハーネスでは40万トークンで自動圧縮を開始する設定を採用しています。
推論強度も既定ではMediumへ設定し、すべての処理で最大推論量を使わないようにしています。
重要なのは「大きなコンテキストを使わない」ことではありません。
- 今の仕事に必要な情報か
- 後のターンでも繰り返し送り続ける必要があるか
- すでに不要になったログやツール出力が残っていないか
を見ることです。
AIエージェントは長く動くほど、過去の会話、検索結果、ツール応答、コード、エラーログを抱え込みます。
1回だけなら小さな無駄でも、そのコンテキストが後続リクエストへ何度も含まれるとコスト差が広がります。
4. Prompt Cacheは実際の作業間隔に合わせる
長いセッションでは、毎回同じコンテキストを最初から処理するより、Prompt Cacheを利用した方がコストを抑えられる場合があります。
しかし、Cacheには保持時間があります。
Uberでは、対話型セッションで開発者が5分以上作業を止めるケースが多く、短いCacheでは再開時にコンテキストを再構築することが増えていました。
そこで対話型セッションの既定Cacheを5分から1時間へ変更しています。一方、短時間で終わることが多いサブエージェントでは5分を維持しています。
ここでも、全処理を同じ設定へそろえていません。
人と対話しながら続くセッションと、短時間で終わるサブエージェントでは、最適なCache条件が違うからです。
APIを使うAI開発では、モデル単価だけでなく、Cache hit率や作業間隔も実コストに影響します。
5. MCPはツールを増やすほどコンテキストを消費する
MCPを使えばAIエージェントへ多くのツールを接続できます。
ただ、接続したツールをすべて最初からモデルへ説明すると、実行前からコンテキストを大量に使います。
Uberでは、100を超えるツールを読み込んだケースで、ツールSchemaだけで約5万〜7万トークンが初期プロンプトへ追加されていました。
しかも、この情報は最初の1回だけではなく、後続ターンでもコンテキストとして持ち回ることになります。
そこでUberは、1,000を超える内部・外部SaaSのMCPを共通Gatewayへ集約し、
- CLIとして必要なツールだけ実行時に解決する
- Tool Searchで必要なツールだけ探して読み込む
という方式へ移しています。
つまり、
使うかもしれない100個のツールを最初に全部読む
のではなく、
今必要なツールを探す
↓
そのツールだけ呼ぶ
へ変えています。
MCPを増やせばエージェントの機能は増えますが、ツール数とコンテキスト量は別に管理する必要があるという例です。
MCP自体の役割はこちらの記事で整理しています。
6. ツール呼び出しの途中経過を全部モデルへ返さない
ツール操作では、最終結果だけでなく途中の状態もトークンを使います。
例えばSQLを実行する処理なら、
実行要求
↓
状態確認
↓
再度状態確認
↓
結果取得
↓
モデルが読む
という複数ターンになる場合があります。
UberのCode-Modeでは、このような処理をPythonなどのスクリプトへまとめ、途中のポーリングをモデルのコンテキストへ入れず、最後の結果だけ返します。
同じSQLを比較したUberの測定では、小さな結果でも50%を超えるトークン削減が確認され、広い結果セットでは削減率がさらに大きくなりました。
AIエージェントに何でも1操作ずつ考えさせるより、手順が決まっている部分はコードへ落としてまとめて実行する方が効率的な場合があります。
これはAgent Skillとも相性のよい考え方です。
毎回モデルがゼロから操作手順を考えるのではなく、繰り返し使う工程をSkillやスクリプトとして固定すれば、モデルは判断が必要な場所へ集中できます。
7. 情報不足のエージェントは「安く失敗」しない
Uberの例で特に印象的なのが、社内情報をつないだAI Context Graphです。
このGraphには、2,400万ノード、8,000万エッジがあり、30を超える内部システムから、サービス、チーム、インシデント、Pull Request、設計文書、デプロイ、データセットなどの情報を結び付けています。
同じモデルへ同じ問いを与えた比較では、Context Graphを使ったエージェントは38秒で正しい対象を見つけました。
一方、Graphを使わないエージェントは20分以上かけてサービスコードを調べ、2つのサブエージェントを起動し、3回エラーになった末に、対象データは利用できないという誤った結論へ到達しています。
モデルが情報を持っていないと、すぐ失敗して終わるとは限りません。
見つからない情報を探し続けることで、時間もトークンも追加で消費します。
そのため、コスト削減は「情報を減らす」だけでは成立しません。
不要なコンテキストは減らしつつ、仕事に必要な情報へ短い経路で到達できる仕組みが必要です。
NVIDIA AVOの記事でも、AIエージェントではモデルだけでなく、メモリ、ツール、評価、状態保存など周辺のハーネスが重要だと紹介しました。
8. コスト上限より「今いくら使っているか」を見せる
Uberは一律の厳しい利用上限だけで管理するのではなく、利用者へコストを見せる仕組みも使っています。
対話型ハーネスのステータスラインには、そのセッションと利用者全体の実行コストが表示されます。
さらに、想定支出の50%、80%、100%へ到達したときにSlackで通知し、必要なら管理者承認で利用枠を上げられる仕組みを用意しています。
セッション分析ダッシュボードでは、
- 高価なモデルを単純な処理へ使っている
- 大きなMCP応答がコンテキストへ残り続けている
- Cache切れ後に巨大なコンテキストを再構築している
- ユーザー入力前から大量のシステム指示・ツール定義を読み込んでいる
といった16種類のコスト上の問題を検出します。
利用禁止へ寄せるより、どの処理がいくら使い、どこに無駄があるのかを利用者が見られる状態を作っています。
個人・小規模開発でも取り入れやすい5つの考え方
Uberと同じ基盤を個人で作る必要はありません。
規模が違っても、考え方はそのまま使える部分があります。
1. 高性能モデルを全工程の既定にしない
難しい設計、原因不明のデバッグ、最終レビューなどへ高性能モデルを使い、限定されたサブタスクは別モデルへ任せます。
モデルの優劣ではなく、その仕事に必要な能力で選びます。
2. 自分の実タスクで小さな評価セットを作る
公開ベンチマークだけでは、自分のコードや作業での品質は判断できません。
よく行う修正、レビュー、調査などを数件残しておき、モデル変更時に同じ課題で比較すると、料金と品質の差を確認できます。
3. 長いセッションを放置しない
大きなログ、古い検索結果、不要なツール応答が残っていないか確認します。
コンテキスト上限が大きいからといって、使い切ることを目標にしない方がよいです。
4. MCPやツールは必要なものだけ読ませる
利用可能なMCPを増やすことと、毎セッションですべて読み込むことは別です。
必要なツールをタスク単位で選ぶ、Tool Searchを使う、CLIやSkillへ処理を逃がすなど、モデルが常に抱えるSchemaを減らします。
5. 「何トークン」より「1成果いくら」を見る
コードレビューなら1レビュー、機能開発なら1つの完了タスク、調査なら1件の調査完了までに、どの程度の利用量が必要だったかを見ます。
安いモデルで失敗を繰り返すより、高性能モデル1回で終わる方が安いケースもあります。
UberがManaged Agentで追っているcost per merged PRやcost per reviewも、この考え方です。
Dynamic Model Routingは今後の取り組み
Uberは今後の取り組みとしてDynamic Model Routingも挙げています。
ここは現在の運用と区別しておく必要があります。
現在すでに行っているのは、実タスクのベンチマークを使ってManaged Agentごとにモデルを選び、サブエージェントの既定モデルを調整することです。
Dynamic Model Routingでは、さらにプログラミング言語、リポジトリ、エージェントの種類など幅広い評価を増やし、実行する仕事に応じてモデルを動的に振り分ける方向を目指しています。
HydraFusionのように、1つの作業の中でモデルを使い分ける仕組みも登場しており、今後は「どのモデルを契約するか」だけでなく、どの仕事をどのモデルへ流すかがAI開発基盤の重要な機能になっていきそうです。
まとめ
UberのAI Software Factoryは、AIエージェントを大量に使うための単一製品ではなく、開発工程全体でエージェントを運用するための仕組みです。
2026年2月から8月にかけて週次アクティブ利用者は7倍、エージェント要求数は9.4倍へ増えましたが、Uberはモデル選択やトークン削減を進め、AI支出を4月以降おおむね安定させたと説明しています。
ポイントは、高性能モデルを安価なモデルへ一括置換したことではありません。
- 実タスクでモデルを評価する
- 主エージェントとサブエージェントの役割を分ける
- 不要なコンテキストを減らす
- Prompt Cacheを作業時間に合わせる
- MCPツールを必要時だけ読み込む
- 定型的なツール操作はコードへまとめる
- 必要な社内情報へ短い経路で到達させる
- 成果単位のコストを見えるようにする
という複数の改善を積み重ねています。
AIエージェントの利用量が増えるほど、「一番強いモデルはどれか」だけでは運用しにくくなります。
モデル、コンテキスト、ツール、評価、コストを1つのシステムとして設計することが、大量のAIエージェントを現実的な費用で回すための次の課題になっています。