当サイトではアフィリエイト広告を利用しています。
Google DeepMindは2026年11月11日、DNA配列や遺伝的変異が特定の細胞種・細胞状態へ与える影響を予測する「AlphaGenome 2」を発表しました。68の組織にまたがる1億700万件超の個別細胞プロファイルを含むデータで学習し、遺伝子発現やクロマチンの状態などを細胞レベルで予測します。
AlphaGenome 2の中心的な変化は、DNA配列に加えて「どの組織・細胞種・細胞状態を対象にするか」を条件として入力する点です。同じDNA領域でも、免疫細胞と心筋細胞、安静時と刺激後では働き方が変わります。対象となる生物学的条件を明示することで、変異がどの細胞で効くのかまで絞って調べられます。
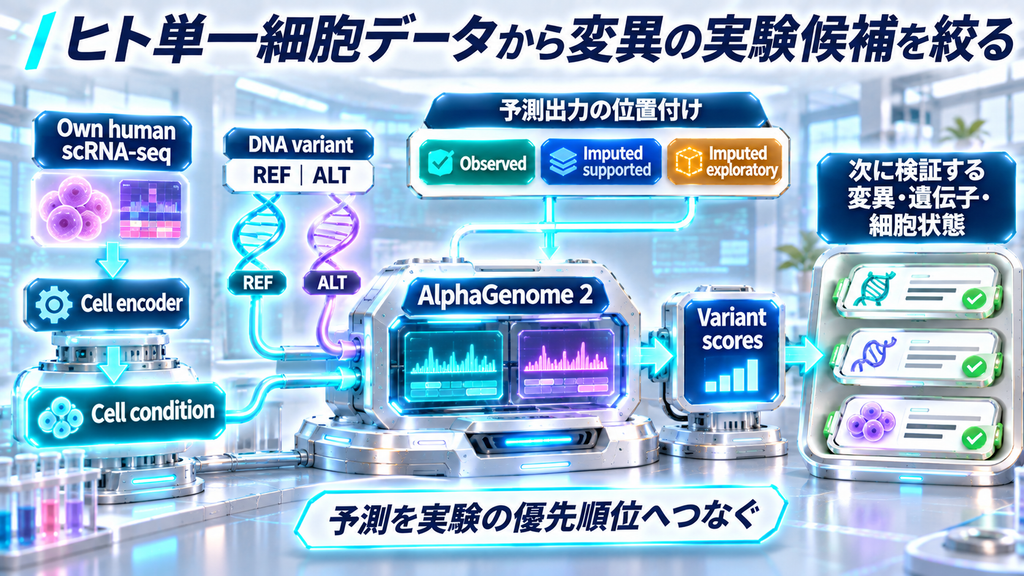
研究者自身のヒトsingle-cell RNA-seq(scRNA-seq、単一細胞RNAシーケンス)データを条件として与え、学習時に含まれていない細胞状態へ予測を広げる仕組みも用意されています。AlphaGenome 2では、「どの変異が影響を持つか」に加えて、「どの細胞状態で、どの遺伝子活動へ、どの方向に影響するか」まで候補を絞れます。
AlphaGenome 2はDNA配列と「生物学的条件」を組み合わせて予測する
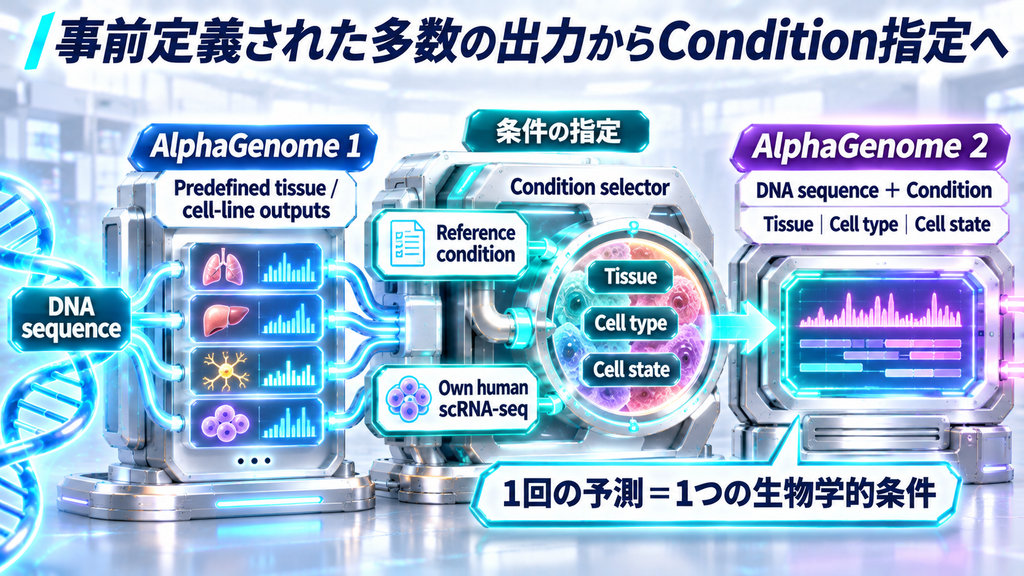
初代AlphaGenomeは、最大100万塩基のDNA配列から、多数の組織や細胞系に対応する分子レベルの出力を並列に予測する構成でした。AlphaGenome 2では、対象となる組織・細胞種・細胞状態を「condition」として指定し、1回の予測で1つの条件を扱う条件付きモデルへ変わりました。
| 項目 | AlphaGenome 1 | AlphaGenome 2 |
|---|---|---|
| DNA入力 | 最大約100万塩基 | 最大約100万塩基 |
| 予測の構成 | 事前定義された多数の組織・細胞系に対応する出力を並列予測 | 組織、細胞種、細胞状態をconditionとして入力し、1条件ずつ予測 |
| conditionの指定 | — | 参照条件/独自のヒトscRNA-seqから条件化 |
| 主な用途 | 多数の組織・細胞系での配列機能予測 | 指定した細胞種・状態での変異影響予測 |
条件は、AlphaGenome側が用意した参照条件から選ぶ方法と、研究者自身のヒトscRNA-seqデータから細胞状態を表現する「expression conditioning」の2種類があります。後者では細胞の遺伝子発現をcell encoderで圧縮し、その表現をDNA配列モデルへ渡します。
この構造によって、同じDNA配列を「血液中のCD14陽性単球」「特定のT細胞状態」のような条件で読み分けられます。疾患や薬剤、ワクチン刺激によって変わる細胞状態も、対応するヒト単一細胞データがあれば予測条件として使えます。
1億700万件超の細胞プロファイルで細胞間の違いを学習した
AlphaGenome 2は、ヒトとマウスのbulkデータとsingle-cellデータを組み合わせ、1億700万件超の個別細胞プロファイルを含むデータで学習されています。Google DeepMindは68組織にまたがる学習データを使ったと説明しています。
予測対象には、遺伝子発現、クロマチンアクセシビリティ、ヒストン修飾、スプライシング、3次元のDNA接触などが含まれます。AlphaGenome 2ではDNAメチル化も予測対象へ加わりました。
同じ組織の中でも細胞種が違えば、同じDNA配列から使われる遺伝子や調節領域は変わります。単一細胞データを大量に学習することで、組織全体の平均では薄まっていた細胞種ごとの差をモデル内部で扱えるようになっています。
変異の影響はREFとALTの予測差からスコア化する
AlphaGenome 2で遺伝的変異を評価するときは、基準となる配列(REF)と変異後の配列(ALT)の両方を同じ細胞条件で予測し、その差を変異スコアへ変換します。
基本の流れは次の4段階です。
- 対象となる組織・細胞種・細胞状態を選ぶ
- 変異を含むDNA領域を指定する
- REFとALTそれぞれの遺伝子発現やクロマチン状態を予測する
- 両者の差を遺伝子や実験出力ごとの変異スコアへまとめる
APIには、遺伝子発現、クロマチンアクセシビリティ、スプライシング、DNAメチル化などに対応する推奨variant scorerが用意されています。研究者は「この変異が、この細胞種で、この遺伝子の発現をどちら向きに変えるか」といった候補を数値として比較できます。
TenK10Kでは細胞種別の原因変異と作用方向の検出範囲が広がった
Google DeepMindは、28種類の主要な免疫細胞を含むTenK10KデータセットでAlphaGenome 2を評価しています。
発表では、原因となる変異を高い確度で特定できた割合が30%で、single-cellデータへ適応させた初代AlphaGenomeの16%を上回りました。遺伝子発現を上げるか下げるかという作用方向も43%対23%でした。
| TenK10Kでの評価 | AlphaGenome 2 | AlphaGenome 1をsingle-cell向けに適応 |
|---|---|---|
| 原因変異を高い確度で特定できた割合 | 30% | 16% |
| 遺伝子発現の作用方向を高い確度で特定できた割合 | 43% | 23% |
この数値は28種類の免疫細胞を使った評価条件で得られたベンチマーク結果で、細胞種別の変異効果を高い確度でどこまで拾えるかを示しています。
炎症性腸疾患(IBD)の例では、既存研究で見つかっていた非コード領域の変異とETS2遺伝子の関係をAlphaGenome 2が再現しました。予測では、その変異が腸のマクロファージでETS2の活動を選択的に高め、他の細胞種では影響が小さいことまで絞り込んでいます。
自分のヒトscRNA-seqデータから未見の細胞状態を条件化できる
AlphaGenome 2のexpression conditioningでは、研究者自身のヒトscRNA-seqデータをcell encoderへ渡し、その細胞集団を表す条件を作れます。API仕様では、1回のconditioningに最大256細胞のraw UMI countsを入力できます。
Google DeepMindは、学習時に含まれていないCOVID-19 mRNAワクチン研究の単一細胞データを例にしています。AlphaGenome 2はワクチン刺激を受けたT細胞と安静時のT細胞を区別し、重症COVID-19と関連する変異の影響が活性化状態で強くなることを予測しました。
モデル全体を新しい細胞状態へ再学習する工程を挟まず、少量のヒト単一細胞発現データを「条件」として使えます。疾患進行、薬剤処理、ワクチン刺激、分化過程のように状態が変化する研究で、対象状態に合わせた変異予測へつなげられます。
未測定データの補完は「観測済み」と区別して扱う
条件付きモデルは、ある細胞状態で測定されていない出力を補完するcross-modality imputationにも使われます。たとえば単一細胞の遺伝子発現を条件として、同じ状態のクロマチンアクセシビリティなどを予測できます。
AlphaGenome 2のAPIは、各予測出力の由来・扱いを示す情報として次のimputation_modeを付けます。
- observed:学習データで実測された条件・出力
- imputed_supported:生物学的に情報があり、ベンチマークで支持された方向の補完
- imputed_exploratory:実験的な制約が十分でなく、探索的に扱う補完
補完値は、次にどの実験を優先するかを決める仮説として使います。実測された出力と補完された出力を区別することで、研究者は予測の根拠と扱い方を分けられます。
GWASの関連領域から「変異・遺伝子・細胞種」を絞り込む
GWAS(ゲノムワイド関連解析)は、疾患や形質と統計的に関連するDNA領域を見つけます。その関連領域には多数の変異が含まれるため、実際に作用する変異、標的遺伝子、作用する細胞種を特定する作業が必要です。
AlphaGenome 2は、DNA配列と細胞条件を組み合わせて次の候補を絞ります。
- どの変異が分子活動を変えるか
- どの遺伝子へ影響するか
- 遺伝子活動を上げるか下げるか
- どの細胞種・細胞状態で影響が強いか
Google DeepMindは、疾患や形質に関連する変異について、数百のヒト細胞・組織条件でAlphaGenome 2の予測を事前計算しています。離れた位置のenhancer(遺伝子の働きを調節するDNA領域)と標的遺伝子の対応や、疾患関連変異が働く細胞種を絞る用途に使われます。
この段階でAIが担うのは、実験前の候補順位付けです。細胞条件を加えた変異スコアによって、研究対象を「どの変異を調べるか」から「どの細胞状態で何を測るか」まで細かくできます。
AlphaGenome 2 APIは研究向けの条件付き予測に使う
AlphaGenomeの公式ドキュメントでは、目的ごとにツールを分けています。
| 目的 | 選ぶもの |
|---|---|
| 特定の組織・細胞種・細胞状態で予測する | AlphaGenome 2 |
| 自分のヒトscRNA-seqデータを条件にする | AlphaGenome 2のexpression conditioning |
| 既に計算済みのヒト変異効果を検索する | AlphaGenome Atlas |
| 初代論文の結果再現や全条件をまとめた解析 | AlphaGenome 1 |
AlphaGenome APIは非商用利用では無料で提供され、ライブモデル予測は数千件規模の解析に向きます。数百万件規模の全ゲノム探索では、事前計算済みのAlphaGenome Atlasを使う方が適しています。
AlphaGenome 2は非商用研究向けにAPIで利用でき、商用研究は執筆時点でプライベートプレビューです。モデルの予測は研究用途を対象としており、臨床判断や診断用途として検証・承認されたものではありません。
まとめ
AlphaGenome 2の大きな変化は、DNA配列だけでなく、対象となる組織・細胞種・細胞状態を予測条件へ入れたことです。これにより、同じ変異がどの細胞で強く作用するかまで候補を絞れます。
研究者自身のヒトscRNA-seqデータを条件にして未見の細胞状態へ予測を広げ、REFとALTの差から変異スコアを作り、観測済み・補完済みの出力を区別しながら実験候補を選べます。AlphaGenome 2では、対象となる組織・細胞種・細胞状態をconditionとして指定し、変異と細胞状態を結びつけた実験候補を細かく絞れます。
公式情報・参照先
- AlphaGenome 2: Deciphering how cells read DNA to better understand disease|Google DeepMind
- AlphaGenome documentation
- Getting started|AlphaGenome
- Choosing a condition|AlphaGenome
- How variant scoring works|AlphaGenome
- Navigating imputed tracks|AlphaGenome
- AlphaGenome API|GitHub
- AlphaGenome 2: A Step Change in Predicting What DNA Does|Genomics